
Les assistants IA prêts à l’emploi répondent bien aux questions individuelles, mais ils manquent sur un autre axe : la continuité. Si vous demandez à un assistant sans statut à propos de votre jardin aujourd’hui, il ne sait pas que vous avez mentionné trois semaines plus tôt vos parcelles en terre drainante, que vous utilisez uniquement des engrais organiques, ou que vos petunias ont eu du mal face à une vague de chaleur. Chaque conversation commence à zéro, et c’est l’utilisateur qui doit expliquer tout cela à nouveau.
Le problème n’est pas la qualité des réponses, mais le fait que l’assistant ne se souvient pas de vous. Ce post montre comment construire un assistant personnel qui accumule le contexte en utilisant OpenClaw, un système agentique open source, fonctionnant sur AgentCore runtime, une capacité de Amazon Bedrock AgentCore. La mémoire d’AgentCore, également une capacité de Amazon Bedrock AgentCore, transforme les conversations temporaires en connaissances durables. Vous verrez également comment étiqueter ces souvenirs avec des métadonnées structurées afin de retrouver les informations pertinentes pour la question en question.
Notre exemple en cours d’exécution est Sprout, un assistant de jardinage, mais l’architecture est indépendante du domaine. En changeant la personne et le manifeste des compétences, le même pipeline peut servir un bot de support, un coach de fitness ou un service d’assistance interne. L’ensemble du système se trouve dans un seul modèle AWS CloudFormation, il est déployé avec une seule commande, et fonctionne selon un modèle de consommation qui coûte quelques dollars par mois pour un usage personnel léger. Sur le chemin, nous partageons des directives de conception que vous pouvez appliquer aux assistants que vous créez avec cette stack.
Aperçu de la solution
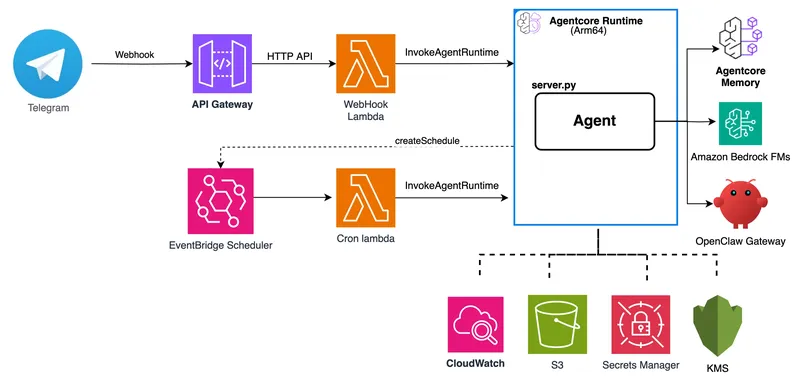
AgentCore est une plateforme permettant de construire, de connecter et d’optimiser des agents à grande échelle, avec n’importe quel framework ou modèle. Le diagramme suivant illustre le flux de demande en amont et en aval, depuis un webhook Telegram entrant jusqu’au runtime AgentCore et aux services AWS associés.
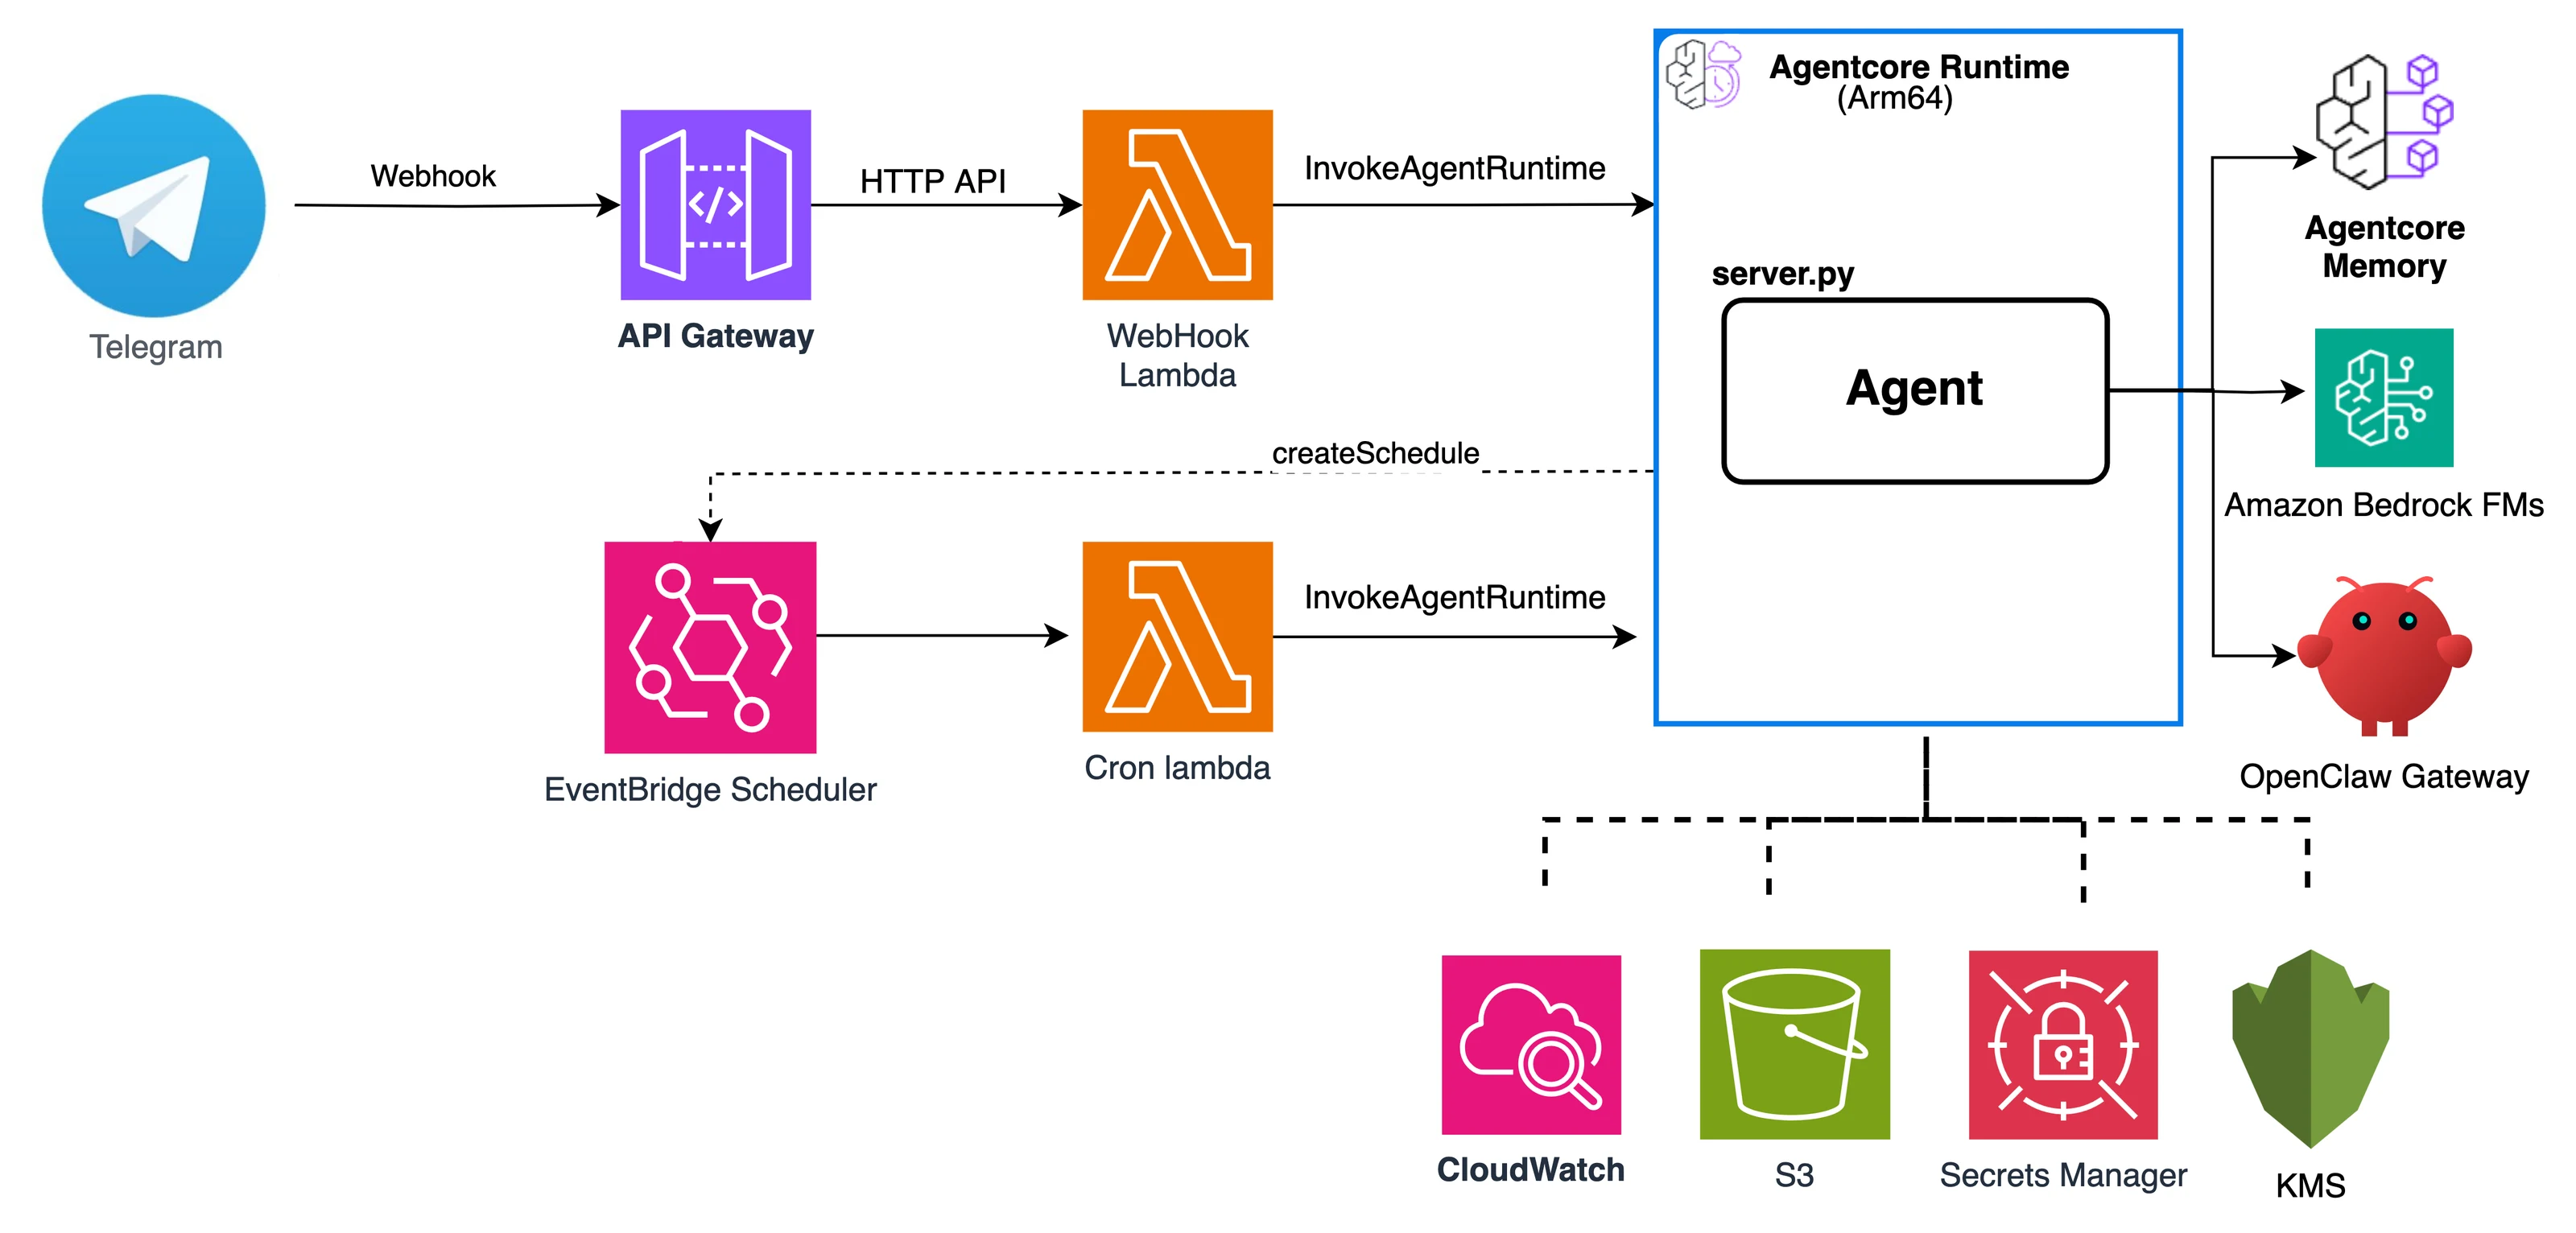
Figure 1 : Les webhooks de Telegram et les horaires d’Amazon EventBridge invoquent tous le même agent de runtime AgentCore, qui coordonne le passerelle OpenClaw, la mémoire AgentCore et Amazon Bedrock
Deux points d’entrée convergent vers un agent unique. Les messages Telegram arrivent via le Gateway API d’Amazon et une fonctionnalité webhook de AWS Lambda, tandis que les tâches planifiées, comme les rappels d’arrosage le matin, arrivent via le Scheduler d’Amazon EventBridge et une fonctionnalité cronjob de Lambda. Les deux sources appellent l’API InvokeAgentRuntime sur le runtime AgentCore, où un processus simple server.py coordonne le passeport OpenClaw, la mémoire du AgentCore et l’API Converse de Amazon Bedrock. Le service de stockage Simple d’Amazon (Amazon S3) fournit le stockage du espace de travail, le service de gestion des clés d’Amazon (AWS KMS) gère l’encryption, AWS Secrets Manager conserve le token du bot, et Amazon CloudWatch enregistre les logs et les métriques.
Prérequis
Pour déployer votre propre version en utilisant le bouton Launch Stack ou les scripts/deploy.sh (décrit dans la section « Grow your own »), vous aurez besoin de :
- Accès au Amazon Bedrock AgentCore, y compris le temps de exécution et la mémoire du AgentCore.
- Accès au modèle accordé pour les modèles que vous prévoyez de router : Claude Haiku 4.5 pour le texte et Claude Sonnet 4.5 pour la vision (ou les équivalents disponibles dans votre compte).
- Docker avec le support de la construction
linux/arm64, ainsi que l’interface de ligne de commande AWS (AWS CLI) configurée. Cela est nécessaire uniquement si vous prévoyez de construire et de déplacer votre propre image. - Un token de bot Telegram (donné par BotFather) servant de porte d’entrée pour l’assistant.
- Connaissances de base en concepts d’orchestration d’agents et en CloudFormation.
L’architecture : un agent sans serveur sur le runtime AgentCore
Chaque composant est présent dans un seul modèle CloudFormation, et aucun outil de compilation n’est nécessaire pour le démarrer. Les sections suivantes expliquent les décisions relatives à la charge de travail.
AgentCore runtime : Payer uniquement pour le calcul actif
L’agent vit dans un conteneur sur le runtime AgentCore, qui utilise une tarification basée sur la consommation. Vous êtes facturé pour les ressources de calcul que votre agent consomme activement, et non pour la durée de fonctionnement en temps réel. Vous ne payez pas pour le temps passé à attendre des I/O, comme la réponse d’un modèle. Pour un assistant personnel utilisé de manière ponctuelle, cela correspond à une base d’utilisation d’environ 1–2 dollars par mois, contre environ 35 dollars par mois pour une instance Amazon Elastic Compute Cloud (Amazon EC2) en fonctionnement permanent. Ces chiffres sont des estimations pour un usage personnel léger en juillet 2026. Pour les tarifs actuels, veuillez consulter les tarifs de AgentCore.
Le runtime impose un contrat minimal pour le conteneur : écouter sur le port 8080, et exposer GET /ping pour la santé et POST /invocations comme point d’entrée de l’agent. Notre conteneur est linux/arm64, construit en plusieurs étapes à partir de l’image officielle OpenClaw plus un couche Python.
OpenClaw en tant que substrat d’agent
OpenClaw fournit le cycle d’agent, l’utilisation des outils et un système de compétences. Il exécute un wrapper (server.py) qui le adapte au contrat de protocole HTTP AgentCore :
- Lors de l’initialisation du conteneur,
server.pylanceopenclaw gateway runen tant que processus sous-sous-proces et effectue des vérifications de santé. GET /pingrenvoie rapidement un résultat sain, donc l’examen de préparation de AgentCore passe.POST /invocationseffectue le travail réel : il analyse le contenu du payload, accède à la mémoire, assemble le contexte, transmet la tâche au gateway et enregistre le résultat. Une remarque : AgentCore peut dégeler un conteneur gelé dont le sous-processeur s’est arrêté. Ainsi, le chemin d’invocation ne suppose pas que le gateway est actif ; il appelle l’aide‑mécanismeensure_openclaw_ready()qui vérifie à nouveau l’état du gateway (et redémarre le gateway si nécessaire) avant de transmettre la tâche.
Ce modèle de wrapper se généralise à d’autres cas d’usage. Tout cadre d’agent exécuté en tant que processus local peut être adapté au runtime AgentCore de la même manière, sans avoir à modifier le cadre lui-même.
Deux modèles, classés par tâche
Le dialogue en texte et la compréhension des images présentent des compromis entre coût et qualité différents, ainsi l’assistant les envoie à différents modèles Claude sur Bedrock :
- Claude Haiku 4.5 pour le texte : Rapide et économique pour les interactions conversationnelles à forte fréquence, qui dominent l’usage quotidien.
- Claude Sonnet 4.5 pour la vision : Une raisonnement multimodale plus puissant pour la tâche moins fréquente mais plus difficile de diagnostiquer une plante à partir d’une photo.
Le texte est transmis par le passeur OpenClaw, qui transmet les compétences et l’état de la session. L’image est appelée directement le grand modèle de langage (LLM) de Bedrock depuis server.py, en passant les données d’image en blocs de contenu multimodale. Nous dirigeons intentionnellement les images à travers le passeur : la version intégrée de OpenClaw dans le conteneur a supprimé les parties de contenu image_url avant qu’elles ne atteignent Bedrock, donc appeler l’API Converse directement depuis server.py garantit que le modèle voit les pixels réels. Les deux chemins partagent le même prompt système (persona plus mémoire), de sorte que l’expérience reste cohérente.
Les identifiants du modèle sont des variables d’environnement (MODEL_ID, VISION_MODEL_ID), de sorte que vous pouvez changer de modèle lors de chaque déploiement sans avoir à reconstruire l’image.
Compétences en tant qu’unité de capacité réutilisable
Les capacités sont déclarées comme compétences dans un manifeste community-skills.json. Un script au moment de la déploiement les transforme en conteneur et les enregistrent dans la configuration OpenClaw avant la construction de l’image. Sprout inclut à l’époque de la publication de cet article des compétences liées au temps, aux rappels et aux notes sur les plantes. En modifiant le manifeste, le même pipeline peut s’appliquer à un domaine différent. C’est ce qui fait que tout cela constitue un schéma réutilisable, et non seulement un seul bot.
Telegram en tant que porte d’entrée sans serveur
Telegram est un canal pratique pour un assistant personnel, car il est basé sur des webhooks, et tout est géré sans serveur. Il ne nécessite aucune développement client, fonctionne sur tous les appareils que l’utilisateur possède, et prend en charge le texte, les images ainsi que la mise en forme riche via une API bot simple. BotFather délivre un token bot, qui est stocké dans Secrets Manager. La déploiement enregistre un webhook qui oriente Telegram vers l’endpoint du gateway API. Lorsque l’utilisateur envoie un message, Telegram le transmet à la fonction Lambda du webhook pour valider le payload et appeler InvokeAgentRuntime. La réponse revient par l’API bot de Telegram.
Une leçon de formatage à noter : le modèle de Markdown hérité de Telegram est impitoyable envers les caractères non encodés, et une seule sous-traitre dans une réponse du modèle peut faire échouer l’envoi de tout message. La rendre en HTML est fiable, donc l’assistant convertit la sortie du modèle en HTML sécurisé pour Telegram avant d’envoyer.
Mémoire : Transformant les conversations jetables en connaissances durables
L’architecture décrite jusqu’à présent est un agent capable et bon marché, sans serveur, mais seul, il oublie toujours vous entre les conversations. C’est la mémoire qui change cela. Imaginez mentionner il y a des semaines que vous cultivez de manière organique, et aujourd’hui l’assistant recommande un traitement et ajoute, tout seul, qu’il a choisi l’option organique parce que vous ne utilisez pas d’engrais synthétiques. Un modèle sans état est incapable de faire cela.
Le modèle mental : événements à court terme, extraction à long terme
La mémoire AgentCore comporte deux couches. La mémoire à court terme stocke chaque tour de conversation en tant qu’événement via CreateEvent, identifié par actorId (le ID de chat Telegram) et sessionId. C’est la transcription brute. La mémoire à long terme est produite de manière asynchrone par des stratégies de extraction gérées, sous forme de données durables et structurées. Nous avons configuré trois stratégies.
USER_PREFERENCE: choix explicites indiqués par le jardinier (« Je ne utilise que des engrais biologiques »).SEMANTIC: faits déduits (« les petites fleurs de pépino poussent dans un lit de fer Corten »).SUMMARIZATION: résumés de sessions épisodiques (« discuté le jaunissement des feuilles inférieures pendant une vague de chaleur »).
espaces de noms : Un jardin par jardinier
Les fichiers Sprout sont enregistrés dans des espaces de noms par utilisateur, de sorte qu’aucun chat ne se mélange jamais :
sprout/{chat_id}/long_term: préférences et faits sémantiques.sprout/{chat_id}/episodic/{session_id}: résumés de session.
L’ID de chat est le seul segment variable, ce qui rend l’isolation facile à comprendre et à tester : chaque jardinier unique correspond à un espace de noms exactement, et aucun jardinier ne coïncide avec un autre.
Le pipeline de récupération, d’assemblage et d’injection
À chaque tour, l’agent récupère les enregistrements à long terme pertinents, les classe par ordre de priorité et les insère dans le prompt du système. Voici ce qui se passe pour chaque message, dans server.py :
- Retourner. Appeler
RetrieveMemoryRecordscontresprout/{chat_id}/long_term, en utilisant le message de l’utilisateur comme requête de recherche, avec un nombre maximal de 50 résultats, et dans un délai inférieur à 3 secondes. Si la récupération échoue ou s’écoule trop longtemps, nous déclinons gracieusement et répondez sans mémoire, plutôt que d’échouer.
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
Extrait 1 : Récupération des enregistrements à long terme pour la tour actuelle (représentatif). Consultez le repository pour le code source complet.
La fonction Assemble ajoute une logique personnalisée supplémentaire. Nous souhaitons que les préférences explicites soient placées en premier par rapport aux faits déduits, l’ordre reste stable au sein de chaque classe, et le résultat est limité avant injection :
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
Extrait 2 : L’étape d’assemblage classe les préférences explicites avant les faits inférés.
Metadonnées : Subgrouping des souvenirs au sein d’un espace de noms
Les espaces de noms indiquent sur quelle mémoire se trouve un enregistrement, mais les métadonnées décrivent de quoi il s’agit. À l’intérieur de sprout/{chat_id}/long_term, une recherche sémantique pour « mes petunias sont flétrissantes » retournerait tout ce qui est proche en signification. Pour un jardinier, cela signifie une préférence pour des engrais à partir de mars, ainsi que une note sur la taille d’un figuier, tous ces éléments étant classés ensemble avec les enregistrements qui comptent vraiment. Et les métadonnées structurées nous aident à limiter le champ des souvenirs avant qu’ils ne atteignent l’invitation.
Une règle structure chaque décision ici. Une clé de métadonnées n’est filtrable côté serveur que si vous la déclarez comme une clé indexée. Vous pouvez en lire plus dans Le filtrage de la mémoire structurée avec des métadonnées dans Amazon Bedrock AgentCore Memory. Dans ce cas, sprout utilise trois clés indexées :
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
    Type: STRINGLIST
Chaque entrée nomme une clé, qui doit correspondre à une clé indexée pour être filtrable, et définit extractionType soit en STRICTLY_CONSISTENT, transmis par l’événement, soit en LLM_INFERRED, extrait de la conversation. Pour les clés inférées, une configuration d’extraction peut limiter les valeurs à une liste fixe. Sprout fait exactement cela, de sorte que les deux chemins d’écriture produiront le même vocabulaire, et un filtre signifie la même chose, indépendamment de la partie qui a créé l’enregistrement.
Perpétuer le tour et fermer le cycle
Après la réponse du modèle, server.py appelle CreateEvent avec à la fois le tour de l’utilisateur et le tour de l’assistant. Cet événement nouveau alimente les stratégies d’extraction, qui enrichissent le stock à long terme pour la prochaine fois.
memory.create_event(
    memoryId=MEMORY_ID,
    actorId=chat_id,
    sessionId=session_id,
    payload=[
        {'role': 'user', 'content': user_message},
        {'role': 'assistant', 'content': reply},
    ],
)  # feeds USER_PREFERENCE / SEMANTIC / SUMMARIZATION extraction; errors are logged, never fatal
Extrait 3 : Conserver le tour afin que les stratégies d’extraction puissent enrichir la mémoire à long terme de manière asynchrone.
L’extraction est asynchrone ; ainsi, un fait mentionné dans cette session peut généralement être retrouvé dans une session ultérieure. Concevoir en tenant compte de ce retard : les événements à court terme de la session couvrent la conversation actuelle, et les enregistrements à long terme couvrent tout ce qui s’est passé avant.
En combinant tout cela : un plan d’arrosage personnalisé
C’est ici que tout le pipeline fonctionne de bout en bout. Au cours de quelques conversations, vous cataloguez tout votre jardin, une plante à la fois, en langage simple. Chaque mention devient un événement. Les stratégies d’extraction extraient des informations sur la plante, son emplacement et son exposition au soleil, et les stockent dans sprout/{chat_id}/long_term. Ce matin, l’utilisateur pose une question : « Vous vous souvenez des autres plantes de mon jardin ? » La récupération des données récupère les enregistrements, les classe par ordre, puis ils sont ajoutés au prompt du système. L’assistant répond avec l’emplacement de l’utilisateur, son exposition au soleil, la construction du lit, le comportement du sol et l’inventaire des plantes, ce qui n’apparaissait pas dans le message lui-même.
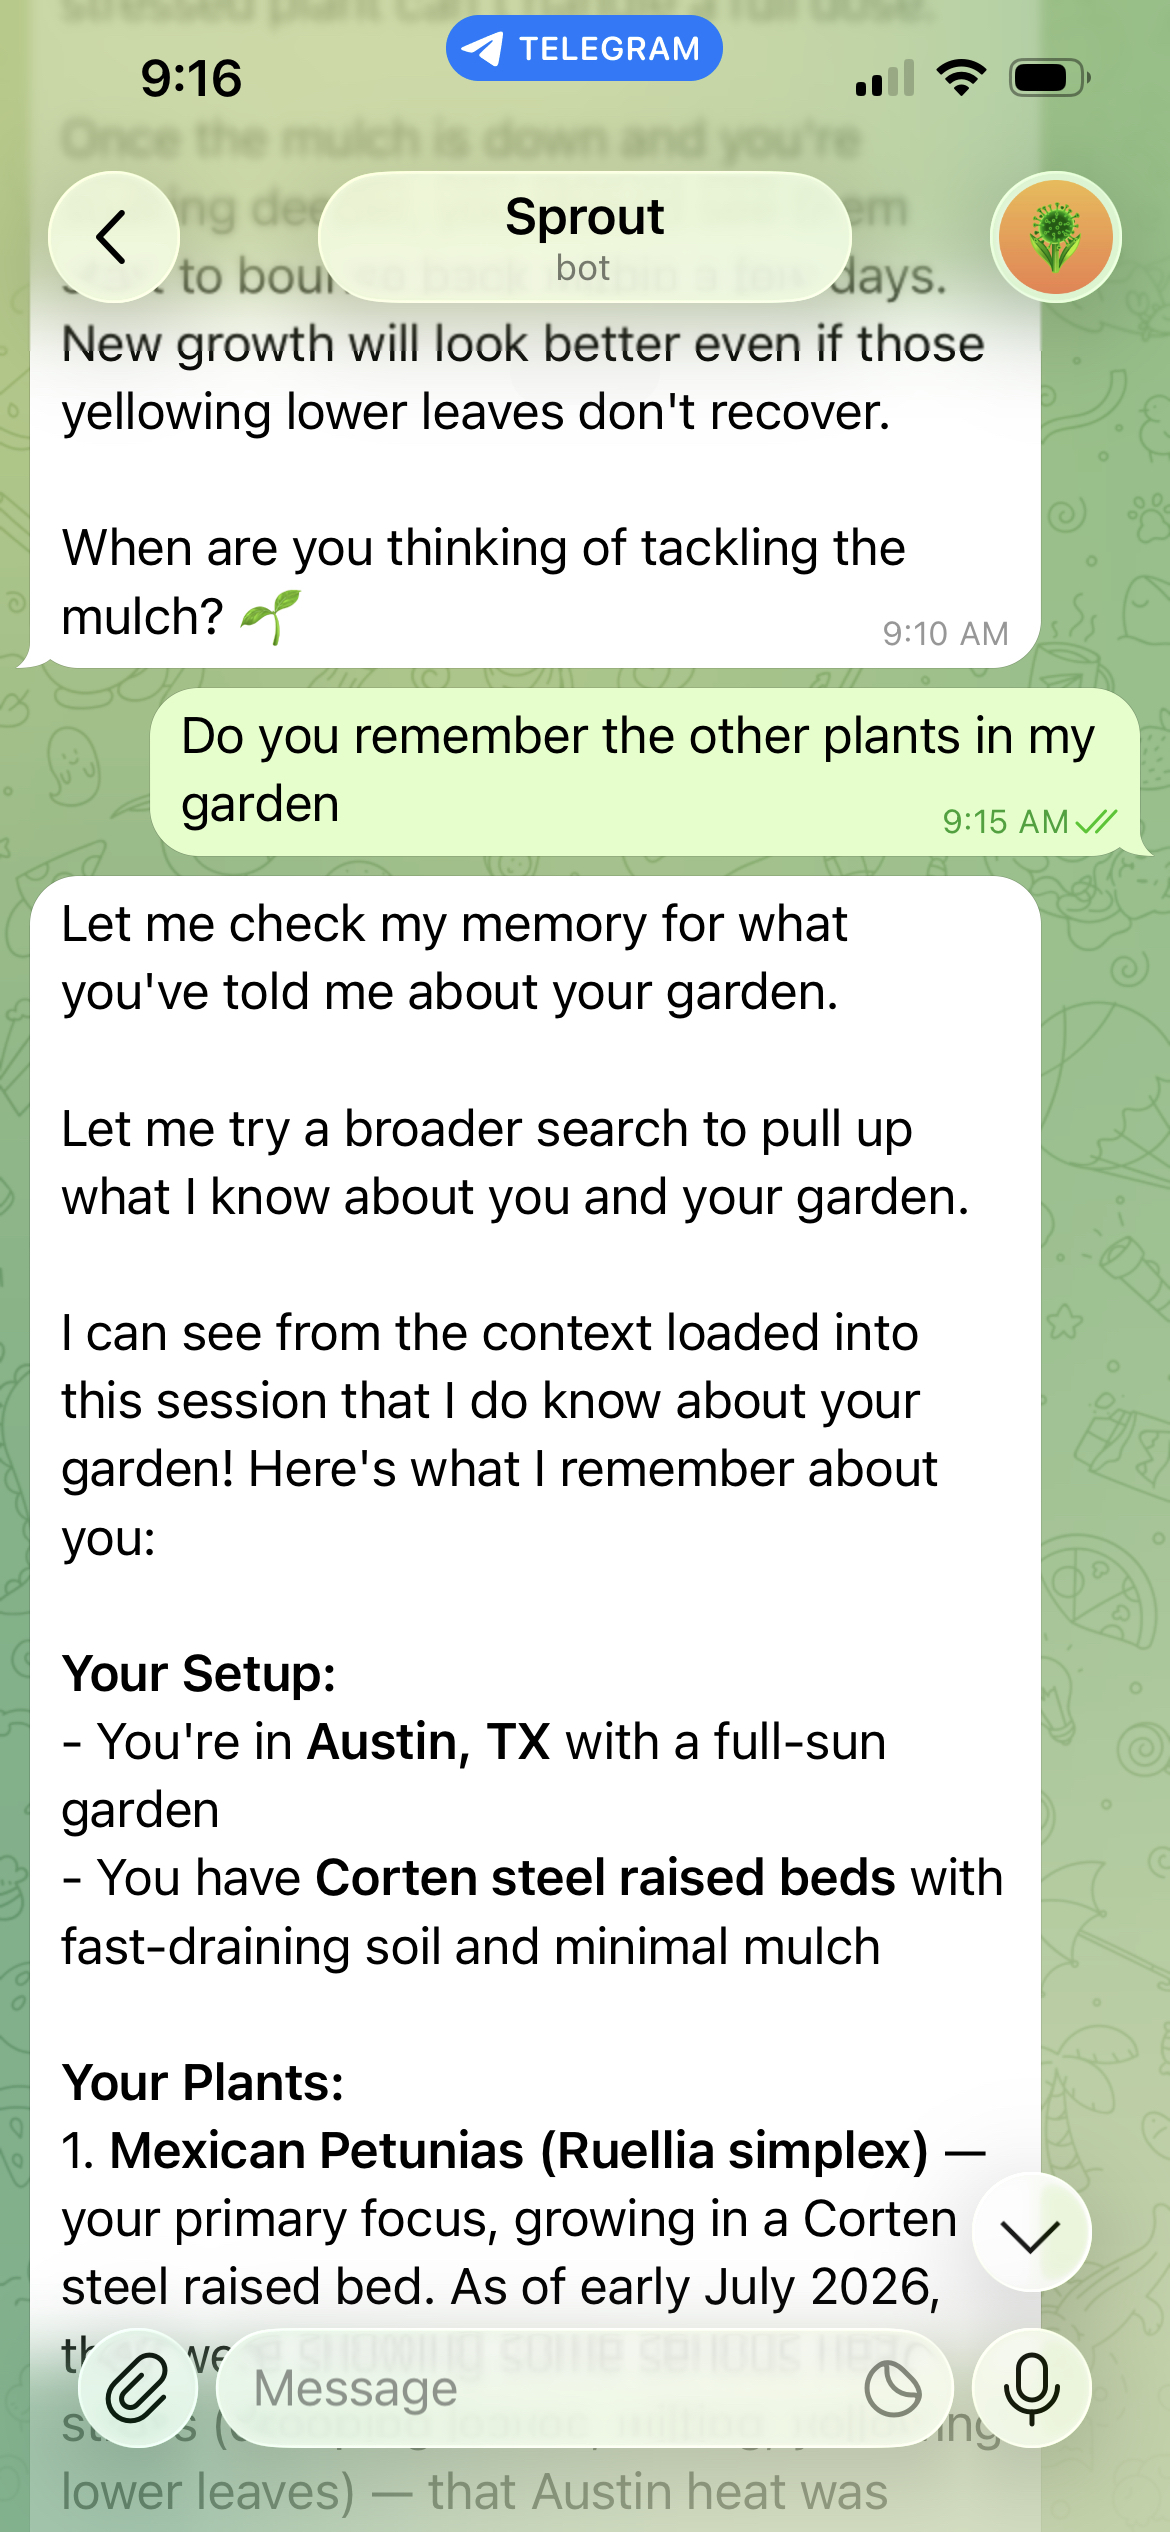
Figure 2 : Sprout répond à une question concernant le jardin en se remémorant l'inventaire des plantes stockées et les conditions de croissance.
En utilisant les compétences de planification sur le chemin Amazon EventBridge → Cron, Sprout peut également transformer ce plan en rappels proactifs (« sautez les herbes, le sol est encore humide d'hier ») et les ajuster en fonction des conditions météorologiques lorsque la pluie ou une vague de chaleur se produit.
La mémoire et la vision se combinent également. Lorsque l’utilisateur envoie une photo d’une plante flétrie, l’image est transmise à Claude Sonnet 4.5, tandis que le prompt du système conserve tout ce que la couche de mémoire connaît. L’assistant correspond la photo aux petunias mexicaines déjà stockées dans l’inventaire de l’utilisateur et diagnostique la fatigue due à la flétrissement dans le contexte, plutôt que d’analyser une photo anonyme de plante de manière froide.
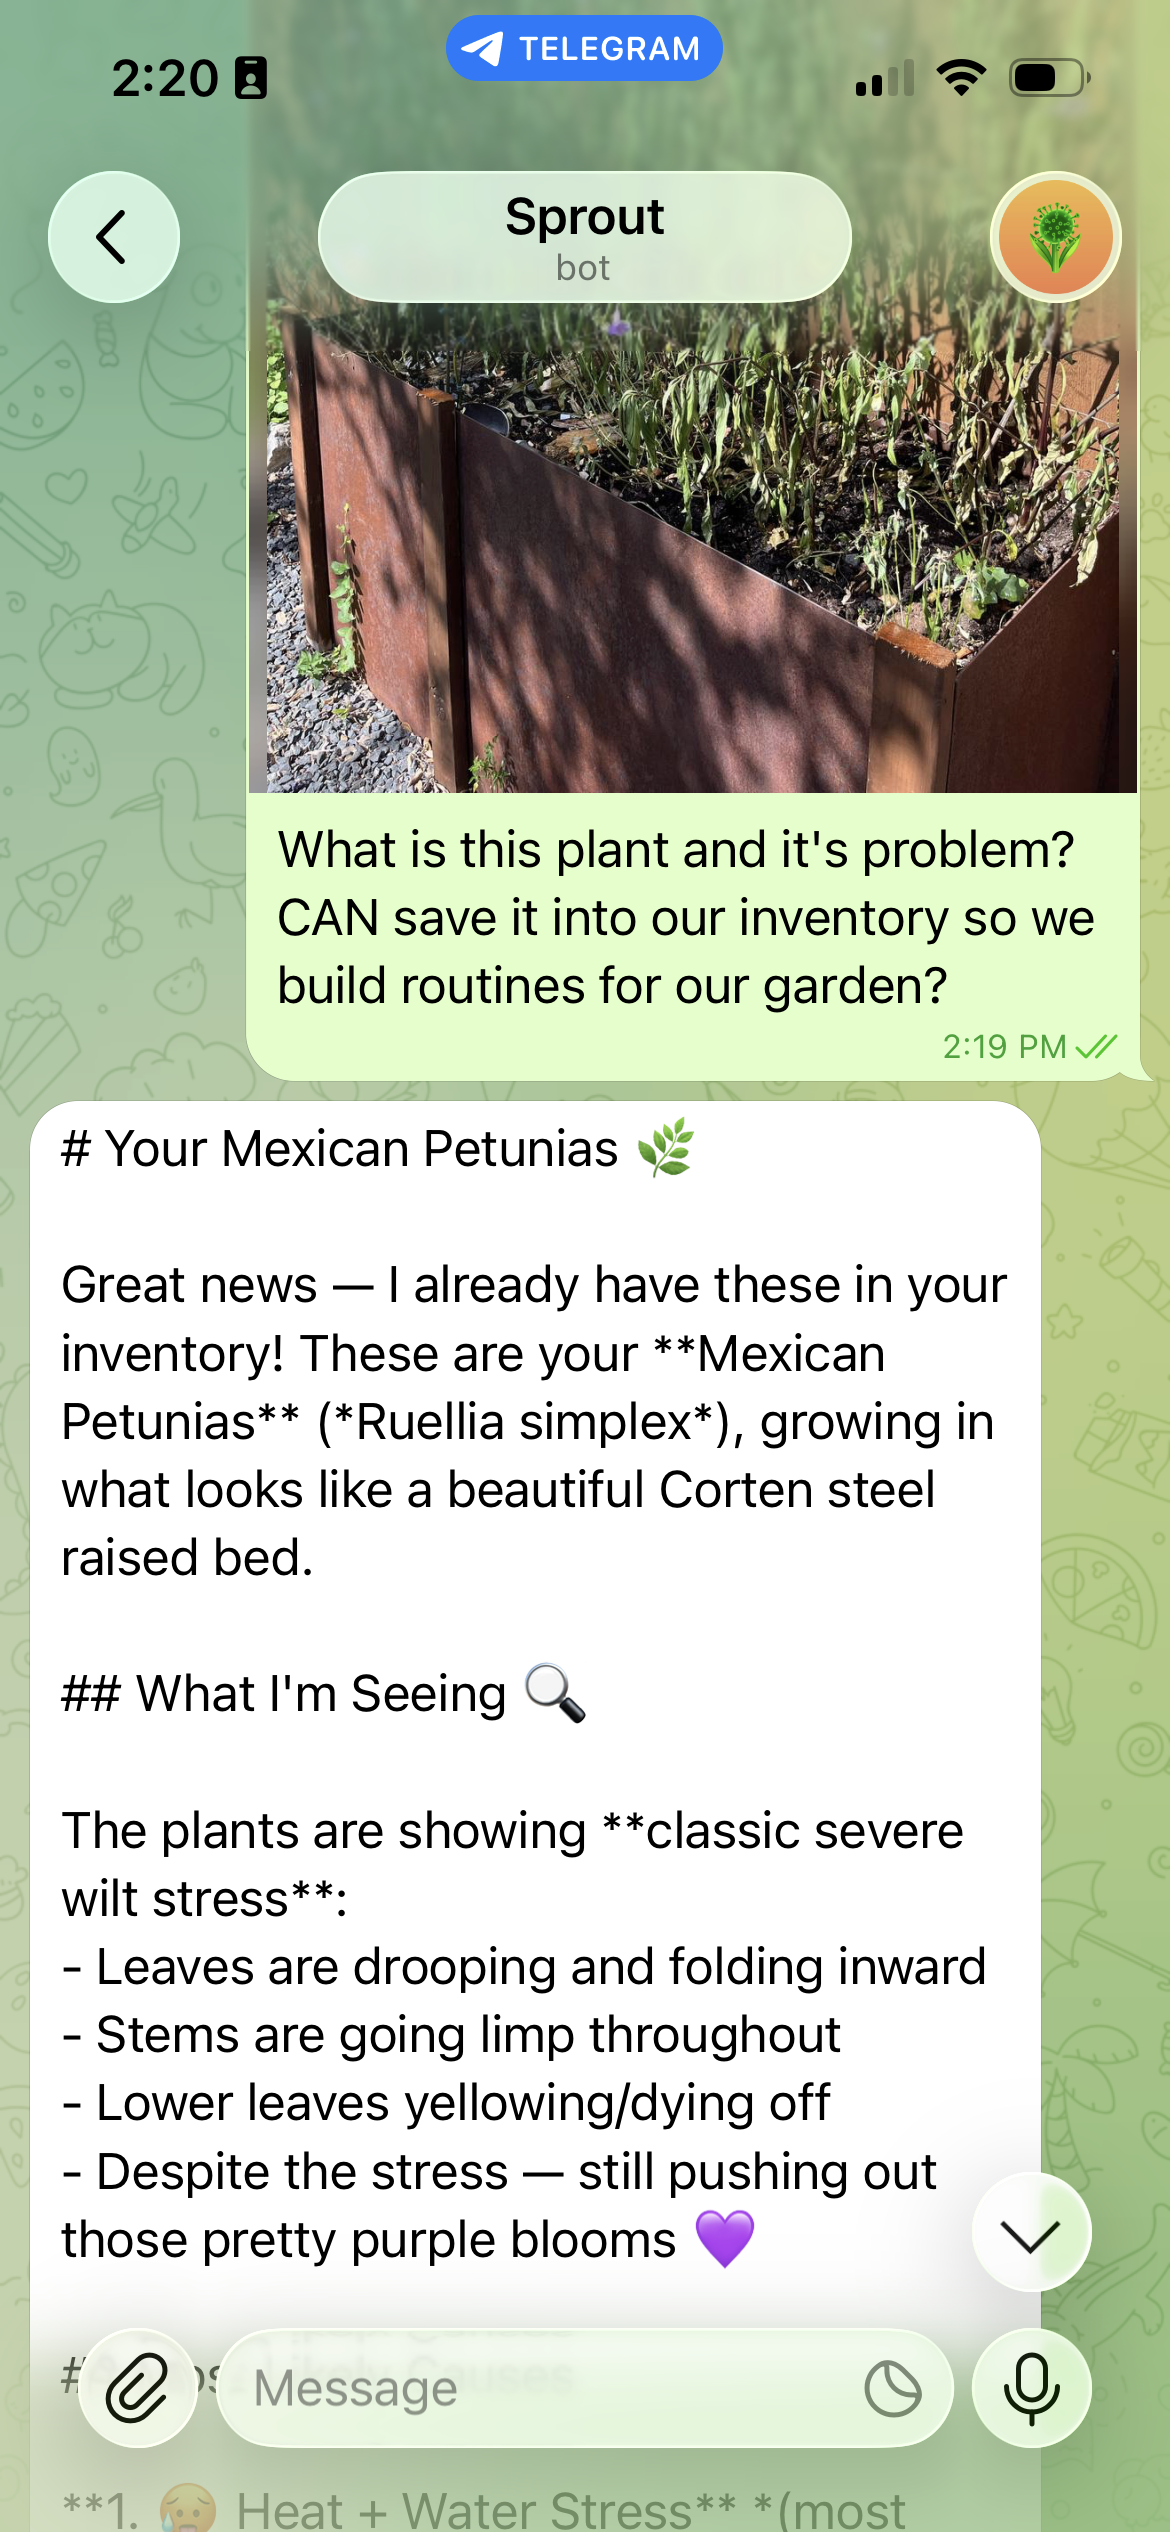
Figure 3 : La vision et la mémoire travaillent ensemble. La photo est destinée au modèle de vision, tandis que le prompt du système contient le contexte du jardin stocké par l’utilisateur.
Les modèles de vision ne sont pas infaillibles. Dans une échange antérieure sans contexte d'inventaire, la même plante a été identifiée avec confiance comme un *morning glory*, une espèce dont les fleurs violettes en forme de trompette sont similaires. L’intégration du modèle de vision avec l’inventaire stocké par l’utilisateur permet de transformer une supposition plausible en une diagnostic correcte et personnalisée, ce qui illustre bien pourquoi la mémoire améliore l’exactitude plutôt que seulement le ton.
Mettre les coûts d’inférence bas avec le stockage en mémoire des prompts
Injecter la mémoire à chaque tour rend le prompt du système plus long, et une implémentation naïve coûterait ces tokens pour chaque requête. Le stockage en cache du prompt sur Amazon Bedrock résout ce problème. L’assistant structure son prompt de telle manière que le préfixe stable, la personnalité et le bloc de mémoire assemblé viennent en premier, et le message utilisateur volatil vient en dernier. Bedrock stocke le préfixe traité entre les requêtes, de sorte que les tours répétés au cours d’une conversation ne nécessitent pas de recomputation de la partie inchangeable. Le stockage en mémoire du prompt peut réduire les coûts jusqu’à 90 % et la latence jusqu’à 85 % pour les modèles pris en charge.
La règle d’ordre est plus importante que n’importe quel paramètre individuel : mettez les contenus stables en premier, les contenus volatils en dernier, et assurez que l’ordre interne du bloc de mémoire soit déterministe (ce que la fonction d’assemblage précédente facilite), afin que le préfixe correspond réellement entre les requêtes.
Lignes directrices de conception pour la construction d’AgentCore et d’OpenClaw
Sprout est un assistant, mais les décisions qui se trouvent derrière lui sont généralisables. Si vous créez votre propre assistant utilisant cette stack, les directives suivantes seront celles que nous appliquerions dans n’importe quel domaine.
- Enroulez, ne divisez pas. Adaptez votre framework d’agent au contrat de conteneur AgentCore avec un enveloppe HTTP léger, plutôt que de modifier le framework. Le contrat est petit, port 8080 avec
/pinget/invocations, et l’enveloppe vous permet de rester sur la voie d’amélioration du framework. - Créez des espaces de noms avant de stocker quoi que ce soit. Les espaces de mémoire de noms constituent votre frontière d’isolation. Placez le identifiant utilisateur comme seule variable, et choisissez un identifiant natif du canal en lequel vous avez confiance, comme l’identifiant de chat. Les designs multi-tenant subissent finalement des audits et des demandes de suppression. Un schéma d’espace de noms propre rend les deux opérations simples.
- Traitez la mémoire comme un amélioration, et non comme une dépendance. Chaque opération de mémoire doit pouvoir échouer de manière gracieuse. Les échecs de récupération doivent produire une réponse sans mémoire, sans bloquer la réponse. Les utilisateurs pardonnent plus facilement un oubli qu’un échec.
- Modéliser les routes selon les tâches. Utilisez un modèle rapide et économique pour les textes à grande volumétrie, et réservez un modèle multimodal plus robuste pour les actions qui en nécessitent. Conservez les IDs de modèle dans les variables d’environnement afin que les changements de routage soient de la configuration, et non du code.
- Instructions d’ordre pour le cache. La personnalité stable et la mémoire viennent en premier, puis les entrées utilisateur volatiles en dernier, avec un ordre déterminist tout au long. C’est cette habitude structurelle qui permet de gagner en temps d’inférence.
- Plan pour la latence d'extraction. La mémoire à long terme est extraite de manière asynchrone, donc ne promettez pas une récupération des nouveaux faits pendant la même session. Les événements de la session courte couvrent la conversation actuelle, et les enregistrements à long terme couvrent ceux précédents.
- Fixez un budget dès le premier jour. Un agent basé sur la consommation est peu coûteux jusqu’à ce qu’une boucle de réessai ou un utilisateur actif fasse autrement. Les alertes AWS Budgets à 80 % et 100 % du plafond mensuel ne coûtent rien et permettent d’identifier les anomalies tôt.
- Maintenez les compétences petites et à un seul but. Une compétence doit faire une seule chose que l’utilisateur pourrait exprimer en une phrase, comme vérifier le temps ou mettre un rappel. Les compétences petites sont testables indépendamment, interchangeables indépendamment, et faciles pour le modèle à choisir correctement. Une compétence qui fait tout oblige le modèle à deviner quelle de ses actions vous avez voulu.
Faites pousser votre propre chose
Deux manières de le planter, même jardin :
- Stack de lancement à une étape : le modèle CloudFormation pointe vers une image du Amazon Elastic Container Registry (Amazon ECR) public, de sorte qu’il ne déploie rien d’autre que le token de bot de Telegram.
- Construisez votre propre image : Le script scripts/
deploy.shvalide le modèle, crée et envoie votre propre image ARM64 dans votre répository privé Amazon ECR, déploie l’ensemble des composants et enregistre le webhook Telegram, pour un processus de construction entièrement personnalisable.
L’utilisation personnelle légère coûte environ 5–9 dollars par mois en juillet 2026 (environ 2 dollars pour l’infrastructure, 1–3 dollars pour le texte Haiku, 2 dollars pour la vision sonnet). Un budget AWS intégré alerte à 80 % et à 100 % de la limite que vous avez défini.
Le code source complet est disponible dans le répertoire GitHub sample-agentcore-memory-openclaw.
Nettoyer
Lorsque vous avez terminé les expériences, détruisez tout pour éviter les frais en cours. Comme tout le système fait partie d’une pile CloudFormation, la nettoyage consiste principalement en une simple suppression :
- Supprimer la pile CloudFormation. Cela supprime l’agent de runtime AgentCore, le API Gateway, les fonctions Lambda, l’emploi du temps d’Amazon EventBridge et les rôles d’AWS Identity and Access Management (IAM) associés.
- Supprimer le stockage de mémoire de AgentCore (et ses espaces de noms) afin qu’aucune donnée utilisateur ne soit conservée.
- Supprimez toutes les images que vous avez ajoutées au répertoire privé ECR, ainsi que le répertoire lui-même si celui-ci n’est plus nécessaire.
- Supprimez l’alerte de budget AWS si vous l’avez créée en dehors de la stack.
- Anéantir le webhook de Telegram (ou supprimer le bot via BotFather), et annuler l’accès au modèle Bedrock si vous ne en avez plus besoin.
Conclusion
Le noyau réutilisable de cette solution est un agent sans serveur sur Amazon Bedrock AgentCore, doté d’un système de compétences et de mémoire gérée. La mémoire de AgentCore élimine la nécessité de créer des magasins de vecteurs personnalisés et des pipelines d’extraction, tout en vous permettant un contrôle total sur ce que l’agent retient ou oublie. Le calcul basé sur la consommation, ainsi que le stockage en cache des prompts, permettent d’obtenir un assistant véritablement personnalisé pour quelques dollars par mois. Les manifestes de compétences OpenClaw rendent tout ce modèle portable entre différents domaines. La personnalisation se renforce également : plus l’utilisateur interagit, plus l’assistant devient utile.
Pour aller plus loin, commencez par un seul domaine, comme les rappels d’arrosage, puis élargissez progressivement la portée de la mémoire. Explorez également la mémoire épisodique afin que l’agent puisse se remémorer des conversations passées spécifiques (« la dernière fois que nous avons discuté de l’arbre à figues, vous avez décidé de ne pas utiliser d’engrais »). Ou bien Forkez le repositaire, insérez votre propre personnage et compétences, et développez l’assistant dont vous avez besoin.
Pour en savoir plus, veuillez vous référer à la documentation de AgentCore. Les articles correspondants suivants abordent les éléments fondamentaux de manière plus approfondie :
- La mémoire de Amazon Bedrock AgentCore : Construction d’agents sensibles au contexte
- Construire des agents d’IA plus intelligents : Enquête approfondie sur la mémoire à long terme d’AgentCore
- Utiliser efficacement le stockage du prompt sur Amazon Bedrock
- Lancer et scaler sécuritairement vos agents et outils sur Amazon Bedrock AgentCore runtime