
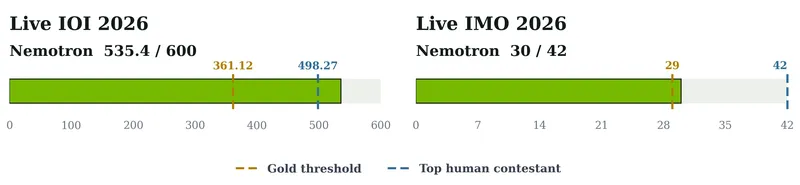
L’Olympiade internationale en informatique (IOI) et l’Olympiade mathématique internationale (IMO) mettent à l’épreuve des différentes compétences. L’IOI exige des algorithmes et du code qui doivent réussir des tests cachés dans des limites strictes de temps et de soumission. L’IMO requiert des preuves rigoureuses en langue naturelle. Réussir à l’une ou l’autre compétition est difficile. Réussir aux deux permet d’atteindre quelque chose de plus large.
Nos résultats récents montrent que Nemotron est une base solide et adaptable pour la construction de modèles spécialisés de classe mondiale. À partir de Nemotron 3, nos équipes ont utilisé le fine-tuning supervisé (SFT), l'apprentissage par renforcement (RL) et l'inference guidée par retour d'information pour créer des systèmes qui ont atteint le niveau de médaille d'or à tantôt IMO 2026 tantôt IOI 2026.

| Compétition | Nemotron spécialisation | Résultat |
|---|---|---|
| IOI 2026 | Nemotron-3-Ultra-CC avec SFT et GenCorrect | 535.4/600, au-delà du seuil en or de 361.12 et la meilleure note humaine de 498.27 |
| D’après moi 2026 | Nemotron 3 Ultra général, SFT et points de contrôle RL dans un système de génération-verification-réfection | 30/42, au-dessus du seuil officiel en or de 29 |
Le résultat de l’IOI provient d’une exécution en direct, prospective, dans les mêmes contraintes de temps, d’accès à Internet et de soumission que celles des participants humains. Il s’agit d’un benchmark non officiel, sans supervision, et n’a pas été inclus dans le classement officiel de l’IOI. Les preuves soumises par le système IMO ont été évaluées par des évaluateurs officiels IMO.
Une recette de spécialisation réutilisable
« Facile à affiner » signifie plus que simplement rendre un point de contrôle traitable. Cela signifie qu’un modèle de base compétent peut être adapté à un domaine exigeant grâce à une méthode claire et réutilisable.
Dans les deux projets, cette recette comprenait quatre parties :
- Commencez par un modèle de base Nemotron robuste.
- Curation de problèmes spécifiques au domaine et de traces de raisonnement de haute qualité.
- Appliquez des méthodes standard après la formation, telles que l’SFT, et, lorsque nécessaire, le RL.
- Associez le modèle spécialisé à un cycle d’inférence qui génère, évalue et améliore les réponses candidates.
Les exercices d’entraînement et d’inférence ont été importants, mais l’approche de base est familière et reproductible. Nous n’avons pas eu besoin de créer un nouveau modèle de fondation pour chaque défi. Nous avons spécialisé Nemotron pour cette tâche.
De la capacité générale de codage à l’or du IOI
Pour les programmes de compétition, nous avons sélectionné 22 000 problèmes et généré des traces de raisonnement synthétiques pour entraîner deux spécialistes. Nemotron-3-Nano-CC, avec 30 milliards de paramètres totaux et 3 milliards de paramètres actifs, a bénéficié à la fois de SFT et de RL. Nemotron-3-Ultra-CC, avec 550 milliards de paramètres totaux et 55 milliards de paramètres actifs, a bénéficié de SFT.
La progression sur IOI 2025 rend la valeur de la spécialisation facile à voir. Nano a amélioré de 130 points avant le entraînement à 280 après SFT et 291 après RL. Avec GenCorrect, notre stratégie d’ génération-évaluation-ajustement itérative, il a atteint 468 points et a franchi le seuil doré de 438,3. Ultra-CC a atteint 502 points avec la même stratégie au moment de l’essai.

Ces expériences ont également montré que l’adaptation ne doit pas avoir la même apparence à toutes les échelles. Le SFT a produit la plupart des gains de Nano, tandis que le RL a apporté une amélioration plus petite mais constante. Pour le modèle Ultra plus performant, une seule époque de SFT suffisait pour surpasser le modèle Nano entièrement post-trainé sur IOI, ICPC et LiveCodeBench Pro. Cette découverte a guidé le système Ultra-CC spécifique à la compétition utilisé lors de IOI 2026, qui a obtenu 535,4 sur 600 points.
Apprendre à utiliser Nemotron pour vérifier, corriger et réviser
Le projet IMO a appliqué la même idée à la mathématique des olympiades. À partir de Nemotron 3 Ultra, nous avons formé un spécialiste avec SFT et un autre avec RL.
Le corpus SFT contenait 414 890 exemples filtrés selon la qualité, répartis sur 15 818 problèmes de démonstration uniques. Il ne se contentait pas de transmettre les réponses finales. Les données couvraient la génération de preuves, leur amélioration, leur vérification et la vérification métadonnée ; ainsi, le modèle a appris à construire des arguments, identifier les lacunes, répondre aux critiques et juger si une preuve était complète. Le modèle de RL a été entraîné sur 9 597 problèmes de démonstration choisis près de la frontière capacité du modèle.
Les deux points de contrôle après entraînement ont surpassé le modèle d’accès général dans les expériences de développement. Le point de contrôle SFT était le plus fort lors de la première ronde de recherche, tandis que le point de contrôle RL a obtenu le meilleur résultat global pour un seul point de contrôle. Leurs forces étaient complémentaires, ainsi le système final utilisait à la fois les spécialistes et le modèle général.
Pour chaque problème de l’IMO, les modèles généraient des preuves candidates, les évaluaient, produisaient des critiques et affinaient les tentatives les plus prometteuses. Une étape distincte nécessitant une grande puissance de calcul sélectionnait la soumission finale. Tout le système fonctionnait en langue naturelle, sans prover formel, outils externes ou accès à Internet. Il a obtenu 30 points sur 42, y compris quatre points complets pour les six problèmes, et a dépassé le seuil officiel de médaille d’or.

Le fine-tuning et le calcul en temps de test fonctionnent ensemble
Notre article précédent sur Hugging Face pour l’IOI 2025 a montré comment le calcul en temps de test peut amener les modèles à poids ouvert à un niveau de performance équivalent à celui des médailles d’or. Les nouveaux résultats ajoutent une pièce importante : une meilleure spécialisation offre au système d’inférence de meilleurs candidats, de meilleurs critiques et de meilleures améliorations.
À IOI, GenCorrect a transformé les gains obtenus lors du fine-tuning en améliorations plus significatives au cours de plusieurs cycles de retour d’information. À IMO, l’utilisation de points de contrôle SFT et RL complémentaires était plus utile que la simple collecte de plus de données à partir d’un seul point de contrôle. Dans les deux cas, le meilleur résultat a été obtenu en combinant un spécialiste compétent avec un système capable de rechercher, vérifier et améliorer.
Cette distinction est importante. Les médailles n’ont pas été produites uniquement par une mise en œuvre minutieuse, et elles n’ont pas été produites uniquement par un échantillonnage forcé. Elles proviennent de la co-conception du modèle, des données et du cycle d’inférence.
Modèles ouverts, données et recettes sur Hugging Face
Nous voulons que ces résultats soient utiles au-delà des compétitions. La collection Nemotron Labs IMO 2026 regroupe les checkpoints SFT et RL, ainsi que les jeux de données d’entraînement, et Nemotron-IMO-Bench, un nouveau benchmark comprenant 200 problèmes de niveau olympiade. Le article IMO décrit l’approche d’entraînement et le système de génération-verification-amélioration, tandis que le répertoire NeMo-Skills contient la pipeline d’inférence IMO, les prompts, les preuves soumises et un quickstart reproductible. Pour le programming compétitif, le modèle Nemotron-3-Ultra-CC est disponible sur Hugging Face, et l’article IOI fournit la recette d’entraînement et la méthodologie GenCorrect. La pipeline d’évaluation et d’inférence IOI est également disponible dans NeMo-Skills.
Ensemble, IMO et IOI fournissent des preuves exceptionnellement exigeantes pour une idée simple : Nemotron peut être affiné en spécialistes de domaine de classe mondiale, puis composé avec des flux de déduction transparents afin de résoudre les problèmes à la frontière de la compétition humaine.
Nous sommes enthousiaste de voir ce que la communauté Hugging Face construira ensuite.