
La semaine dernière, je voulais une version miniature du rewriter de prompts qui est incluse dans Qwen-Image 2.1. La version officielle est un modèle de 9B qui nécessite environ 20 Go de mémoire et réfléchit pendant des milliers de tokens avant d’écrire un seul paragraphe. Sur Hub, je n’ai trouvé que des copies compressées du même modèle de 9B. Alors j’ai décrit ce que je voulais pour ML Intern ; le lendemain, j’ai reçu une version de 0,8B qui fonctionne sur un CPU. Elle produit une sortie valide à 99,7 % des fois et utilise environ un quart des tokens du modèle d’entraînement. Le calcul pour tout le projet, y compris l’étiquetage du modèle de 9B, les 8 797 demandes d’exemple et la mise en œuvre, a coûté 16 USD.
Au cours des prochains jours, j’ai créé cinq modèles supplémentaires de la même manière. Chaque modèle a commencé comme un message dans HuggingChat avec ML-intern activé, et chaque modèle se termine en tant que modèle public sur le Hub, avec son évaluation indiquée dans la carte du modèle. ML-intern planifie le travail, me demande un budget avant de dépenser quoi que ce soit, effectue une petite test avant le travail réel, puis entraîne, évalue et publie sur Hugging Face avec des équipements spéciaux.
Comment je formule les questions aux stagiaires en ML
Le premier message est où je consacre mes efforts. Ma première instruction, pour le modèle citrus partagé ci-dessous, comptait environ 450 mots. Pour mon 6e projet, elle était proche de 2 000 mots, car chaque projet m’a appris quelque chose que je voulais appliquer dans le suivant. Les sept instructions sont toutes sur GitHub à yvrjsharma/ml-intern-prompts, exactement comme je les avais écrites.
Un prompt commence par l’idée en une seule ligne et pourquoi je la souhaite. Ensuite, il nomme précisément les éléments : le jeu de données, le modèle de base, le script d’entraînement. Tout ce que j’ai déjà vérifié est placé sous un titre qui dit littéralement « Faits vérifiés, ne réinventez pas ». Ainsi, l’agent utilise son budget sur les tâches nécessaires, plutôt que de réapprendre ce que je sais déjà. Pour la section concernant le LoRA de caméra, il est indiqué quel entraîneur a ajouté le support des images transparentes, et quels problèmes ouverts sur GitHub rendent l’entraîneur de fallback risqué.
Deux lignes dans la demande sont cruciales. La première demande une base avant tout entraînement. Par exemple, la demande de prompts de citron dit : « Indiquez également le score zéro-shot du modèle de base sur la même métrique avant l’entraînement, afin que nous puissions voir les gains obtenus. » Sans cela, vous obtenez un modèle entraîné sans savoir s’il est meilleur que ce avec quoi vous avez commencé. La deuxième est une vérification de type test de fumée avec une validation ajoutée. Pour les LoRAs d’images, j’ai demandé 50 étapes d’entraînement, puis une vérification que les poids sauvegardés ont bien changé, avant de payer pour l’exécution complète.
À la fin de la demande, je définis les livrables attendus et la limite de coût. Je précisais ce qui doit figurer sur la carte du modèle, ainsi qu’une instruction comme : « Limitez le budget total à 12 USD et demandez-moi la permission avant de dépasser cette somme. » Comme les ingénieurs en IA commencent chaque tâche avec un budget nul et ont besoin de l’autorisation avant d’exécuter des tâches payantes, cette limite de dépense est strictement appliquée. Lorsqu’on omet un budget, l’agent propose plusieurs options en fonction de la taille du projet et demande lequel vous préférez.
Vous n’avez pas nécessairement besoin de tout cela lors de votre première tentative. Par exemple, je n’avais pas la section verified-facts dans mon rapport citrus, et l’assistant ML Intern a quand même produit un modèle qui a augmenté l’exactitude de Qwen3.5-2B de plus de trois fois. Laissez-moi vous montrer 6 choses que j’ai construites avec l’assistant ML Intern en seulement quelques jours.
1. Un modèle qui connaît votre domaine
Un modèle de vision générale peut décrire une feuille de citron jaunie. Cependant, déterminer si c’est un problème d’acarien ou une carence en magnésium, ainsi que les remèdes biologiques et non biologiques pour traiter la plante, est très difficile. En utilisant Claude, j’ai créé un ensemble de données d’entraînement combiné à partir de trois sources hébergées par l’organisation Project-AgML sur le Hub. Le résultat, citrus-disease-vlm-instruct, est un ensemble de données contenant 3 017 images annotées concernant 21 types différents de parasites, maladies, carences nutritionnelles et approches de traitement. ML-intern a effectué le tuning fin des Qwen3.5-2B en utilisant ces exemples, en s’assurant avant tout de tester le modèle de base.
Sur les 335 photos de test, le modèle de base identifia correctement le problème à 14,9 % des fois. Après deux époques sur un A10G, le modèle affiné obtint 52,8 %. Coût de calcul : environ 1,90 $ américains.
Voir : Modèle · Journaux de données · Application Citrus Doctor
2. Un modèle qui dessine votre personnage
Les modèles d’images connaissent de nombreux personnages. Huggy, dessiné dans le style plat des assets de la marque Hugging Face, n’en faisait pas partie. J’ai demandé à ML-Intern une LoRA sur FLUX.2 klein base 4B, entraînée sur 84 dessins accompagnés de légendes du Chunte/huggy_for_training dataset.
L’agent sauvegarde un point de contrôle tous les 100 pas et utilise le même ensemble de prompts pour chaque fois, ce qui facilite la sélection. Au pas 200, Huggy est entièrement on-model. À partir du pas 500, le style de Huggy commence à se mélanger dans les prompts qui n’ont rien à voir avec Huggy ! Le LoRA entraîné fonctionne également sur le modèle de Klein dérivé en 4 pas. Coût de calcul : environ 7,60 USD.
Voir : Modèle · Jeu de données · Application Huggy Generator
3. Un modèle qui fait un nouveau truc
- LoRAs d’angle de caméra sont parmi les ajouts communautaires les plus appréciés pour les modèles Qwen-Image antérieurs. On peut donner au modèle une image d’un objet et demander de le voir à 45 degrés de gauche. Lorsque j’ai vérifié quelques jours après la sortie du modèle Qwen-Image 2.1, personne n’avait créé un tel élément, donc j’ai demandé à un expert en ML de le développer.
L’interné en ML a généré 1 030 objets domestiques scannés depuis Google Scanned Objects, à 24 angles chacun, pour 24 722 images transparentes, sur une tâche exécutée par CPU qui a coûté quelques centimes. Par la suite, 461 objets ont été finalisés pour l’entraînement, 40 ont été conservés pour les tests, et 1 844 paires avant/après entraînement ont été réparties équitablement sur 23 instructions de caméra.
La formation a été effectuée avec 2 000 pas en environ 90 minutes sur un A100 (~3,75 $ US). Tout le projet a duré environ une demi-journée et 48 tâches, y compris celles qui ont échoué à cause de manques de packages ou de chemins incorrects, et qui ont dû être reenvoyées par le ML-Intern. Le coût total de calcul est d’environ 16 $ US.
Voir : Modèle · Jeu de données · Application Viewpoint Orbit
- Doodle-in LoRA est une autre idée intéressante. Téléversez une photo avec des griboles rouge vif, et ajoutez un court prompt désignant un objet. Le LoRA remplace les griboles par cet objet, tout en conservant la lumière et la composition originales.
Aucun jeu de données n’existait pour cela, donc mon prompt décrivait comment en créer un. On commence par une photo réelle dans Open Images, on retire un objet avec le modèle de inpainting LaMa, et on trace un trait là où se trouvait l’objet. La photo non modifiée est l’objectif. Un spécialiste en ML a écrit et testé les scripts de construction des paires dans une sandbox CPU, puis les a exécutés comme tâches GPU, en enregistrant l’auteur et la licence de chaque photo source en cours de processus. Il a construit 6 042 paires d’entraînement et un ensemble de test de 160 paires, dont 40 paires de test proviennent de 23 classes d’objets qui n’ont jamais été entraînées.
Avant l’entraînement, le modèle de base a été mesuré seul et avec le Viggle turbo LoRA. Il s’est avéré que l’exécution des modifications par lots produisait des images identiques, ce qui rendait l’évaluation moins coûteuse. L’entraînement a duré 2 000 étapes en 1 heure et 38 minutes sur un A100 (~4 USD), et une comparaison des checkpoints sauvegardés sur 48 paires de tests a mis en évidence l’étape 500.
En combinaison avec le Viggle turbo LoRA à 6 étapes, le LoRA s’est très bien débrouillé. 67,5% des objets ont été détectés là où ils étaient dessinés, en 4,7 secondes par modification. Les objets des 23 classes inconnues ont été détectés aussi fiablement que les autres (65,0 % contre 64,2 %). Le projet a duré un peu plus d’une journée et 59 tâches. Coût total de calcul : environ 24 USD.
Voir : Modèle · Jeu de données · Application Doodle-in
4. Un modèle qui s’adapte à votre appareil
- Le Pocket Rewriter mentionné en haut de cet article est le premier. Un chercheur en ML a commencé par générer 8 797 demandes d’images courtes avec un petit modèle d’instruction via des fournisseurs d’inférence, en suivant un ensemble de prompts : photos, affiches, logos, infographies, etc. Environ un tiers de ces demandes demandaient un texte exact entre guillemets, et beaucoup étaient en langues autres que l’anglais. Le modèle 9B a ensuite réécrit toutes ces images sur un A100 en 2 heures 37 minutes (~6,50 $ USD). Après filtrage pour la qualité, 1 840 exemples ont été sélectionnés pour le jeu de données d’entraînement.
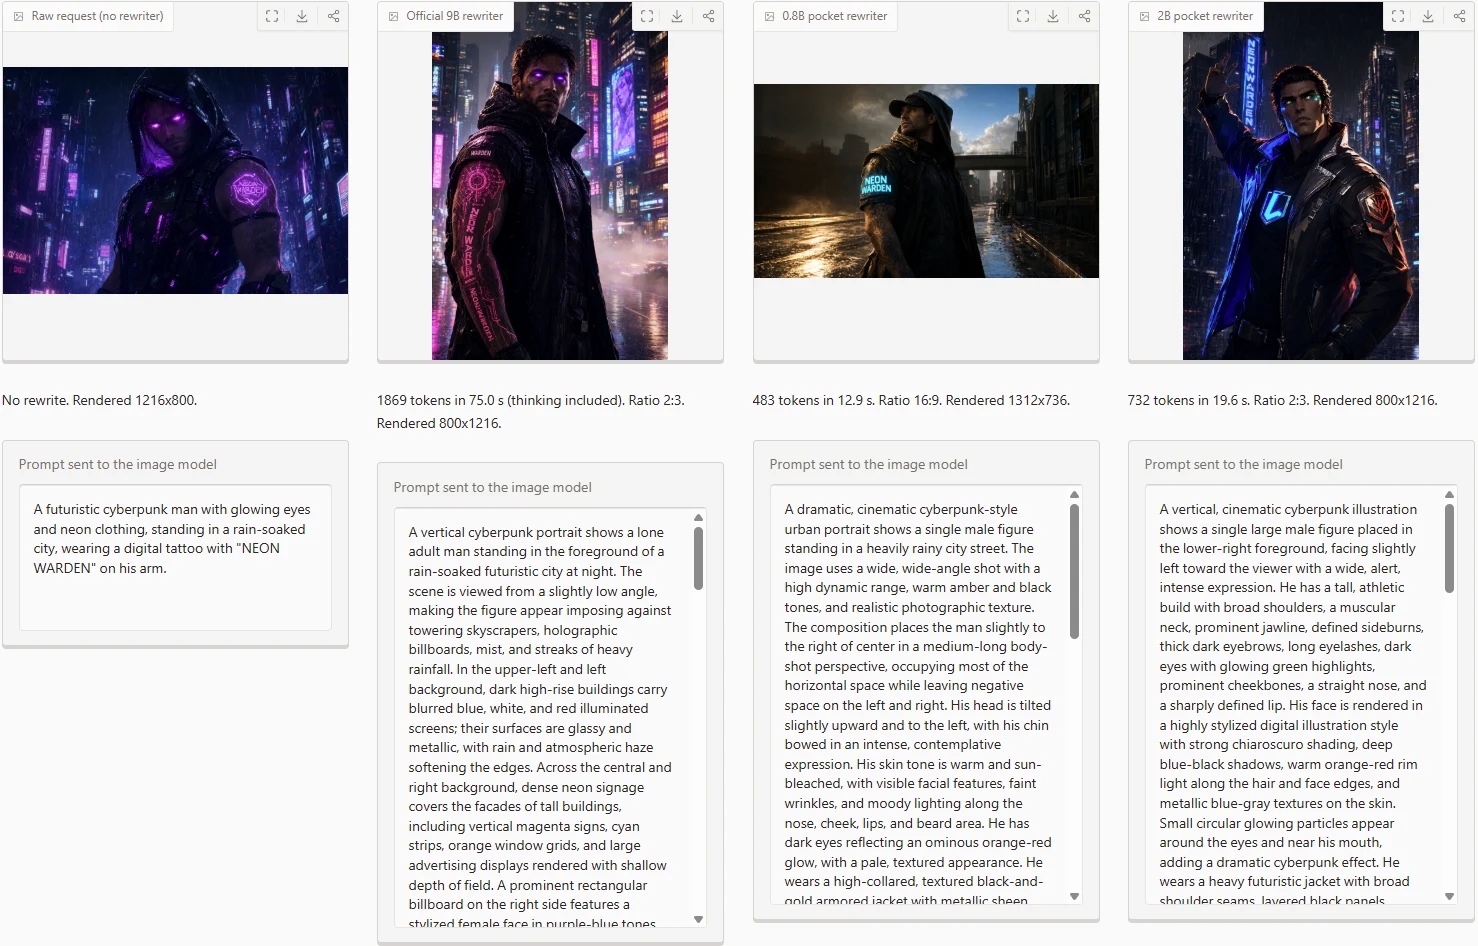
La formation des 0,8B et 2B étudiants a duré 12 et 18 minutes sur un A10G (0,75 $ pour les deux). Le 0,8B est également fourni en fichier GGUF de 812 MB pour être exécuté sur une CPU. Le projet a nécessité environ 11 heures et 24 tâches. Coût total de calcul : environ 16 $.
Voir : Pocket rewriter 0.8B Student · 2B Student · Dataset · Pocket Studio App · Comparer le professeur et l’étudiant dans Rewriter Arena
- Agate-Preview-002-4step est le deuxième. Agate Preview 002 de Logolabs est un modèle texte à image à 260M paramètres, suffisamment petit pour un navigateur, mais qui nécessite 50 étapes avec guidance, ce qui correspond à 100 passes réseau par image. J’ai demandé à un expert en ML de le simplifier à seulement 4 passes !
Il a fallu deux essais. La première tentative a stocké 155 000 images d’entraînement en format latents, a intégré la guidance dans le modèle, puis a réduit le nombre de étapes de 16 à 8 à 4, tous sur des machines A100. L’étudiant qui utilise 4 étapes a surpassé l’essai du professeur avec les mêmes 4 étapes sur GenEval et FID. Par la suite, l’ingénieur en IA l’a exporté en ONNX pour le navigateur. Cette tentative a duré environ 13 heures et a coûté 22 USD.
J’ai effectu une deuxième session d’entraînement en demandant au stagiaire en ML d’améliorer un modèle à 4 étapes un peu plus. Ensuite, j’ai généré 24 000 paires d’images supplémentaires avec l’enseignant en 16 étapes, puis j’ai affiné le modèle à 4 étapes contre ces données pendant environ une heure. GenEval est passé de 0,509 à 0,536, contre 0,563 de l’enseignant en 50 étapes, avec seulement 4 étapes (un quart du temps de calcul). Le stagiaire en ML a réexporté la version pour navigateur. La deuxième session a duré environ 8 heures. Le coût total de calcul pour les deux sessions est d’environ 37 dollars américains.
Voir : Modèle Agate 4-step · Jeu de données · Exécuter Agate dans votre navigateur · Agate 4-step LIVE
Quel est le coût
| Modèle | Modèle de base | Computer |
|---|---|---|
| Dr de l’agrumes | Qwen3.5-2B | 1,90 USD |
| Huggy LoRA | FLUX.2 petit base 4B | 7,60 $ USD |
| Pocket rewriter (0,8B et 2B) | Qwen3.5-0.8B et 2B | 16,05 $ USD |
| Viewpoint Orbit LoRA | Qwen-Image 2.1 | 16 USD |
| Doodle-in LoRA | Qwen-Image 2.1 | USD 24.30 |
| Achatte 4 étapes (deux séries) | Agate Preview 002 | USD 37 |
| Total | environ 103 USD |
Ces sont les coûts de travail GPU et CPU rapportés pour chaque session.
Créez le vôtre
ML-intern se trouve dans HuggingChat. Active le mode ML-intern et collez un prompt. Si vous voulez un point de départ, mes exemples de prompts sont à copier librement. Commencez avec un modèle que vous souhaitez avoir et un jeu de données que vous possédez, ou un modèle que vous pouvez décrire. Donnez-vous un petit budget, demandez une base de données et une test de pression, puis lisez ce qui se produit avant d’augmenter les exigences.
Si vous crée quelque chose avec cela, partagez-le sur X en taguant @Gradio et @HuggingFace. Nous aimerions voir les modèles que vous créez, que personne d’autre n’aurait pensé à développer pour vous.