
Par l'équipe Yunzhong, depuis Ao Feisi
QbitAI | Compte officiel QbitAI
Pousser un panneau, et le passage se referme ; apporter une rampe, et le haut mur devient franchissable.
Chaque action modifie le monde, et le monde modifié devient le point de départ de la prochaine décision de l'agent.
Lorsqu'un tel monde peut être construit par du code et dessiné en temps réel par un modèle de diffusion, l'IA dispose alors d'une « arène d'essai » qu'elle peut explorer à répétition : agir elle-même, observer les conséquences, vérifier ses hypothèses, puis rapporter son expérience au tour suivant.
C'est AgentGarten, la dernière création de l'équipe MirroS. Elle connecte un environnement de code exécutable à un moteur de rendu neuronal en temps réel : le code définit les règles physiques, le modèle génère le retour visuel, avec un débit supérieur à 30 fps, permettant à l'agent d'interagir en continu avec le monde.
Dans l'expérience classique de cache-cache, les changements surviennent rapidement. Le caché apprend à déplacer le panneau pour se construire un abri au tour 4, et le chercheur maîtrise le franchissement du mur grâce à la rampe au tour 10. Après un saut raté, le chercheur rapproche même activement la rampe, ajuste sa position et réessaie.
Ce qui anime l'évolution de ces stratégies, c'est le « manuel d'expérimentation » rédigé par les agents eux-mêmes.
À la fin de chaque tour, ils analysent leurs tentatives, consignent leurs découvertes et notent leurs questions ; au tour suivant, ils poursuivent l'exploration en s'appuyant sur ces acquis.
Le code permet au monde de fonctionner, le rendu en temps réel rend le monde visible, et l'entraînement continu permet d'accumuler l'expérience.
AgentGarten relie ces trois éléments en une boucle fermée, afin d'explorer une question plus vaste :
Lorsqu'un agent possède un monde où il peut agir, se tromper et accumuler de l'expérience, comment l'intelligence y évoluera-t-elle de manière continue ?
Blog complet : https://mirros.ai/blog/worlds-for-evolving-agents
Rapport technique : https://mirros.ai/report/agent-garten.pdf
Code : https://github.com/MirroS-Lab/AgentGarten
Page du projet : https://mirros-lab.github.io/agent-garten
Ce qui manque aux agents, c'est un monde où s'entraîner à répétition
Pour que l'IA comprenne réellement le monde physique, il est loin de suffire de lui montrer d'immenses quantités de vidéos. Comme on ne peut pas apprendre à nager en regardant seulement des enregistrements, les agents doivent eux-mêmes « descendre sur le terrain », c'est-à-dire agir, observer les résultats concrets, puis décider de la suite.
Il faut donc un environnement doté d'une causalité physique déterministe : la caisse poussée doit rester en place, le passage bloqué doit rester impraticable, et toutes les actions ultérieures doivent être continuellement contraintes par ces changements physiques.
Les deux voies technologiques dominantes actuelles ont chacune leurs limites :
Les environnements traditionnels à base de moteurs de code ou de jeuxoffrent des états précis et des règles transparentes : chaque collision physique est parfaitement claire.
Mais leur faiblesse réside dans l'image : les scènes construites par programmation ne présentent souvent que des maillages géométriques bruts et des textures répétitives. Pour donner à des centaines, voire des milliers de scènes ouvertes un rendu photoréaliste en matière de lumière et de matériaux, il faudrait un investissement en modélisation artistique et en ingénierie proprement astronomique.
Les modèles du monde centrés sur la génération vidéo(comme les grands modèles vidéo de tous types), peuvent certes générer des images haute définition époustouflantes et produire les images suivantes en fonction des actions.
Mais le problème, c'est que l'information physique est entièrement enfouie de manière implicite dans la mémoire du réseau de neurones, sans fournir d'état explicite consultable ou modifiable. Vous voulez savoir combien d'eau il reste dans un verre, faire serrer une vis par un bras robotique, ou définir un ensemble strict de règles d'arbitrage de tâches ? Dans une simple boîte noire vidéo, c'est une tâche quasi impossible.
La solution de MirroS se résume ainsi :faire jouer à chacun son rôle : la physique confiée au code, la lumière confiée au modèle neuronal.
Le code fait avancer le monde, le modèle se charge de « l'apparence »
Dans AgentGarten, une boucle d'interaction standard fonctionne ainsi :
L'agent donne une instruction d'action ; l'environnement de code calcule immédiatement les collisions physiques et les mises à jour d'état, puis exporte depuis le point de vue de la caméra à la première personne de l'agent un « croquis géométrique » léger (c'est-à-dire la profondeur spatiale ou les normales de surface) ;
Ensuite, le moteur de rendu neuronal lit ce croquis géométrique, le combine avec les souvenirs visuels antérieurs, et rend instantanément l'image suivante photoréaliste qu'il transmet à l'agent.
△Figure 2 | Boucle d'échange entre l'environnement de code et le moteur de rendu neuronal. L'agent émet une instruction d'action, le monde de code met à jour l'état et exporte les conditions géométriques, et le moteur de rendu neuronal génère en temps réel l'observation visuelle suivante.
Cette division du travail apporte deux bonds qualitatifs majeurs :
Premièrement, les règles physiques restent toujours « déterministes et contrôlables ».
La disposition des scènes, la détection des contacts et l'issue des parties sont toutes tranchées par le code, sans produire aucun « physique hallucinatoire ».
Deuxièmement, la construction d'un monde entièrement nouveau devient extrêmement rapide.
Construire par le passé 100 environnements de simulation réalistes exigeait une équipe d'artistes professionnels pour la modélisation, l'habillage des textures et l'éclairage, avec des coûts difficilement supportables. Dans AgentGarten, il suffit de pouvoir produire de simples contours de profondeur et de normales en 3D pour que n'importe quelle scène codée de manière minimaliste puisse être directement traitée par ce moteur de rendu neuronal, obtenant instantanément des ombres, lumières et matériaux réalistes. Vol en wingsuit, manipulation par bras robotisé, cuisine, course automobile à plusieurs véhicules : tout repose en couche basse sur la même interface visuelle — le coût d'expansion des environnements virtuels passe pour la première fois d'un « travail artistique à forte intensité de main-d'œuvre » à une « extension programmatique par le code ».
△图3|世界 physique diversifié à travers les tâches. Couvre la navigation spatiale, la manipulation d'objets, les mouvements de caméra avec re-prises de vue et les interactions multi-véhicules. À gauche, le modèle blanc simplifié exporté par le code ; à droite, le rendu visuel réaliste généré en temps réel par le moteur de rendu.
Plus crucial encore, ce moteur de rendu estGénération en continude : l'action avance d'un pas, l'image est générée d'un segment, l'agent observe clairement le résultat avant de prendre la décision suivante, et l'interaction s'écoule vraiment de manière continue comme dans le monde réel.
Retour sur Cache-Cache : 25 millions de parties et 4 cycles
Le monde est construit ; ce qu'il faut maintenant observer, ce sont les agents : dans un tel monde, en agissant et en tirant les leçons de ses expériences de façon répétée, peut-il s'améliorer de lui-même au fil du temps ?
Une référence classique est l'expérience de cache-cache d'OpenAI en 2019 : les cachettes et les chercheurs s'affrontaient sur un terrain équipé de rampes et de plans inclinés ; après un entraînement massif en auto-apprentissage par le jeu, ils ont successivement appris à construire des abris et à utiliser les rampes pour franchir les murs.
L'équipe MirroS a refait cette expérience dans AgentGarten, avec un cadre en tête-à-tête : le cacheur prépare d'abord la scène, puis c'est au tour du chercheur d'entrer en jeu.
Les règles du duel sont claires et pures : le cachetteur commence par disposer la scène pour bloquer les entrées, puis le chercheur entre en scène pour fouiller. L'agent contrôle ses déplacements et ses saisies en écrivant du code Python, et prend ses décisions uniquement à partir des images générées sous ses yeux, sans aucune connaissance des coordonnées spatiales ni de la position de son adversaire.
Les deux parties sont parties d'un manuel totalement vierge, chacune maintenant une bibliothèque de stratégies composée de compétences individuelles. Chaque cycle de confrontation comprend dix parties, suivies d'un débriefing pour capitaliser les enseignements ; au cycle suivant, une partie de la bibliothèque de compétences est tirée au hasard et appliquée.
Rapidement, ces stratégies de jeu classiques ont émergé l'une après l'autre en quelques manches : déplacer la barrière pour bloquer la porte, transporter la rampe pour construire un pont, et, après un échec à franchir le mur, rapprocher la rampe et réessayer.
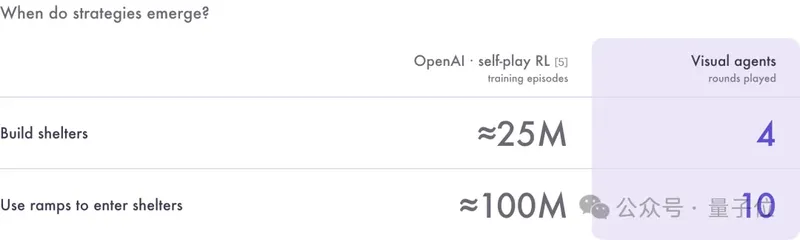
L'étude de 2019 est célèbre pour l'émergence de ces comportements classiques et offrait également un point de comparaison intuitif (voir figure 4) : dans cette étude, l'IA, s'appuyant sur un apprentissage par renforcement à partir de zéro, a découvert la construction d'abris après environ 25 millions de parties, et a appris à franchir des murs à l'aide de rampes après environ 100 millions de parties.
Alors que dans AgentGarten, les agents font face à des images en vue à la première personne, passant en revue et révisant des manuels écrits entre les tours : les cachéteurs ont appris à construire des abris au tour 4, et les chercheurs ont maîtrisé le franchissement de murs à l'aide de rampes au tour 10.
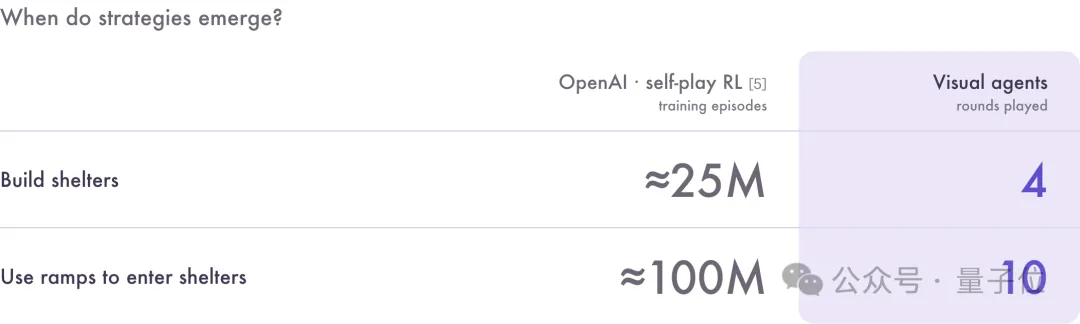
△Figure 4|Comparaison de l'échelle des parties jouées avant l'apparition des stratégies représentatives. L'apprentissage par renforcement en auto-jeu s'entraîne à partir de zéro sur des états physiques privilégiés pendant des dizaines à des centaines de millions de parties ; l'agent MirroS agit à partir de rendus à la première personne et maîtrise rapidement les stratégies correspondantes en quelques tours grâce à la réflexion manuelle tour par tour.
Jouer tout en prenant des notes, consigner son expérience par écrit
Les progrès rapides dans Hide-and-seek reposent sur un flux d'entraînement générique.
L'approche de MirroS est la suivante :Laisser l'agent prendre lui-même des notes。Tout ce qu'elle a appris en termes de connaissances est consigné dans une série de manuels.
L'exercice est divisé en quatre étapes progressives rigoureuses :
- Réception de la mission: recevoir un document de mission, clarifier les objectifs de l'action et les lignes rouges à respecter, mais sans aucune réponse type.
- Tâtonnement à l'aveugle: agir de manière autonome sous de strictes limites de pas et de temps. Seules les images de la caméra sont disponibles, pas de coordonnées divines, pas de mini-carte, et le score reste invisible avant la fin.
- Rédaction du manuel: à la fin d'un cycle, faire son auto-analyse et consigner honnêtement : ce que l'on a tenté, les phénomènes observés, quels jugements sont douteux, et quelles nouvelles hypothèses vérifier la prochaine fois.
- Archivage et transmission: le manuel est archivé et figé, puis transmis tel quel comme héritage a priori à l'agent du cycle suivant.
En parcourant ces manuels rédigés par les agents, on découvre qu'ils ont une véritable couleur d'enquête scientifique. Le modèle distingue rigoureusement « ce qui a été observé sur le terrain » des « spéculations imaginées », et prend même soin d'annoter à l'attention des successeurs des guides anti-pièges :
- Le cachotier a résumé une vérité issue de l'expérience : «l'essentiel de la défense consiste à boucher les passages, et non seulement à bloquer la ligne de vue», avertissant les successeurs de s'appuyer sur les angles morts pour réduire les failles, et de tester l'efficacité du blocage par de petits déplacements ;
- Le chercheur a dégagé une loi de contrôle : «avant de déplacer un objet, tirez d'abord dessus pour tester, ne prenez pas un objet coincé pour un objet bien saisi» ; après s'être approché, il appuie d'abord sur la touche de micro-traction pour voir si l'objet bouge par rapport aux repères de la pièce, afin de vérifier s'il est réellement saisi ;
- L'avertissement d'un conducteur traversant un pont est encore plus frappant : «le disque cible glisse dans l'angle mort de l'avant du véhicule, cela ne signifie pas pour autant que le véhicule soit déjà arrivé en toute sécurité”。
Les expériences ayant résisté à l'épreuve sont reprises par les successeurs, tandis que les leçons des échecs les poussent à explorer de nouvelles branches stratégiques.
La même boucle, rejouée dans quatre autres mondes
Hide-and-seek n'est qu'un point de départ. Parce que le monde du code est fondamentalement un environnement logiciel programmable, la même boucle « exploration — bilan — capitalisation » peut être facilement répliquée dans bien d'autres scénarios complexes.
L'équipe a également exécuté quatre sessions d'entraînement dans quatre autres mondes totalement différents :
- Accompagnement du chiot: l'agent doit maintenir l'affection d'un chiot en 60 secondes en tendant la main pour le caresser et en jouant avec une balle au bon moment. Le score est passé de 13 points au premier tour à 19 points au 4e tour.
- Croisement sur un pont étroit: deux véhicules négocient pour se laisser passer en s'appuyant sur la vue à la première personne du conducteur, en se croisant sur une voie étroite à sens unique en un temps aussi court que possible pour échanger leurs positions aux deux extrémités. Le temps total de passage des deux véhicules a été fortement réduit de 71 secondes à 41 secondes.
- Bergerie coopérative: deux chiens de berger, en se coordonnant uniquement grâce à leur propre vision, ont conduit quatre moutons dans l'enclos et les y ont maintenus pendant 5 secondes. Du tour 1, où le temps était dépassé avec seulement trois moutons parqués, aux trois derniers tours où tous les moutons ont été parqués de manière stable, « sans en manquer un seul ».
- Chargeuse de carrière: la chargeuse lourde doit pousser des pierres, alimenter en matériaux et stocker en entrepôt. Au tour 1, elle parvenait à peine à pousser les pierres ; au tour 4, elle a pu dérouler proprement l'ensemble du processus dans la limite de 360 secondes, avec 31 secondes d'avance.
Ces tâches d'une telle amplitude illustrent toutes la même chose : cette boucle fermée d'accumulation d'expérience fonctionne tout aussi bien dans des mondes totalement différents.
Comment l'image suit l'action : comment atteindre 30 images par seconde sur une seule carte
Pour que l'agent puisse « voir et agir » dans le monde virtuel, le moteur de rendu neuronal doit surmonter les trois montagnes qui entravent depuis longtemps la vidéo générative :suivre les actions soudaines, stabiliser les interactions ultra-longues, et tourner suffisamment vite。
Partant d'un modèle fondamental omni-modal, l'équipe MirroS a proposé la méthode d'entraînementAdversarial Forcing, puis, combinée à des optimisations d'inférence, a ouvert cette voie visuelle :
1. De la génération hors ligne de segments entiers au rendu en flux par blocs
Alors que les modèles vidéo habituels génèrent d'un coup une vidéo entière, AgentGarten l'a transformé en génération en flux par blocs. L'agent effectue une action, le modèle produit immédiatement le court bloc d'images correspondant, observe le résultat avant de prendre la décision suivante.
2. Pas de dérive dans les interactions de longue durée (relecture exacte)
Plus la génération continue dure longtemps, plus les micro-erreurs risquent de s'accumuler en dérive d'apparence. De nombreux modèles coupent le graphe de calcul historique pour économiser la mémoire vidéo, si bien que les gradients ne peuvent pas être rétropropagés vers la mémoire historique ; et si l'on recalcule uniformément toute la séquence en un second passage, les micro-différences d'ordre d'exécution sous-jacent introduisent des erreurs de plusieurs points de pourcentage.
L'équipe a conçu un mécanisme de relecture exacte : premier passage de déroulement avant sans gradient, second passage réexécuté avec gradient selon un rythme par blocs strictement identique, reproduisant avec précision la trajectoire d'inférence et stabilisant la cohérence temporelle des interactions sur longues séquences.
3. Introduction d'une adversité vidéo réelle : éviter la dégradation de l'image et les artefacts
En se fiant uniquement à la distillation de score sur des échantillons générés par le modèle lui-même, l'inférence prolongée se déforme facilement et fait apparaître des artefacts en grille.
L'équipe a introduit pendant l'entraînement un discriminateur de vidéos réelles pour construire le signal adversaire ; ancré sur la qualité physique réelle, il contraint à la fois la texture de l'image et force les résultats générés à épouser strictement les contours géométriques fournis par le code.
4. Maintenir une interaction temps réel à plus de 30 fps
L'équipe a écrit à la main des opérateurs fusionnés Triton personnalisés, éliminant les allers-retours mémoire vidéo et évitant l'attente de démarrage à froid de plusieurs minutes de la compilation traditionnelle de graphes entiers ; en combinant CUDA Graph pour éliminer la surcharge d'ordonnancement CPU et en remplaçant le décodeur par un modèle ultra-léger à latence inférieure à 10 millisecondes, elle assure finalement de manière stable l'interaction en boucle fermée à une résolution de 480p et un débit supérieur à 30 fps.
Préparer aux agents en évolution constante des mondes qu'ils peuvent traverser
Le code exécutable permet aux mondes d'entraînement d'être générés par programme à l'infini ; le moteur de rendu appris confère à ces mondes un retour physique perceptible et réaliste ; le manuel expérimental accumulé fait de chaque exploration une marche vers le prochain cycle d'exploration.
En combinant ces trois éléments, l'agent dispose d'un espace dans lequel il peut véritablement explorer, faire des erreurs et évoluer.
C'est précisément l'idée centrale de l'exploration par MirroS du Physical RSI (auto-amélioration récursive dans le monde physique).
Le Scaling des modèles de langage bat son plein, tandis que le Scaling de l'intelligence dans le monde physique ne fait que commencer.
Une véritable intelligence embarquée généraliste nécessite de croître en continu au fil des allers-retours réels avec le monde physique :
Faire de chaque inconnue le point de départ de la prochaine évolution.
Blog complet : https://mirros.ai/blog/worlds-for-evolving-agents
*Cet article est republié par QbitAI avec autorisation ; les opinions restent celles de l'auteur original.