
Par Tian Yanlin, depuis Ao Fei Si
QbitAI (量子位) | Compte officiel QbitAI
Eh bien, dans la compétition des modèles d'action mondiaux (WAM), une équipe chinoise vient-elle vraiment de se hisser à la première place mondiale ?!
De plus, des modèles embodied de pointe comme GPT-6-Astra, π0.5 de Physical Intelligence et NVIDIA GR00T-N1.7 ont tous été laissés derrière cette fois-ci.
L'auteur de ce coup est une société chinoise de robotique —星动纪元 (StarEra), la société embodied affiliée directe et seule entreprise détenue en capital par Tsinghua。
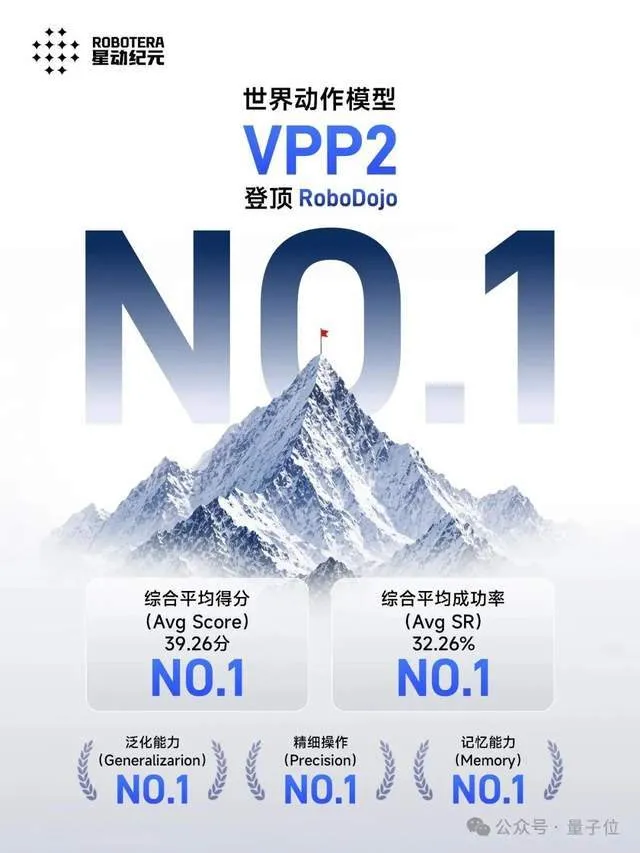
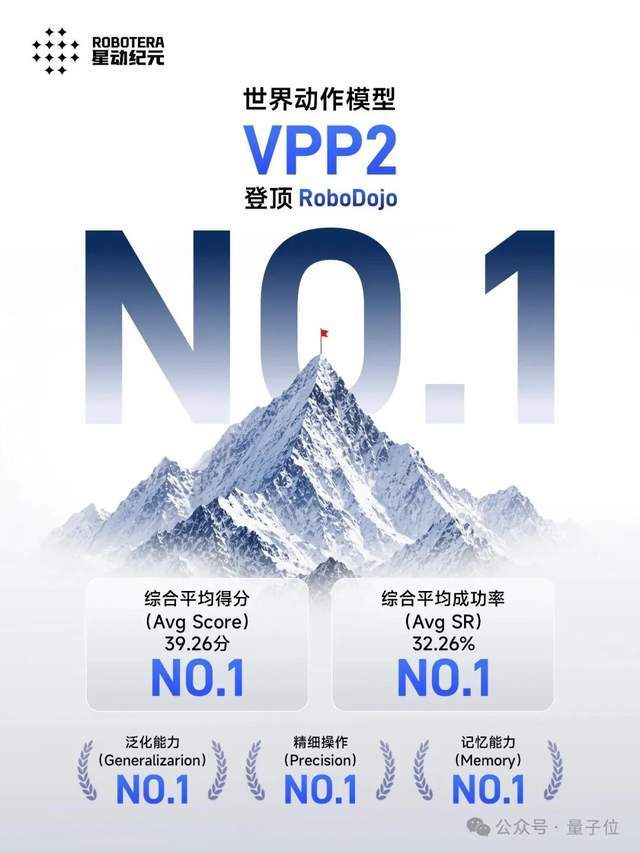
Récemment, 星动纪元 (StarEra)a vu son modèle d'action mondial développé en interne, VPP2décrocher la première place duclassement de simulation RoboDojo。
avec un taux de réussite moyen global de 32,26 % et un score moyen global de 39,26 points, premières places sur les deux indicateurs.
Le point clé : cette compétition n'était vraiment pas facile.
RoboDojo est surnomméle « mont Everest » de l'intelligence embodied, porté par le MMLab de l'université de Hong Kong et construit conjointement par près de 20 institutions académiques de premier plan dans le monde.
Il pose volontairement des questions là où les robots sont peu performants : dans un environnement différent, saura-t-il encore travailler ? Si les objets sont mal placés, saura-t-il encore les saisir correctement ? À mi-tâche, se souvient-il encore de ce qui s'est passé auparavant ?
Bref, il n'est pas si facile de tricher en accumulant de la pratique.
Et le résultat ?
Non content de décrocher la première place globale, 星动纪元 VPP2 a également pris la tête surla capacité de généralisation, la manipulation fine et la mémoire, trois dimensions.
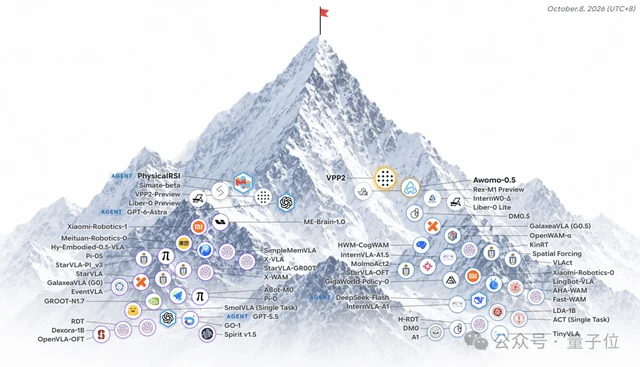
Selon toute apparence, cette fois VPP2n'a ajouté aucune donnée supplémentaireetn'a utilisé aucun moyen d'augmentation tel que Agent RSI,, s'appuyant uniquement sur « l'ensemble de données standard »pour évincer toute une série de prétendants solides.
Cela montre que le modèle VPP2 est suffisamment puissant en lui-même : les gains de performance proviennent du pré-entraînement et d'une base suffisamment généralisable, d'où l'absence de recours à des stratégies d'augmentation externes ou à un gonflement des données pour « gonfler les scores ».
Dis donc, mon gars, comment un modèle aussi costaud a-t-il bien pu être entraîné ???
Nous avons creusé dans la feuille de route technique, et force est de constater que la percée de VPP2 a vraiment de quoi impressionner.
Elle cible un problème récurrent des modèles du monde : une fois la prédiction erronée, l'action qui suit l'est aussi.
La solution apportée par VPP2 consiste d'abord à entraîner la capacité de prédiction vidéo jusqu'à un niveau suffisamment élevé, puis à laisser le robot agir réellement dans des environnements inconnus.
De la prédiction à l'action, deux capacités de généralisation progressent ensemble.
Au vu des nombreux résultats de tests divulgués à ce jour, VPP2 est déjà devenu l'un des concurrents les plus compétitifs dans la course aux modèles d'action du monde (WAM).
Le modèle d'action du monde WAM, une nouvelle course qui couronne un nouveau champion
Le secteur de l'intelligence embarquée connaît un phénomène plutôt embarrassant.
Les démos de robots sont de plus en plus spectaculaires, et les scores des modèles dans les classements ne cessent d'augmenter, mais si l'on demande vraiment : quel robot est le plus intelligent, le plus capable de travailler ?
Difficile de répondre.
Par exemple, demandons à un robot de saisir un gobelet. Sur la table vue pendant l'entraînement, il peut réussir à tous les coups. Mais changez de gobelet ou déplacez légèrement sa position, et il se met immédiatement à douter de tout.
Sans parler des tâches qui nécessitent l'exécution continue de plusieurs étapes.
C'est précisément pour cela que cette batterie de tests qu'est RoboDojo mérite notre attention.
Son objectif est d'établir une norme d'évaluation unifiée et reproductible pour l'intelligence embarquée ; les tests en simulationcomprennent 42 tâches de manipulation bimanuellecouvrant cinq dimensions : généralisation, manipulation de précision, tâches de longue durée, mémoire et compréhension d'instructions à vocabulaire ouvert.
En clair, il s'agit de sortir le robot de sa zone de confort.
Les modèles de robotique traditionnels peuvent atteindre des scores proches de la note maximale sur des tâches familières, mais dès que l'environnement, la position des objets ou la combinaison de tâches changent, le taux de réussite peut chuter de manière significative.
RoboDojo évalue précisément ce type de situations complexes, pour mesurer quelle capacité de généralisation le robot possède face aux changements.
Et le bilan présenté cette fois par VPP2 est assez remarquable.
Avec un taux de réussite moyen de 32,26 % et un score moyen de 39,26 points, il se classe premier sur les deux indicateurs.
À titre de comparaison, dans l'évaluation post-entraînement du benchmark de simulation RoboDojo,GPT-6-Astraaffiche un taux de réussite moyen de 22,48 % et un score moyen de 28,97 points.
tandis queVPP2le devance respectivement de 9,78 points de pourcentage et de 10,29 points.
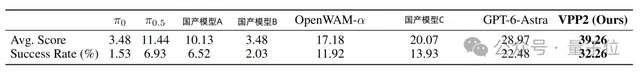
Capture d'écran de l'article, données des modèles de référence issues du classement officiel
Les deux indicateurs ont chacun leur spécificité : le taux de réussite mesure si le robot peut accomplir intégralement la tâche ; le score moyen évalue jusqu'où la tâche a progressé, reflétant même sa performance partielle lorsqu'il n'a pas pu tout achever.
Les deux indicateurs combinent les résultats des tests sur cinq dimensions de capacités.
En d'autres termes,VPP2 accomplit non seulement les tâches dans une proportion plus élevée, mais démontre aussi une plus forte capacité d'achèvement partiel sur les tâches qu'il n'a pas pu terminer.
De plus, cette avance ne se limite pas au score global.
En décomposant les cinq dimensions de capacités, VPP2 arrive également premier sur trois d'entre elles : la généralisation, la manipulation de précision et la mémoire.
Ces trois capacités correspondent à plusieurs obstacles majeurs que les robots doivent franchir pour entrer dans le monde réel : rester opérationnel dans un environnement différent, effectuer des manipulations précises, et se souvenir des étapes précédentes lors de l'exécution de tâches enchaînées.
Leader au score global, et solide sur les capacités clés.
Cependant, aussi difficile soit RoboDojo, le terrain d'examen reste un « environnement de simulation ». Dans le monde physique, la friction des objets, leur déformation et leurs écarts de position introduisent de nouvelles variables.
La capacité de généralisation dont VPP2 a fait preuve en simulation,reste-t-elle valable sur un vrai robot ?
Xingdong Jiyuan a également mené des expériences.
Cette fois, l'équipe a directement déployé VPP2sur un véritable robot bi-bras ALOHA, en testant 10 types de tâches de manipulation en zero-shot : saisir, placer, empiler, plier, verser, etc.
Autrement dit, sans aucun réglage fin supplémentaire pour ces tâches de test, le robot devait s'y mettre directement.
Résultat : VPP2 a de nouveau livré des performances de premier plan :un taux de réussite moyen de 58,5 %, supérieur aux 40 % de π0.5.
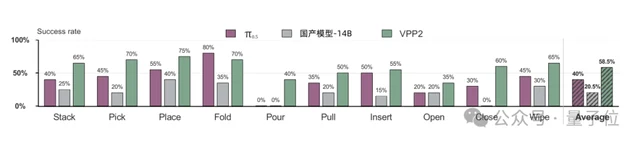
Sur les 10 types de tâches, VPP2 a obtenu le meilleur résultat sur 9 d'entre elles.
Voilà qui devient intéressant.
La première place du classement démontre ses capacités selon le système d'évaluation standard ; la manipulation en zéro-shot sur robot réel examine ensuite si ces capacités peuvent être transférées à un environnement physique réel.
Mise côte à côte avec ces deux feuilles de route, la supériorité technique de VPP2 mérite qu'on s'y attarde davantage.
Il faut savoir que VPP2 suit la voie dumodèle d'action du monde (WAM, World Action Model)。
L'idée de base de ce type de modèle est d'utiliser la prédiction vidéo pour comprendre comment le monde physique va évoluer ensuite, puis de convertir cette prédiction en actions du robot.
Mais cette voie a longtemps souffert d'un problème : une belle prédiction vidéo ne signifie pas que le robot saura vraiment travailler.
Et cette fois, VPP2 s'est justement attaqué à ce problème.
De la généralisation de la prédiction à la généralisation de l'action : comment VPP2 y est-il parvenu ?
Pour comprendre la percée de VPP2, commençons par une tâche simple : faire mettre par le robot un verre posé sur la table dans une boîte.
Pour un humain, tendre la main, saisir, soulever, poser — cela ne demande presque aucune réflexion.
Mais le robot doit déterminer la position du gobelet, la trajectoire du bras mécanique, le moment où la pince doit se refermer, et prévoir en plus ce qui va changer dans le monde physique tout au long de l'opération. Le moindre écart à une étape peut tout faire capoter.
Les modèles d'action du monde (WAM) existants sont précisément sujets à des défaillances à ce niveau.
D'un côté, les modèles vidéo ordinaires excellent à générer des images, mais le fait qu'une image paraisse plausible et le fait qu'elle soit conforme aux lois physiques réelles sont deux choses différentes.
Par exemple, on demande de saisir le gobelet de gauche, mais le modèle prédit de saisir celui de droite. La vidéo est quand même générée, mais le robot, lors de l'exécution, part directement à côté.
De l'autre côté, intégrer directement l'apprentissage des actions dans un modèle vidéo peut aussi endommager sa capacité de généralisation d'origine.
Résultat : les actions sont apprises, mais le robot ne sait plus les exécuter dans un autre environnement.
VPP2 propose un jugement très direct :la qualité de la prédiction vidéo détermine le plafond de l'action.
Sur la base de cette idée, Xingdong Jiyuan choisit d'entraîner la prédiction vidéo et l'apprentissage des actions en plusieurs phases ; l'essentiel n'est pas de « tout cuire ensemble, vidéo et actions », mais de procéder à leur« découplage », puis de les« reclasser »。
Pour ce faire, Xingdong Jiyuan a conçu une stratégie d'entraînement entrois phases:
- Première phase : pré-entraînement continu sur des vidéos au niveau de l'événement, pour que le modèle apprenne à prédire le déroulement complet d'une opération.
- Deuxième phase : post-entraînement et distillation sur des vidéos de durée fixe, pour que la capacité de prédiction suive la vitesse d'exécution en temps réel du robot.
- Troisième phase : entraînement d'un expert en actions, qui convertit la prédiction vidéo en actions concrètes, tout en préservant autant que possible la capacité de généralisation d'origine.
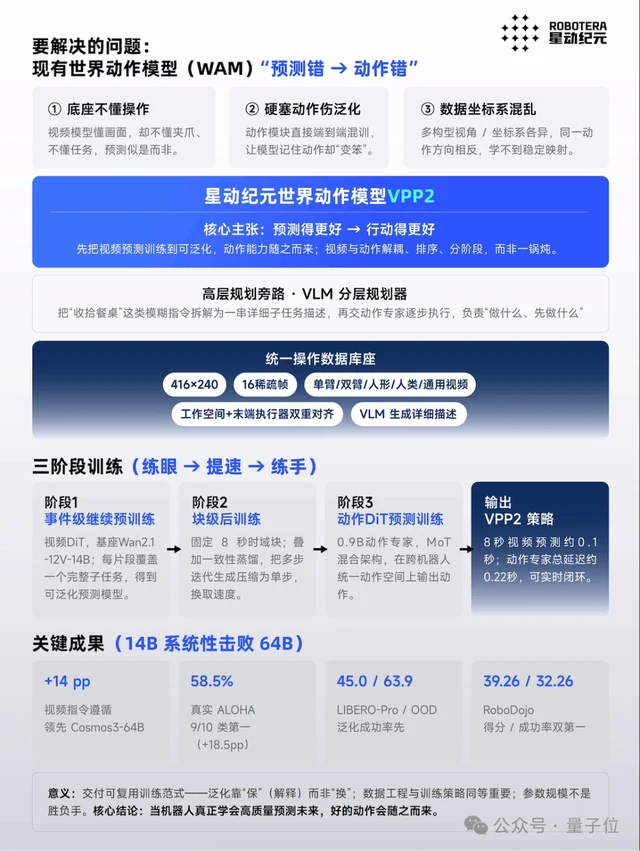
Ces trois phases progressent par paliers successifs et mènent finalement àdeux percées majeures: la prédiction peut généraliser, et l'action aussi peut généraliser.
Première percée : donner à la prédiction vidéo une capacité de généralisation
Ce que VPP2 doit d'abord résoudre, c'est la question de savoir si le robot peut prédire avec précision les changements physiques dans des tâches inconnues.
Xingdong Jiyuan s'appuie sur Wan2.1-I2V-14B, open source d'Alibaba, en y intégrant des données variées : manipulation robotique, activités humaines, vidéos générales, couvrant différents corps de robots et modes d'opération.
Mais ce qui est vraiment intéressant, c'est son traitement des données.
L'équipe n'a pas simplement nourri le modèle avec des vidéos en vrac : elle a d'abord découpé les processus d'opération en segments sémantiquement complets, puis les a accompagnés de descriptions détaillées.
Par exemple, il ne suffit pas de dire au modèle « mettre le gobelet dans la boîte » : il faut préciser de quel bras mécanique, de quel gobelet, de quelle boîte il s'agit, ainsi que tout le déroulement de l'opération.
Car une même instruction vague peut correspondre à une infinité de trajectoires d'action.
Si le modèle n'a même pas identifié les objets de l'opération, il lui sera naturellement très difficile de prédire correctement l'avenir.
VPP2 décrit donc les tâches de manière plus fine, afin d'établir une correspondance plus stable entre les instructions en langage et les opérations physiques.
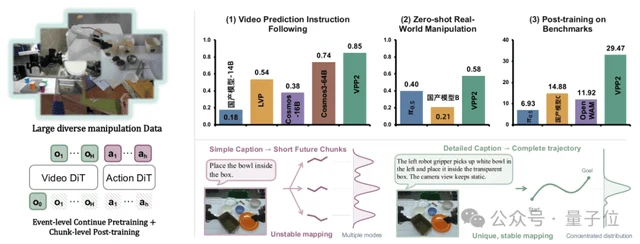
L'étape encore plus déterminante est l'entraînement à la prédiction vidéo au niveau de l'événement.
La prédiction à court terme traditionnelle s'intéresse à ce qui se passera dans les images suivantes, tandis que VPP2 fait directement apprendre au modèle les transformations d'une opération complète, du début à la fin.
Du rapprochement du bras mécanique vers le gobelet, à sa saisie, puis à son dépôt dans la boîte, ce que le modèle doit comprendre, c'est comment se déroule une chose entière.
Ainsi, face à de nouveaux objets, positions ou même tâches de manipulation, il a davantage de chances de prédire des évolutions physiques plausibles.
Lors du test de suivi d'instructions sur des vidéos de manipulation robotique,14B paramètresa atteint un taux de réussite de 2 %90%de taux de réussite, tandis que le modèle Cosmos3 de 64B paramètres atteint 78 %.
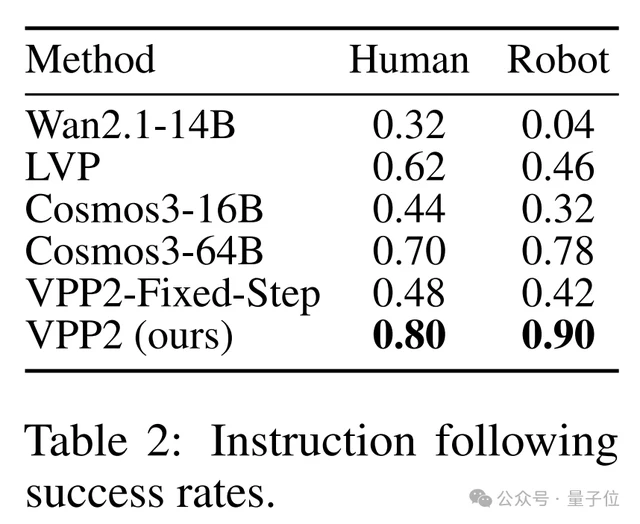
14B bat 64B.
Cela montre aussi que, dans la prédiction de manipulation physique, la taille des paramètres n'est pas le seul facteur décisif : la capacité à réellement comprendre le processus de manipulation est tout aussi importante.
Cependant, aussi précise soit la prédiction, si le robot ne peut pas bouger, cela ne sert à rien.
Deuxième percée : transformer la généralisation de la prédiction en généralisation de l'action
Il y a ici deux obstacles : premièrement, lavitesse, et deuxièmement,comment conserver la capacité de généralisation originale du modèle vidéo tout en apprenant les actions.
La première difficulté s'explique facilement. Si un robot doit générer une vidéo pendant plusieurs secondes avant chaque mouvement, même une capacité de prédiction très puissante a du mal à être utile.
Xingdong Jiyuan (Robot Era) a choisi d'abord d'accélérer le modèle de prédiction.
L'équipe a d'abord ajusté le modèle de prédiction au niveau des événements pour prédire des extraits vidéo d'une durée fixe de 8 secondes, puis, grâce à la distillation de cohérence, a compressé le calcul multi-étapes en une génération en une seule étape.
Au final, prédire les changements visuels des 8 secondes à venir prend environ 0,12 seconde de calcul.
La deuxième difficulté est un peu plus délicate.
Après avoir réussi non sans peine à faire apprendre au modèle vidéo à prédire des tâches inconnues, une fois l'entraînement aux actions ajouté, le modèle n'a plus su qu'exécuter des opérations familières.
La capacité d'action s'est développée, mais la capacité de généralisation a été perdue ? Ce que VPP2 doit faire, c'est franchir ces deux difficultés à la fois.
VPP2 introduit un0.9B de paramètresqui apprend, avec l'architecture MoT,comment générer les actions du robot à partir de l'état futur prédit.Mais Xingdong Jiyuan n'a pas entraîné ensemble, dès le départ, le modèle de prédiction vidéo (Video DiT) et l'expert d'action.
Au début de l'entraînement aux actions, les paramètres de base du modèle vidéo ont été gelés et adaptés uniquement via LoRA, afin d'éviter autant que possible que l'entraînement aux actions ne détruise la capacité de généralisation prédictive déjà acquise.
Cela revient à faire d'abord comprendre au robot comment le monde physique évolue, puis à l'entraîner à convertir cette « compréhension » en « actions ».
Les deux capacités se développent par étapes tout en se complétant mutuellement.
Au final, la prédiction vidéo prend environ 0,12 seconde, l'expert d'action environ 0,1 seconde, si bien que
Enfin, la prédiction vidéo prend environ 0.12 seconde et l'expert d'action environ 0.1 seconde,La latence globale de génération d'un segment d'action est d'environ 0.22 seconde.
Le
test zéro-shot sur le vrai robot ALOHAmentionné précédemmenta déjà montré le potentiel de VPP2 à convertir sa capacité de prédiction en opérations sur des tâches inconnues.
Les deux autres séries de tests de généralisation valident davantage encore cette voie.
LIBERO-Proévalue la capacité d'opération après des changements de position des objets et d'exigences des tâches : VPP2 atteint un taux de réussite global de 45,0 %, contre 11,0 % au maximum pour les autres modèles de référence.
LIBERO-OODévalue quant à lui la généralisation par composition : des objets, des dispositions et des objectifs de tâches familiers sont recombinés pour former de nouvelles tâches jamais vues auparavant.
Le taux de réussite global de VPP2 atteint 63,9 %.
En examinant ces résultats ensemble, l'approche technique de VPP2 devient claire.
D'abord, grâce à des données multi-sources, des descriptions détaillées des tâches et un entraînement à la prédiction au niveau des événements, le modèle prédit plus précisément les changements physiques.
Ensuite, grâce à l'accélération par distillation et à un apprentissage des actions par étapes, cette capacité de prédiction est convertie en opérations réelles, tout en préservant autant que possible la capacité de généralisation d'origine.
Il est évident que le plafond de performance de l'intelligence incarnée n'en est pas encore au point où l'on ne peut plus que tout miser sur l'échelle.
VPP2 le démontre encore une fois :optimiser le pipeline de données, ajuster le paradigme d'entraînement— ces méthodes d'ingénierie en apparence modestesont encore l'opportunité d'apporter des gains de performance considérables pour le modèle.
De GPT à WAM, l'IA physique est en train de former un nouveau paradigme
Que la prédiction puisse généraliser et que l'action puisse aussi généraliser est la percée centrale la plus remarquable de VPP2 en tant que modèle d'action mondiale (WAM).
Mais les tâches réelles sont souvent bien plus complexes. Le robot doit non seulement savoir comment faire, mais aussi juger quoi faire d'abord et quoi faire ensuite.
Cela nécessite l'intervention de capacités cognitives et de planification de niveau supérieur.
Star Era apporte ici une idée :GPT réfléchit, VPP2 agit.
Le premier est chargé de la compréhension, du raisonnement et de la planification, décomposant les tâches complexes en étapes claires ; le second prédit comment le monde physique évolue, puis traduit la planification en actions concrètes.
Cette idée bénéficie déjà d'un soutien expérimental préliminaire dans l'article de VPP2.
L'équipe utilise en pratique un planificateur de haut niveau VLM, chargé de la compréhension sémantique, de la mémoire et de la décomposition des tâches, avant de confier les sous-tâches claires à VPP2 pour exécution.
Les résultats sont assez parlants. Lors des tests de tâches longues sélectionnées dans RoboDojo,après l'introduction de la planification de sous-tâches par VLM,le taux de réussite moyen est passé de 27,6 % à57.6%。
Cela signifie que, pour accomplir des tâches complexes, un robot ne peut se contenter de puissantes capacités d'action. La coordination entre planification de haut niveau et exécution de bas niveau influence également la réussite des tâches.
En suivant cette ligne de réflexion,GPT+VPP2pourrait donner naissance à unnouveau paradigme technologique d'IA physique: cognition générale + exécution physique générale.
Les modèles généralistes comme GPT seraient chargés de comprendre les intentions, de raisonner et de planifier, tandis qu'un WAM comme VPP2 prédirait les évolutions physiques et générerait les actions, puis s'ajusterait continuellement grâce aux retours d'exécution.
De la cognition et de la planification à la prédiction, puis à l'exécution et au retour d'information, une boucle complète d'IA physique se dessine progressivement.
Et cela donne à la valeur des WAM un espace d'imagination bien plus grand.
Les capacités d'un modèle doivent s'exprimer par l'interaction du corps physique avec le monde réel, et l'usage réel expose à son tour les échecs et produit des retours d'information, poussant modèle et matériel à continuer de s'améliorer.
Xingdong Jiyuan développe simultanément le cerveau, le corps et les mains dextres ; la stratégie de « deep full-stack » s'explique dans cette logique :la société cherche à maîtriser non seulement l'entraînement, mais aussi la mise en œuvre des capacités et le reflux des retours d'information.
u1s1, aussi belle soit une approche technique, il faut finalement aller travailler dans le monde réel.
Xingdong Jiyuan a déjà lancé, dans ce domaine, des coopérations avec China Post, SF Express et d'autres entreprises, avec uneexploitation en régime permanent dans 5 provinces et municipalités à travers le pays, et dans plus de 10 centres logistiques.。
Dans les scénarios logistiques, les dimensions des marchandises, leur emplacement et les processus opérationnels peuvent varier. Avec la même opération, changer d'entrepôt peut obliger le robot à se réadapter.
Cela impose aussi des exigences plus élevées quant à la capacité de généralisation des robots.
La capacité d'un modèle à transférer ce qu'il a appris vers des tâches inconnues détermine directement l'efficacité et le coût des déploiements multi-scénarios à l'avenir.
Bien sûr, les progrès de la commercialisation de ses activités logistiques existantes ne signifient pas que VPP2 ait déjà atteint un déploiement à grande échelle. Il reste à vérifier si le modèle peut fonctionner de manière stable à long terme dans davantage de scénarios réels.
Mais la performance de VPP2 cette fois-ci a déjà délivré un signal digne d'attention.
La concurrence entre modèles d'action du monde passe désormais de la prédiction du futur à la transformation de cette prédiction en actions généralistes.
En regardant à nouveau le sacre de RoboDojo, ce qui mérite l'attention n'est donc plus seulement une première place.
De la simulation aux robots réels, de la généralisation par prédiction à la généralisation par action, les résultats d'une série d'expériences de VPP2 montrent que :l'entraînement en deux phases combinant prédiction vidéo et apprentissage d'actions permet effectivement d'améliorer la capacité de manipulation des robots dans des tâches inconnues.
Et à mesure que les modèles de cognition généraliste comme GPT se combinent davantage avec les WAM, l'IA physique devrait également former un système de capacités plus complet.
En fin de compte, le prochain tour de la compétition en intelligence incarnée consiste à savoir si les robots peuvent emporter ce qu'ils ont appris vers davantage de scénarios inconnus.
Prédire avec précision, c'est bien ; encore faut-il savoir le faire. C'est là la clé pour que les modèles d'action du monde s'orientent réellement vers le monde physique.
PS :VPP2 est désormais open source,Les personnes intéressées peuvent essayer et reproduire les résultats de l'article.
Si vous obtenez vraiment une surprise en l'exécutant, revenez nous en parler ~
1. Code open source
: https://github.com/roboterax/video-prediction-policy-2
2. Page du projet :
https://robert-gyj.github.io/video-prediction-policy-2