
IT之家 Le 9 octobre, JetBrains a publié hier (8 octobre) un post indiquant l’arrivée du modèle Mellum2.1, destiné à renforcer les capacités de programmation d’intelligence artificielle. Ce modèle reprend la structure hybride expert de 12B de Mellum2, avec 2,5B de paramètres actifs, et continue d’être distribué sous le licence Apache 2.0.
Mellum2.1 majore principalement la phase d'apprentissage renforcé après pré-entraînement, en transformant les phases de finition à court terme en éléments principaux de l'entraînement, et en ajoutant des données d'entraînement dans des tâches telles que les compétitions mathématiques, les algorithmes, les sciences, l'utilisation d'outils et l'ingénierie logicielle.
JetBrains a mis en place une infrastructure d’environnement de récupération de connaissances interne pour ce modèle, activant des millions de sandboxes pendant l’entraînement, couvrant des milliers d’environnements. De plus, avant l’entraînement, l’équipe a filtré des jeux de données ouverts, en éliminant les défauts de test, les réponses non vérifiables et les tâches dont la difficulté est inappropriée.
Après l’amélioration, Mellum 2.1 peut explorer le bibliothèque de code, éditer les fichiers et vérifier ses propres modifications. JetBrains indique que la meilleure amélioration apparaît dans le domaine de la programmation d’intelligences artificielles : le modèle peut détecter la cause racine des tests échoués, élaborer des solutions de correction et vérifier les résultats.
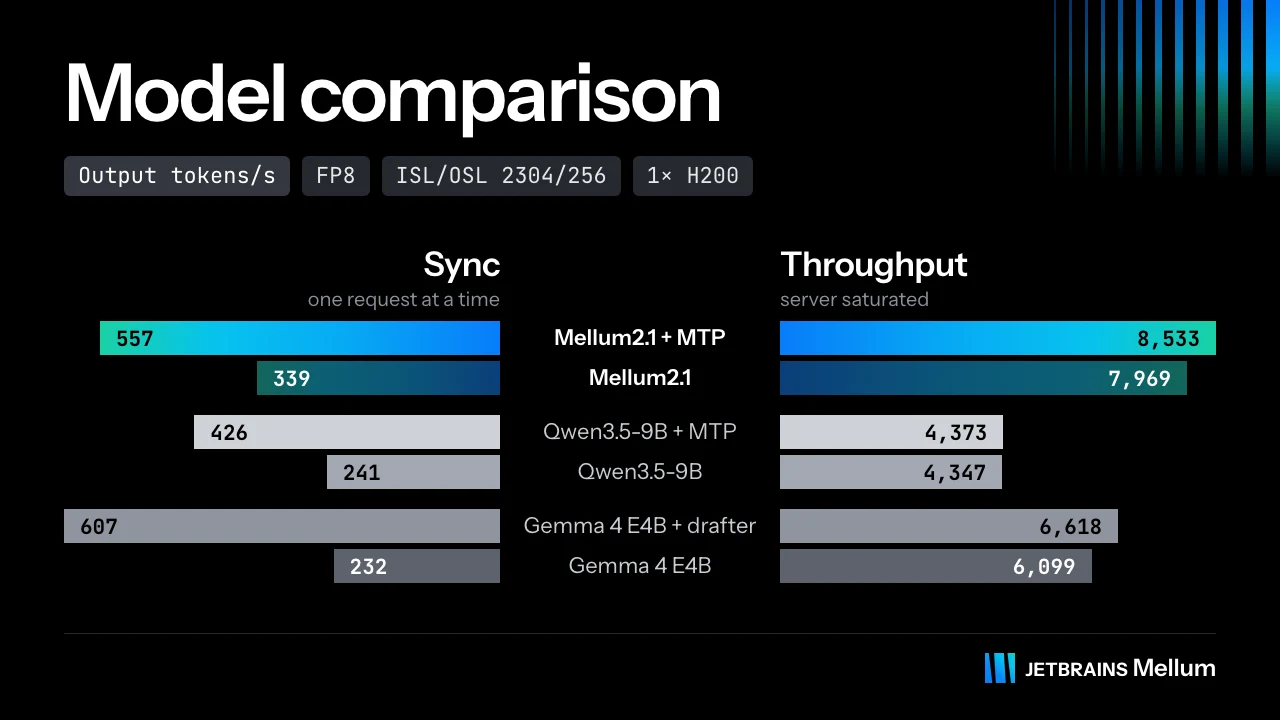
En termes de performance, l’architecture Mellum2.1 est identique à celle de Mellum2, avec une vitesse inchangée ; la prédiction multi-tokens (MTP) améliore encore la rapidité de réponse. Dans un scénario de requête unique, la MTP augmente sa vitesse d’environ 1,6 fois.
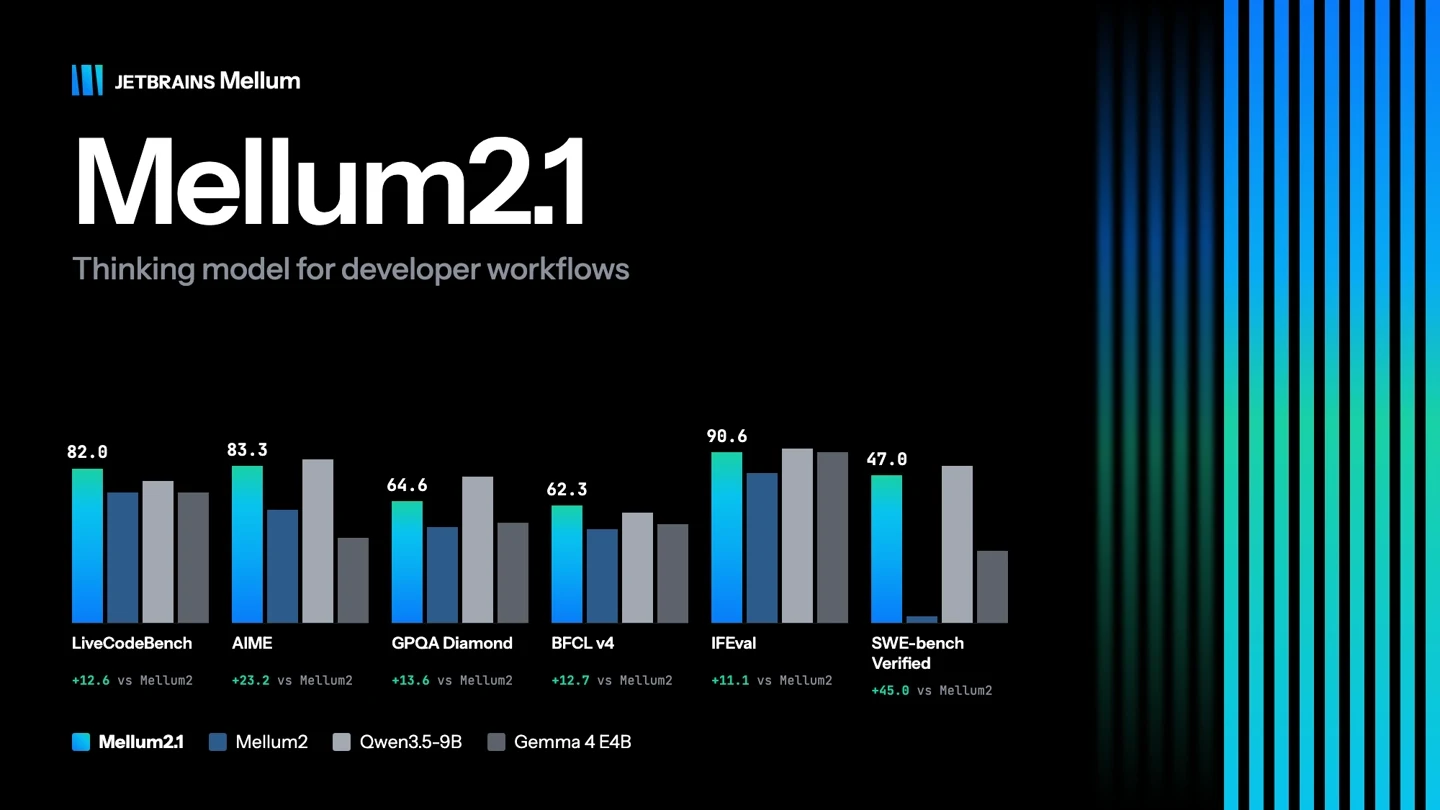
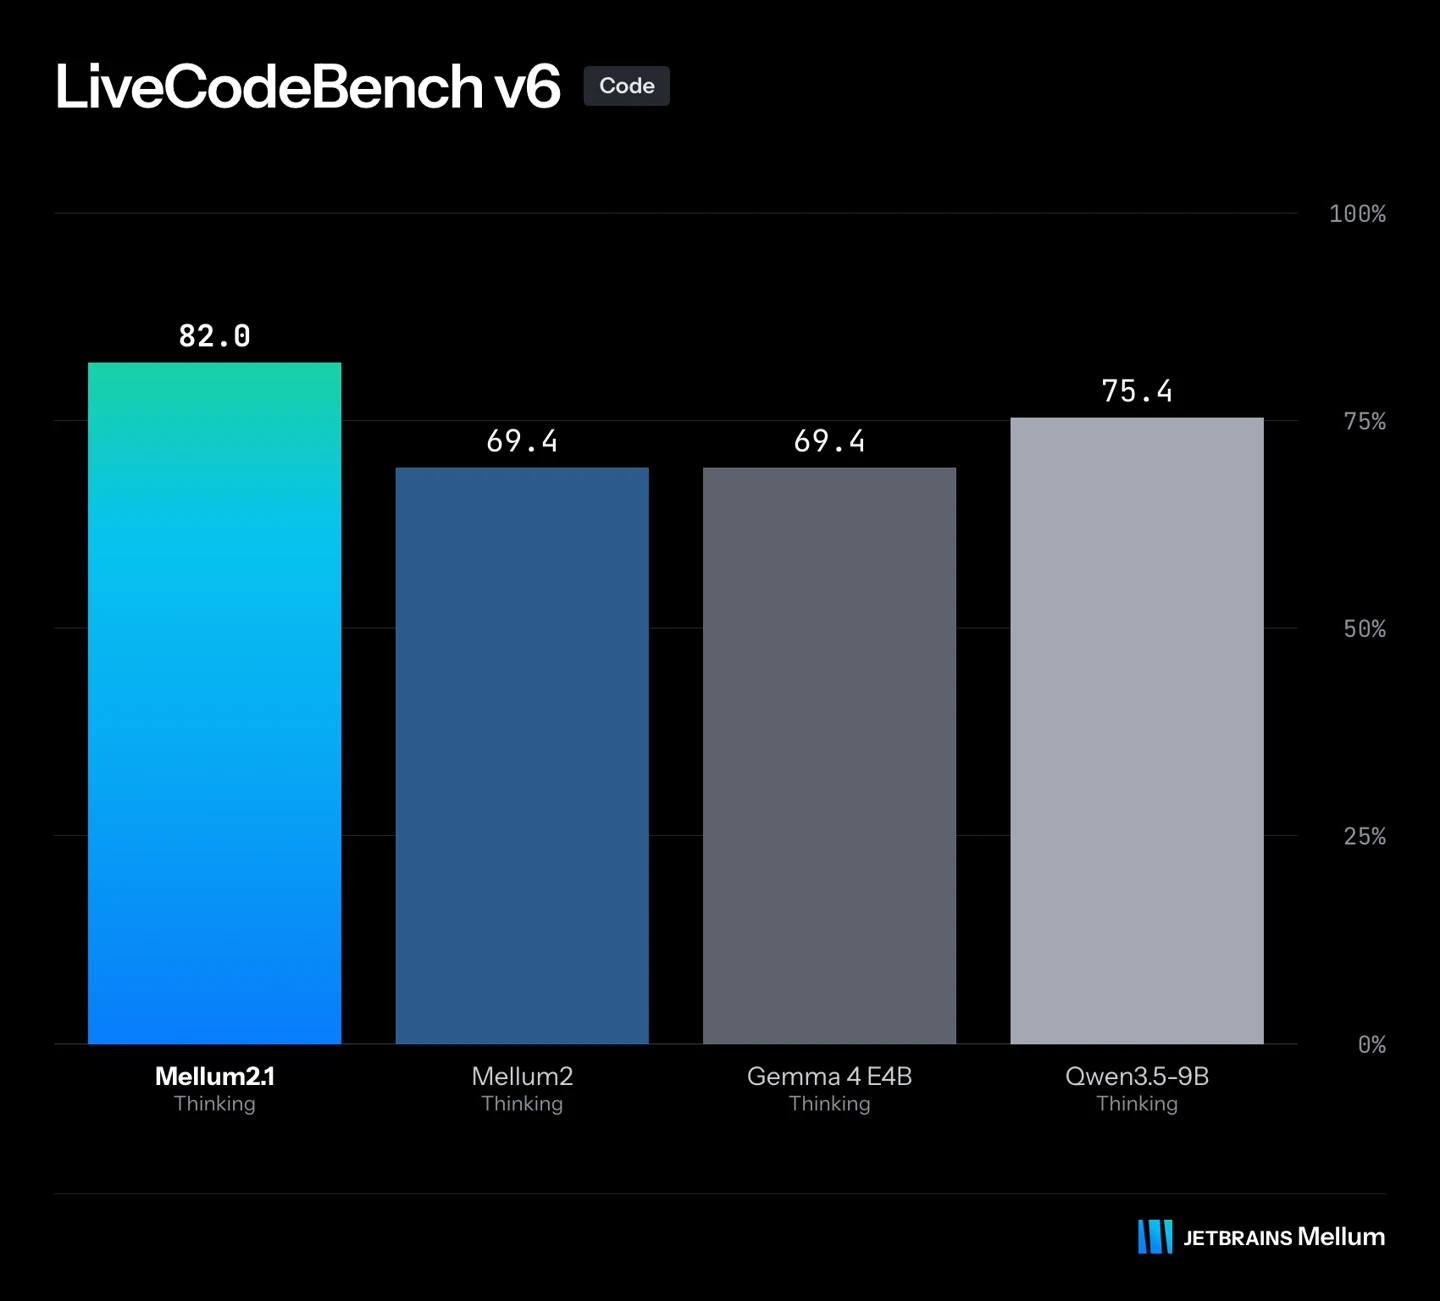
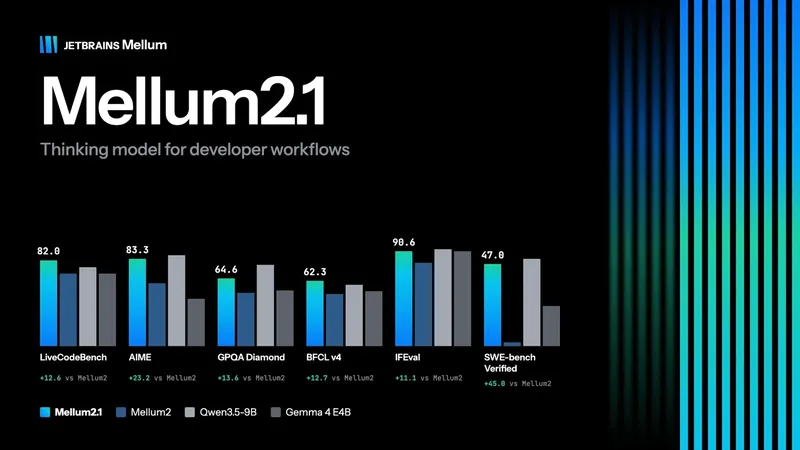
JetBrains compare Mellum2.1 avec Mellum2, Qwen3.5-9B et Gemma 4 E4B dans les mêmes conditions d’évaluation. Les résultats montrent que en situation de charge élevée, le débit de raisonnement de Mellum2.1 en nombre de tokens est près du double de celui de Qwen3.5-9B, et cela se manifeste dans des domaines tels que la programmation, les compétitions d’algorithmes, les mathématiques, les appels à outils et les connaissances générales. IT Home fournit les captures d’écran correspondantes ci-dessous :
Mellum2.1 est désormais disponible sur Hugging Face, et il prend en charge le déploiement local ou sur une infrastructure propre, permettant aux entreprises de conserver leurs code et données dans leur environnement propres. Les versions officielles incluront également des versions GGUF pour llama.cpp, Ollama et LM Studio, ainsi que l’élément de décodage de spéculation MTP de vLLM.