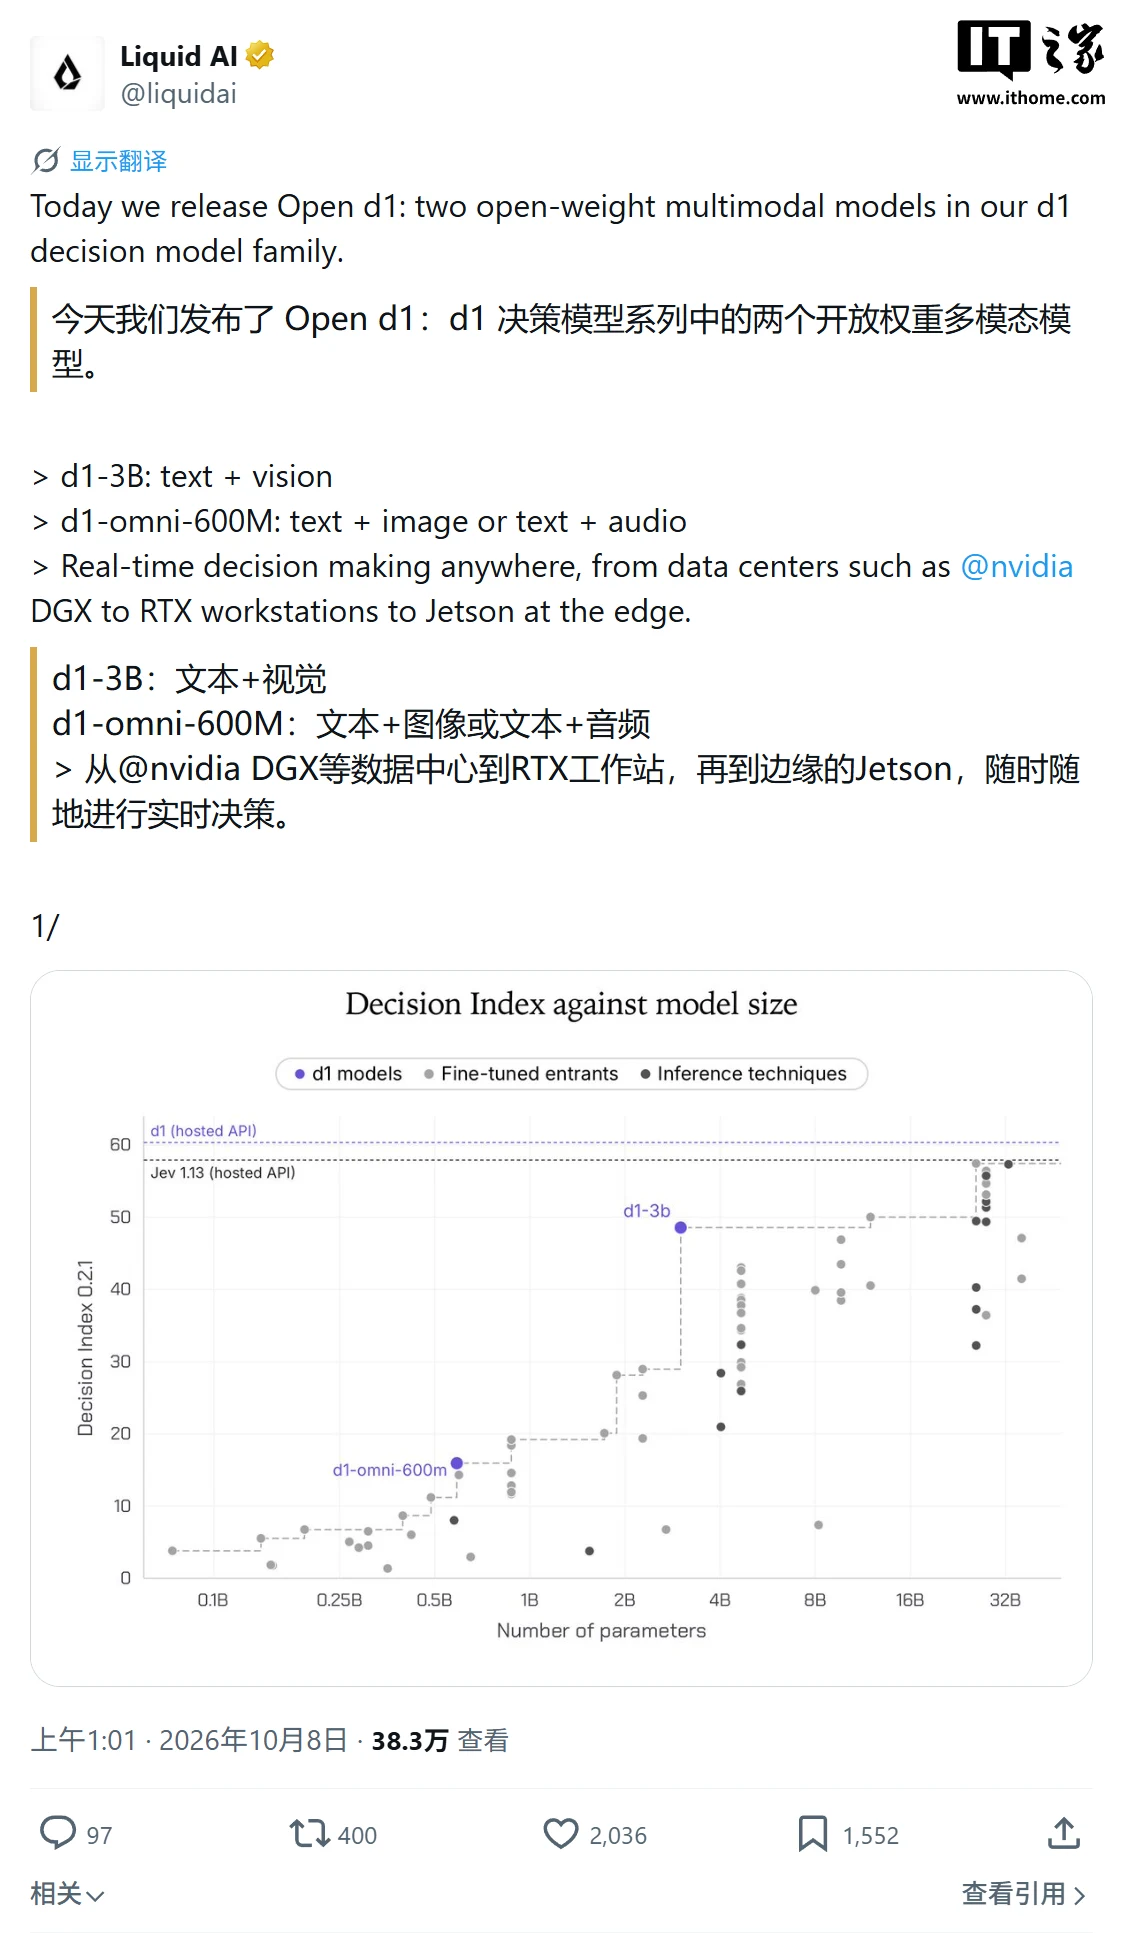
IT之家 Le 9 octobre, Liquid AI a publié le 7 octobre un article de blog annonçant le lancement de deux modèles de décision à poids ouverts de la série d1 : d1-3B prend en charge le jugement de textes et d'images avec 3,12 milliards de paramètres,d1-omni-600M prend en charge les entrées texte, image et voix avec 587 millions de paramètres.
Selon l'article de blog cité par IT之家,après le succès viral du modèle Jev lancé en septembre,des sociétés comme OpenAI ont également lancé des modèles de décision similaires, et Liquid AI est un nouveau venu dans cette bataille ; les modèles d1-3B et d1-omni-600M lancés cette fois sont disponibles publiquement sur Hugging Face, où les utilisateurs peuvent les télécharger, les affiner et les déployer.
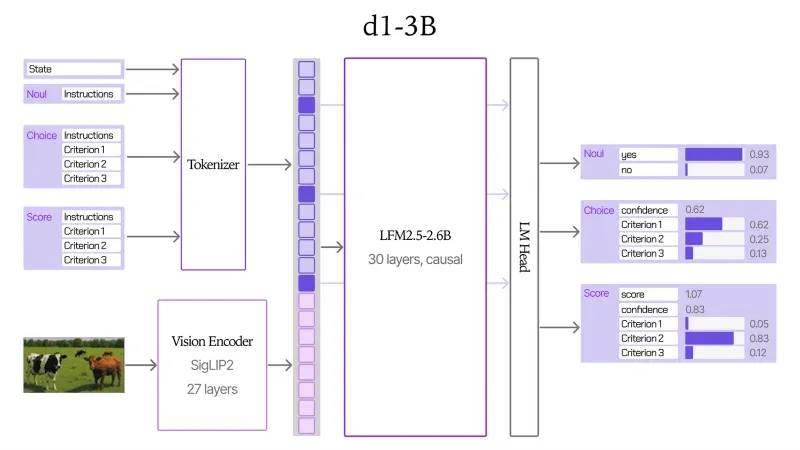
d1-3B possède 3,12 milliards de paramètres et a été entraîné à partir du modèle vision-langage LFM2.5-VL-3B, prenant en charge les entrées texte et image. Le modèle a obtenu un score de 48,57 sur l'ensemble de test public Decision Index v0.2.1, et Liquid AI affirme qu'il surpasse tous les modèles de moins de 10B.
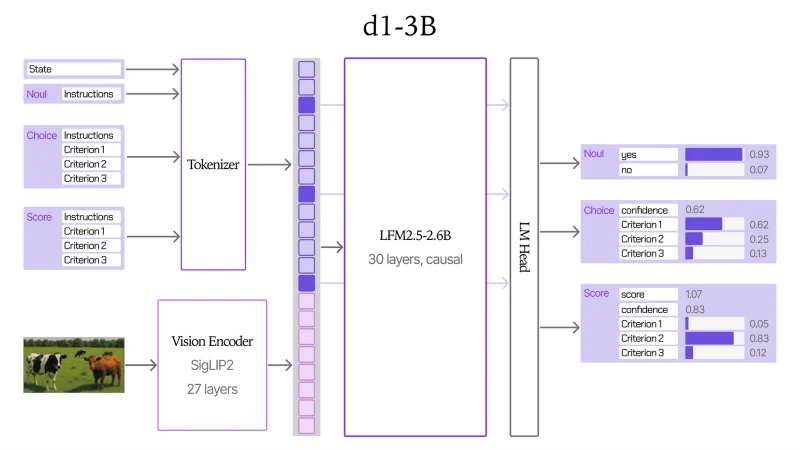
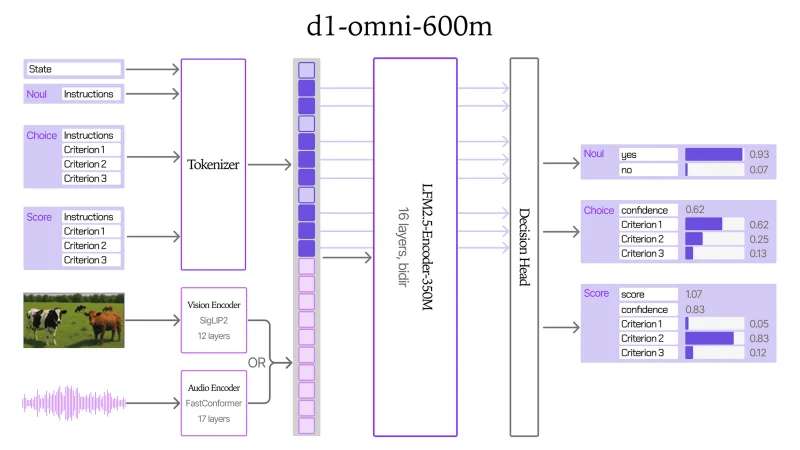
d1-omni-600M compte 587 millions de paramètres et a été entraîné à partir de l'encodeur bidirectionnel LFM2.5-Encoder-350M. Le modèle prend en charge les entrées texte et image, ou texte et voix en combinaison, et constitue le premier checkpoint de modèle de décision multimodal expérimental de Liquid AI.
En matière de vitesse d'inférence, d1-3B répond à une seule question en 8 millisecondes sur NVIDIA RTX 4090, et traite une image de 384 pixels en 102 millisecondes. Sur Jetson AGX Thor, une seule question prend 16 millisecondes ; sur Jetson Orin Nano, 50 millisecondes.
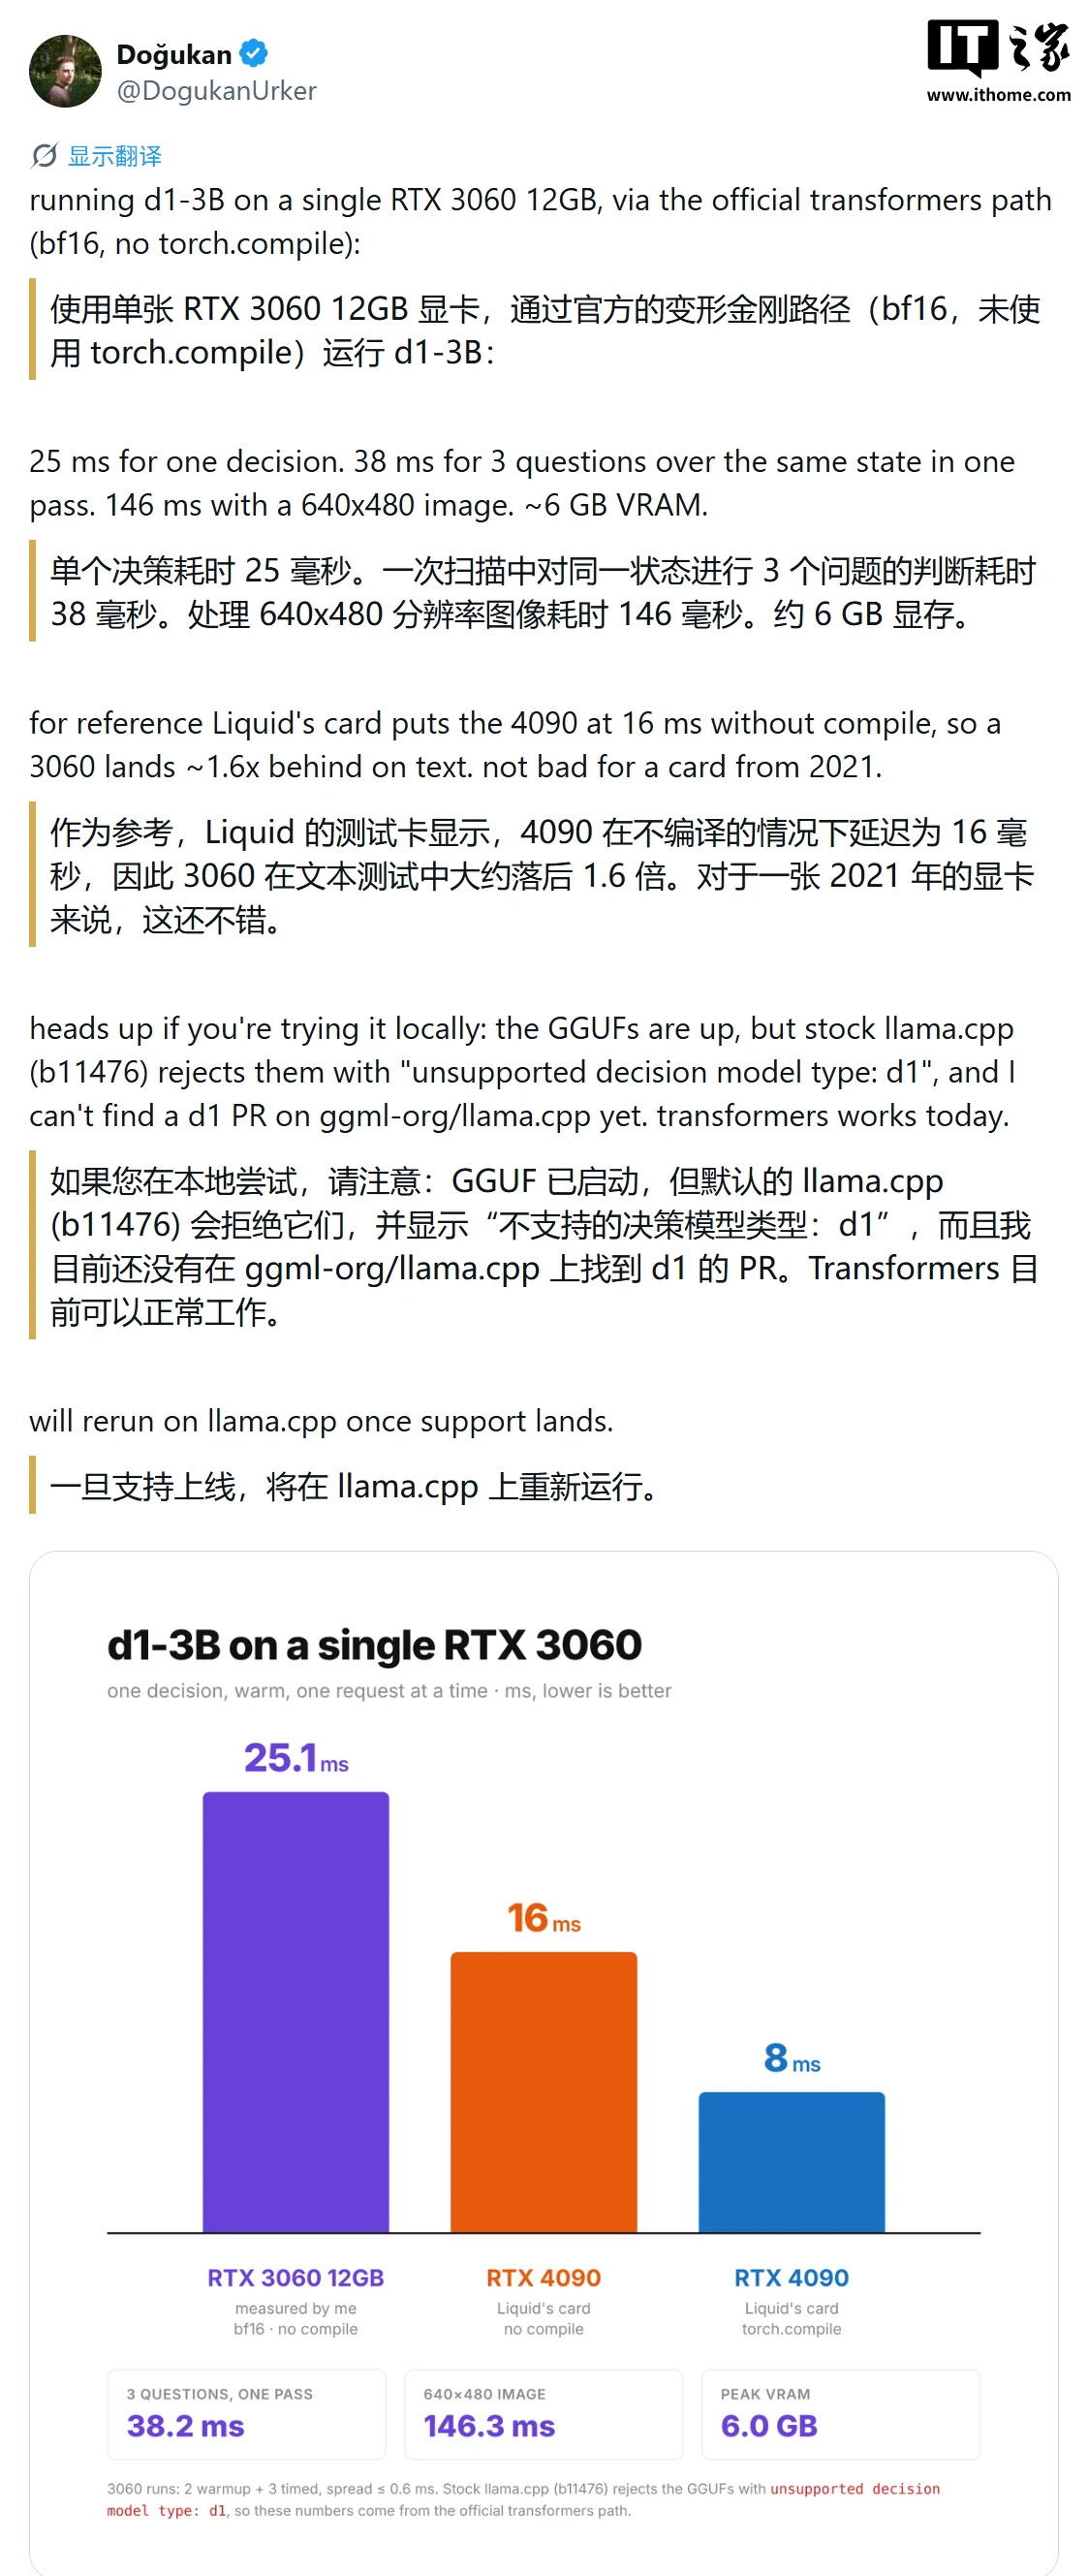
Les tests des utilisateurs montrent que d1-3B, sur une GeForce RTX 3060 avec 12 GB de mémoire vidéo, prend 25 millisecondes pour un seul jugement, traite une image de 640×480 pixels en 146 millisecondes, avec une consommation de mémoire vidéo maximale d'environ 6 GB. D'autres utilisateurs rapportent que le modèle prend 8 millisecondes par jugement sur RTX 3090.