
Wenle, depuis Aofeisi
QbitAI | Compte public WeChat QbitAI
La dualité divine et démoniaque de DeepSeek a été démasquée par l'équipe Seed de ByteDance.
La même question, sans rien changer, en ajoutant simplement quelques caractères insignifiants au début, et le modèle échoue soudainement ???
Et ce n'est pas un raté occasionnel.
Les chercheurs de Seed ont découvert que les performances de DeepSeek-V4 varient étonnamment selon la position de l'information en entrée,avec des variations périodiques tous les 4 Token。
Qu'est-ce que cela signifie ? La capacité du modèle à se souvenir d'une chose dépendrait de l'endroit où elle se situe dans l'entrée ??
En ajoutant deux Token au début, la réponse peut passer de fausse à juste, et en ajoutant encore deux Token, elle redevient fausse.
Bon, le modèle commence lui aussi à se soucier de son positionnement pour répondre.
Lors de tests de récupération en contexte long de 128K, les chercheurs ont découvert que la même information, en changeant simplement de position, faisait varier la précision de récupération des modèles de la série DeepSeek-V4 dejusqu'à 40,2 points de pourcentage。
L'équipe a en outre découvert que ce problème était lié à une technique d'optimisation du contexte long adoptée par DeepSeek-V4 —
la compression du KV Cache par blocs。
Cette technique visait à l'origine à permettre au modèle de traiter les textes longs avec moins de mémoire et plus efficacement.
Résultat : après compression, le modèle est devenu tantôt divin, tantôt démoniaque (doge).
Deux Token de plus, et DeepSeek répond soudainement correctement
Les chercheurs de ByteDance Seed ont d'abord mené une expérience avec le propre code de DeepSeek.
Le sujet du test étaitDeepSeek-V4-Flash-Base。
Ils ont extrait une fonction de quantification FP8 du code d'inférence officiel de DeepSeek-V4 et demandé au modèle de compléter le dernier Token.
La bonne réponse à la tâche devrait être 8, car ce code doit effectuer une conversion de type liée à FP8.
Mais le modèle pensait parfois qu'il fallait compléter avec 32.
Pour comprendre ce qui se passait, les chercheurs ont ajouté une docstring purement décorative avant le code, contenant des signes égaux répétés.
Puis ils ont commencé à ajuster le nombre de signes égaux.
Le code lui-même n'a pas changé, la position à compléter n'a pas changé, la bonne réponse n'a évidemment pas changé… La seule modification : ces quelques Token dénués de sens pratique ajoutés au début.
Résultat : les réponses de DeepSeek se sont mises à osciller.
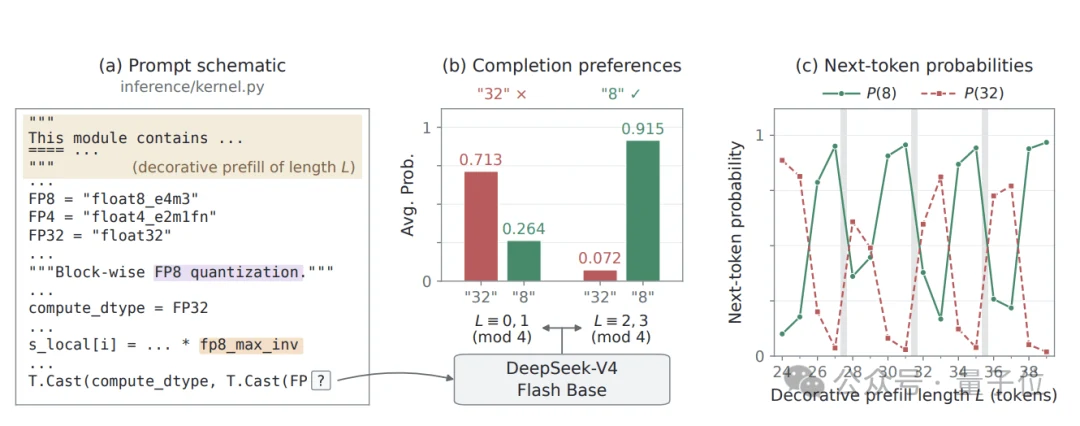
Lorsque la longueur du remplissage se situait à certaines positions, le modèle avait tendance à répondre 32, ce qui est faux.
En décalant d'un ou deux Token vers l'avant, il avait de nouveau tendance à répondre 8, la bonne réponse.
Si l'on continue à décaler, la mauvaise réponse revient —
L'ensemble du processus se répète avec une période de 4 tokens.。
Plus précisément, parmi les 16 longueurs de remplissage testées dans l'article, lorsque le reste de la longueur modulo 4 est 0 ou 1, le modèle tend vers la mauvaise réponse 32 ; lorsque le reste est 2 ou 3, il tend vers la bonne réponse 8.
Les chercheurs ont également mesuré les probabilités que le modèle attribuait aux deux réponses candidates.
Sur un ensemble de positions, la réponse erronée 32 atteignait une probabilité moyenne de 71,3 %, tandis que la réponse correcte 8 n'obtenait que 26,4 %.
En changeant d'ensemble de positions, la situation s'inverse complètement :
la probabilité moyenne de la réponse correcte 8 monte à 91,5 %, et la réponse erronée 32 ne reste qu'à 7,2 %.
Autrement dit, la simple variation de longueur de quelques caractères non pertinents placés devant suffit à amener le modèle à porter des jugements radicalement différents sur une même question.
C'est un peu difficile à juger.
Quand un programmeur débogue du code, il commence généralement par vérifier la logique, les variables et les dépendances.
Il faudrait désormais, semble-t-il, aussi vérifier au passage s'il n'a pas tapé deux signes égal en trop juste avant.
Cependant, un seul cas de complétion de code ne suffit pas à mesurer l'ampleur du problème.
L'équipe Seed a donc poursuivi les tests à plus grande échelle.
Elle s'est tournée vers une tâche classique des capacités de contexte long des grands modèles de langage,l'aiguille dans une botte de foin。
Les chercheurs ont construit un contexte d'une longueur de 128K Tokens, contenant environ1.6万 paires clé-valeur。
par exemple K1 correspond à V1, K2 correspond à V2…
puis ont demandé au modèle de retrouver la Value correspondant à une Key donnée.
Pendant les tests, les relations clé-valeur restaient inchangées, la question inchangée, et la longueur totale du contexte était maintenue constante.
Les chercheurs ont principalement ajustéla position de l'information cible par rapport à la frontière de la fenêtre de compression。
Résultat : la courbe de précision de la série DeepSeek-V4 présentait des fluctuations périodiques extrêmement marquées.
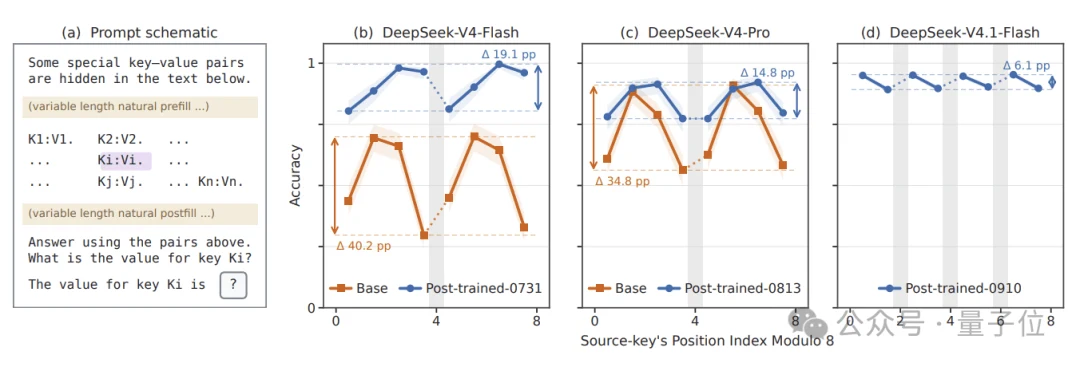
DeepSeek-V4-Flash-Base affichait ainsi un écart de précision maximal de 40,2 points de pourcentage entre différentes positions,
et DeepSeek-V4-Pro-Base atteignait 34,8 points de pourcentage.
Aprèsl'entraînement postérieurla situation s'est améliorée.
L'écart de DeepSeek-V4-Flash-0731 s'est réduit à 19,1 points de pourcentage, et celui de DeepSeek-V4-Pro-0813 à 14,8 points de pourcentage.
Le plus récent DeepSeek-V4.1-Flash-0910 a vu son écart descendre encore, à 6,1 points de pourcentage.
Mais les différences périodiques persistaient.
D'où vient cette variabilité ?
En regardant de plus près, la période de fluctuation de DeepSeek-V4 est de 4 Tokens, tandis que celle de DeepSeek-V4.1 est devenue 2 Tokens.
Les chercheurs ont découvert que celacorrespondait exactement au pas de compression du KV Cache adopté respectivement par chacune des deux générations de modèles。
Bon, même les cycles de fluctuations des performances aux questions correspondent à la configuration de compression sous-jacente.
Le problème viendrait de la compression du KV Cache ?
Eh bien, parlons justement de la compression du KV Cache.
Lorsqu'un grand modèle traite de longs contextes, il doit conserver les informations de Key et de Value correspondant à un grand nombre de Tokens historiques, pour les utiliser dans les calculs d'attention ultérieurs.
Plus le contexte est long, plus la mémoire et les coûts de calcul occupés par cette partie du cache sont importants.
En particulier pour les longues tâches comptant facilement plusieurs centaines de milliers, voire des millions de Tokens, le KV Cache devient vite un goulot d'étranglement pour l'efficacité de l'inférence.
Ainsi, DeepSeek-V4 a adoptéla compression du KV Cache par blocs。
l'idée consiste à diviser les Tokens contigus en fenêtres, puis à comprimer les informations de chaque fenêtre en un nombre réduit d'entrées de cache.
Ainsi, le modèle n'a plus besoin de conserver un cache de même ampleur pour chaque Token historique.
Cela permet d'économiser de la mémoire tout en réduisant le coût de calcul de l'attention sur les contextes longs.
Mais l'équipe Seed a découvert que la cause de la dualité divine et démoniaque de DeepSeek pourrait se cacher justement dans ce processus de découpage en blocs.
Supposons que chaque 4 Tokens constituent un pas de compression.
Alors, la même information apparaissant en position 1, 2, 3 ou 4 dans la fenêtre, les conditions dans lesquelles elle est comprimée peuvent différer.
L'article nomme cette position relative aux limites de la fenêtre de compressionla Phase (phase)。
Les chercheurs ont constaté quela capacité de récupération du modèle présente des différences systématiques selon la phase de l'information。
Ils ont nommé ce phénomènePhase Sensitivity, la sensibilité de phase。
Prenons une analogie : on remet au modèle le même document :
Dans la première mise en page, le chiffre clé tombe justement à l'endroit que le modèle retient facilement ;
dans la seconde mise en page, on a seulement ajouté quelques mots au début, ce qui change la position du chiffre clé par rapport à la fenêtre de compression.
Le document reste le même, mais la capacité du modèle à retrouver ensuite le chiffre peut différer nettement.
De plus, ce problème ne peut pas être simplement attribué au fait que « l'information se trouve coupée entre deux fenêtres ».
Les chercheurs ont constaté que, même lorsque la Key et la Value se trouvent dans la même fenêtre de compression, la précision de récupération peut varier fortement selon la position.
Cela montre que le problème concerne aussi la manière dont le modèle écrit réellement l'information dans le cache comprimé, et dont il la lit ensuite depuis le cache.
Pour le confirmer davantage, l'équipe Seed a carrément entraîné elle-même, à partir de zéro, une série de modèles.
Ils ont pris comme basel'architecture Qwen3-0.6Bconstruit plusieurs schémas de compression du KV Cache, et établi comme référence un modèle à attention complète sans compression par blocs.
Seul le mécanisme de compression était modifié, afin de voir si les fluctuations périodiques apparaissaient en conséquence.
Résultat :tous les modèles à compression par blocs testés ont présenté des variations périodiques correspondant au pas de compression。
En revanche, le modèle de référence à attention complète n'a pas montré de périodicité d'une ampleur équivalente.
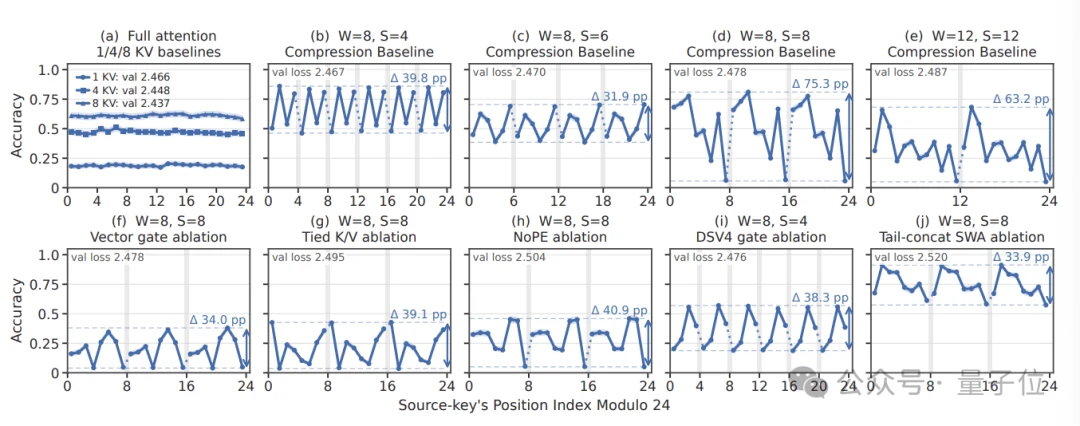
Les chercheurs ont également ajusté séparément la taille de la fenêtre et le pas de compression, et ont constaté que la période suivait principalement le pas de compression.
Avec un pas de 4, les performances fluctuaient avec une période d'environ 4 Tokens ;
avec un pas de 6, la période passait elle aussi à environ 6 Tokens ;
Avec un pas de 8, il en va de même ;
……
même sans utiliser l'encodage positionnel RoPE, ou en remplaçant les poids de compression apprenables par une simple moyenne, le phénomène persiste.
En d'autres termes, le problème n'est pas causé individuellement par un encodage positionnel ou un module particulier.
C'est la conception même de la compression par blocs qui peut introduire des faiblesses périodiques de récupération.
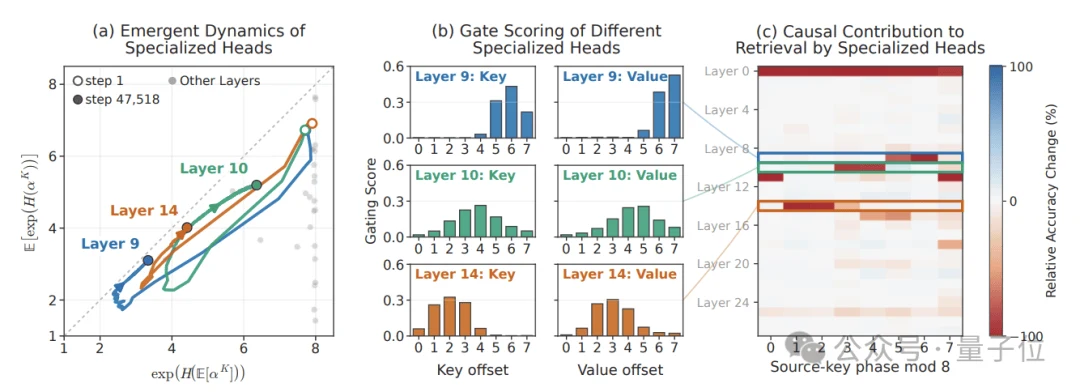
L'équipe Seed est allée plus loin en intervenant sur les têtes d'attention, afin d'observer comment la capacité de récupération du modèle à chaque phase évolue après la suppression de différents composants.
Les résultats montrent que les contributions des différentes têtes d'attention aux différentes phases ne sont pas identiques.
Certaines têtes sont plus aptes à traiter l'information de certaines positions, tandis que d'autres jouent un rôle plus important à d'autres positions.
Les chercheurs appellent cela la Phase Specialization, la spécialisation de phase.
Autrement dit, le modèle semble développer en interne une forme de division du travail : différentes composantes d'attention développent des préférences pour différentes positions dans la fenêtre de compression.
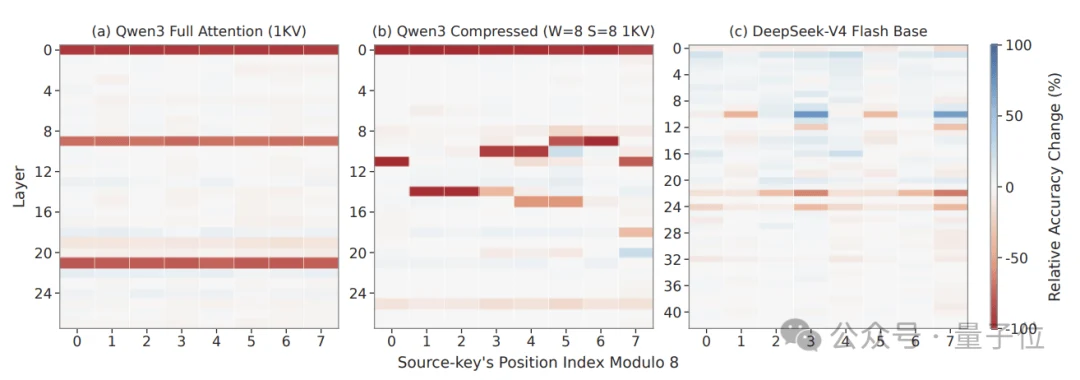
Cette division du travail peut aider le modèle à effectuer la récupération d'informations, mais elle peut aussi faire de certaines positions des maillons relativement faibles.
L'article analyse également le processus d'entraînement à travers un modèle théorique simplifié, et constate que le flux de gradients peut pousser le module de compression à former des préférences de position stables.
Cela explique aussi pourquoi cette périodicité n'est pas un simple bruit aléatoire. Elle pourrait être le résultat naturel de l'apprentissage par le modèle de la manière de compresser l'information.
Mais ce type de problème ne se voit pas nécessairement directement dans les benchmarks ordinaires, car les évaluations classiques compilent généralement un grand nombre de résultats de tests en une note moyenne.
Supposons que le modèle performe très bien à certaines positions et décroche nettement à d'autres : la moyenne calculée au final pourrait malgré tout rester bonne.
C'est pourquoi l'équipe Seed propose que, lors de l'évaluation de modèles utilisant une compression par blocs du KV Cache, on ne se contente pas de regarder la précision globale de récupération, mais qu'on place la même information sur différentes phases de compression et qu'on la teste séparément dans chaque cas.
Pourtant, même en présence de ce biais de performance lié aux positions, face aux coûts de mémoire et de calcul du raisonnement sur de longs contextes, la compression conserve une valeur bien réelle.
Mais après avoir économisé sur le cache, le modèle peut ne plus traiter l'information de différentes positions sur un pied d'égalité.
Bien sûr, au vu des résultats de ces expériences, le post-entraînement et l'itération architecturale permettent effectivement de réduire nettement cet écart.
Adresse de l'article : https://arxiv.org/pdf/2609.36322