
Construire un agent d'IA pour une démonstration et en exploiter un pour 40 millions de développeurs sont des problèmes d'ingénierie différents. Postman s'est donné pour mission de construire Agent Mode, une manière native d'IA de travailler sur les tests d'API, la documentation, la découverte et l'implémentation. L'équipe s'attendait à ce que la qualité des modèles et la conception des invites soient les problèmes les plus difficiles. Les défis les plus profonds sont venus de l'intégration d'un agent dans un produit mature avec des années d'hypothèses fondées sur l'interface, une surface étendue et des concepts spécialisés.
Dans cet article, Postman et AWS décrivent les modèles architecturaux qui ont émergé lors du rendu d'un produit mature lisible pour un agent d'IA. Ces modèles incluent la maîtrise de la prolifération d'outils, l'exposition de lectures basées sur des schémas et la considération du contexte plutôt que de la capacité comme goulot d'étranglement principal.
Nous expliquons également comment Agent Mode utilise Amazon Bedrock pour la flexibilité des modèles, l'inférence multi-Régions à portée géographique, la rétention nulle des données selon le modèle et la mise en cache des invites multi-niveaux. Ensemble, ces leçons peuvent aider les équipes à faire passer leurs agents de production au-delà des prototypes.
Pourquoi Postman a construit Agent Mode
Agent Mode est le portail de Postman pour travailler avec le produit de manière native en IA sur les tests, la documentation, la découverte et l'implémentation. Postman a évolué pendant 11 ans, et les développeurs et utilisateurs ont appris à localiser l'information via l'interface en déployant des barres latérales, en consultant des onglets et en ouvrant des requêtes. Ré-ingénierier cette conscience pour un agent a mis en évidence des hypothèses structurelles dans les API du produit, son expérience utilisateur et la distribution du savoir produit. Un agent raisonne sur les données plutôt que de naviguer sur un écran. La figure 1 illustre comment Agent Mode agit directement sur l'application.
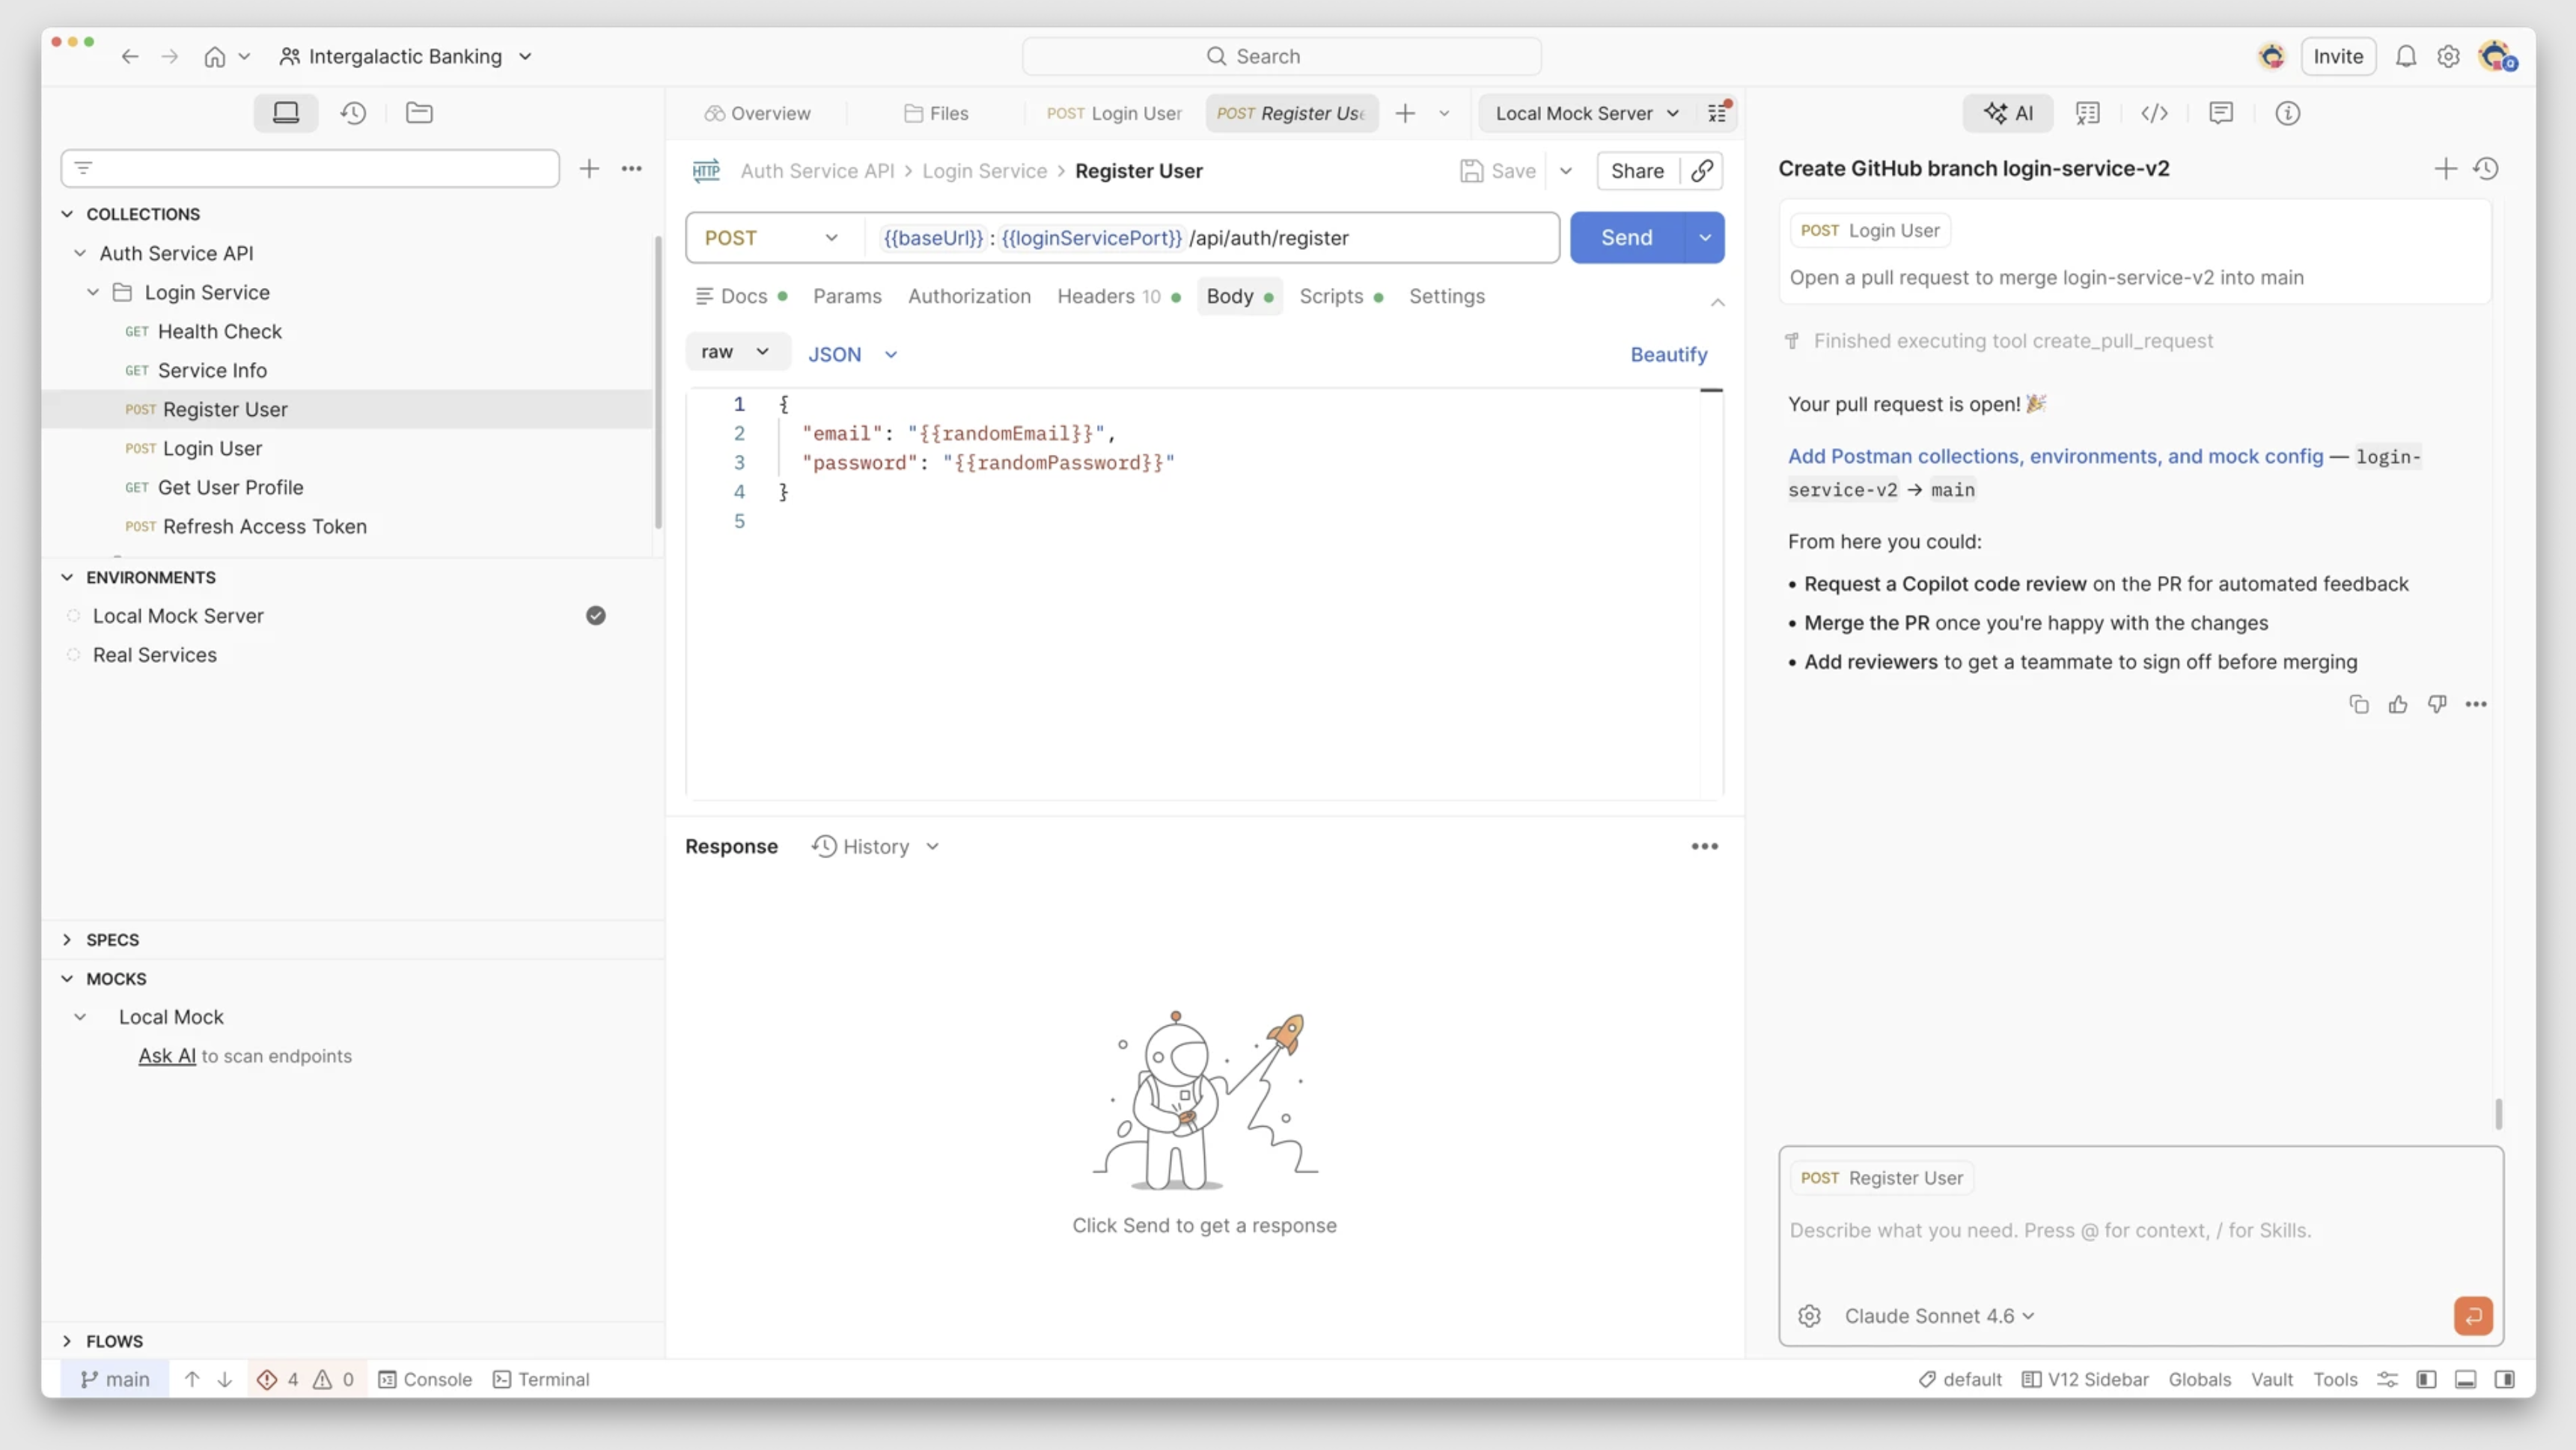
Figure 1 : Agent Mode agit directement sur l'application Postman. Dans cet exemple, il ouvre une pull request et propose les étapes suivantes sans que l'utilisateur ait à naviguer dans l'interface
Agent Mode s'exécute sur Amazon Bedrock, qui fournit un accès géré aux modèles de fondation derrière l'agent. Prendre en charge la communauté mondiale de développeurs de Postman crée une demande variable et sensible à la latence avec de fortes pointes de trafic. Avec Amazon Bedrock, Postman peut faire évoluer cette charge de travail de production sans exploiter sa propre infrastructure de service de modèles, tout en conservant la flexibilité dans le choix des modèles et le contrôle du débit, du traitement géographique et des coûts. La figure 2 fournit une vue d'ensemble de l'architecture de production avant que les sections suivantes n'examinent ses composants.
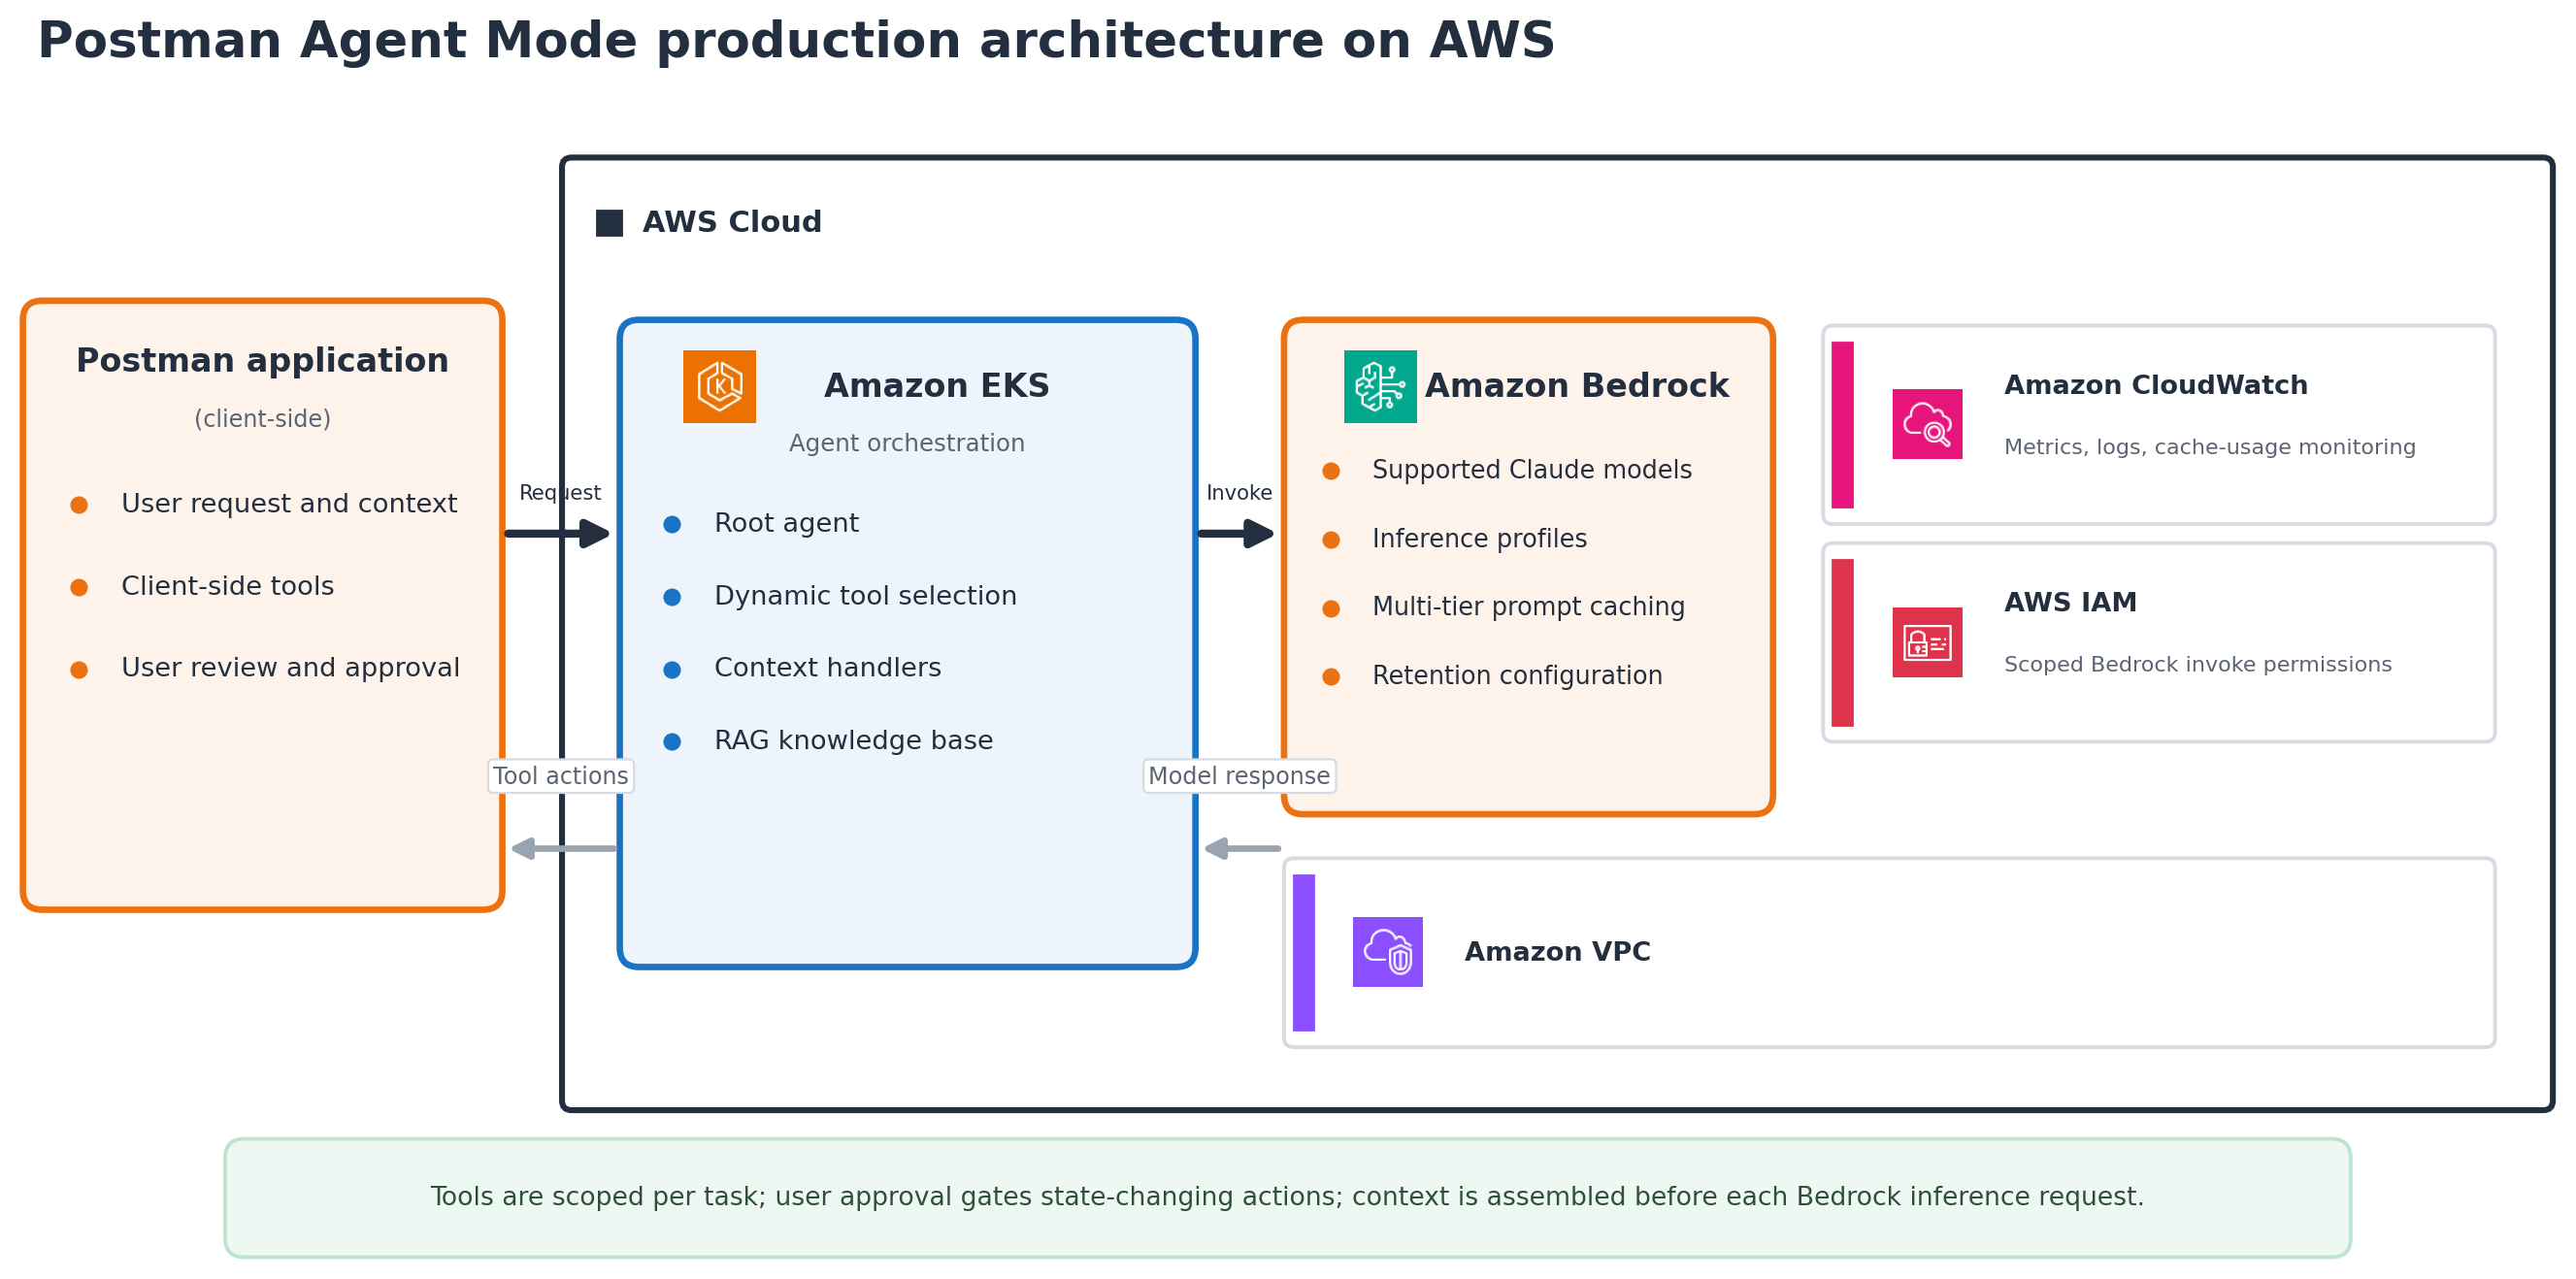
Figure 2 : Postman Agent Mode combine des outils côté client, une orchestration d'agent, un contexte construit sur mesure et l'inférence de modèles Amazon Bedrock. Les outils sont délimités pour chaque tâche, et l'approbation de l'utilisateur demeure une partie des actions qui modifient l'état de l'application
La supervision humaine fait partie de la conception de production. Agent Mode exige l'approbation de l'utilisateur avant les actions qui modifient l'état de l'application. Postman délimite également les outils disponibles selon la tâche, sélectionne un contexte construit sur mesure et applique des paramètres de rétention des données dépendant du modèle. Ces contrôles réduisent les actions involontaires et l'exposition inutile des données, tandis que les tests et la surveillance de production restent nécessaires. Comme contrôle d'IA responsable, Postman utilise Amazon Bedrock Guardrails pour masquer les informations personnellement identifiables avant qu'elles n'atteignent le grand modèle de langage (LLM) sous-jacent. Les administrateurs d'entreprise peuvent activer cela dans les paramètres de garde-fous d'Agent Mode.
Gérer la prolifération d'outils
Dans Agent Mode, les outils définissent la manière dont l'agent agit au sein de Postman. Au début, l'équipe penchait vers des outils très atomiques : de petites actions précises telles qu'ouvrir une requête, mettre à jour un champ ou récupérer une métadonnée spécifique. Cette approche favorisait l'exactitude et le contrôle dans les premières itérations, mais elle a aussi révélé plusieurs problèmes.
De nombreux flux de travail réels exigent de longues séquences d'appels d'outils. Même lorsque chaque étape était rapide, l'expérience globale semblait lente, car chaque action devait revenir au modèle avant que la suivante puisse commencer. Les utilisateurs regardaient l'agent passer par des actions qu'ils avaient mentalement regroupées en une seule opération.
Lors des tests de Postman, les erreurs de sélection d'outils ont augmenté une fois que l'ensemble d'outils visible a dépassé environ 40 outils. L'agent pouvait appeler des outils inexistants, passer des arguments incorrects malgré des schémas valides, ou sélectionner des outils qui semblaient sémantiquement raisonnables mais qui étaient erronés dans le contexte. Les modèles plus grands ou plus récents ont réduit ce comportement sans toutefois l'éliminer.
Au-delà d'une certaine taille d'ensemble d'outils, exposer davantage d'outils peut réduire l'efficacité de l'agent. L'architecture actuelle sélectionne les outils en fonction des besoins et du contexte, et isole les fils d'exécution individuels. Le modèle ne voit que les outils pertinents pour la tâche en cours. La Figure 3 illustre ce processus de sélection dynamique.
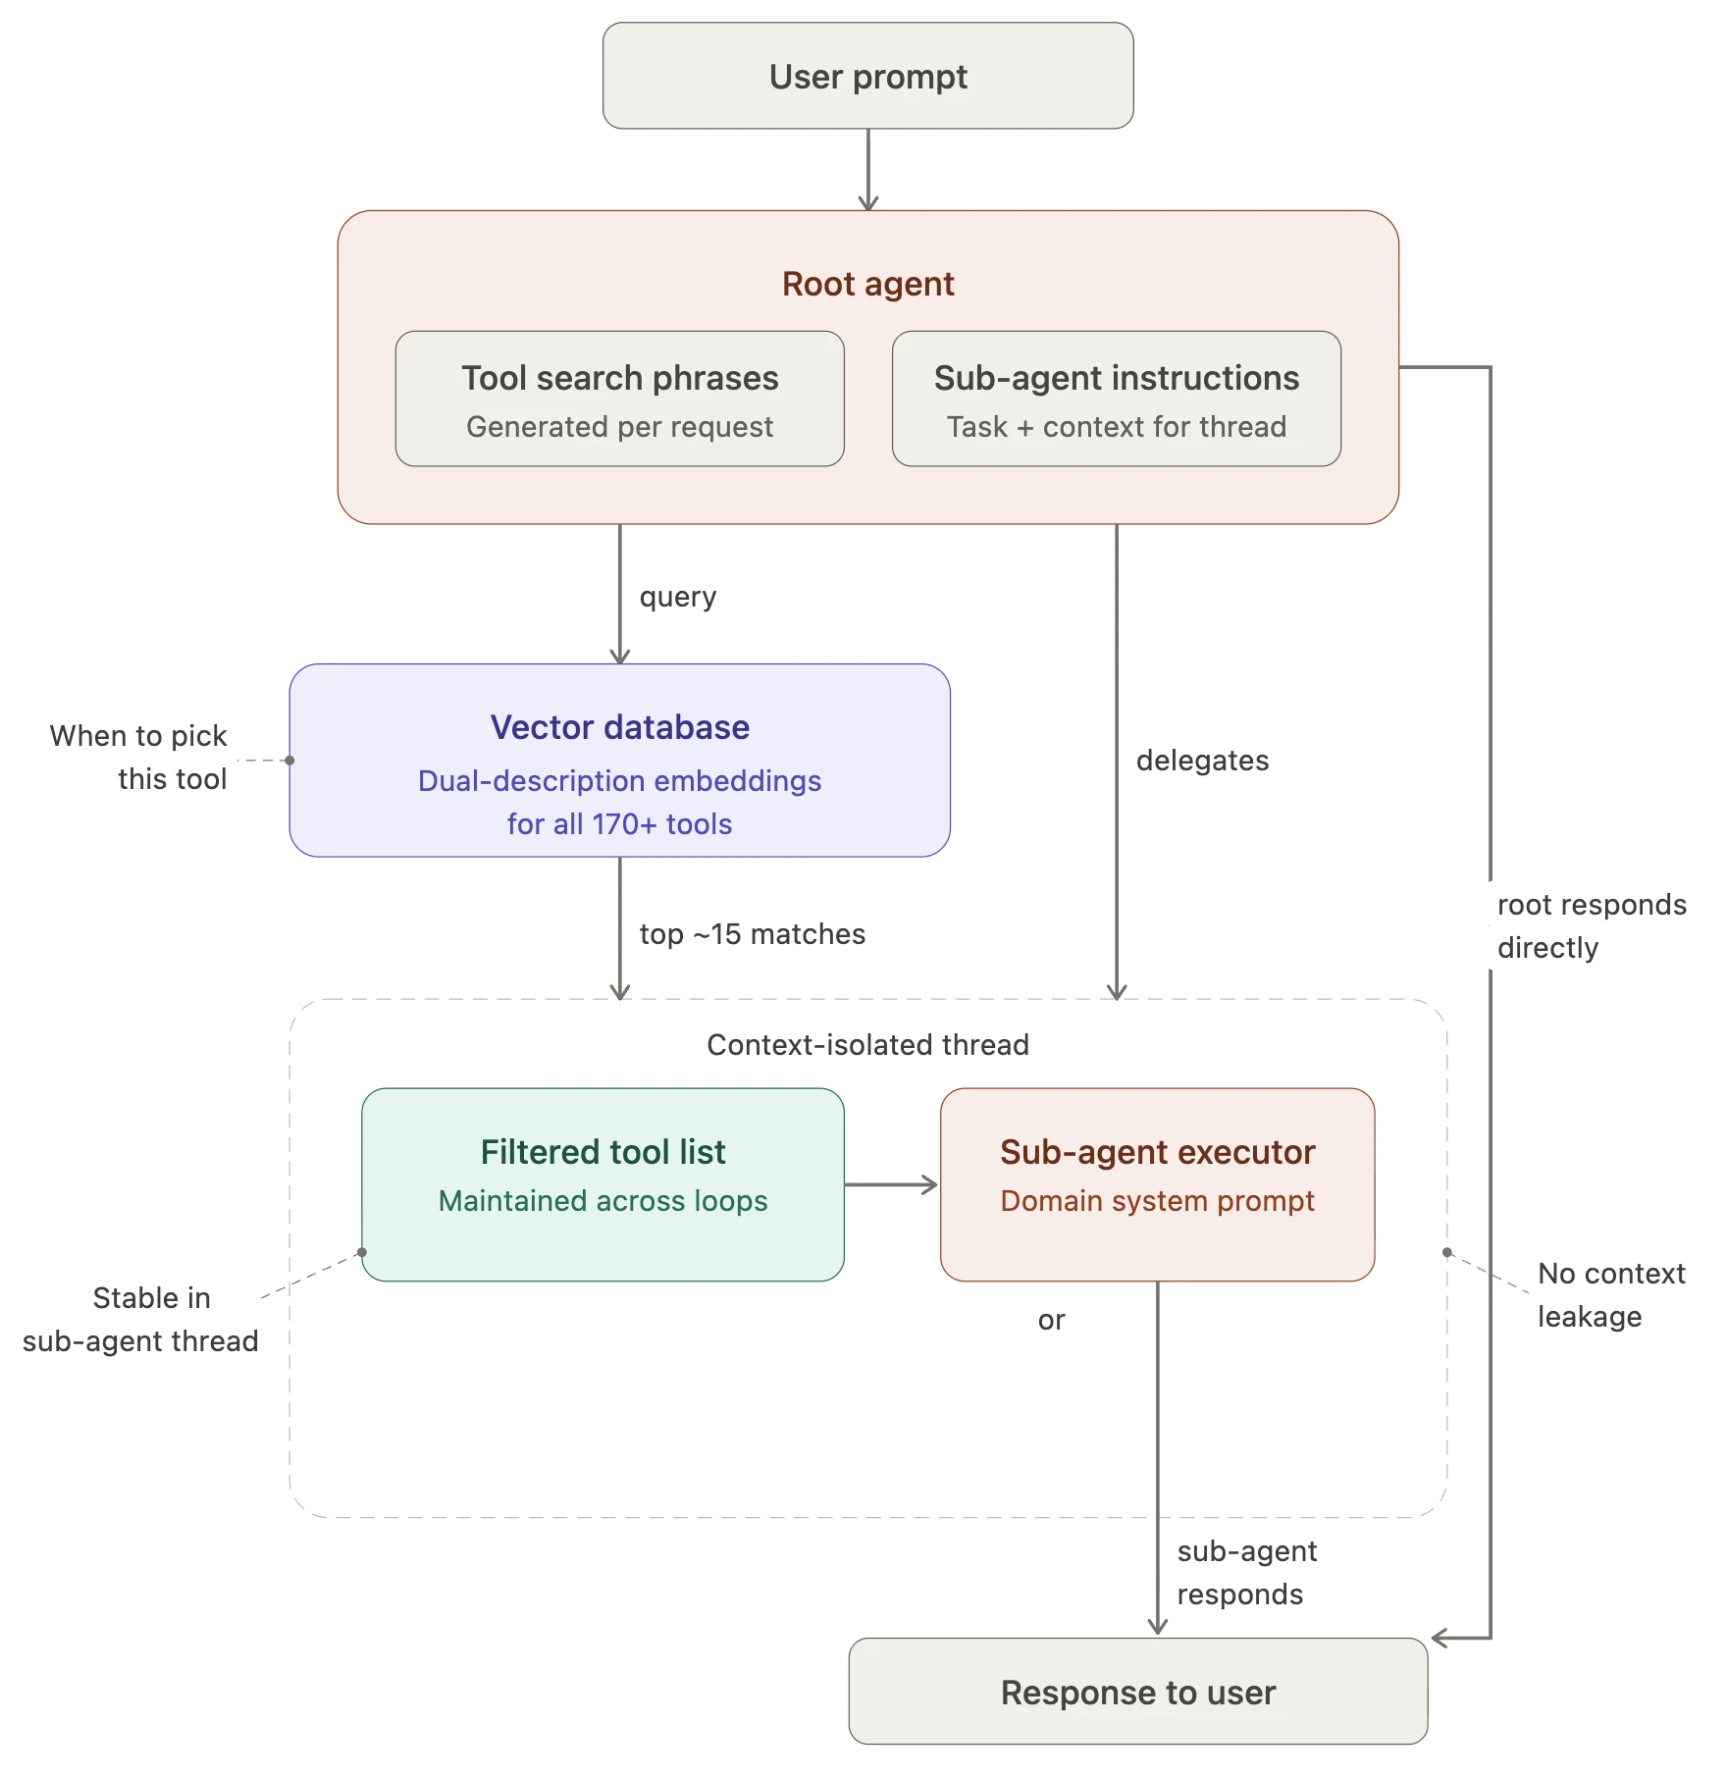
Figure 3 : L'agent racine interroge une base de données vectorielle d'embeddings d'outils et réduit plus de 170 outils à environ 15 outils pertinents pour la requête. Il transmet ensuite ces outils à un sous-agent isolé du contexte, de sorte que le modèle ne voit que les outils nécessaires à la tâche
Un problème plus subtil était que de nombreuses API clientes étaient implicitement couplées à l'état de l'interface. Les outils qui modifiaient des requêtes nécessitaient que certains éléments soient ouverts, tandis que d'autres outils ouvraient de nouveaux onglets comme effets secondaires. L'agent devait ouvrir un onglet de requête pour la lire, imitant les interactions avec l'interface au lieu de raisonner sur les données. Postman découple activement les outils des onglets, et sa Git natif fonctionnalité utilise largement cette approche. Par exemple, Agent Mode peut désormais envoyer des requêtes en arrière-plan sans onglet ouvert, bien que l'approbation de l'utilisateur soit toujours requise.
Conseil aux développeurs : Traitez votre catalogue d'outils comme faisant partie du budget de contexte. Délimitez dynamiquement les outils exposés au modèle pour chaque tâche, et découplez « ce que l'agent peut faire » de « ce que l'interface a happen d'ouvert ».
Exposer des lectures basées sur les schémas
Pour des produits tels que l'API Catalog, Postman a consolidé plusieurs vues étroites en un seul outil de requête. Ces produits exposent des données structurées telles que la disponibilité des services, les résultats de tests et les temps de réponse des points de terminaison sur de nombreux services.
Connaissant les schémas des tables ClickHouse sous-jacentes, l'agent peut générer des requêtes complexes avec des jointures et des clauses WHERE. Cela réduit considérablement le nombre d'outils distincts nécessaires pour répondre à une question d'analyse :
SELECT toString(service_id) AS service_id,
    countMerge(total_events_state) AS total_requests,
    countMerge(error_events_state) AS total_errors,
    round(countMerge(error_events_state) * 100.0
        / countMerge(total_events_state), 4) AS error_rate_pct,
    avgMerge(avg_latency_state) AS avg_latency_ms,
    quantileMerge(0.95)(p95_latency_state) AS p95_latency_ms
FROM http_events_summary_1d
WHERE service_id IN ('...list of service IDs')
    AND bucket_1d >= today() - 7
GROUP BY service_id
HAVING p95_latency_ms < 100
    AND total_requests > 0
ORDER BY error_rate_pct DESC;
Avec cette approche, le travail d'ingénierie passe de la construction d'un outil par question à la modélisation soignée des données une seule fois. L'agent peut alors générer une bien plus grande variété de requêtes que ce que l'équipe aurait jamais pu énumérer comme outils individuels.
Conseil aux développeurs : Lorsque vous disposez de données bien structurées, donnez à l'agent un accès en lecture sensible au schéma à un moteur de requêtes plutôt qu'une prolifération d'outils de lecture à usage unique. Vous échangez le nombre d'outils contre la modélisation des données, ce qui produit une meilleure courbe de montée en charge.
Le contexte était le véritable goulot d'étranglement
Postman supposait initialement que l'absence d' outils serait le plus grand obstacle. En pratique, l'absence ou l'incomplétude du contexte a causé plus d'échecs que l'absence de capacités.
Le contexte est la compréhension par l'agent de l'endroit où l'utilisateur se trouve dans Postman, des entités actives et de l'état déjà établi. Lorsque ce contexte était erroné ou absent, même des outils corrects devenaient inefficaces. La Figure 4 distingue les deux formes de contexte fournies à l'agent.
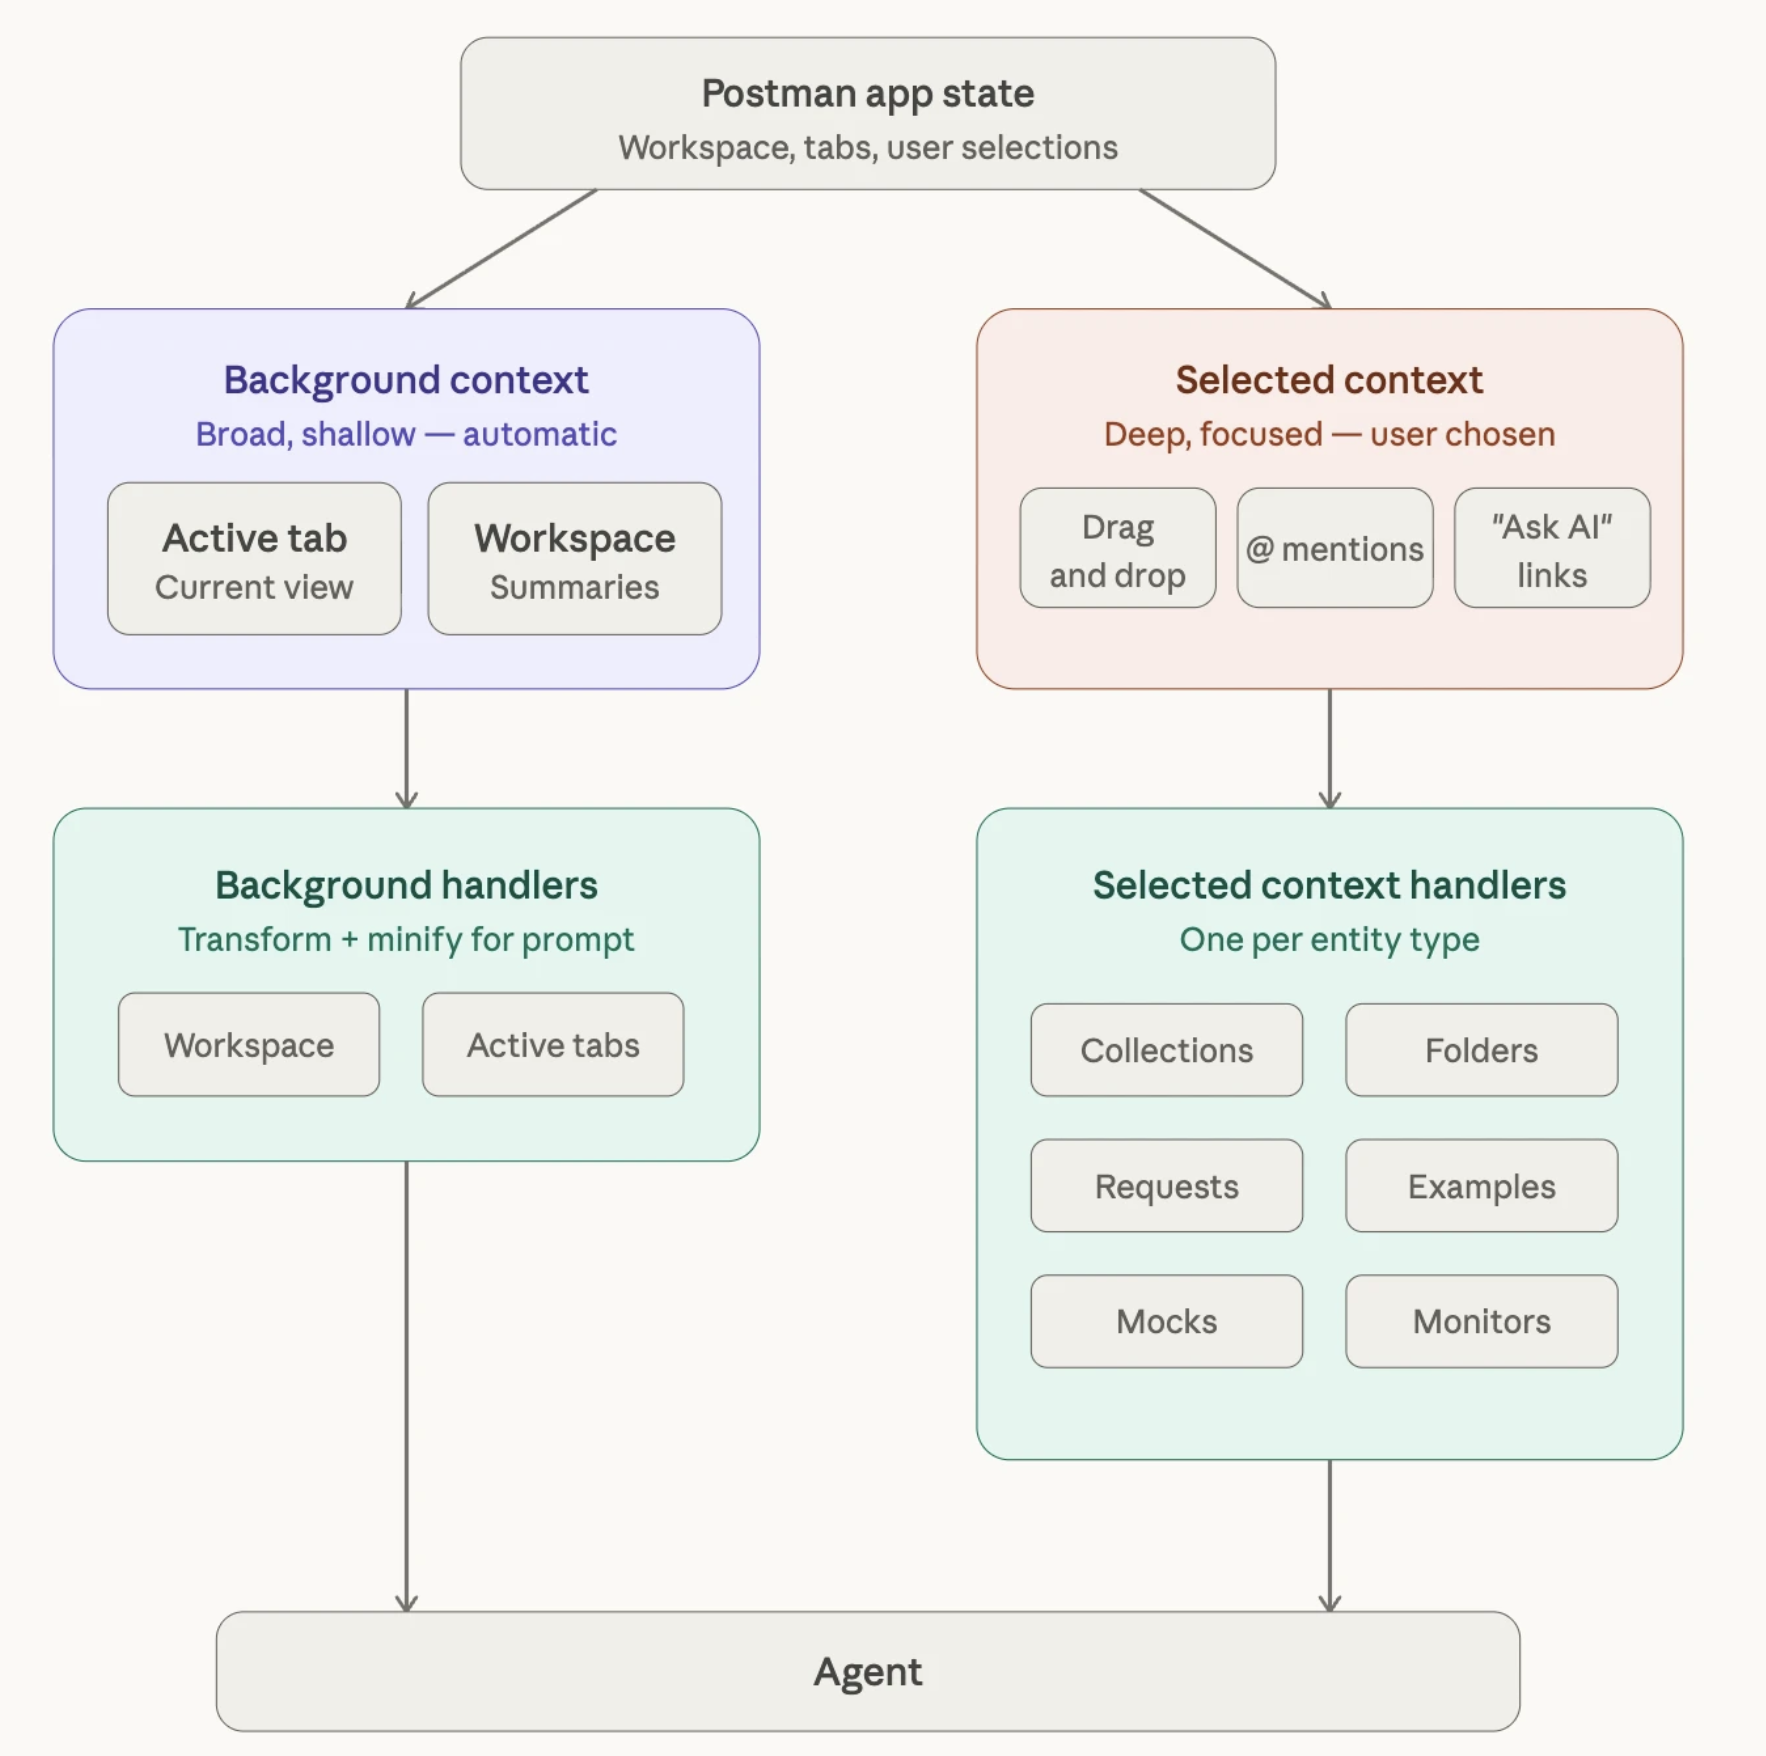
Figure 4 : Deux types de contexte alimentent l'agent. Le contexte d'arrière-plan, large et superficiel, est collecté automatiquement et réduit pour le prompt. Le contexte sélectionné, approfondi et ciblé, est choisi par l'utilisateur et acheminé via un gestionnaire dédié pour chaque type d'entité. Chaque gestionnaire distille l'entité en les informations dont l'agent a besoin
Le défi était structurel. Pendant plus de 11 ans, les développeurs et les utilisateurs ont appris à trouver l'information via l'interface. Réingénier cette conscience pour un agent a nécessité plusieurs itérations pour déterminer ce qui comptait pour chaque flux de travail et ce qui était du bruit. Sérialiser le modèle de données de l'interface existante ne produisait pas de contexte utile, car ces objets étaient façonnés pour le rendu et le transfert de données, pas pour le raisonnement. Postman a donc construit des gestionnaires de contexte dédiés qui distillaient chaque entité en ce que l'agent devait savoir.
À mesure que davantage d'objets ont acquis des gestionnaires, la troncature est devenue le problème suivant. De nombreux champs contiennent des données ouvertes générées par les utilisateurs, notamment des descriptions de requêtes, des spécifications OpenAPI et des payloads de requêtes. Ces données peuvent encombrer la fenêtre de contexte. Gérer soigneusement le budget de contexte est essentiel à grande échelle et soutient l'approche basée sur le système de fichiers que l'équipe explore, où chaque gestionnaire n'a pas besoin d'une logique de troncature et d'expansion personnalisée.
Conseil aux développeurs : Ne nourrissez pas le modèle avec votre modèle de données de rendu. Construisez des gestionnaires de contexte adaptés à un objectif précis et traitez la fenêtre de contexte comme un budget rare et activement géré. Le bruit évince le signal bien avant que le modèle n'atteigne sa limite.
Tout mettre ensemble
À mesure que le Agent Mode évoluait, il est devenu évident que le système devait agréger trois composants distincts, chacun résolvant un problème différent.
- Les outils côté client résident dans l'application Postman et représentent les actions finales que l'agent peut effectuer, telles que l'ouverture de requêtes, la modification de paramètres, l'exécution de collections et l'inspection de l'authentification. Agent Mode utilise également des outils côté serveur pour des fonctions telles que la recherche web et la gestion de la boucle de l'agent, mais la plupart des outils opèrent sur l'application Postman.
- Des instructions génériques d'agent définissent le comportement au niveau du système, notamment le degré de proactivité du Agent Mode, la manière dont il communique l'incertitude et les connaissances de base du produit qu'il possède.
- Une base de connaissances utilise une approche de génération augmentée par récupération (RAG). Postman possède une vaste surface produit qui inclut plusieurs protocoles de requête, des serveurs simulés (mock servers), des moniteurs, la documentation, l'API Network, la gouvernance des workspaces, les variables, les helpers, la génération de code, les paramètres de requête et les exécutions de collections.
Encoder tout cela dans des invites statiques n'était pas réalisable, et la plupart de ces éléments sont sans rapport avec une requête donnée. Pour l'amorçage initial, l'équipe a utilisé le Postman Learning Center pour générer des articles concis propres à chaque fonctionnalité. À l'exécution, Agent Mode sélectionne les articles de connaissances en fonction de la requête entrante et du contexte disponible. Par exemple, lorsqu'un utilisateur sélectionne un serveur simulé (mock server), Agent Mode injecte automatiquement l'article correspondant. Cela permet de garder l'agent léger par défaut tout en offrant de la profondeur au besoin. La base de connaissances évolue avec l'application, si bien que les équipes peuvent livrer la documentation d'Agent Mode avec les nouvelles fonctionnalités.
Exécuter Agent Mode sur Amazon Bedrock
Les trois composants décrits précédemment aboutissent à la même action d'exécution : un appel d'inférence à un modèle de fondation (FM). À l'échelle de Postman, le trafic est irrégulier et piloté par les développeurs. Le routage, la mise en cache et les contrôles de traitement géographique aident Postman à absorber les pics de trafic, à maîtriser le coût de l'inférence et à répondre aux exigences de traitement propres à chaque charge de travail. Amazon Bedrock fournit les quatre capacités les plus importantes ici.
Flexibilité des modèles au sein de la famille Claude
Agent Mode n'est lié à aucun modèle en particulier. Via les API d'inférence de modèles Amazon Bedrock, Postman peut accéder aux modèles Anthropic Claude pris en charge et router chaque charge de travail vers un modèle approprié. Un modèle plus rapide peut servir les interactions à fort volume et sensibles à la latence, tandis qu'un modèle plus grand peut gérer le raisonnement complexe là où la qualité compte plus que le coût. Passer d'un modèle Claude pris en charge à un autre est avant tout un changement de configuration plutôt qu'une nouvelle intégration. Cette flexibilité répond directement aux défis de prolifération d'outils et de contexte décrits plus tôt. Lors de ses tests, Postman a constaté que les modèles plus récents et plus grands réduisaient les hallucinations d'outils, et Postman peut adopter les modèles pris en charge sans reconstruire l'intégration. Voir les modèles pris en charge par région AWS dans Amazon Bedrock.
Inférence inter-régions pour un débit élevé
Le trafic des développeurs est irrégulier, et provisionner pour la demande de pointe dans une seule région AWS peut s'avérer coûteux. Agent Mode utilise l'inférence inter-régions d'Amazon Bedrock pour router automatiquement les requêtes parmi les régions de destination définies par un profil d'inférence. À l'exécution, l'application transmet l'ID du profil d'inférence sélectionné ou l'Amazon Resource Name (ARN) comme modelId dans Converse ou InvokeModel. Le profil, les politiques IAM (AWS Identity and Access Management) et de contrôle de service applicables, ainsi que les quotas, doivent autoriser chaque région de destination que Bedrock pourrait sélectionner.
- Les profils d'inférence géographiques routent les requêtes uniquement parmi les régions prises en charge au sein d'une zone géographique définie, comme les États-Unis ou l'Union européenne. Cette option associe un débit accru à une frontière de traitement géographique configurée.
- Les profils d'inférence globaux peuvent router les requêtes parmi les régions de destination prises en charge dans le monde entier afin d'offrir un débit supplémentaire lors des pics de trafic. Ils ne conviennent que lorsque la charge de travail n'exige pas de frontière de traitement géographiquement contrainte.
Postman peut sélectionner le profil d'inférence par charge de travail : un profil global pour le débit disponible maximal ou un profil géographique lorsque le traitement doit rester dans la zone géographique définie par le profil. Ce choix est explicite dans le modelId utilisé pour chaque requête d'inférence Bedrock.
# Schematic Converse request
response = bedrock_runtime.converse(
    modelId="<geographic-inference-profile-id-or-arn>",
    messages=messages,
    system=system_blocks,
)
Résidence des données et contrôles d'entreprise
Pour les clients d'entreprise, la géographie de traitement autorisée peut être aussi importante que le débit. Les profils d'inférence géographiques contraignent le routage de Bedrock aux régions de destination prises en charge par le profil au sein de la zone géographique sélectionnée. Cela ne signifie pas que l'inférence s'exécute dans l'environnement AWS propre à Postman. Amazon Bedrock traite les requêtes dans les régions AWS éligibles pour ce profil, avec des données chiffrées en transit et au repos. AWS indique que Bedrock n'utilise pas les invites et complétions pour entraîner ses modèles ni pour les distribuer à des tiers. Postman a configuré une rétention des données nulle avec data_retention_mode défini sur none pour les modèles Agent Mode pris en charge. La disponibilité et le comportement dépendent du modèle ; chaque modèle de production doit donc être vérifié par rapport à la documentation actuelle sur la protection et la rétention des données d'Amazon Bedrock.
La mise en cache des invites pour maîtriser les coûts
Un agent de production renvoie à chaque tour un contexte stable substantiel, incluant les instructions système, le comportement générique de l'agent, un ensemble d'outils de base, les connaissances sélectionnées et le contexte de la conversation. Retraiter le préfixe inchangé à chaque requête ajoute une latence et un coût évitables.
Agent Mode utilise la mise en cache des invites d'Amazon Bedrock pour réutiliser les préfixes d'invite stables. Le cœur quasi immuable, comprenant l'invite système, les instructions de l'agent et les définitions des outils de base, utilise un point de contrôle de cache d'une heure. Le contexte plus variable utilise un point de contrôle de cinq minutes qui se rafraîchit à chaque accès au cache. Bedrock exige que le point de contrôle à plus longue durée apparaisse avant le point de contrôle à plus courte durée. Le niveau le plus court convient aux sessions interactives car le contexte inactif expire, tandis que le niveau d'une heure peut amortir son prix d'écriture en cache plus élevé sur de nombreuses lectures. Les bénéfices du cache et les TTL pris en charge dépendent du modèle sélectionné. Les équipes peuvent vérifier le comportement via les champs d'utilisation cacheReadInputTokens et cacheWriteInputTokens et mesurer le délai avant le premier token pour leurs propres charges de travail.
# Schematic cache checkpoints in Converse content blocks
{"cachePoint": {"type": "default", "ttl": "1h"}}  # stable core
{"cachePoint": {"type": "default", "ttl": "5m"}}  # variable layer
À retenir pour les développeurs : Traitez l'inférence comme un problème de routage et de mise en cache, et pas seulement comme une décision de sélection de modèle. Sélectionnez le modèle Claude selon la charge de travail, choisissez le profil d'inférence inter-régions approprié, et mettez en cache le préfixe de prompt stable avec des TTL correspondant à la fréquence de changement de chaque couche.
Bonnes pratiques pour faire évoluer les agents en production
Distillées du parcours de Postman, pour les développeurs travaillant sur Amazon Bedrock :
- Budgétez les outils aussi soigneusement que les tokens. Sélectionnez dynamiquement les outils exposés par tâche. Lors des tests de Postman, les erreurs de sélection d'outils augmentaient à mesure que l'ensemble d'outils visibles devenait volumineux.
- Préférez les lectures conscientes du schéma à la prolifération d'outils. Modélisez bien vos données et laissez l'agent les interroger.
- Découplez les actions de l'agent de l'état de l'interface. Si un outil nécessite un onglet ouvert, l'agent navigue dans l'interface plutôt que de raisonner directement sur les données.
- Construisez le contexte de manière délibérée. Des gestionnaires de contexte dédiés surpassent toujours la sérialisation de votre modèle de rendu.
- Gérez la fenêtre de contexte comme une ressource rare. La stratégie de troncature et d'expansion est un problème de conception à part entière, pas une réflexion après coup.
- Livrez la documentation avec les fonctionnalités. Une base de connaissances RAG ne reste utile que si elle évolue en parallèle du produit.
- Routez et mettez en cache sur Bedrock. Associez chaque charge de travail au modèle Claude approprié, choisissez l'inférence inter-régions en fonction des besoins de débit et de géolocalisation, et appliquez une mise en cache par niveaux aux préfixes de prompts stables.
Conclusion
La création du mode Agent a obligé Postman à affronter l'écart entre les capacités des grands modèles de langage et la structure de produits matures : hypothèses d'interface, clients couplés, catalogues d'outils tentaculaires et connaissances réparties entre documentation et équipes. La sélection dynamique d'outils, les lectures basées sur le schéma et l'ingénierie délibérée du contexte se sont révélées être des schémas répétables à l'échelle de la communauté de développeurs de Postman. Amazon Bedrock fournit l'accès géré aux modèles, l'inférence inter-régions, les contrôles de rétentiondépendants du modèle, et la mise en cache des prompts qui prennent en charge l'architecture de production.
Que vous construisiez votre premier agent ou que vous fassiez évoluer un agent existant, ces schémas peuvent aider les équipes à éviter les défis courants d'intégration et de mise à l'échelle des agents.
Pour en savoir plus, consultez la documentation Amazon Bedrock, y compris des conseils pour l’inférence inter-régions, la mise en cache des prompts, et la protection et la rétention des données. Pour obtenir des conseils d’implémentation associés, lisez Effectively use prompt caching on Amazon Bedrock et Amazon Bedrock annonce l'inférence inter-Régions mondiale pour un débit accru sur le blog AWS Machine Learning. Pour explorer le produit, consultez la documentation de Postman Agent Mode.
L’implémentation en production de Postman est propriétaire et n’est pas disponible sous forme de dépôt d’exemples public.