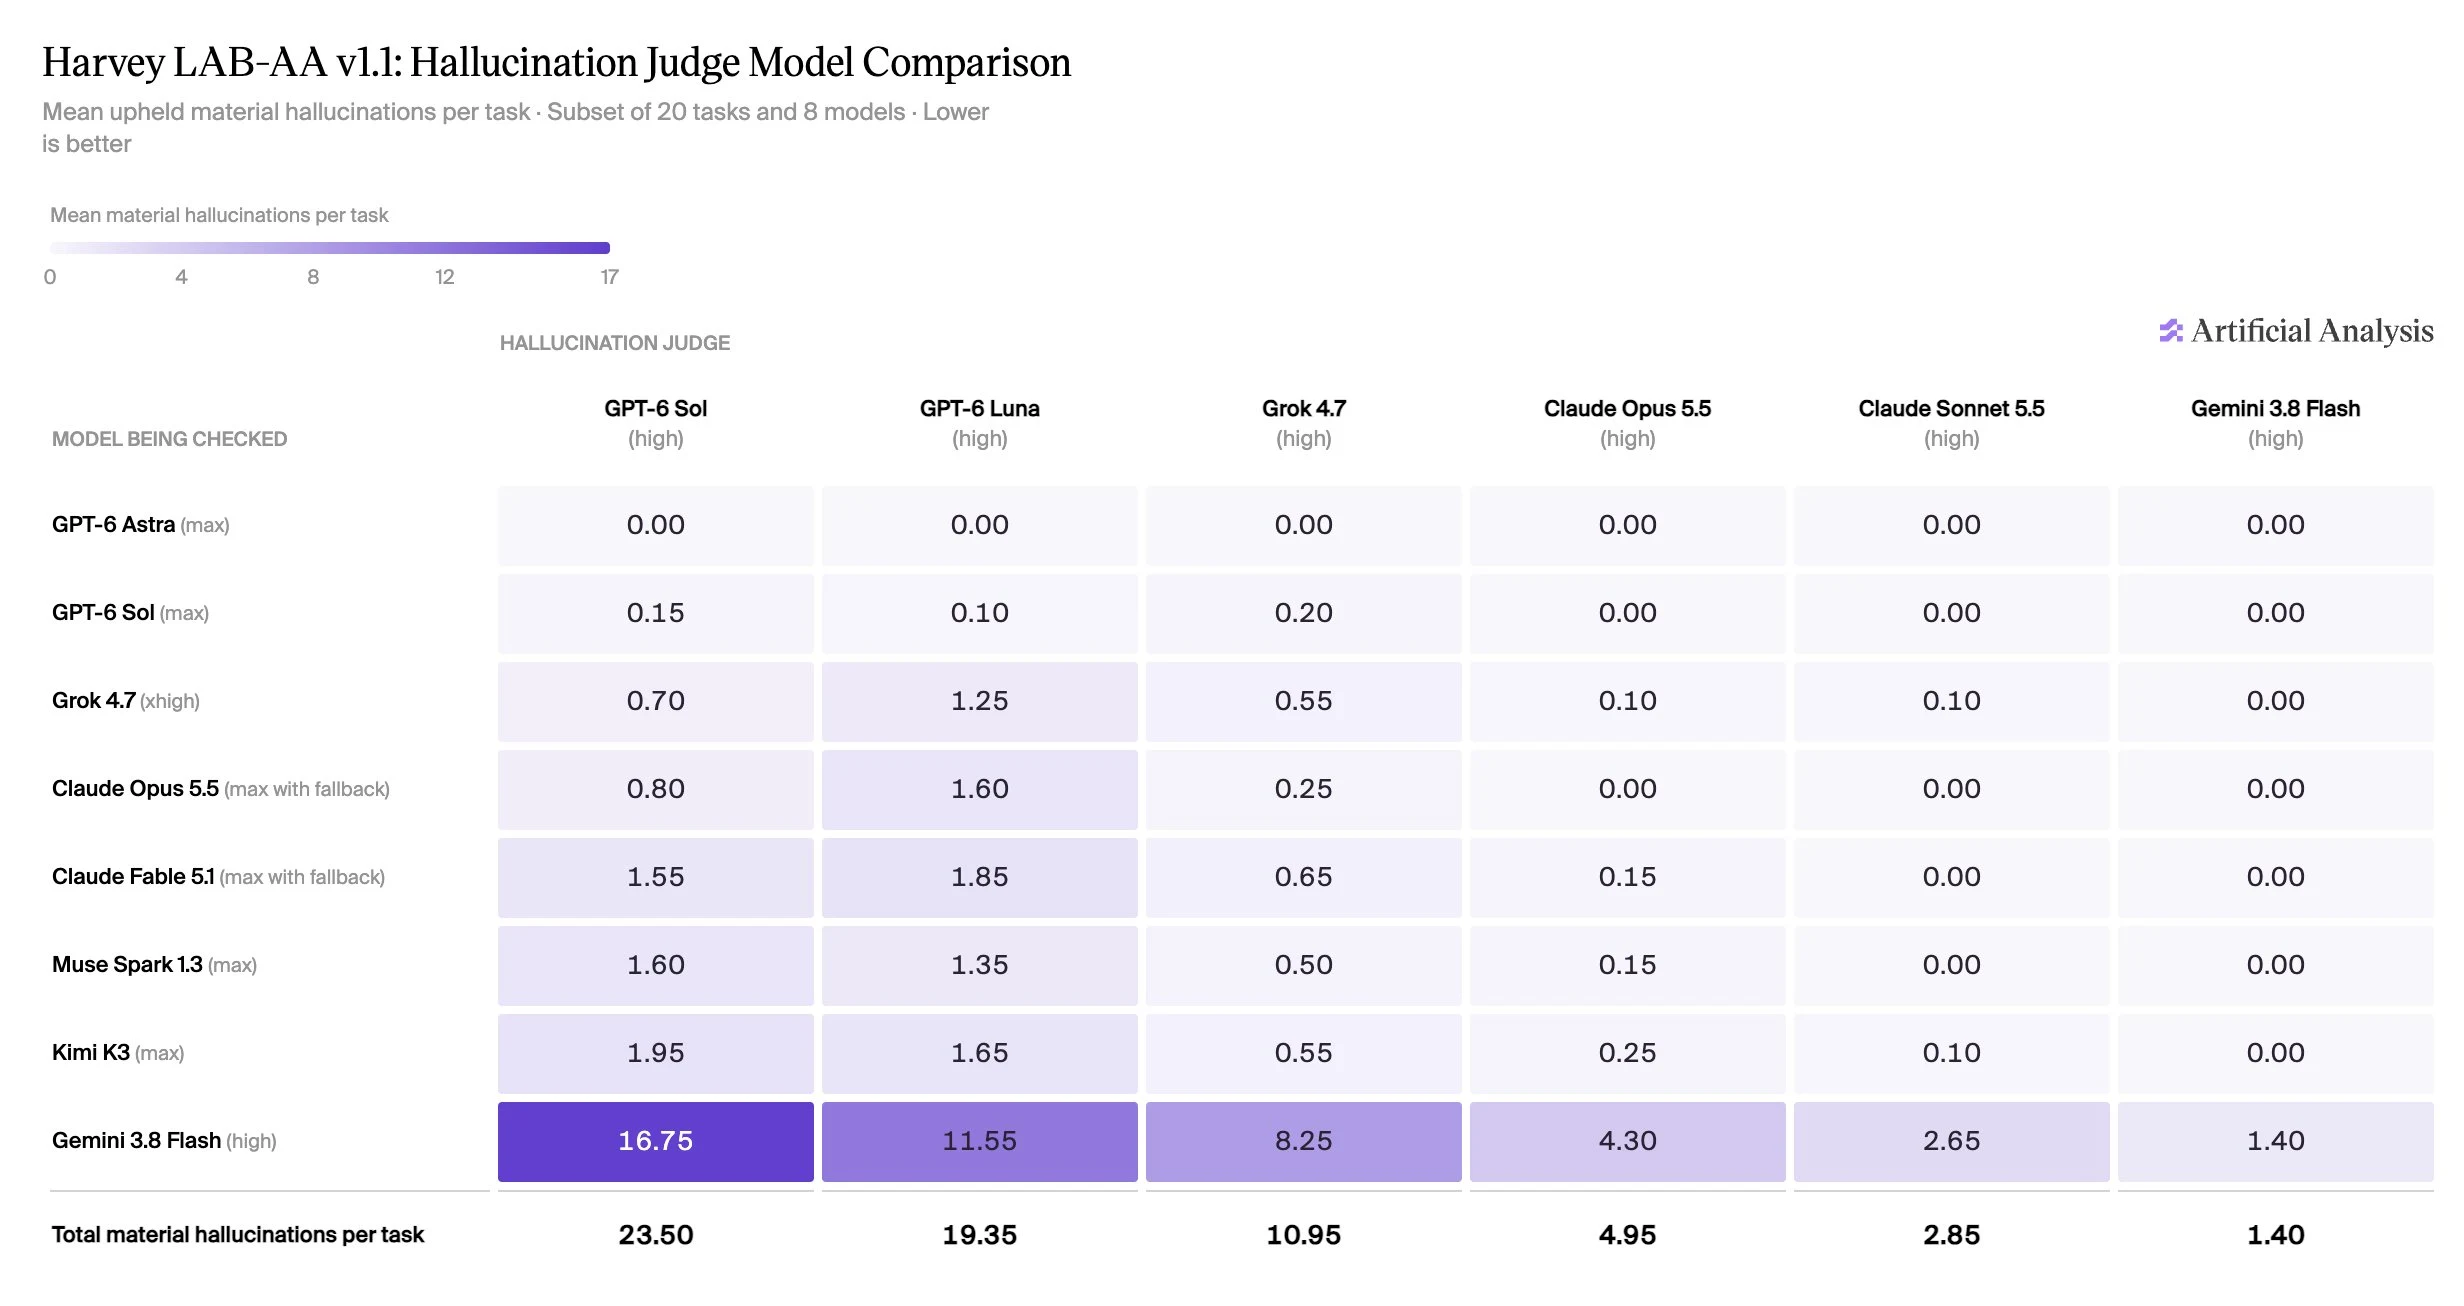
Nous avons comparé six détecteurs d'hallucinations sur les mêmes livrables provenant d'un sous-ensemble fixe de 20 tâches et de huit modèles. Nous avons exécuté notre vérification en deux étapes à l'aide de GPT-6 Sol (high), GPT-6 Luna (high), Grok 4.7 (high), Claude Opus 5.5 (high), Claude Sonnet 5.5 (high) et Gemini 3.8 Flash (high), et nous avons sélectionné GPT-6 Sol (high) pour l'utilisation en production.
Sur ce sous-ensemble de 20 tâches, GPT-6 Sol et GPT-6 Luna ont généralement identifié davantage d'hallucinations substantielles, tandis que Claude Sonnet 5.5 et Gemini 3.8 Flash en ont identifié bien moins. Claude Opus 5.5 s'est située entre Grok 4.7 et Claude Sonnet 5.5 dans chaque ligne de modèle. Au total, Opus a confirmé 99 hallucinations substantielles, contre 219 pour Grok, 57 pour Sonnet et 470 pour GPT-6 Sol. GPT-6 Sol a identifié davantage d'hallucinations substantielles malgré l'approche conservatrice de la vérification en matière de signalement des erreurs, qui exclut les connaissances juridiques générales ne figurant pas dans les documents sources.
Les six détecteurs n'ont trouvé aucune hallucination substantielle dans les sorties de GPT-6 Astra, tandis que GPT-6 Sol allait de 0 à 0,20 par tâche. Les deux figuraient parmi les modèles comptant le moins d'hallucinations substantielles selon chaque détecteur. Cette comparaison montre des différences de comportement entre les détecteurs ; les seuls décomptes n'établissent pas la précision ni n'excluent une auto-préférence.