
vLLM prend désormais en charge Vera Rubin NVL72 !
NVIDIA Vera Rubin est la plateforme de nouvelle génération conçue pour l'inférence agentique. Inferact, NVIDIA, Red Hat et la communauté vLLM travaillent à faire fonctionner vLLM sur Vera Rubin NVL72 depuis son annonce, et vLLM s'exécute aujourd'hui sur Vera Rubin NVL72 avec des builds de conteneurs quotidiens et le support des modèles de DeepSeek, Moonshot AI, Z.ai et MiniMax.
Cet article donne un aperçu préliminaire de l'état d'avancement, et voici quelques points forts du travail réalisé jusqu'à présent :
- Matériel Vera Rubin NVL72 : 5x les FLOPS NVFP4, environ 2.4x la bande passante HBM et 1.7x la bande passante NVLink bidirectionnelle du GB200 NVL72, avec des exponentielles 2 à 4x plus rapides pour le softmax.
- Support dès le jour 0 : Rubin s'appuie sur la famille d'architectures de Blackwell, donc les kernels Blackwell de vLLM sont compatibles avec Rubin. Grâce à cela, vLLM prend déjà en charge des modèles divers tels que DeepSeek, Kimi, GLM et MiniMax sur Rubin.
- Kernels optimisés pour Rubin : Via FlashInfer 0.7.0, vLLM bénéficie de kernels d'attention, GEMM et MoE optimisés pour Rubin. Nous avons également optimisé notre kernel de prefill MiniMax Sparse Attention (MSA) pour Rubin.
- MoE tenant compte de la localité : Pour tirer le meilleur parti de la bande passante HBM accrue de Rubin, nous utilisons les domaines de localité de CUDA 13.4 pour répartir les poids du MoE. Cela permet aux SM de lire les poids uniquement depuis la mémoire la plus proche d'eux.
- Performances préliminaires : Les premiers résultats montrent déjà des gains impressionnants avec vLLM : un débit par GPU 7,8x supérieur au GB200 NVL72 sur AgentX à interactivité équivalente, et jusqu'à un débit VLM 3,7x plus élevé que le GB300 NVL72 sur MLPerf. Ce n'est que le début ; nous nous attendons à encore plus de performances à mesure que les optimisations se poursuivent.
Ce que Rubin change pour l'inférence
Cliquer pour déplierFigure 1. Comparaison par GPU de NVIDIA Vera Rubin NVL72 et GB200 NVL72. Survolez une métrique pour mettre en évidence sa partie du GPU ; « Show table » liste chaque valeur. Sources : NVIDIA pages de spécifications de Vera Rubin NVL72 et de GB200 NVL72 , et blogs développeurs NVIDIA Rubin.
La plateforme Vera Rubin
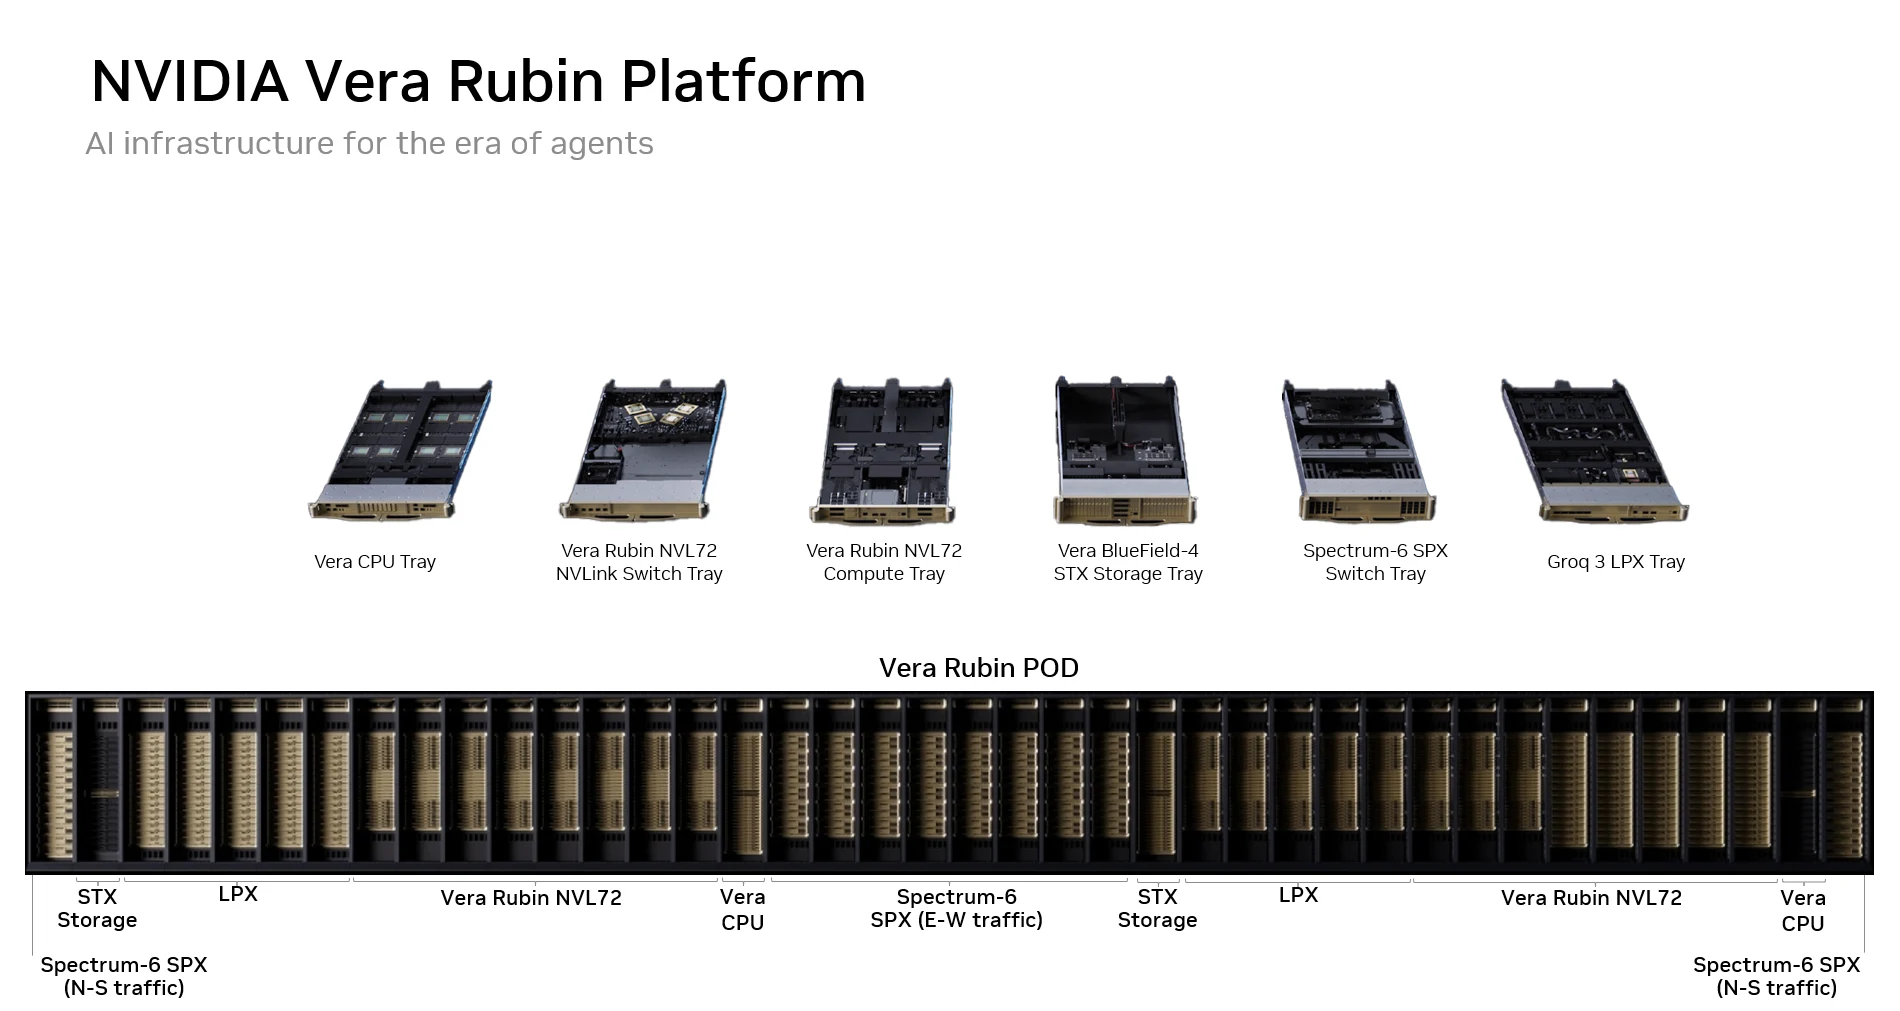
La plateforme Vera Rubin offre d'excellentes performances grâce à une co-conception extrême de ses composants de rack – elle comprend cinq nouveaux systèmes à l'échelle du rack, distincts et conçus à des fins spécifiques pour les charges de travail d'IA agentique : Vera Rubin NVL72, Vera CPU rack, Groq 3 LPX, Spectrum-6 SPX et BlueField-4 STX Storage.
Un seul Vera Rubin NVL72 délivre 5x plus de FLOPS d'inférence NVFP4 que le GB200 NVL72 et 2,4x plus de bande passante mémoire. Côté réseau scale-up, la sixième génération de NVLink offre jusqu'à 1,7x plus de bande passante que Blackwell, offrant une expérience utilisateur nettement meilleure dans les scénarios de service agentique en production.
Softmax. Fait notable, Rubin a également amélioré les performances du softmax, une opération centrale dans l'attention des LLM. Rubin augmente le débit exponentiel, notamment un débit FP32 multiplié par 2 et un débit BF16/FP16 multiplié par 4 par rapport au NVIDIA GB200, permettant au softmax de suivre le rythme des opérations matricielles plus rapides.
Mémoire. La HBM de Rubin a été mise à niveau de HBM3e vers HBM4, offrant jusqu'à 2.4x plus de bande passante par rapport au GB200 NVL72. Combiné à sa puissance de calcul supérieure, le GPU Rubin accélère les opérations clés d'inférence des LLM telles que GEMM, MoE (Mixture of Experts) et l'attention, et offre un débit global bien plus élevé ainsi qu'une latence de décodage plus faible (détails ci-dessous).
Réseautage. Le réseau inter-GPU est également grandement amélioré sur la plateforme Rubin. Le NVLink de sixième génération délivre 1.7x plus de bande passante réseau que la génération précédente. Cela accélérerait les collectives (par exemple AllReduce et All2all) et autres opérations de communication, améliorant la vitesse et l'extensibilité de l'inférence des LLM à grande échelle (par exemple la désagrégation prefill/decode, un large parallélisme d'experts).
État de la prise en charge de Rubin par vLLM
La communauté vLLM a travaillé sur l'activation de Rubin immédiatement après son annonce publique. En tant qu'éléments essentiels de la communauté vLLM, des ingénieurs de NVIDIA, Inferact et Red Hat ont collaboré et contribué afin de garantir que tous les utilisateurs puissent déployer aisément n'importe quel modèle sur la plateforme Rubin.
Dans cette section, nous mettons en évidence la prise en charge spécifique à Rubin en cours dans vLLM, à savoir l'exploitation des domaines de localité, ainsi que nos améliorations d'utilisabilité pour une utilisation prête à l'emploi sur le matériel Rubin.
Prise en charge des domaines de localité
Depuis Ampere, les GPU NVIDIA prennent en charge des accès mémoire globaux non uniformes. La fonctionnalité locality domain de NVIDIA CUDA 13.4 permet aux applications de tirer pleinement parti des accès mémoire globaux non uniformes en plaçant le calcul et les données dans le même domaine de localité. Les SM peuvent accéder à la mémoire globale située dans leur propre domaine de localité avec une bande passante supérieure et une latence inférieure à celle de la HBM dans les autres domaines. Avec les Green Contexts et les streams CUDA, nous pouvons lancer un kernel dans chaque domaine de localité, afin que chaque kernel puisse accéder à la mémoire locale. Cette fonctionnalité accélère principalement les workloads limités par la mémoire, comme le décode MoE. Les domaines de localité font toujours l'objet d'une conception et d'un développement actifs. Dans cette section, nous utilisons le décode MoE comme exemple pour une analyse approfondie.
Cliquez pour déplierFigure 3. Split-N dans le forward MoE sur deux domaines de localité. Les poids W sont divisés par colonnes à N/2, et les SM de chaque domaine ne lisent que la moitié de W présente dans leur propre HBM, de sorte que chaque domaine utilise sa bande passante mémoire locale. L'entrée X et la sortie C s'étendent sur les deux domaines. Utilisez Pause, Prev/Next ou les pastilles d'étapes pour parcourir les étapes.
Le décode MoE est limité par la lecture des poids depuis la HBM, notre objectif est donc d'optimiser le débit mémoire à travers les domaines de localité. Pour une première exploration de la nouvelle fonctionnalité de domaine de localité de Rubin, nous utilisons la stratégie split-N à la fois dans FC1 et FC2, comme illustré dans la Figure 3. Nous fragmentons les poids par colonnes, plaçons chaque fragment dans la mémoire globale du domaine de localité correspondant, et restreignons les SM de chaque domaine à leur fragment local. Cela élimine la plupart des accès mémoire inter-domaines, ce qui améliore les performances des kernels et réduit la consommation d'énergie. Comme la mémoire d'activation est relativement petite pendant le décode, le fait de la laisser non localisée sur deux domaines mémoire n'entraînerait qu'une surcharge minimale.
Les SM ne peuvent pas toujours être partitionnés en domaines égaux. Par défaut, la création de domaines de localité n'inclura pas ces SM lorsqu'elle essaie de créer des partitions égales. Pour que les deux partitions aient le même nombre de SM, nous devons activer cudaDevSmResourceGroupBackfill (backfill mode) lors de la création des domaines (nous renvoyons les utilisateurs à la documentation officielle des domaines de localité pour plus de détails). Au cours de notre étude de performances, nous incluons à la fois le mode par défaut (seuls 200 SM sont utilisés sur les deux domaines) et le backfill mode (les 212 SM sont utilisés).
La Figure 4 compare le temps de forward préliminaire de la couche MoE (FC1 + FC2) avec les domaines de localité activés ou désactivés, pour différentes stratégies de parallélisme. Nous utilisons les formes MoE de MiniMax M3 comme exemple. Avec les domaines de localité activés, nous obtenons systématiquement en moyenne des accélérations de 1.2x dans les configurations de forward à petits tokens. Et la tendance reste à peu près la même pour les autres stratégies de service TP et EP. Même en mode par défaut, où seulement 200 des 212 SM sont utilisés, l'activation des domaines de localité apporte un gain similaire. La raison principale est que, dans le décode à petits tokens, le forward est dominé par le chargement des poids, et les domaines de localité permettent un débit HBM plus élevé. Ces premiers résultats ne sont qu'un point de départ, avec des marges de réglage et d'optimisation supplémentaires pour maximiser les bénéfices de performance de la localisation sur Rubin.
Cliquez pour déplierFigure 4. Latence préliminaire de FC1 + FC2 par rank de la couche MoE de MiniMax M3 sur Rubin, non localisé vs localisé (plus bas est meilleur), avec l'accélération (latence non localisée ÷ localisée) au-dessus de chaque paire. Les onglets changent la stratégie de parallélisme (TP2, TP4, EP2, EP4) ; le commutateur bascule entre le backfill mode (212 SM sur 212) et le mode par défaut (200 SM sur 212). Routage équilibré ; le temps de communication n'est pas inclus.
Convivialité dès le jour 0
La convivialité est toujours la première priorité de vLLM. À compter d'aujourd'hui, les utilisateurs peuvent récupérer et utiliser les images nightly construites avec CUDA 13.4 et PyTorch 2.15 depuis le Docker Hub de vLLM, à savoir vllm/vllm-openai:cu134-nightly, pour le matériel Rubin.
Compatibilité de la pile logicielle Blackwell. Rubin s'appuie sur la famille d'architectures de Blackwell, avec des tcgen05 instructions tensor core étendues. C'est une nouvelle cible de compilation GPU (sm107), mais les kernels construits pour la cible de la famille Blackwell (sm100f) peuvent également s'y exécuter. En pratique, les kernels Blackwell de vLLM, en particulier ceux à forte densité de GEMM, comme l'attention et le MoE, peuvent déjà s'exécuter sur Rubin sans aucune modification.
Builds de conteneurs quotidiens. Les builds de conteneurs quotidiens pour Rubin sont déjà disponibles (#55953), rendus possibles par #53443 et #54640 pour le chemin de build Rubin sur CUDA 13.4, et #56545 et #59288 pour les mises à jour des dépendances Rubin.
Couverture des modèles. Avec ces éléments en place, vLLM peut désormais servir divers modèles, notamment DeepSeek, Kimi, GLM et MiniMax, sur Rubin.
Kernels optimisés pour Rubin
Progressivement, les kernels exploitant les capacités et fonctionnalités matérielles spécifiques à Rubin sont publiés et intégrés en amont dans des bibliothèques de kernels telles que FlashInfer, le fork MSA de vLLM (vllm-project/MSA), Humming (vllm-project/humming), etc. À ce jour, vLLM a intégré quelques kernels importants pour maximiser les performances sur Rubin, notamment la GEMM dense NVFP4 ou MXFP4, le MoE NVFP4, l'attention FP8, le préremplissage MSA FP8, et bien d'autres.
Performances
Nous évaluons les performances de vLLM s'exécutant sur des GPU Vera Rubin NVL72 avec deux benchmarks représentatifs : SemiAnalysis AgentX (détaillé dans notre article précédent) et MLPerf Inference v6.1.
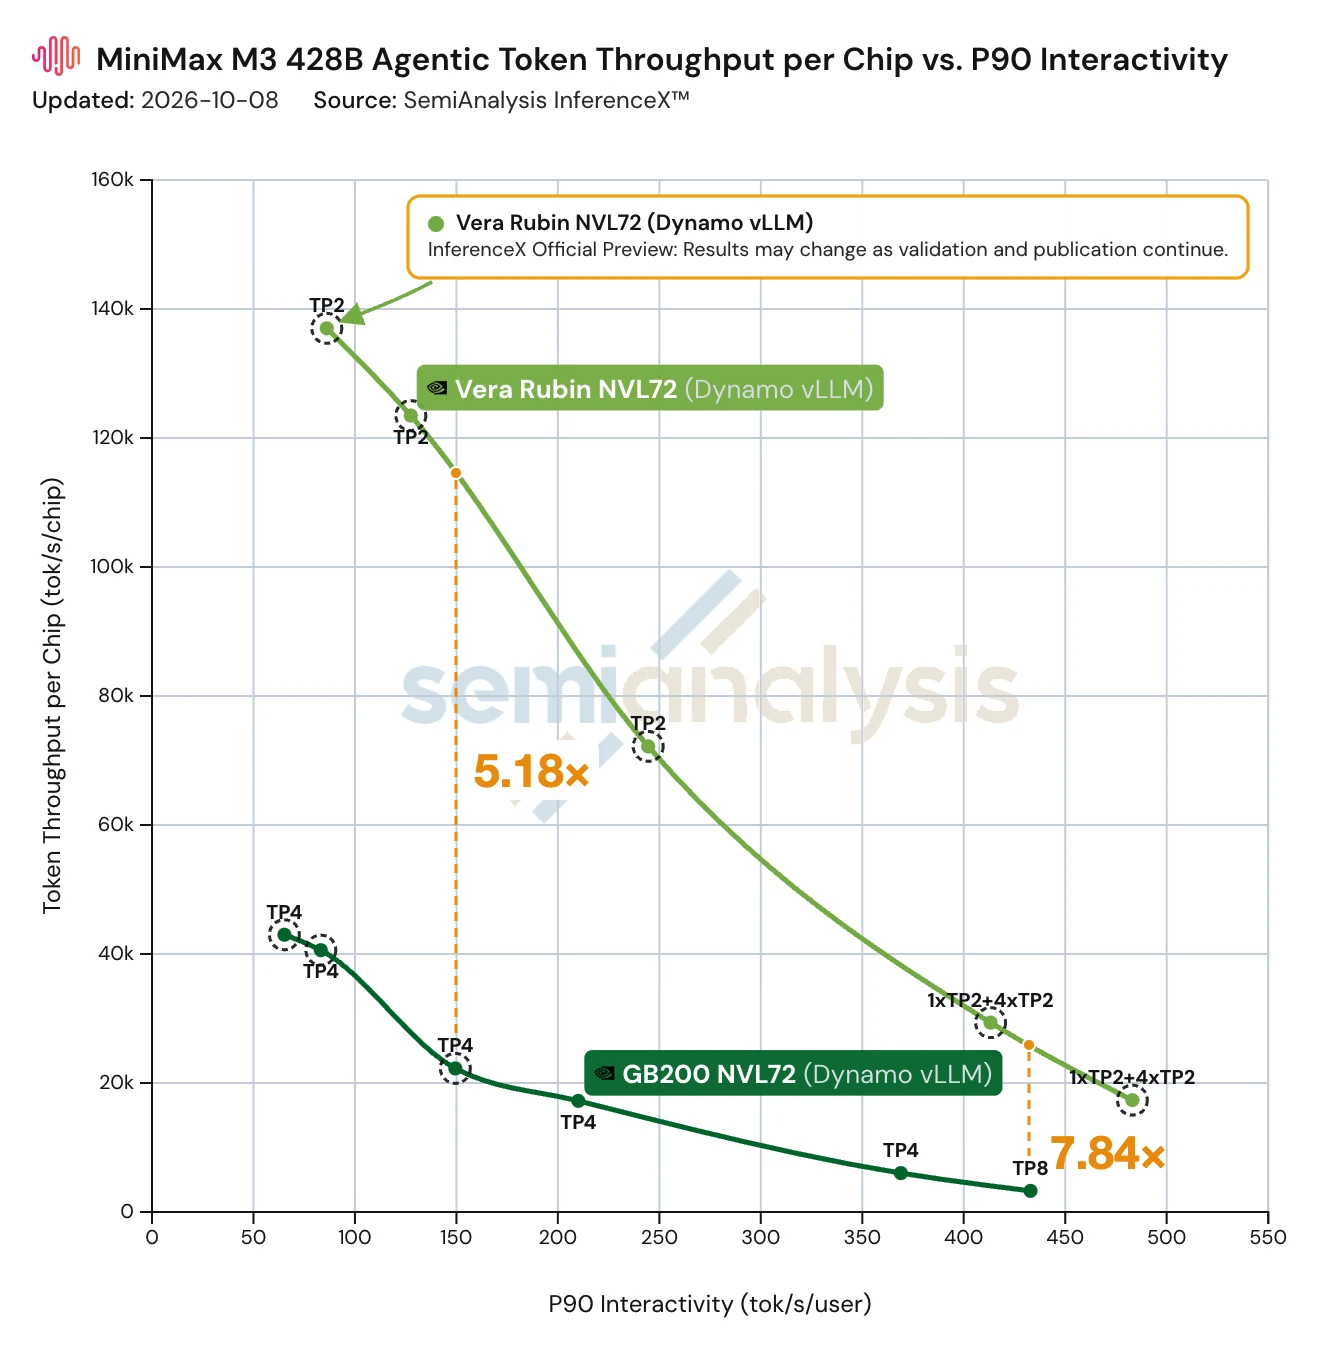
Sur AgentX, vLLM exécutant MiniMax M3 sur Vera Rubin NVL72 délivre jusqu'à 7.84x le débit par NVIDIA GB200 à interactivité égale, et un débit supérieur de 5.18x sous une contrainte de 150 TPS. Il s'agit d'un tout premier aperçu des capacités d'inférence de la plateforme. À mesure que nous aurons accès à davantage de nœuds Vera Rubin NVL72, nous élargirons les tests et accélérerons l'optimisation, avec des gains de performance supplémentaires attendus à mesure que ce travail progresse.
La campagne MLPerf Inference v6.1 a été le tout premier terrain d'essai pour le déploiement de vLLM sur la plateforme NVIDIA Vera Rubin NVL72. Sur le benchmark de modèle Vision-Language (VLM), avec le déploiement du modèle Qwen3-VL-235B-A22B via vLLM comme moteur d'inférence backend et Dynamo comme routeur frontend, Vera Rubin NVL72 délivre jusqu'à 3.7x un débit supérieur à celui du GB300 NVL72 sur les scénarios hors ligne, serveur et interactif. Plus de détails sur les résultats publiés de MLPerf Inference v6.1 sont disponibles dans l'article de blog de NVIDIA.
Prochaines étapes
"Rome ne s'est pas construite en un jour", et peaufiner l'utilisabilité et les performances sur les GPU Vera Rubin NVL72 sera un périple continu, riche en excitations. Dans un avenir immédiat, en travaillant ensemble en tant que communauté, nous prévoyons d'activer de nombreuses nouvelles fonctionnalités pour les GPU Rubin, notamment, sans s'y limiter :
- Intégrer le MegaMoE sm107 de FlashInfer dans vLLM via FlashInfer.
- Activer pleinement les domaines de localité pour les couches MoE.
- Découvrir et exploiter davantage d'opportunités de chevauchement entre différentes couches ou kernels grâce à PDL et Lamport Sync.
- Explorer les méga-kernels pour les cas d'usage sensibles à la latence.
- Optimiser les kernels KDA et MLA sur Rubin pour Kimi K3.
- Intégrer les kernels Rubin CSA et HCA pour DeepSeek-V4.1-Flash.
- Terminer et intégrer les kernels de décodage MSA Rubin.
- Intégrer le kernel MoE all-to-all à écriture comptée CFT dans vLLM via FlashInfer.
Remerciements
Ce travail est un effort collaboratif entre Inferact, NVIDIA, Red Hat et la communauté vLLM au sens large. Nous tenons à remercier tout particulièrement :
- NVIDIA, pour l'accès anticipé aux Vera Rubin NVL72 et la collaboration étroite tout au long du développement.
- Inferact et NVIDIA, pour la direction de la collaboration Rubin, la conduite de l'optimisation des performances, l'intégration des kernels MSA et l'analyse des performances du MoE sensible à la localité.
- NVIDIA et Red Hat, pour la mise en place et l'activation des builds Docker quotidiens pour Rubin.
- La communauté vLLM, pour son soutien continu et ses contributions tout au long du processus.
Annexe : exécution de vLLM sur Vera Rubin NVL72
Afficher les configurations de kernels pour RubinvLLM a déjà intégré quelques kernels hautement optimisés pour Rubin. Cette section présente les configurations correspondantes pour les activer afin de maximiser les performances sur les GPU Rubin.
- GEMM dense NVFP4 ou MXFP4 en CuTe-DSL. Activé par défaut pour un checkpoint de modèle NVFP4/MXFP4, mais vous pouvez définir
--linear-backend flashinfer_cutedslpour NVFP4 ou--linear-backend flashinfer_cutlasspour MXFP4 afin de vous assurer qu'il est activé. - MoE NVFP4 en CuTe-DSL. Vous pouvez l'activer via
--moe-backend flashinfer_cutedsl. - GEMM groupé masqué en CuTe-DSL pour le MoE NVFP4 W4A4 au format d'experts « batched ». Ceci s'applique à un déploiement avec
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latency|nixl_epoùN>1. Dans ce cas,--moe-backend auto|flashinfer_cutedslles deux aboutiraient à ce kernel. - BMM FP8 en CuTe-DSL pour les couches linéaires FP8 W8A8 statiques par tenseur. Activé par défaut et il peut être sélectionné par l'autotuner FlashInfer.
- Attention FP8 Trtllm-gen. Pour l'activer, vous avez besoin d'un cache KV FP8 via
--kv-cache-dtype fp8ou d'un checkpoint qui spécifie un cache KV FP8, et également de définir--attention-backend FLASHINFER|FLASHINFER_MLA. Pour le prefill MLA de type DeepSeek, veuillez également ajouter-ac.mla_prefill_backend=TRTLLM_RAGGED -ac.use_prefill_query_quantization=true. - Prefill MSA FP8 en CuTe-DSL. Pour l'activer, vous avez besoin d'un cache KV FP8 via
--kv-cache-dtype fp8ou d'un checkpoint qui spécifie un cache KV FP8, et également de définir--attention-config.minimax_m3_msa_decode_backend=cutlass.