
Par Yishui, depuis Aifeisi
QbitAI | Compte public QbitAI
Jouer à un jeu vidéo tout en s'améliorant soi-même ?
Eh bien, Huawei vient carrément d'apprendre à l'IA à « devenir plus forte en jouant » !
Dans une toute nouvelle étude, le laboratoire Noah's Ark de Huawei, en collaboration avec l'UCL et d'autres équipes, a présenté un système d'agents IA nomméMemento 3—
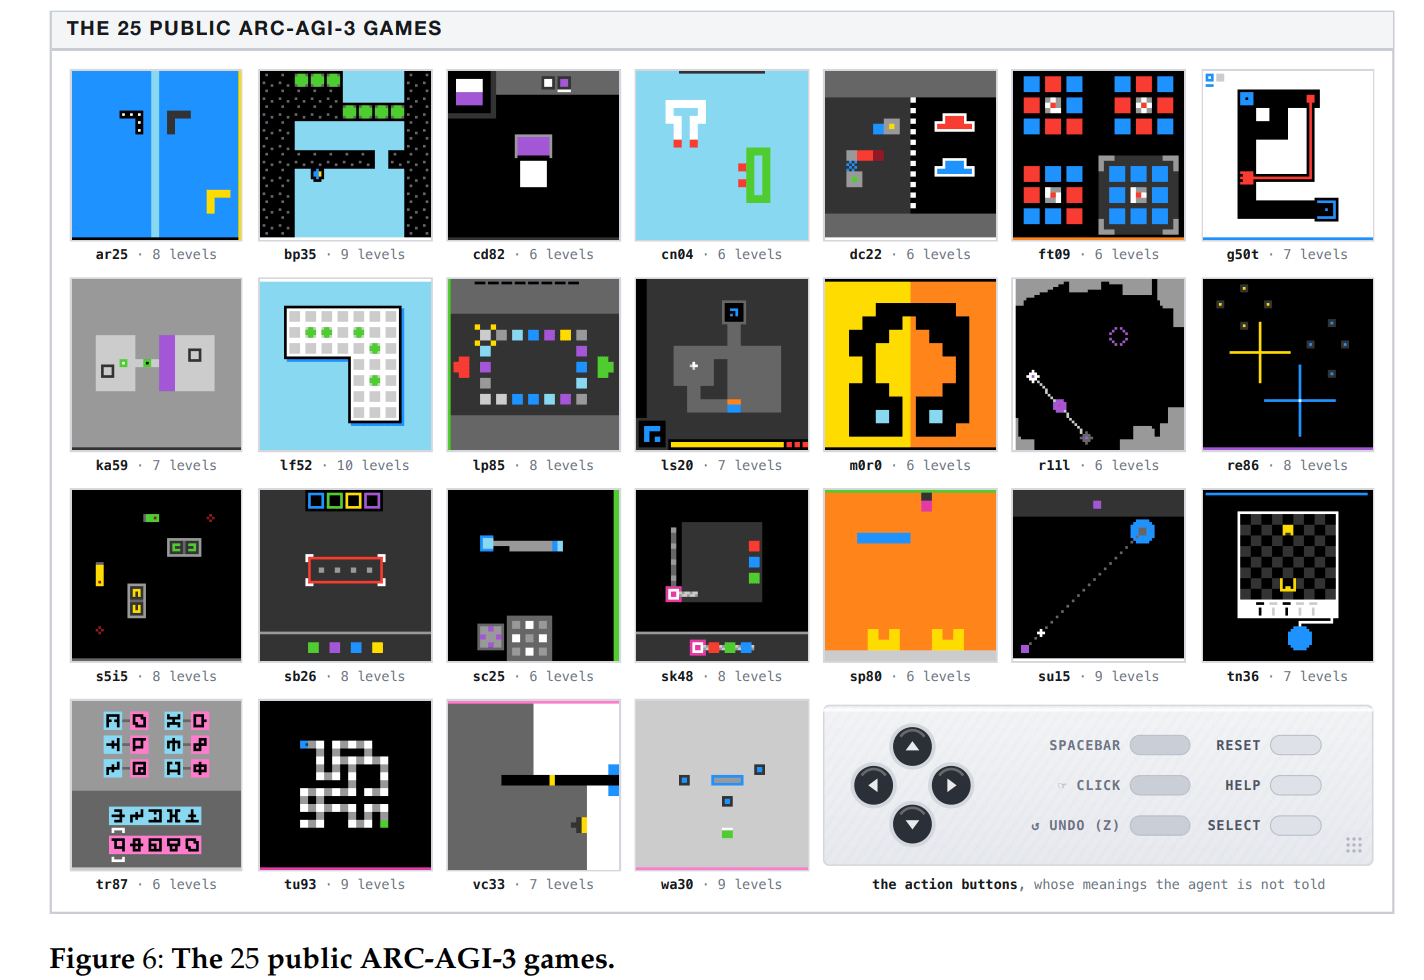
qui a terminé la totalité des 25 jeux et 183 niveaux de l'ensemble public ARC-AGI-3.
Et ce n'est pas en fonçant bêtement par essais et erreurs.
Un humain a besoin de 17135 actions pour accomplir le même ensemble de niveaux.
Or Memento 3 n'en a utilisé que 7518,soit environ 56 % d'actions en moins que l'humain, décrochant finalement un score RHAE parfait de 100(Relative Human Action Efficiency, efficacité d'action relative à l'humain).
Plus scandaleux encore,ce système repose sur Claude Opus 5 comme modèle de base, sans aucune mise à jour des poids du modèle ni aucun fine-tuning spécifique aux jeux。
il s'est simplement mis à jouer tout seul, a déduit les règles lui-même, a écrit son propre code, et se corrigeait et se modifiait en cas d'erreur.
Et puis… il a fini les jeux avec le score parfait.
À titre de comparaison, Claude Opus 5 seul, dans le cadre de test standard officiel de l'ARC Prize, n'obtient qu'environ 40,7 de RHAE en moyenne.
Avec le même modèle de base, le simple changement de système d'agent a fait bondir le score de 59,3 points.
Ce n'est pas tout.
Cette méthode ne se limite pas aux jeux de réflexion : l'équipe de recherche l'a aussi fait jouer au classique d'Atari, Pong (ping-pong).
Résultat : l'IA a mis au point elle-même une stratégie de contrôle, puis, sans avoir besoin de demander d'inférence au grand modèle, a écrasé son adversaire 21:0 trois parties de suite.
Attendez, le grand modèle ne participe même plus aux actions suivantes, et le jeu se joue quand même aussi bien ?!
La clé se cache dans le titre de cette étude :
Model-Based Recursive Self-Improvement, auto-amélioration récursive fondée sur un modèle du monde。
L'IA de Huawei termine 25 jeux, avec 56 % d'actions en moins que les humains
Commençons par voir ce que valent vraiment ces 25 jeux.
Ils proviennent d'ARC-AGI-3, lancé par l'ARC Prize ; ceux qui suivent l'évaluation des IA connaissent déjà bien la série ARC.
Mais cette génération présente un changement très marquant :
Ce n'est plus seulement le schéma classique de poser des questions et d'y répondre : cette fois, l'IA est directement jetée dans des mondes de jeu inconnus.。
Les règles, c'est à l'IA de les deviner ; les objectifs, c'est à elle de les trouver ; les effets de ses actions, c'est à elle de les tester elle-même.
L'IA : donc en fait tout repose sur moi, hein~
Ces 25 jeux publics contiennent au total 183 niveaux, dont les graphismes sont pour la plupart composés de simples pixels, blocs, couleurs et formes.
À première vue, on dirait presque une collection de petits jeux vieux de plusieurs décennies.
Mais ne vous laissez pas tromper par ce style graphique austère.
Pour l'IA, savoir comment agir n'est pas ce qui est le plus difficile ; le plus pénible, c'est de ne pas savoir du tout comment ce monde fonctionne.
Que se passe-t-il quand on marche sur un sol spécial ? Une porte ne s'ouvre pas : est-ce que la couleur ne correspond pas, ou est-ce que la forme ne correspond pas ?
Plus embêtant encore : les niveaux suivants peuvent introduire de nouvelles règles qui remettent totalement en cause l'expérience acquise auparavant.
Non seulement l'IA, mais les joueurs humains aussi restent bloqués。
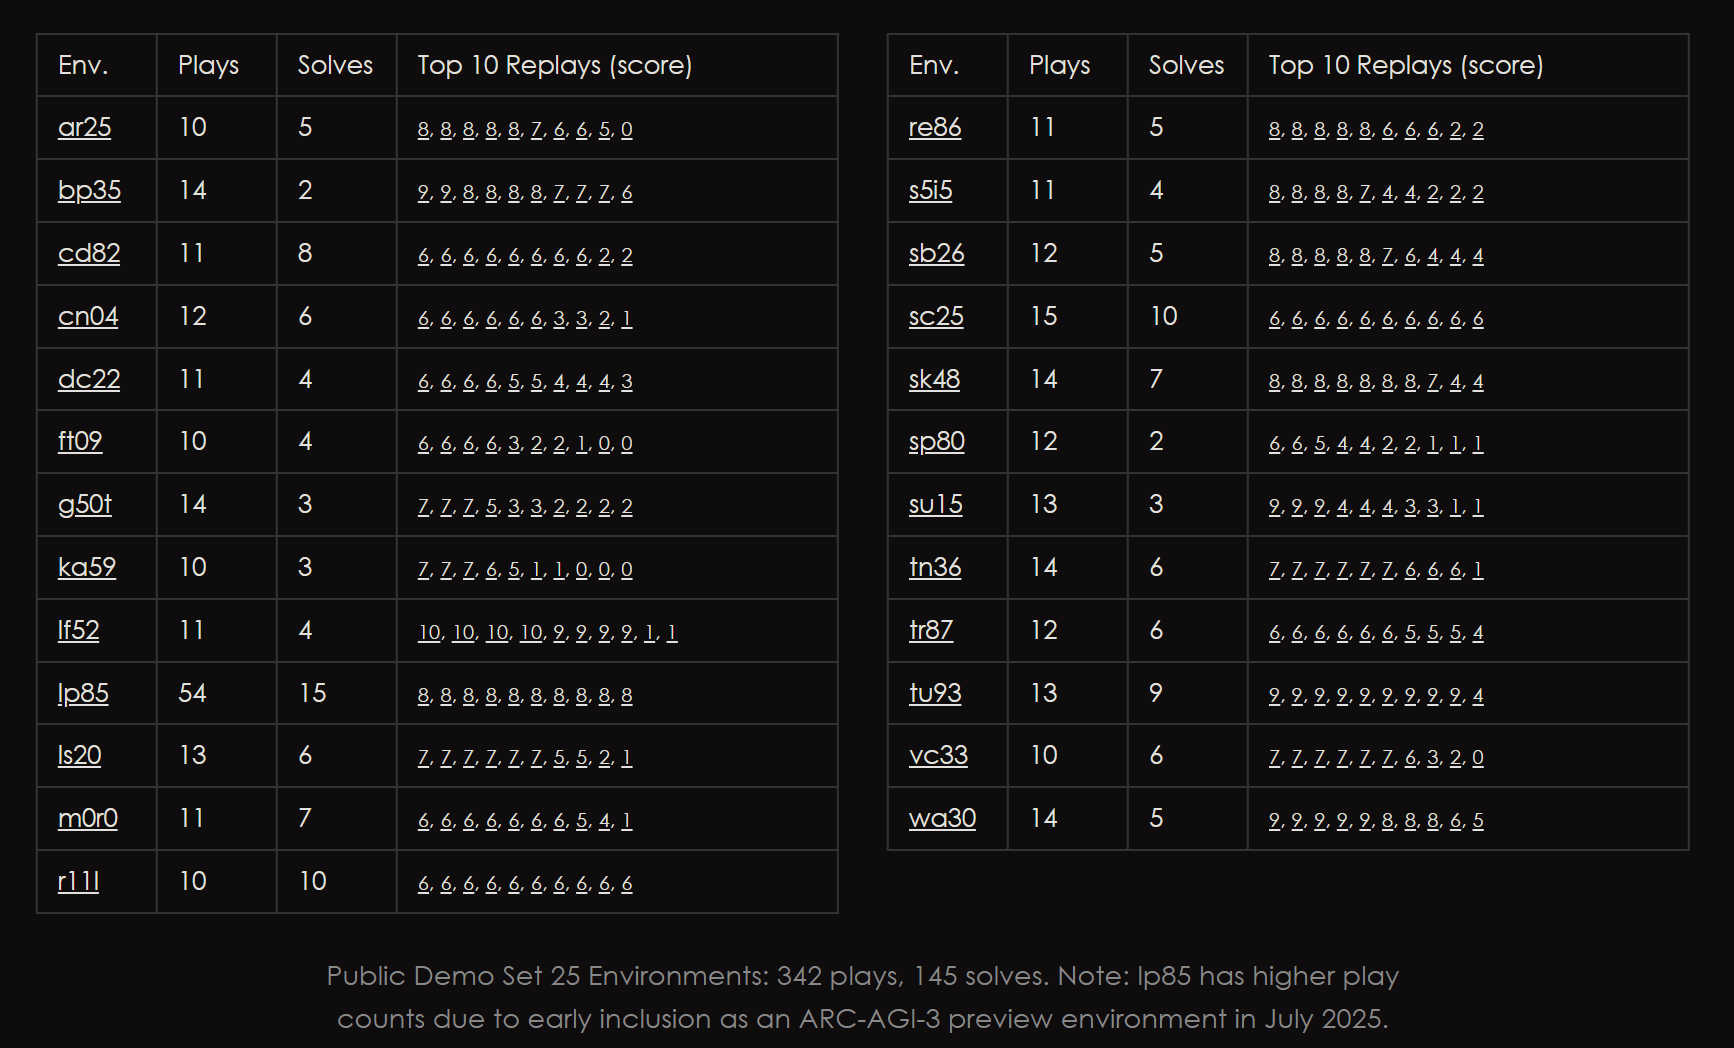
Les données de test de l'ARC Prize montrent que, dans un jeu de réflexion nommé r11l où il faut déplacer une amibe et changer sa couleur, les 10 participants ont tous terminé le jeu ; alors que dans un autre jeu d'énigmes, tr87, qui teste le déchiffrage de symboles, sur 12 participants, seuls 6 ont réussi.
Avant l'IA de Huawei, les équipes de recherche s'affrontaient déjà avec une intensité considérable :
Le Continual Harness de l'Université de Princeton n'a terminé que 3 jeux, avec un score de 20.5 points.
DreamTeam, développé avec la participation de chercheurs de Nvidia, fait un peu mieux : 6 jeux terminés, avec un score de 38.1.
Encore plus haut, OPINE-World, développé par le chercheur indépendant David Courtis, et NOOA, de l'équipe de Nvidia, ont obtenu respectivement 78.4 points et 85.1 points.
Le plus impressionnant est baseline1 du développeur indépendant Sergey Rodionov : non seulement il a terminé les 25 jeux, mais il a en plus obtenu 99 points, à 1 point seulement du score parfait.
Mais cette fois, l'équipe de Huawei a directement comblé aussi ce dernier 1 point manquant。
Memento 3 n'a pas seulement terminé les 25 jeux et 183 niveaux avec un score de 100 : il a en plus réduit le nombre total d'opérations à 7518, soit 829 de moins que les 8347 de baseline1.
Non seulement il a fini les jeux, mais il les a terminés avec moins d'étapes.
Comment a-t-il fait ??
Sans entraîner de grand modèle, l'IA « monte en niveau » en rédigeant elle-même son propre guide
En consultant l'article, on découvre que la méthode centrale de Memento 3 s'appelleCode as Model (le code comme modèle)。
Cela paraît un peu abstrait, mais en réalité, cela consiste à faire préparer à l'IA, pendant qu'elle joue, deux choses :
un guide de jeu constamment mis à jour, ainsi qu'un ensemble de code capable de simuler le fonctionnement du jeu.
- Rulebook (manuel des règles) : un document Markdown qui consigne les régularités découvertes par l'IA dans le jeu, par exemple quelles actions déclenchent quels effets, comment terminer un niveau, et quelles règles restent incomprises.
- Executable World Model (modèle du monde exécutable) : l'IA écrit directement les règles qu'elle a synthétisées sous forme de code Python exécutable, ce qui revient à fabriquer elle-même une version simplifiée d'un simulateur du jeu.
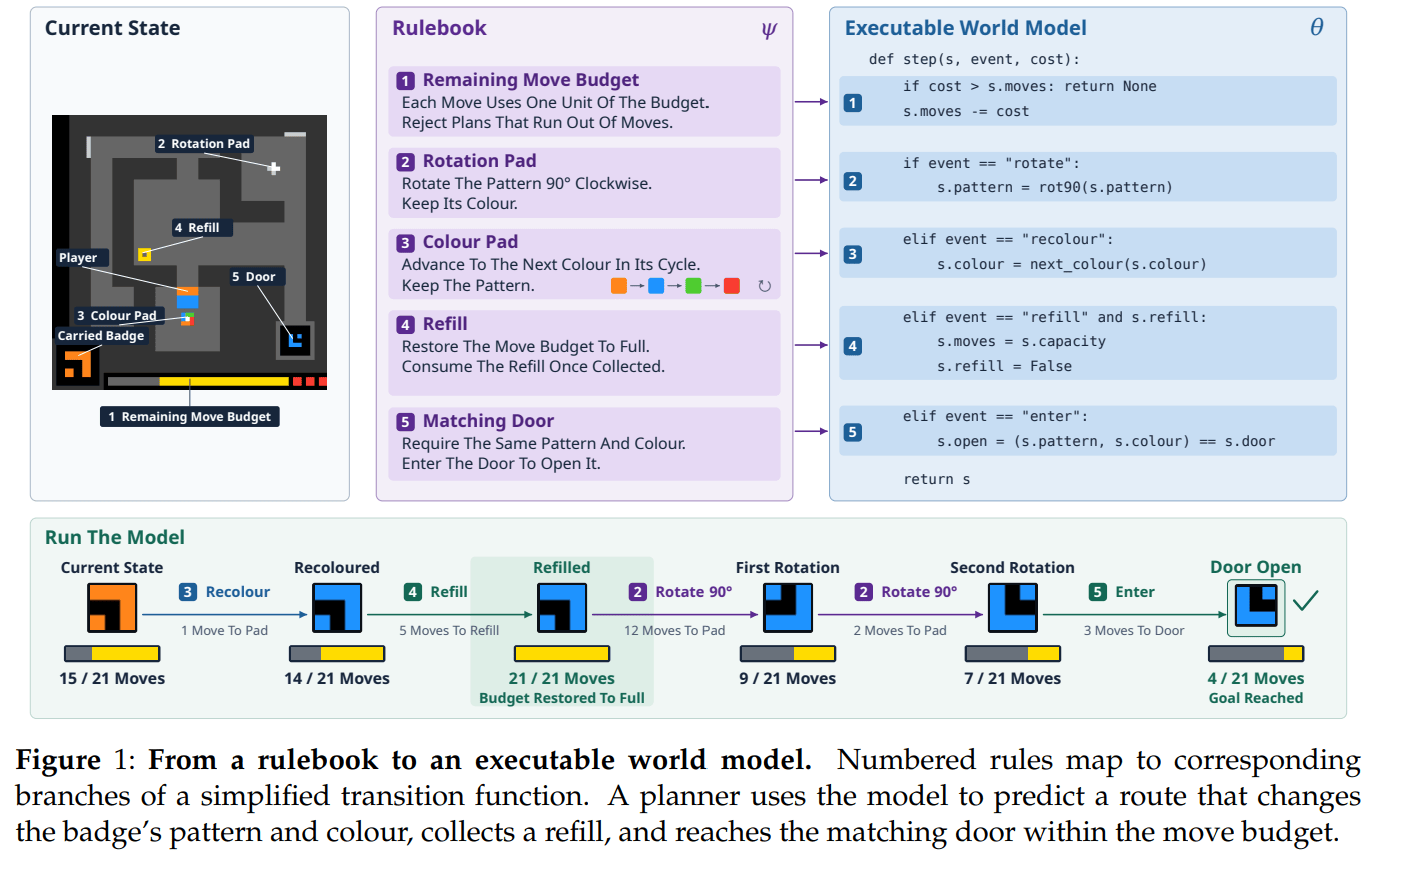
Grâce à ces deux éléments, l'IA peut d'abord dérouler différents scénarios dans le simulateur qu'elle a construit, puis décider du prochain mouvement.
Mais un problème se pose : et si les règles du jeu comprises au départ étaient tout simplement fausses ?
Pas de panique :Memento 3 ne se contente pas de rédiger son propre guide ; s'il découvre qu'il s'est trompé, il peut aussi le remettre en question et recommencer。
L'article en présente d'ailleurs un exemple.
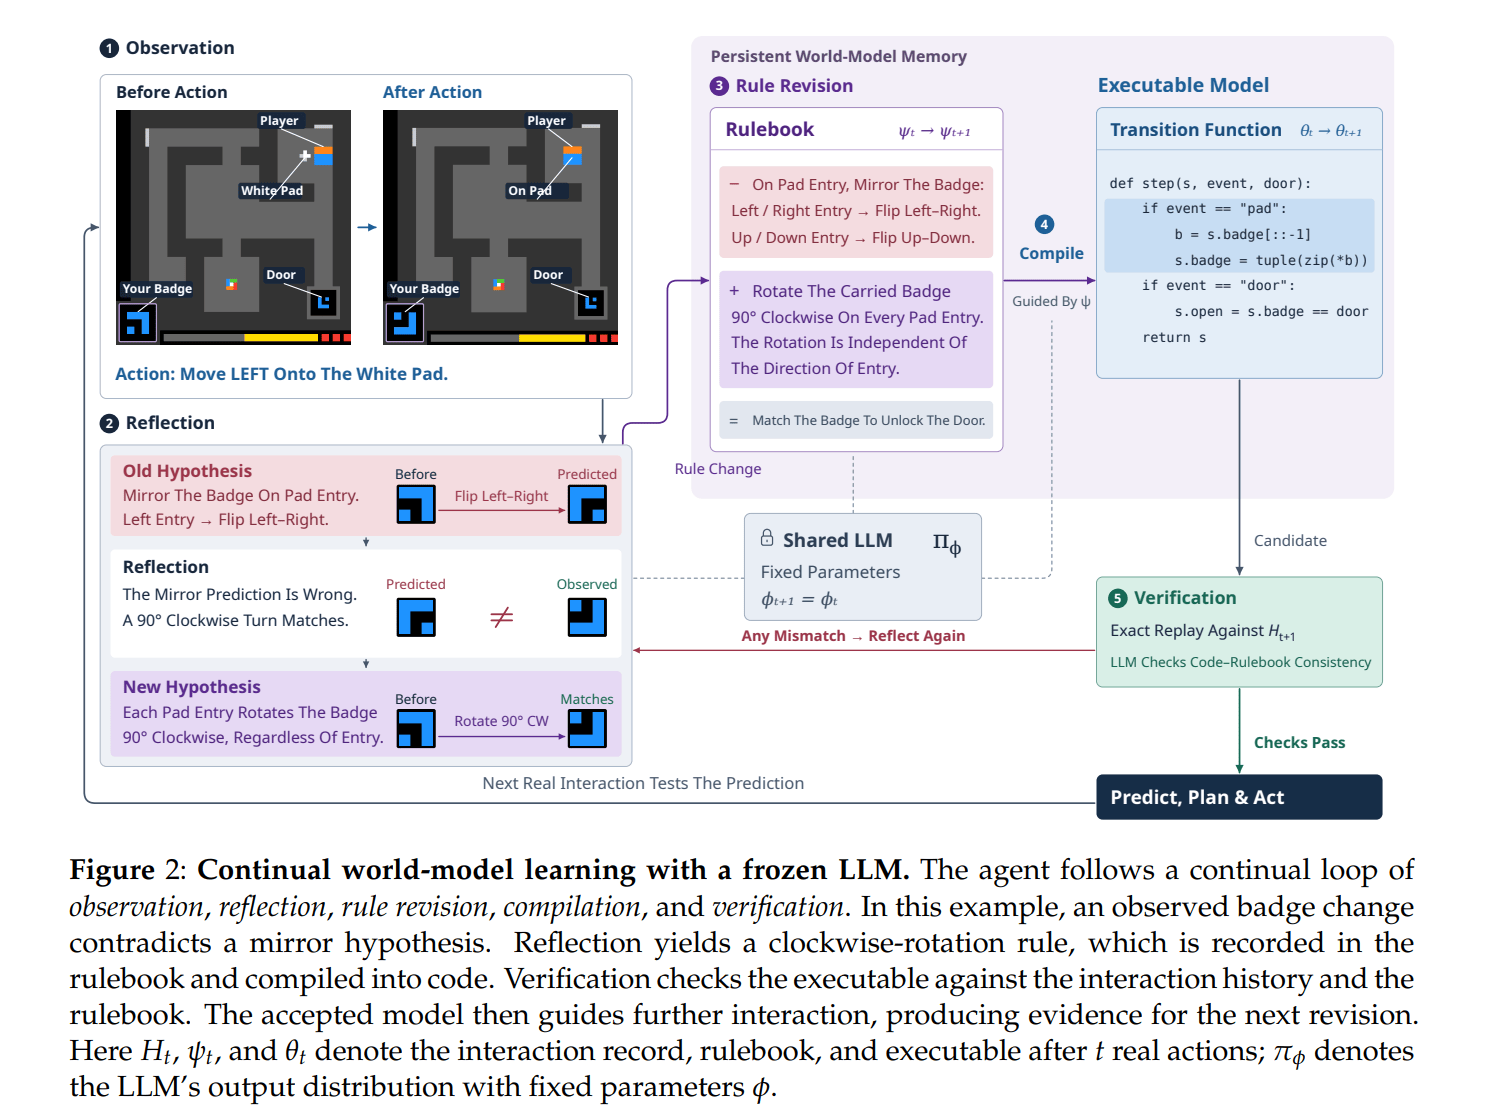
Dans un jeu d'énigmes, l'IA rencontre un sol spécial ; au début, elle pense qu'en marchant dessus, le motif porté par le personnage subit une inversion en miroir selon la direction d'entrée.
Mais en le testant réellement, elle découvre que le motif ne se retourne pas, mais tourne de 90 degrés dans le sens horaire, et cela indépendamment de la direction d'entrée.
L'IA modifie donc le manuel des règles, et le code Python correspondant est mis à jour en conséquence.
Cependant, après modification, il faut encore vérifier.
Le système simule à nouveau les opérations précédentes et compare pixel par pixel les images du jeu de 64×64, afin de confirmer que le code reproduit fidèlement les résultats réels.
Si rien ne correspond, on continue à corriger.
Ainsi, l'IA explore tout en corrigeant ses erreurs, et les règles deviennent de plus en plus précises au fil des modifications.
De plus, l'expérience acquise précédemment peut être réutilisée dans les niveaux suivants.。
Par exemple, dans le jeu de décryptage de symboles tr87, l'IA ne distinguait au début pas si l'orientation des symboles affectait leur signification, avant de découvrir que des symboles orientés différemment pouvaient représenter la même lettre.
Au fur et à mesure de l'apparition de nouveaux niveaux, elle a de nouveau remis en cause sa compréhension précédente de la position du curseur.
Sur l'ensemble de la partie, le même manuel de règles a été révisé en 11 versions.
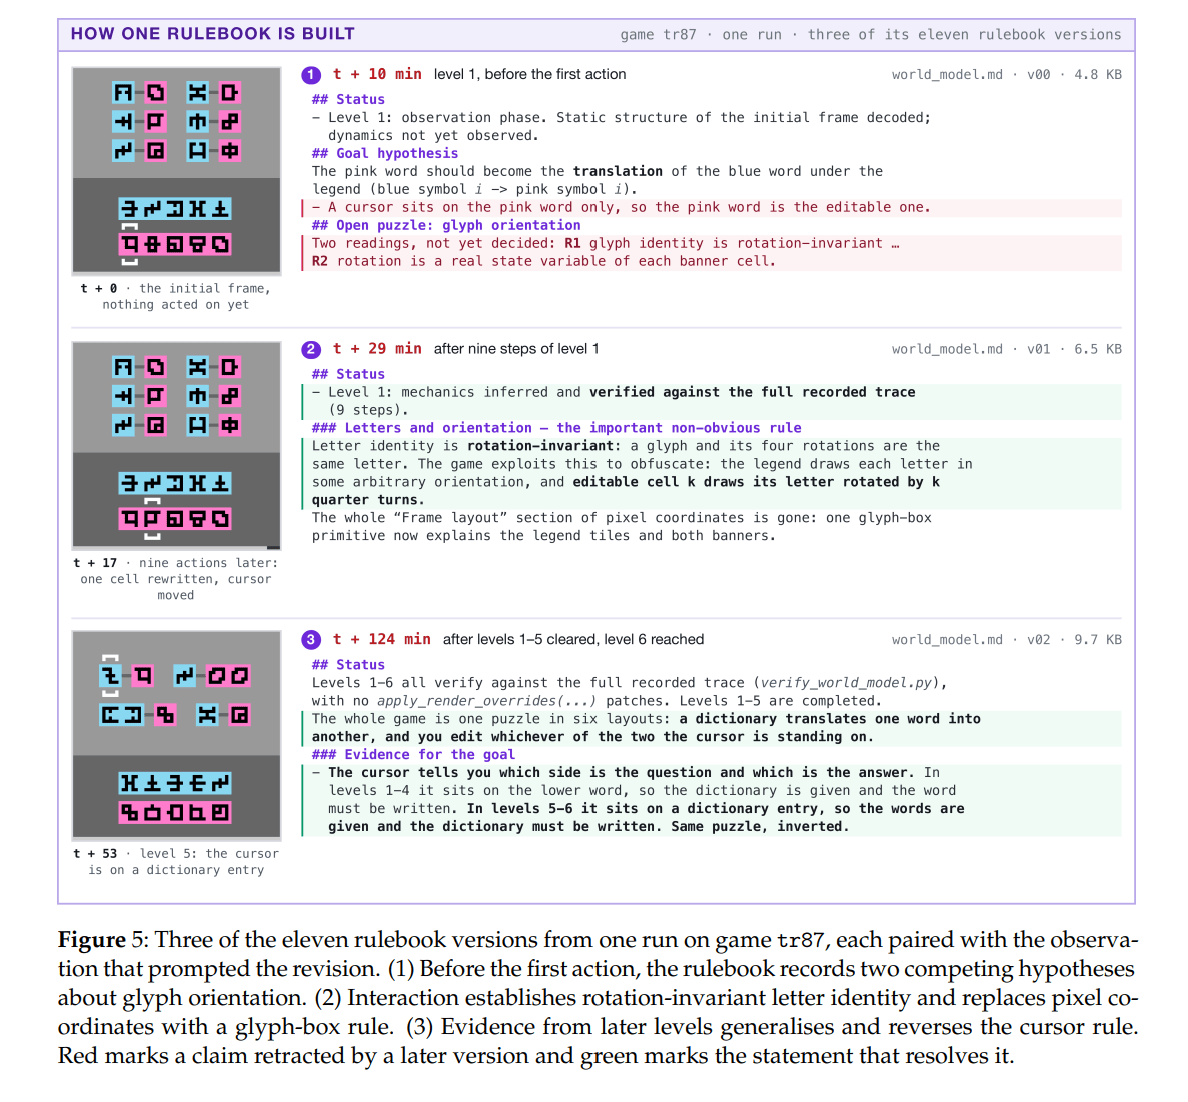
Pour faciliter le retour en arrière, l'équipe de recherche a même introduit la gestion de versions avec Git.
Chaque modification des règles et du code laisse une trace ; lorsqu'une erreur est repérée, il est possible de consulter les versions historiques et, si nécessaire, de les restaurer directement.
Impressionnant : en jouant à un jeu, on se retrouve à maintenir un dépôt de code au passage.
C'est précisément ce que l'équipe de recherche appelle l'auto-amélioration récursive (RSI).
Sans toucher aux paramètres du grand modèle, l'IA peut, en accumulant de l'expérience et en modifiant les règles et le code, devenir de plus en plus habile au jeu.
De plus, cette méthode est réellement étayée par des données.
L'équipe de recherche a mené des expériences comparatives sur trois jeux :
avec le manuel de règles conservé, l'IA a utilisé au total 617 opérations ; sans le manuel, en ne gardant que le modèle du monde en code, il lui en a fallu 677.
Autrement dit, grâce à ce guide, le nombre d'opérations a diminué d'environ 9 %, et les tours d'exécution de l'agent d'environ 18 %.。
Mais l'équipe de recherche ne s'est pas arrêtée là.
Puisqu'un modèle du monde permet à l'IA d'éviter les détours, qu'en est-il en utilisant deux modèles à la fois ?
Ils ont donc fait gérer à l'IA deux modèles du monde simultanément, partageant l'historique des opérations de jeu, mais formulant chacun des hypothèses de règles différentes.
Résultat : dans le jeu wa30, le modèle du monde unique nécessitait 899 opérations pour terminer le niveau ; avec le double modèle du monde, ce chiffre est directement tombé à 597.
Soit une nouvelle réduction d'environ 34 % du nombre d'opérations.。
Bien sûr, cette amélioration n'a été validée pour l'instant que sur wa30 et ne peut pas être directement généralisée aux autres jeux.
Mais au moins dans ces expériences, Memento 3 a prouvé une chose :
sans réentraîner le grand modèle, l'IA peut devenir de plus en plus forte en corrigeant continuellement sa compréhension du monde.
Au score de 21:0, l'IA n'a même plus besoin de faire appel au grand modèle.
Alors, cette méthode ne sert-elle qu'à jouer aux jeux de réflexion ?
L'équipe de recherche a décidé d'augmenter la difficulté en envoyant directement Memento 3 affronter le classique des salles d'arcade Atari Pong (ping-pong).
Contrairement aux jeux de réflexion précédents, la balle se déplace et rebondit cette fois sans cesse : l'IA doit non seulement comprendre les règles du jeu, mais aussi juger en temps réel la trajectoire de la balle et contrôler la raquette pour la renvoyer.
Et cet essai a effectivement donné lieu à quelque chose de nouveau.。
Au début, l'IA ignorait elle aussi les lois du rebond de la balle et devait tâtonner en jouant.
Elle pensait initialement que la raquette était divisée en quatre zones : la balle frappant à des positions différentes repartait dans la direction correspondante.
Puis, en jouant, un rebond horizontal est soudainement apparu.
Hein ? Cela ne correspondait pas aux règles établies précédemment.
L'IA a donc réanalysé la position de la collision et modifié la formule de rebond ; plus tard, face à de nouveaux écarts de trajectoire, elle a continué à s'ajuster, parvenant progressivement à des lois du mouvement plus conformes à la réalité.
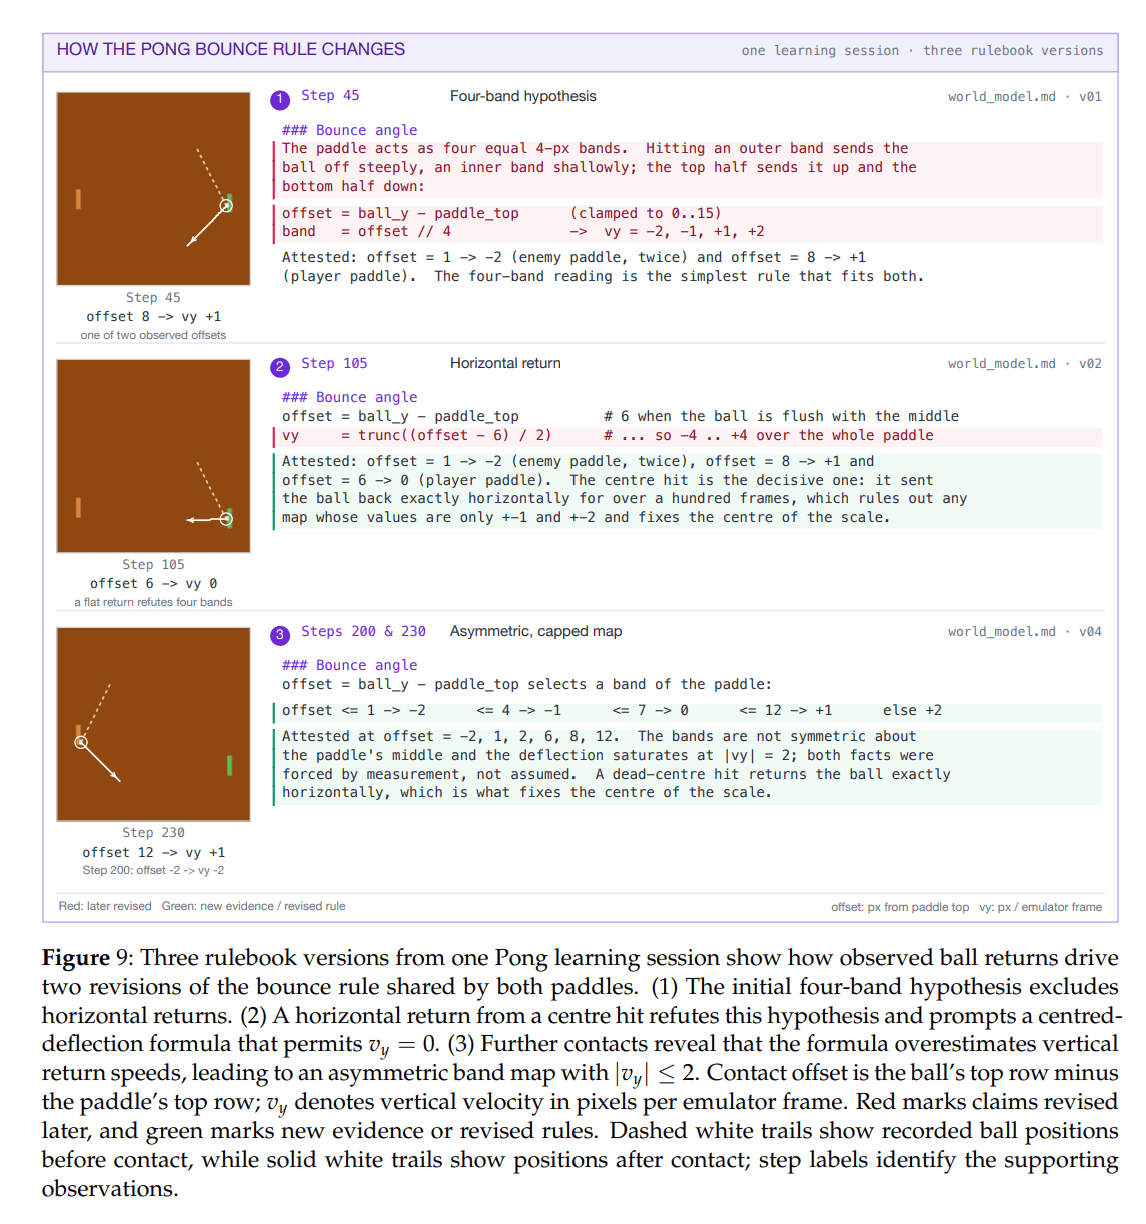
Une fois la stratégie de contrôle suffisamment mûre, l'équipe de recherche a tout simplement laissé ce programme jouer seul.
Sans plus faire appel à Claude Opus 5, ni mettre à jour les règles.
Résultat,trois parties avec des départs différents, toutes terminées sur le score de 21 à 0。
Impressionnant : au début, il explorait encore comment recevoir la balle, et ensuite il a littéralement infligé un shutout à son adversaire ???
Et attention, à ce stade, le grand modèle de langage n'a plus besoin d'entrer en scène lui-même.
Il se charge uniquement de la phase d'exploration des règles et de synthèse des stratégies ; une fois les tactiques apprises, il les confie directement au code pour l'exécution.
À titre de comparaison, sans utiliser de modèle du monde, si l'on laisse le grand modèle décider à chaque étape de l'action suivante uniquement à partir de l'image affichée, le score final n'est que de -19, guère mieux que le -20.7 obtenu en appuyant au hasard.
Cette comparaison fait ressortir l'écart.
Plutôt que de laisser le grand modèle réfléchir à chaque étape, autant d'abord lui apprendre à jouer, puis confier les tactiques à un programme.。
Et l'efficacité est assez spectaculaire.
Selon les données de l'article, Memento 3 n'a utilisé qu'environ9500 images de jeupour apprendre cette stratégie de contrôle.
En comparaison, certaines méthodes classiques d'apprentissage par renforcement nécessitent souvent des centaines de milliers, voire des centaines de millions d'images d'entraînement.
Bien sûr, cela ne signifie pas que Memento 3 soit sans coût.
Après tout, il repose sur Claude Opus 5 avec le niveau de raisonnement Extra-High activé, et les processus d'exploration, de génération de code et de validation consomment pas mal de tokens et de puissance de calcul.
De plus, les expériences actuelles portent principalement sur des environnements de jeu aux règles relativement claires ; si l'on passe à un monde réel plus complexe et changeant, il reste à vérifier si cette méthode reste efficace.
Cela dit, cette recherche soulève une piste intéressante à suivre :
l'amélioration de soi récursive (RSI) ne nécessite pas forcément de modifier les poids sous-jacents du modèle. En construisant un modèle du monde externe vérifiable, exécutable et réversible, un grand modèle généraliste aux paramètres gelés peut tout aussi bien s'itérer lui-même et évoluer rapidement dans des domaines inconnus.
Adresse de l'article :
https://arxiv.org/abs/2610.11794
Références :
https://x.com/ScarletKc/status/2109169173540884935