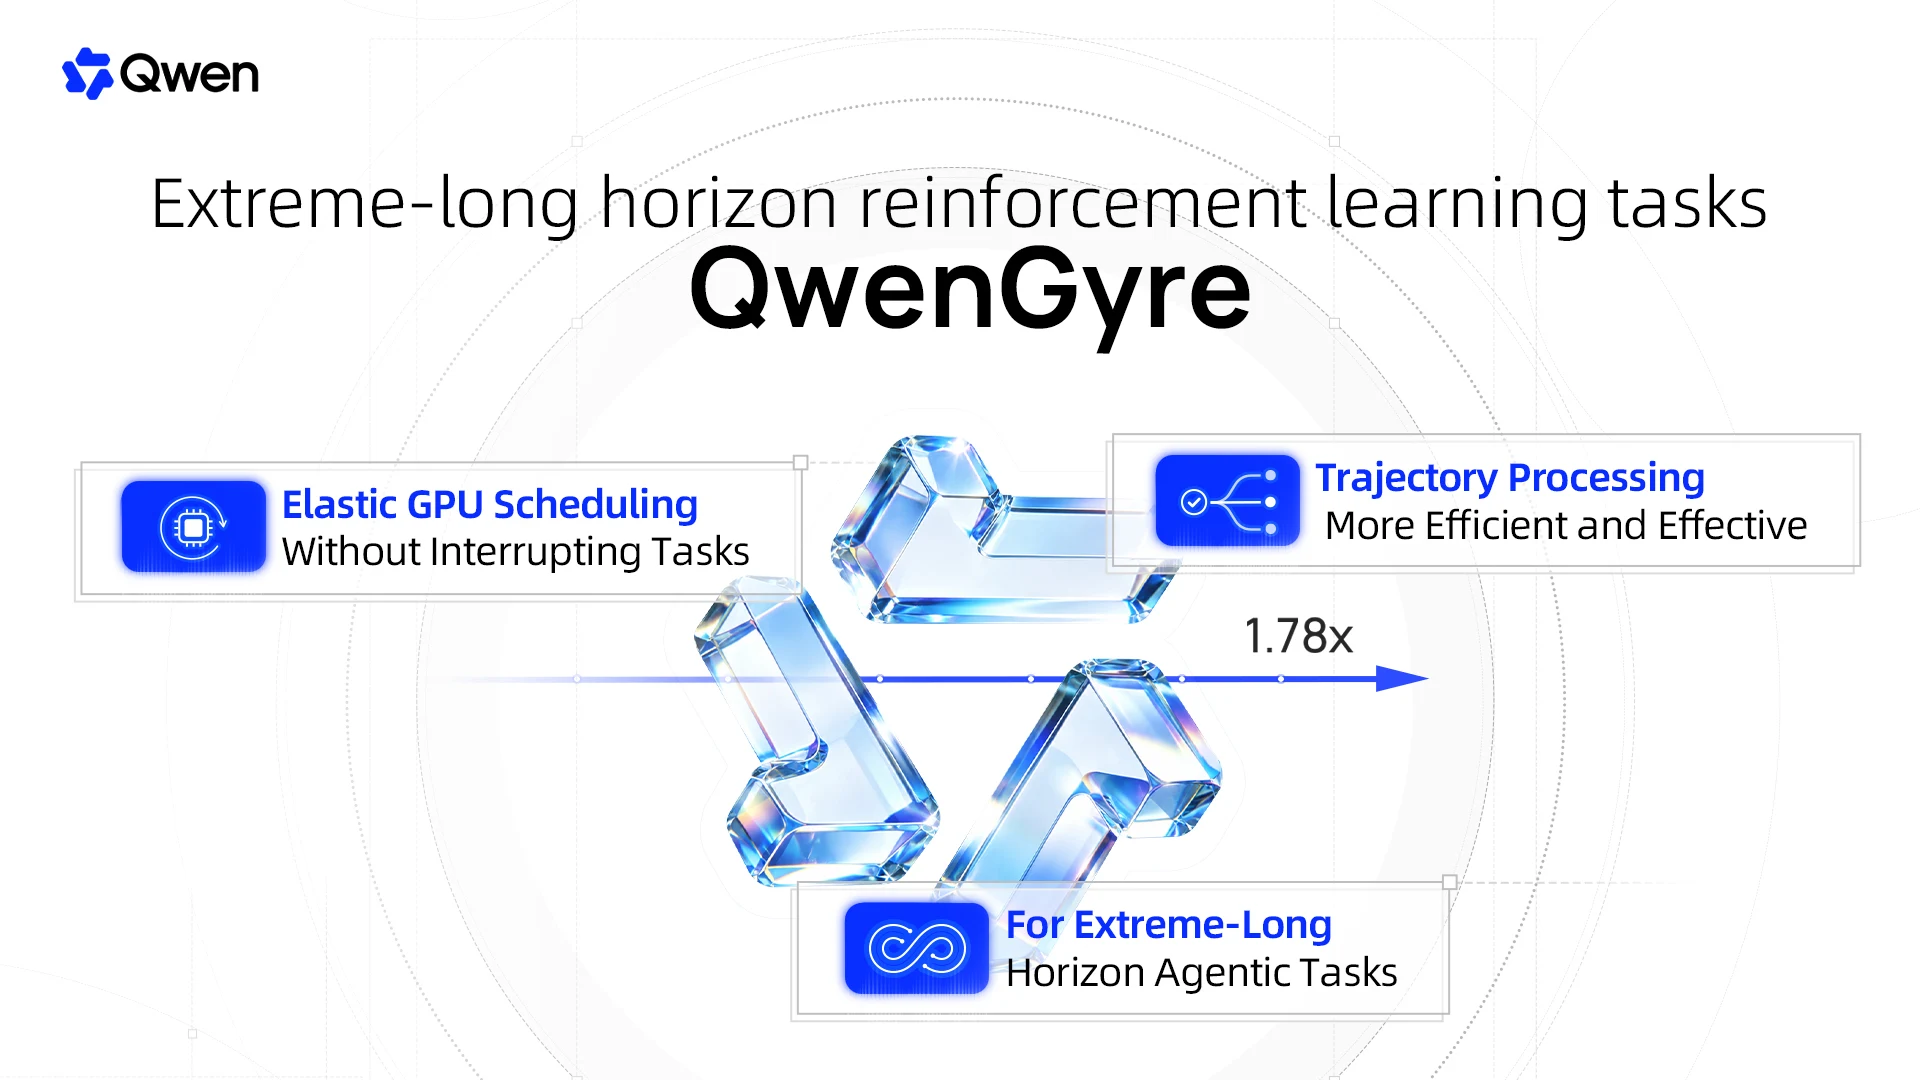
Présentation de QwenGyre, qui introduit le RL élastique pour l’entraînement d’agents à long horizon extrême (XLong). ✨
Il est lancé avec deux designs principaux : 🥳
- Scheduler Élastique : réalloue les GPU entre le déploiement et l’entraînement à mesure que la demande change – les exécutions en direct ne sont jamais interrompues. Vitesse jusqu’à 1,85× par rapport à Colocate, 1,78× par rapport à Async.
- Trajectory Processor : transforme les exécutions multiples (compaction, sous-agents, retours) en arbres de trajet partagés préfixés, avec des échantillons d’entraînement limités et dédupliqués. Les progrès partiels après un timeout sont toujours comptabilisés.
Étendu à Qwen3.8-2.4T-A95B avec environ 700K tokens par mise en œuvre, QwenGyre améliore NL2RepoBench de 52,5 % à 58,5 % en 48 étapes, réduisant le temps de formation tout au long du processus de ~44 % par rapport à Async.
🔗 Lire le papier :
https://arxiv.org/abs/2609.33848