
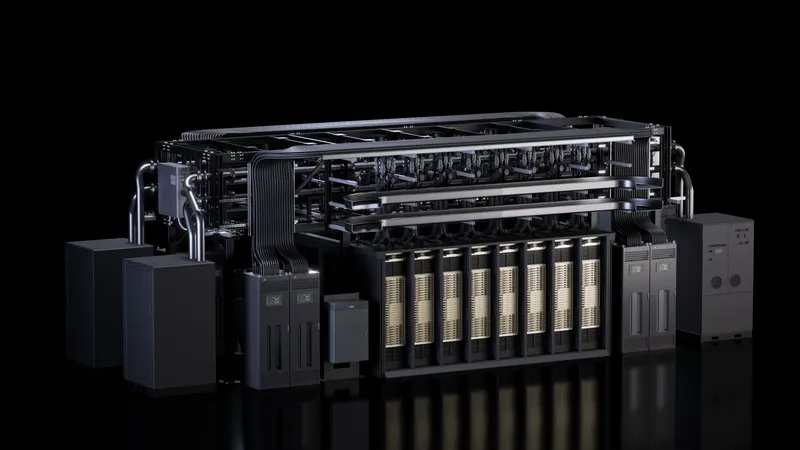
Alors que les usines d’IA passent de mégawatts à gigawatts, leur construction nécessite plus que des technologies informatiques avancées. Les normes ouvertes aident l’industrie à étendre l’infrastructure d’IA plus rapidement, plus efficacement et plus fiablement.
Lors du Sommet mondial de l’Open Compute Project (OCP) qui s’est tenu au centre de conférences San Jose McEnery, NVIDIA a annoncé de nouveaux partenariats et contributions visant à établir une base commune pour l’infrastructure de l’IA de nouvelle génération.
NVIDIA a contribué aux designs de rack et de plateau de calcul NVIDIA Vera Rubin via l’architecture ouverte NVIDIA MGX, offrant aux constructeurs de systèmes une base commune pour développer l’infrastructure d’usine d’IA de nouvelle génération.
Ensemble, ces efforts s’étendent à la propre usine d’IA, au réseau électrique qui la alimente et à l’architecture de rack à l’origine du calcul informatique accéléré moderne.
NVIDIA et partenaires annoncent des progrès dans l’architecture ouverte
Lors de l’événement OCP, NVIDIA et ses partenaires ont fait quelques annonces :
- NVIDIA et les hyperscalers ont publié des normes ouvertes pour les usines d’IA de nouvelle génération, incluant les normes de conception des usines d’IA et la résilience du réseau.
- NVIDIA a lancé de nouveaux composants logiciels open source pour NVIDIA DSX AI Factory.
- Meta et NVIDIA ont développé des réseaux open source d’IA avec les SuperNIC Ethernet NVIDIA Spectrum-X et les innovations Spectrum-6.
- Visionbay a introduit un design de usine pour la technologie 800V DC IA dans l’ère Vera Rubin.
- NVIDIA et Cisco ont annoncé le standard USFP ultra-dense small form factor plugable, le premier module de l’industrie pour les infrastructures réseau basées sur 400 Gb/s.
- NVIDIA et Google ont annoncé le soutien à Falcon Transport pour les futurs NVIDIA ConnectX-10 SuperNICs et BlueField DPUs.
Devant une salle comble, Ian Buck, vice-président de hyperscaling et de calcul haute performance chez NVIDIA, a discuté de la manière dont l’infrastructure ouverte devient un élément essentiel pour l’expansion des usines d’IA à l’échelle mondiale.
La nouvelles à OCP Met en lumière le fait que le partenariat extrême entre NVIDIA et les normes ouvertes accélère la déploiement, améliore l’efficacité énergétique et booste les performances par token par watt.
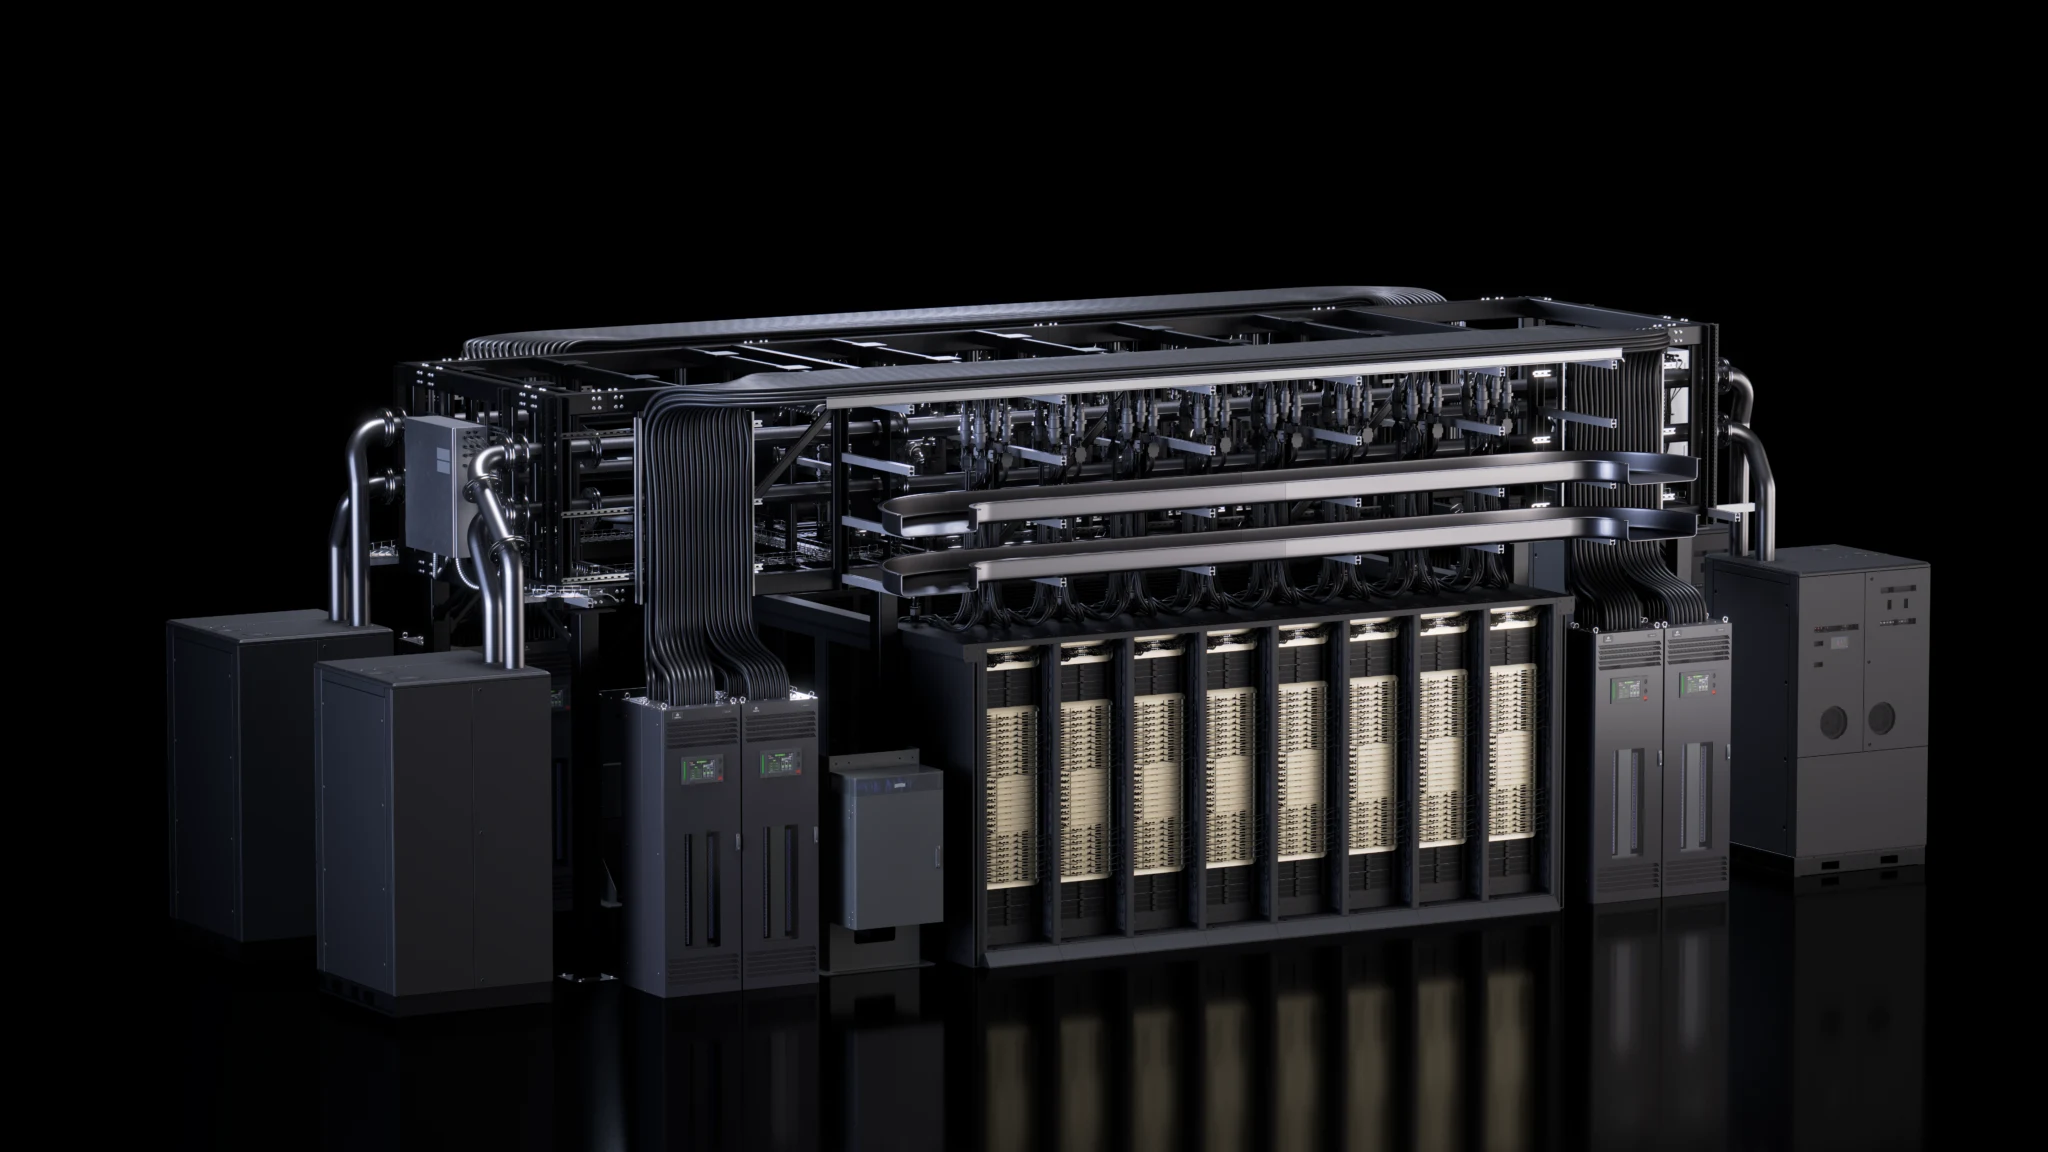
Vera Rubin AI Factories progressent grâce aux contributions du MGX Rack lors de l’OCP
NVIDIA s’est jointe aux leaders de l’industrie pour contribuer au design de référence du centre de données AI MGX de troisième génération via l’initiative Open DC d’OCP.
En combinaison avec des technologies de refroidissement liquide ouvertes telles que MQD et MQDB, cet effort permet de transformer les conceptions éprouvées de usines d’IA en normes industrielles que d’autres peuvent adopter, fabriquer et développer.
Pour les usines de IA Vera Rubin de NVIDIA, la spécification mise à jour MGX 1.2 étend l’architecture ouverte pour les usines d’IA avec un refroidissement liquide de type blind-mate à échelle de rack, une infrastructure d’interconnexion compatible à échelle de rack et un barreau de bus de 5 000 A refroidi liquide, conçu pour des systèmes d’IA à haute puissance. Elle ajoute également un support natif pour équipements de 19 pouces et des designs de rack à densité plus élevée.
MGX 1.2 développe davantage la modularité avec des emplacements d’entrée/sortie configurables, des plateformes de calcul refroidies liquide sans vent, des interfaces de puissance et de refroidissement standardisées, ainsi qu’une infrastructure commune qui permet aux partenaires de l’écosystème de construire des plateformes de calcul accéléré interopérables. Il améliore les temps d’assemblage, de test et de maintenance afin de simplifier la fabrication et les services sur le terrain, permettant ainsi une construction plus rapide et plus efficace d’infrastructures. L’architecture prend en charge les déploiements sur rack jusqu’à 250 kW, tout en simplifiant la disponibilité, le déploiement et la réutilisation de l’infrastructure.
Les spécifications de conception du rack CPU Vera élargissent l’architecture ouverte MGX de NVIDIA au-delà du calcul accéléré, offrant une plateforme conçue pour l’ère croissante de l’IA agentique. Alors que le Vera Rubin NVL72 constitue la base pour les entraînements et inférences à grande échelle, le rack CPU Vera de NVIDIA est conçu pour soutenir la appel d’outils, l’orchestration et l’exécution en environnement sandbox, aidant les agents IA à interagir avec des applications, des données et des services en temps réel.
Basé sur l’architecture de rack NVIDIA MGX de troisième génération, le rack CPU Vera partage les mêmes principes de conception à échelle de rack qui unissent calcul, réseau, alimentation et refroidissement en une plateforme modulaire commune. Cette approche permet aux partenaires de déployer des infrastructures spécialisées tout en bénéficiant d’un écosystème partagé, d’une intégration simplifiée et d’une base constante pour les usines d’IA de nouvelle génération.
NVIDIA lance de nouveaux composants logiciels open source pour DSX AI Factory
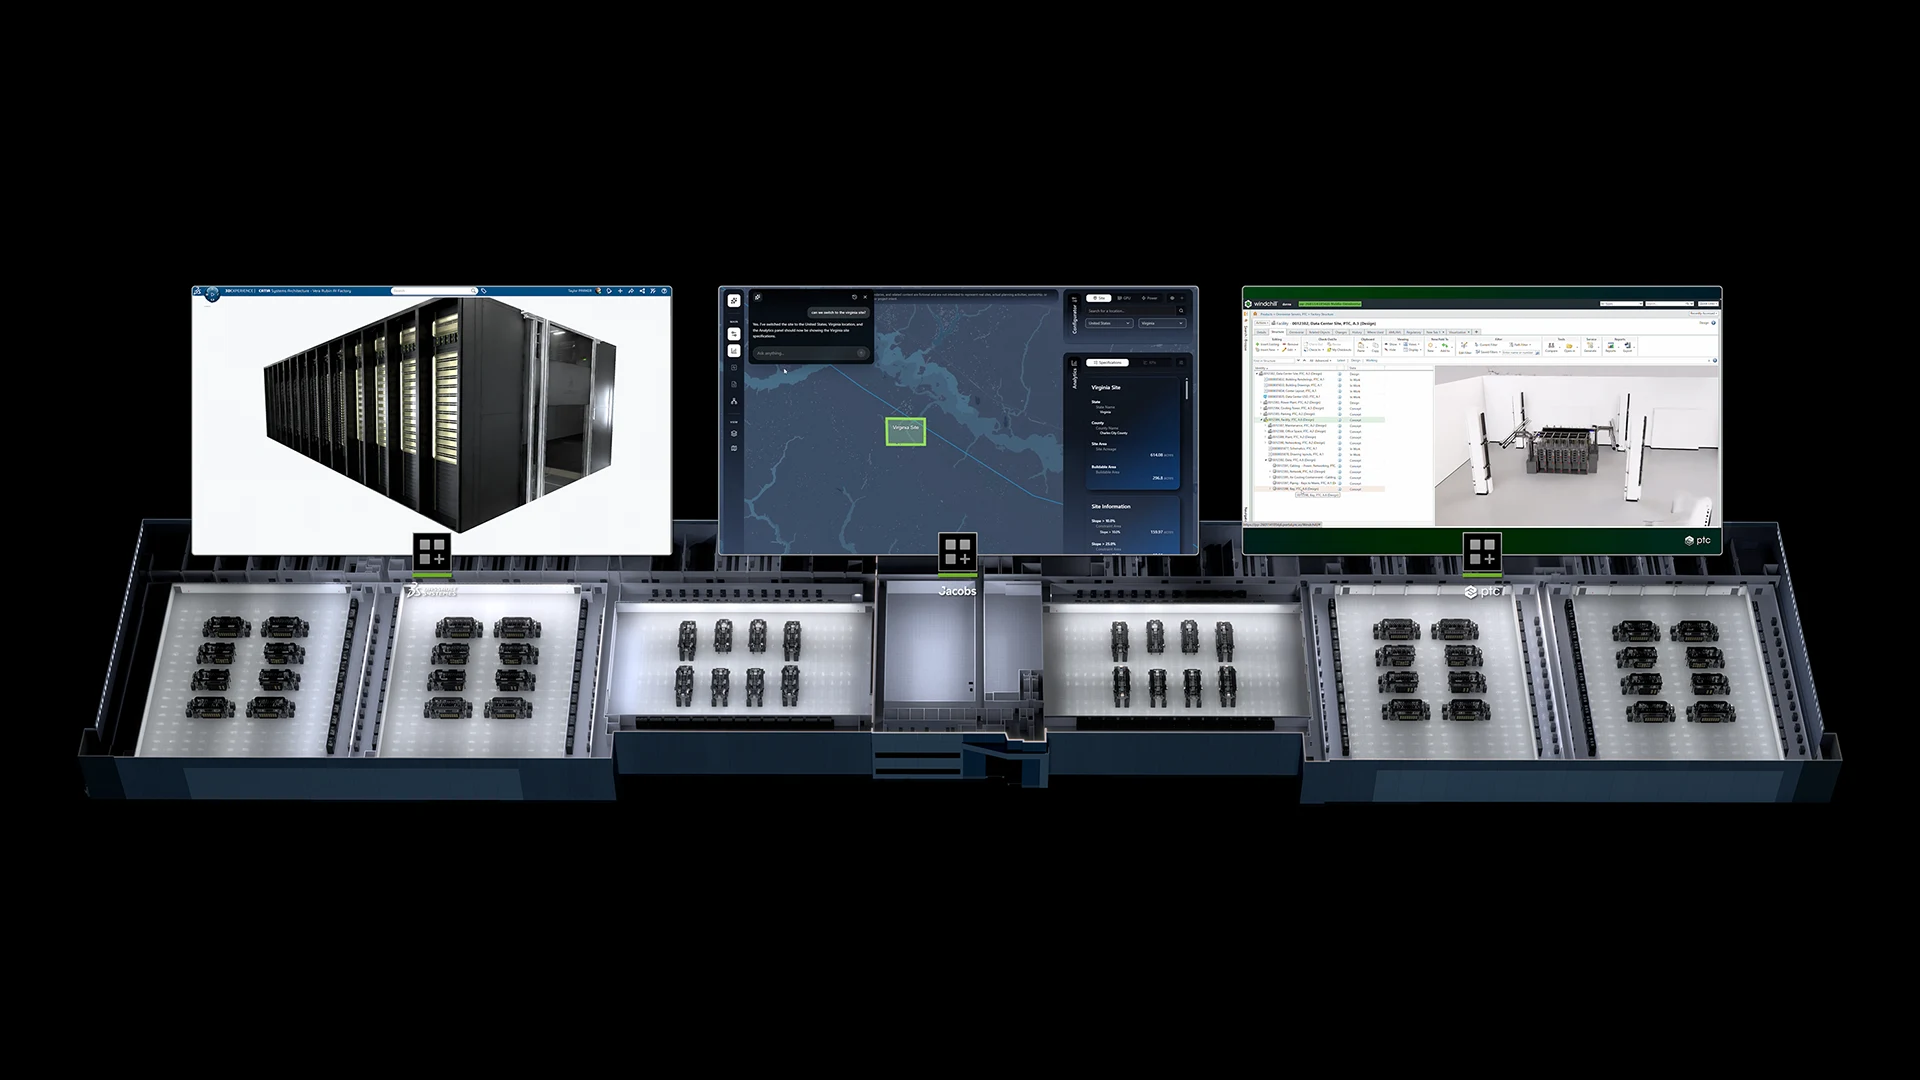
NVIDIA DSX AI factory platform applique un codage extrêmement étroit pour unifier calcul, réseau, alimentation, refroidissement, infrastructures et logiciel, permettant aux usines d’IA de fonctionner comme un système optimisé unique, maximisant ainsi les performances de l’IA dans les limites de l’infrastructure disponible. Au cœur de ce système unifié se trouve DSX OS, une couche d’exploitation ouverte qui transforme l’architecture DSX en opérations coordonnées et reproductibles à grande échelle.
À OCP, NVIDIA a étendu le DSX OS avec des composants open source pour la configuration des réseaux, la validation des clusters, la gestion des rack et la mise en place de matériel bare metal :
- NVIDIA Config Manager : Automatise la configuration des switches à grande échelle, permettant aux clients de déployer, valider et maintenir des réseaux de fabrique d’IA cohérents avec une intervention manuelle minimale ou nulle.
- NVIDIA Cluster Readiness Engine : Aide à éliminer les arrêts coûteux des tâches en subissant des tests de stress sur les clusters GPU avec des simulations de charge réelle, afin de garantir la santé du matériel avant le début de l’entraînement
- NVIDIA Rack Management Service : Offre une abstraction matérielle de rack et des solutions d’opérations qui traitent les racks comme des unités de première classe pour améliorer la gestion du firmware à l’échelle de l’usine d’IA.
- Fournisseur de API de cluster pour le contrôleur d’infrastructure NVIDIA : Accélère la déploiement sur matériel bare-metal et l’intégration des locataires, transformant du matériel AI brut en clusters prêts à la production en quelques heures plutôt que en jours.
Étendus grâce à l’expérience de NVIDIA dans la mise en service des NVIDIA DGX Cloud, ces composants open source permettent aux fournisseurs de services cloud et aux partenaires logiciels d’intégrer directement les capacités de l’usine de l’IA dans leurs plateformes multi-tenant.
Les développeurs peuvent visiter lapage GitHub de DSX AI Factory pour explorer et contribuer aux composants logiciels open source existants et nouveaux de la plateforme NVIDIA DSX AI Factory.
NVIDIA et les hyperscalers publient des standards ouverts pour les usines d’IA de nouvelle génération
Pour que l’infrastructure de l’IA puisse se développer à l’échelle mondiale, elle a besoin de plus qu’un matériel avancé – elle a besoin d’une base commune sur laquelle toute l’industrie peut s’appuyer.
À OCP, NVIDIA s’est associée à AMD, Google et Meta pour publier une nouvelle spécification ouverte qui constitue cette base. La Spécification du centre de données ouvert v0.7 définit un plan unifié pour la conception des installations d’IA de nouvelle génération — depuis l’architecture énergétique jusqu’à l’infrastructure de refroidissement et au plan physique.
La Spécification de résilience du réseau OCP, publiée par Google, Meta, Microsoft et NVIDIA, définit la manière dont les infrastructures d’IA à grande échelle doivent fonctionner en cas de perturbations dans le réseau électrique : rester connecté, réagir automatiquement et retrouver une charge proche de la pleine capacité en moins de deux secondes.
Avec ces normes désormais ouvertes, les fabricants du monde entier disposent d’un objectif commun à atteindre. Les fabricants d’équipements, les fournisseurs de colocation et les opérateurs de centres de données peuvent commencer à concevoir, fabriquer et livrer le niveau d’infrastructure qui alimente les usines d’IA en construction à l’échelle mondiale — sans avoir à attendre des spécifications propriétaires des clients individuels.
Étant compatibles avec le design de référence NVIDIA DSX, ces spécifications offrent une implémentation valide et déployable de toutes les exigences, depuis l’aménagement des installations et l’architecture énergétique jusqu’au logiciel qui surveille et répond aux signaux du réseau en temps réel. Pour les opérateurs qui construisent des usines de IA Vera Rubin, il y a désormais une liaison directe entre la norme communautaire ouverte et un système en fonctionnement.
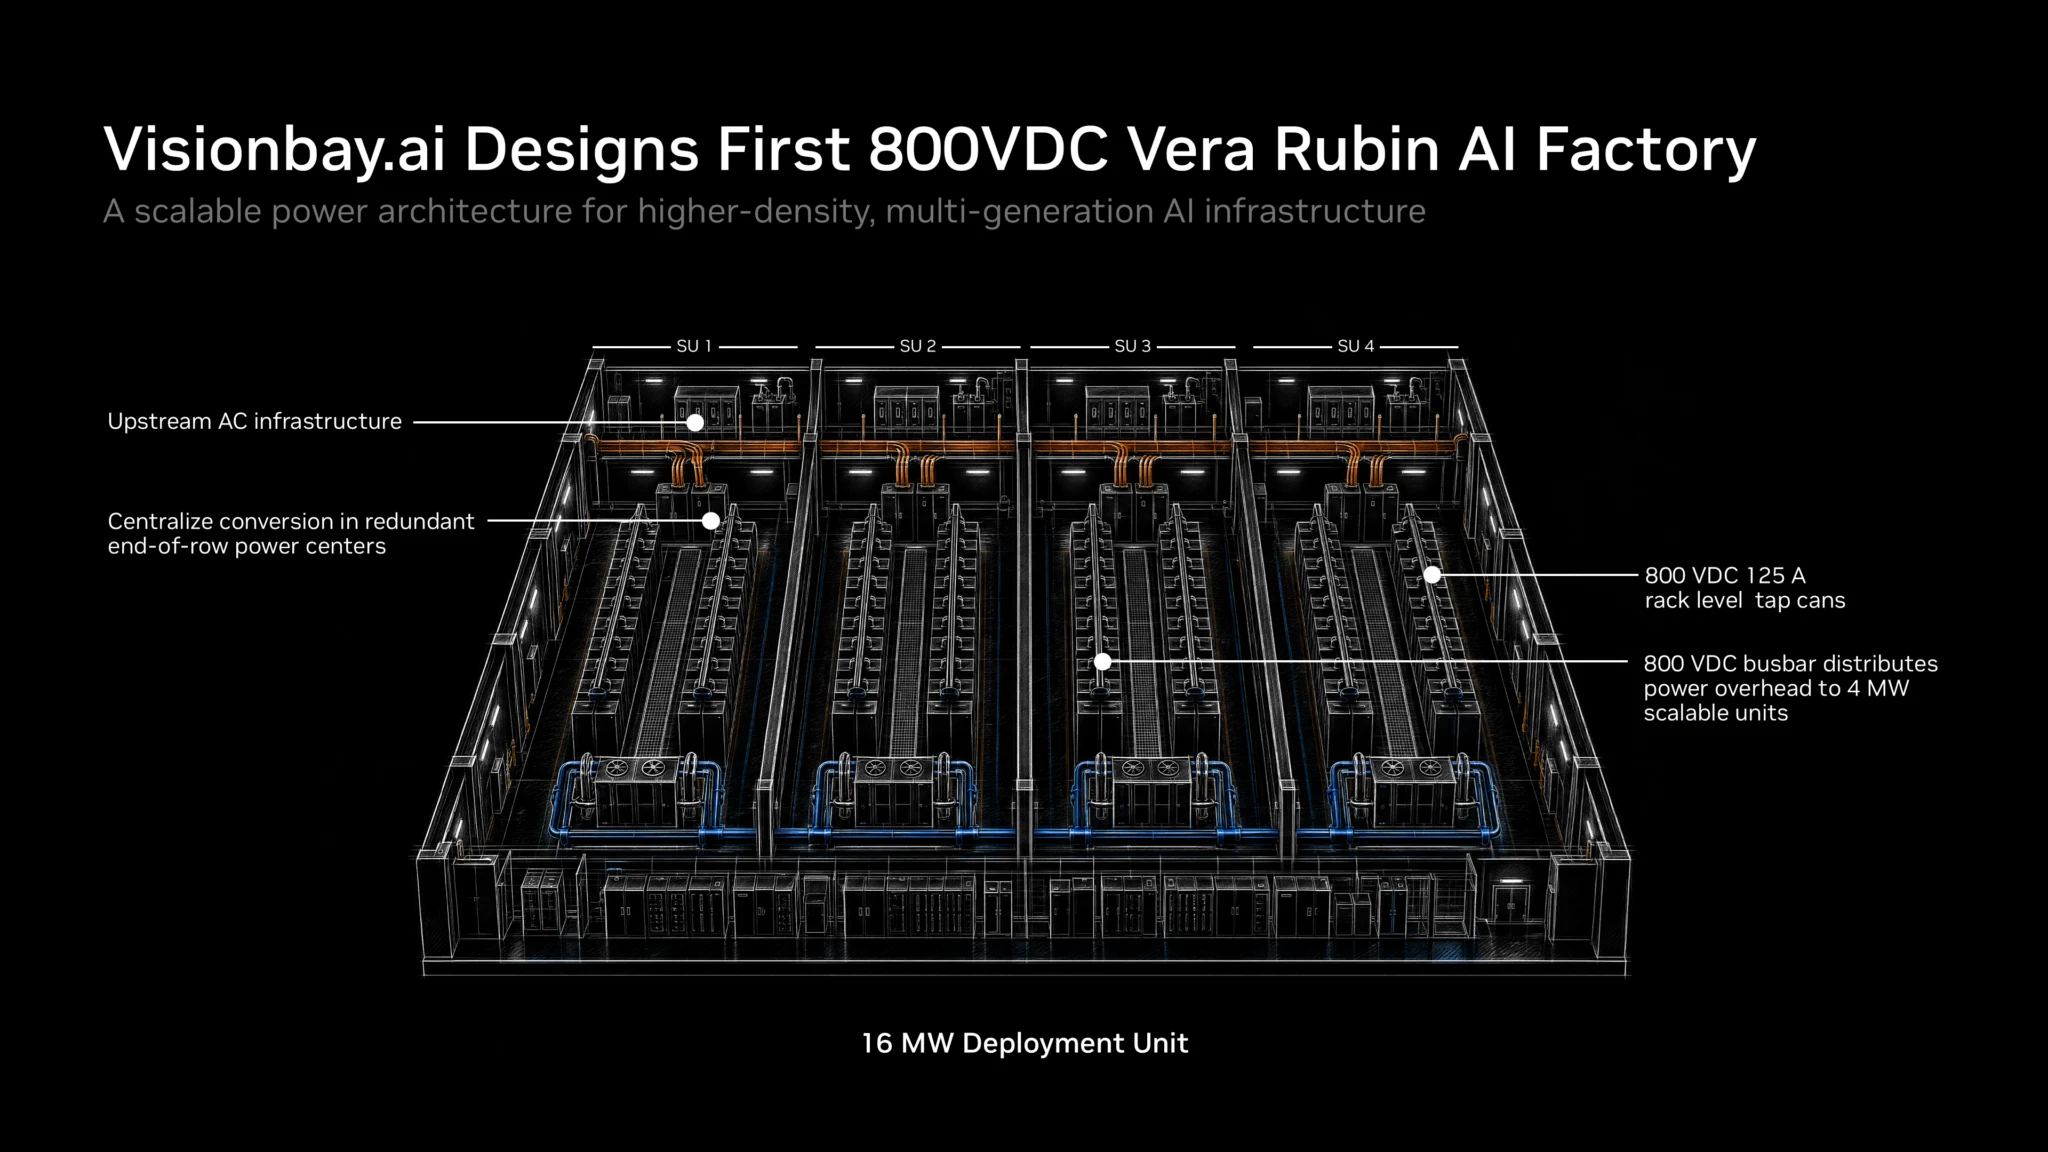
Visionbay.ai Conceille 800VDC AI Factory pour l’ère Vera Rubin
Alors que les usines d’IA deviennent de plus en plus grandes et puissantes, un défi se pose pour toutes : fournir suffisamment d’énergie aux systèmes informatiques accélérés qui sous-tendent la nouvelle génération d’IA.
À OCP, Visionbay a dévoilé les plans de K-1, une plateforme de usine d’IA de nouvelle génération conçue autour de l’architecture 800 VDC et construite en tenant compte des déploiements futurs de NVIDIA Vera Rubin. Le projet combine l’architecture de référence 800 VDC de NVIDIA avec les technologies de puissance et de thermique de Vertiv, afin de créer une base évolutive pour une infrastructure d’IA à haute densité.
Le design répond à une évolution croissante des défis de l’industrie. À mesure que les charges de formation, d’inférence et de raisonnement de l’IA se développent, les densités d’énergie des rack continuent d’augmenter. La distribution d’énergie à basse tension traditionnelle devient de plus en plus difficile à étendre, ce qui nécessite davantage de cuivre, plus de câblage et plus d’équipements de conversion d’énergie.
En adoptant l’architecture 800 VDC de NVIDIA, K-1 crée un chemin vers une infrastructure AI à plus grande densité, tout en conservant la flexibilité pour les déploiements existants. Au lieu d’exiger une transition complète dès le premier jour, la plateforme est conçue pour intégrer progressivement la distribution 800 VDC là où elle apporte le plus grand avantage, aidant les opérateurs à se préparer aux générations futures de calcul accéléré sans nécessiter un réaménagement complet des installations.
L’architecture est conçue autour de centres de puissance au niveau des clusters qui centralisent la conversion AC à DC et distribuent 800 VDC plus près des ressources de calcul. Cette approche simplifie la livraison d’énergie en aval, permet une expansion modulaire et crée des blocs de construction répétables pour la croissance future de l’usine d’IA.
K-1 reflète également la philosophie de conception à niveau système qui sous-tend les usines d’IA de NVIDIA, où puissance, refroidissement et calcul sont conçus ensemble. Avec le soutien d’une infrastructure refroidie par liquide, d’une distribution de puissance évolutive et des déploiements futurs de classe Vera Rubin, ce projet montre comment les partenaires de l’écosystème transposent l’architecture des usines d’IA de NVIDIA en une infrastructure déployable conçue pour la prochaine ère du calcul accéléré.
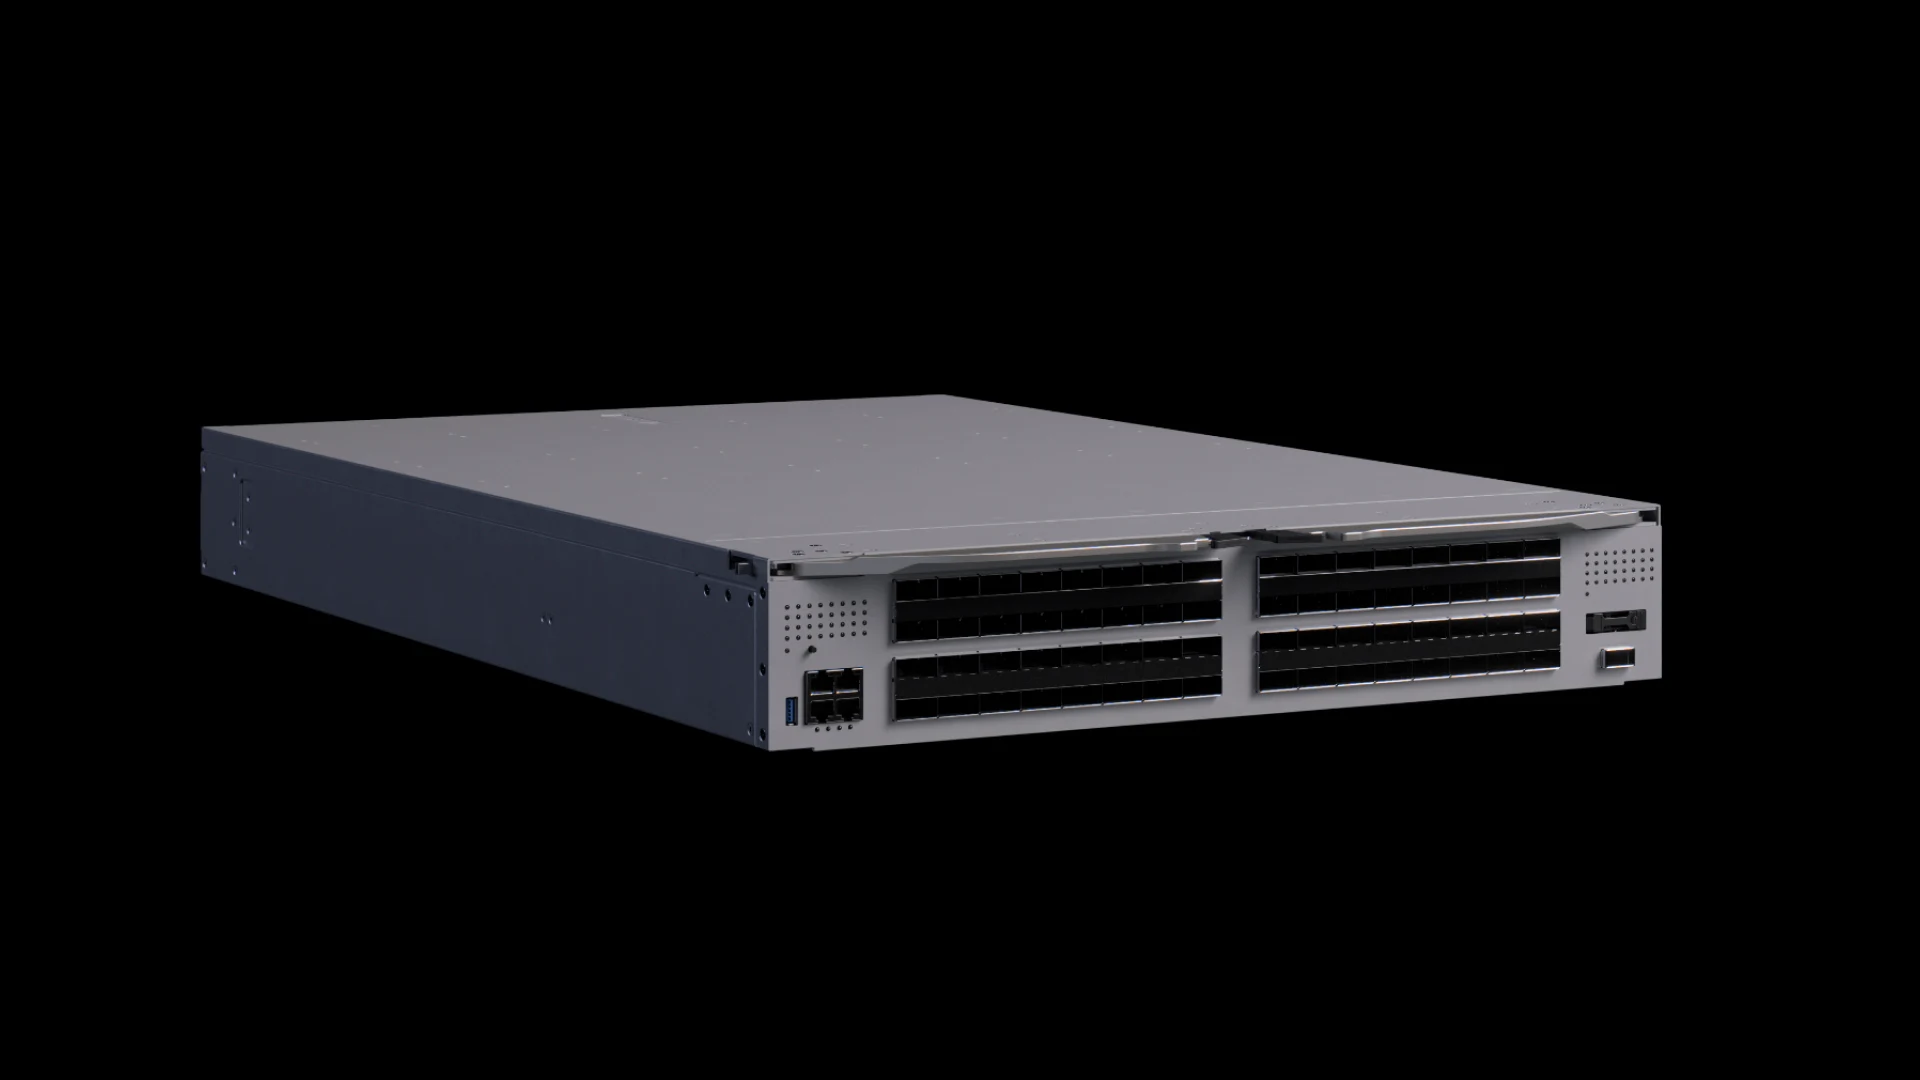
Meta et NVIDIA Advance AI Networking avec Spectrum-6 et Multiplane Technology
Lors de l’événement, Meta et NVIDIA ont annoncé que Meta utilisera les commutateurs Ethernet NVIDIA Spectrum-6 102,4 Tb/s pour construire des usines NVIDIA Vera Rubin AI plus grandes et plus performantes sur un réseau ouvert.
Spectrum-6 offre deux fois plus de capacité de commutation et de bande passante par voie que Spectrum-4, et propose une structure d’Ethernet IA sans perte à 200G par voie, avec une large bande passante efficace et une isolation des performances qui empêche le trafic d’un travail de ralentir celui d’un autre.
Le commutateur N-IceCube de Meta, basé sur le Spectrum-6, est intégré dans IcePack, le rack à refroidissement liquide 100T de Meta. N-IceCube utilise le système de commutation ouvert Facebook Open Switching System (FBOSS), le système d’exploitation de réseau open source de Meta qui a contribué à OCP pour soutenir des réseaux efficaces à haute échelle.
FBOSS est construit sur l’Interface d’abstraction Switch, un standard OCP que NVIDIA a contribué au développement, offrant une méthode indépendante des fournisseurs pour contrôler le matériel switch. Ces technologies, ensemble, soutiennent des usines d’IA agentique comprenant plus de 100 000 GPU qui entraînent et servent des modèles mixture-of-experts.
L’annonce marque la prochaine étape d’une collaboration qui combine l’expérience de Meta dans le fonctionnement d’infrastructures d’IA à haute échelle avec la technologie de réseau de NVIDIA.
Au cœur de cette collaboration se trouve la technologie Spectrum-X Multiplane, rendue possible par les commutateurs Spectrum-6 et les SuperNICs ConnectX-9. Multiplane distribue le trafic GPU sur huit plans de réseau indépendants, permettant aux usines d’IA de s’étendre jusqu’à 100 000 GPU sans ajouter de niveaux de commutateurs ni de coûts d’infrastructure supplémentaires. Plusieurs chemins entre les GPU améliorent l’utilisation du réseau et la résilience : lorsqu’un composant tombe en panne, le trafic se déplace vers les autres équipements, permettant aux GPU de rester productifs et aux applications d’IA de fonctionner, même avec un bande passante réduit.
Meta et NVIDIA ont collaboré pour renforcer cette résilience grâce à l’expérience de déploiement et à l’itération rapide de l’ingénierie. Les équipes ont validé les améliorations dans les environnements sur site et en cloud.
« Nous sommes enthousiastes face à notre partenariat étroit avec NVIDIA, qui permet de rendre les structures multi-planes évolutives et performantes sur le plan opérationnel – une exigence essentielle tant pour nos propres projets d’infrastructure que pour nos partenaires cloud conjoints », a déclaré Omar Baldonado, directeur senior des centres de données et du réseau d’IA chez Meta. « L’extension de FBOSS aux ASICs Spectrum signifie que nous pouvons exécuter le même stack de logiciel sur nos équipements, et le nouveau commutateur basé sur Spectrum de Meta, N-IceCube, intègre cela dans Icepack – notre rack de réseau à refroidissement liquide de 102,4 T, conçu pour l’expansion, qui connecte les générations futures d’accélérateurs de notre flotte. »
Ensemble, Meta et NVIDIA développent une architecture et un guide opérationnel que d’autres opérateurs d’infrastructures d’IA peuvent adopter, transformant les leçons tirées des charges de travail de production exigeantes en usines d’IA plus évolutives, résilientes et efficaces.
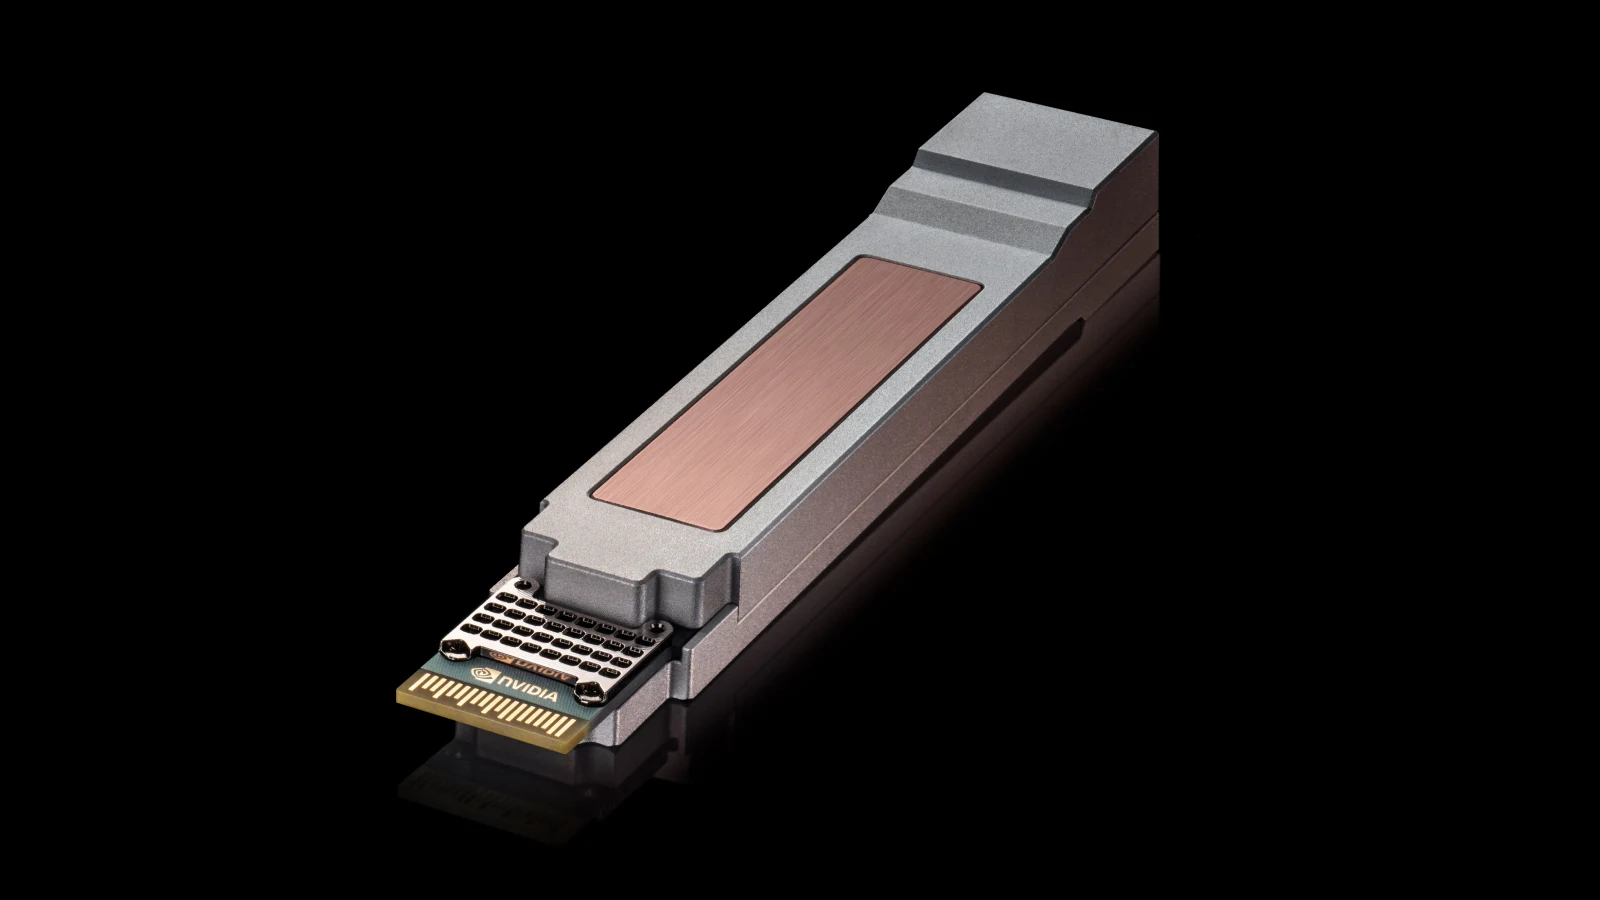
Avec USFP, NVIDIA et Cisco, ils réinventent les optiques pluggables pour les usines d’IA à grande échelle
Alors que les usines d’IA se développent pour soutenir des modèles plus complexes et la demande croissante d’inférences, chaque composant de l’écosystème infrastructure doit offrir une meilleure performance, une efficacité et une simplicité – jusqu’au niveau de la connexion réseau elle-même.
À OCP, NVIDIA et Cisco ont annoncé des plans pour USFP, un nouveau format de module transceiver optique pluggable conçu pour aider les constructeurs de usines d’IA à étendre les textiles d’IA de nouvelle génération, tout en améliorant la densité de bande passante et l’efficacité énergétique.
Avec une empreinte environ équivalente à celle du format OSFP de 200 Gb/s par voie, le USFP offrira un chemin vers la connectique à 400 Gb/s par voie et étendra le modèle de déploiement basé sur des transceivers déjà éprouvé au cours de plusieurs générations de réseaux de centres de données. En intégrant 16 voies plein-duplex et en prévoyant une évolution vers 32 voies, le USFP fournira quatre fois plus de densité de bande passante que les optiques pluggables traditionnels de 200 Gb/s par voie.
Le résultat est la capacité de connecter davantage de ressources informatiques sans ajouter de niveaux de réseau qui pourraient augmenter la latence, la consommation d’énergie et la complexité.
Le nouveau format est conçu pour répondre aux exigences de taille et d’efficacité des usines de IA de nouvelle génération. Il permet de utiliser des réseaux à plus haute bande passante tout en conservant la flexibilité et la disponibilité nécessaires, qui font que les optiques pluggables sont un élément essentiel des centres de données modernes. Il offrira également une efficacité énergétique environ 1,3 fois supérieure, aidant les opérateurs à transporter plus de données avec moins d’énergie.
Pour soutenir la mise en place d’un écosystème ouvert, NVIDIA et Cisco collaborent avec TE Connectivity et Amphenol sur des cages, des connecteurs et des modules. Ils prévoient de promouvoir USFP grâce à une initiative multi-source menée par la communauté. Ensemble, ces entreprises établissent les bases d’une réseau industriel de l’IA plus scalable, plus efficace et interopérable.
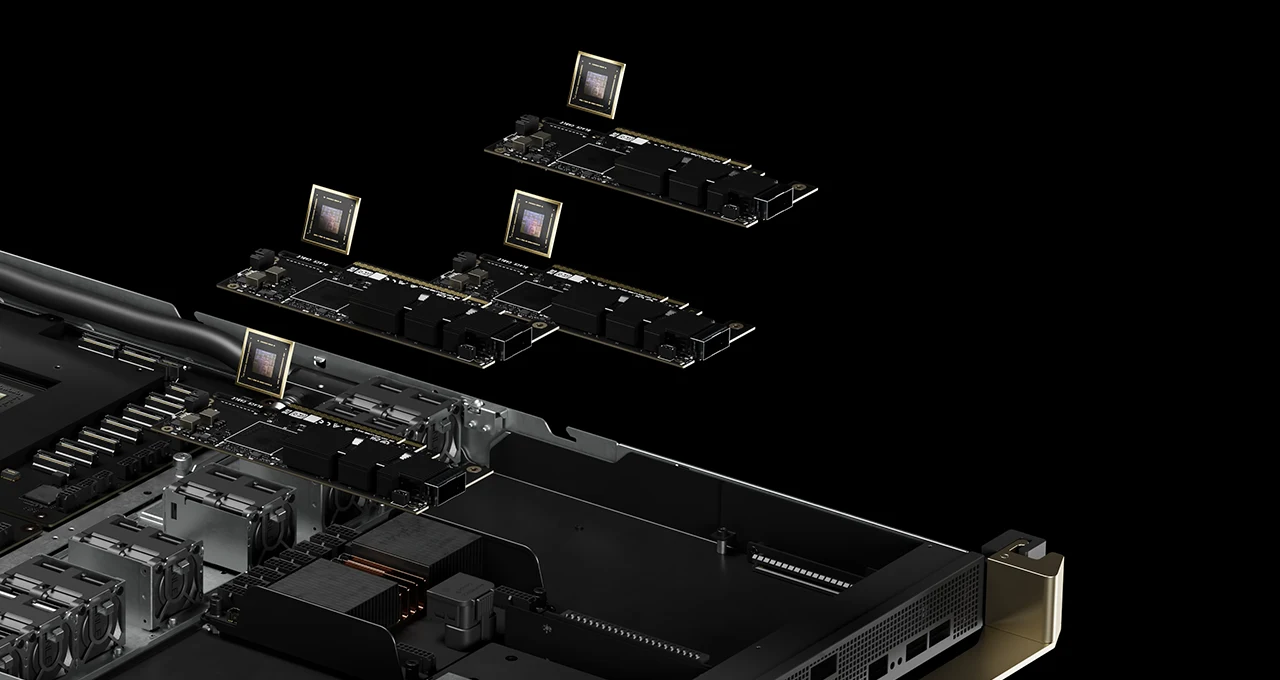
Google Falcon Transport prend en charge NVIDIA ConnectX-10 pour un réseau d’IA interopérable
NVIDIA et Google ont également annoncé le soutien à Falcon Transport pour les futurs NVIDIA ConnectX-10 SuperNICs et BlueField DPUs, ce qui permet d’améliorer l’efficacité du réseau dans les infrastructures de IA à grande échelle.
Falcon est un protocole de transport conçu pour transmettre les données de manière fiable sur les réseaux Ethernet, afin d’éviter que les paquets ne soient perdus en cas de congestion. Il prend en charge les charges de travail liées à l’IA et au stockage grâce au équilibrage de charge multipath, au contrôle de la congestion programmable, à la récupération des pertes matérielles et à la sécurité par connexion.
Cette collaboration combine l’accélération matérielle NVIDIA avec le logiciel DOCA afin de mettre en œuvre Falcon et d’étendre les réseaux NVIDIA au transport du centre de données de Google. Les cartes réseau NVIDIA et Google peuvent communiquer via un transport commun, tout en permettant aux applications de conserver des interfaces de programmation standard RDMA.
En distribuant le trafic entre différentes voies, en s’adaptant aux congestionnements, en récupérant les paquets perds et en protégeant les connexions, Falcon permet aux charges de travail d’utiliser plus efficacement la bande passante disponible et de maintenir un performance prévisible à mesure que les structures Ethernet s’étendent.
Apprenez plus en participant àNVIDIA à OCP.