
LFM2.5-24B-A2B est un modèle de raisonnement à 24B paramètres, avec seulement 2B paramètres actifs, conçu pour des agents rapides et privés sur le dispositif. Il réfléchit avant d’obtenir une réponse, appelle des outils et effectue des tâches multiétapes dans des outils d’agents populaires. Comme seuls 2B paramètres sont actifs par token, chaque token de raisonnement est peu coûteux, permettant ainsi de faire fonctionner les agents en continu sur votre propre matériel.
- Agent de première classe : Compétitif avec Qwen3.6-35B-A3B, un modèle qui dispose d’environ 50 % plus de paramètres totaux et actifs, dans les tâches d’agentisation et d’utilisation d’outils, et qui obtient une note de 48.09 sur LiveClaw contre 38.19.
- Réflexion à vitesse MoE : Toujours réfléchit avant de répondre. Avec seulement 2B paramètres actifs par token, chaque token de réflexion est peu coûteux.
- Inference efficace : 184 tok/s sur un Apple M5 Max et jusqu’à 21K tok/s sur une seule GPU NVIDIA B300.

Comment nous avons construit un agent de raisonnement avec 2B de paramètres actifs
LFM2.5-24B-A2B s’appuie sur LFM2-24B-A2B et conserve son architecture : 40 couches, 64 experts par bloc MoE avec routage top-4, ainsi que le même hybride de convolutions courtes gérées et de GQA. La fenêtre de contexte passe de 32K à 131K tokens, et une expansion du tokenizer en place double le vocabulaire de 65K à 128K tokens pour une tokenisation plus efficace des caractères non latins. Contrairement à son prédécesseur, il s’agit d’un modèle de raisonnement uniquement, qui produit une chaîne explicite de pensée avant sa réponse finale.
Pré-entraînement : étape de formation préalable, distincte de l’entraînement ordinaire ; utiliser « pré-entraînement ». Le pré-entraînement a été augmenté de ~17T à ~33T tokens. Pendant la phase de milieu d’entraînement, 2T tokens sont ajoutés à 32K contexte, avec un poids accordé aux raisonnements, aux mathématiques, au code, à l’exécution d’instructions et au texte multilingue, ainsi que 300B tokens à 131K contexte, avec un poids accordé aux données à long contexte. Les appels d’outils et les trajectoires multi-tours apparaissent dans les deux phases. Post-entraînement : le modèle de base devient un agent en cinq étapes.
- Fine-tuning supervisé (SFT)
- Spécialisation en enseignement
- Distillation multi-domaine sur politique (MOPD), non-agentique : distiller les enseignants spécialisés sur des tâches non-agentiques.
- MOPD, agentique : une deuxième étape de distillation axée sur les tâches agentiques.
- Apprentissage renforcé agentique (Agentic RL) : entraîner le modèle à l’intérieur de dispositifs agents, tels que OpenClaw, Hermes Agent, Pi et OpenCode.
Résultats du benchmark
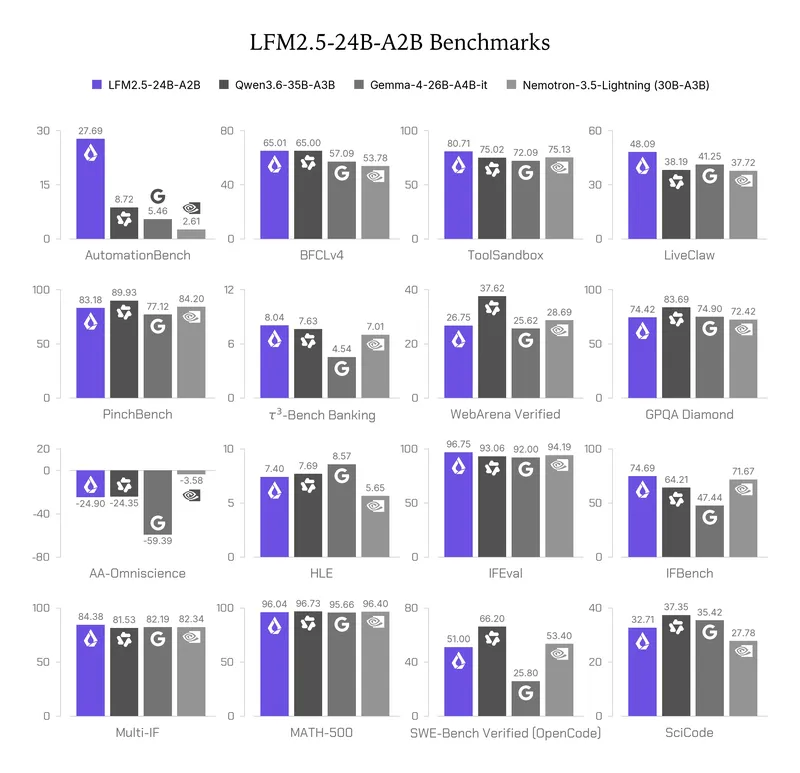
Nous avons évalué LFM2.5-24B-A2B par rapport à Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it et Nemotron-3.5-Lightning sur 16 benchmarks couvrant l’utilisation d’outils et les workflows agents, la connaissance, le suivi d’instructions, les mathématiques et le codage. C’est le modèle le plus petit du groupe, mais il est compétitif avec MoEs, avec environ 50 % de paramètres totaux et actifs supplémentaires.
| Benchmark | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Vérifié (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
*Tous les modèles ont été évalués avec vLLM, en utilisant les paramètres de génération recommandés pour chaque benchmark.
Pour votre application, les points forts sont l’utilisation des outils et le suivi des instructions. LFM2.5-24B-A2B se place en tête ou à égalité sur cinq des huit critères d’utilisation des outils et d’agency (AutomationBench, BFCLv4, ToolSandbox, LiveClaw et τ³-Bench Banking), et sur AutomationBench, il obtient plus de trois fois la note du modèle le mieux classé. Il est également en tête sur les trois critères de suivi des instructions. Les modèles plus grands restent en avant sur les tests d’évaluation intégrant beaucoup de connaissances, tels que GPQA Diamond, HLE et AA-Omniscience, ainsi que sur les tests de codage, comme SWE-Bench Verified (OpenCode) et SciCode. Par conséquent, il est conseillé d’utiliser LFM2.5-24B-A2B en combinaison avec une recherche de données ou une recherche en ligne pour traiter des tâches impliquant une grande quantité de connaissances.
Ces résultats font de LFM2.5-24B-A2B une base solide pour les agents qui doivent raisonner, utiliser des outils et fonctionner de manière fiable sur votre appareil.
Vitesse d’inférence sur CPU et GPU
LFM2.5-24B-A2B est livré avec un soutien immédiat sur l’ensemble de l’écosystème d’inférence, y compris llama.cpp, MLX, vLLM, SGLang et ONNX.
Inference Edge. LFM2.5-24B-A2B est le modèle le plus rapide parmi ceux comparés, décodant 184 tokens/s sur un M5 Max et 114 tokens/s sur un Ryzen AI Max+ 395. Cela représente jusqu’à 1,7 fois plus de vitesse que le modèle suivant, tout en utilisant la moindre mémoire.

Inference GPU. LFM2.5-24B-A2B est le modèle le plus rapide dans sa catégorie de taille, atteignant plus de 21 000 tokens de sortie par seconde à haute concurrence sur un seul B300.

Comment utiliser LFM2.5-24B-A2B
Prenez LFM2.5-24B-A2B lorsque vous avez besoin d’agents qui raisonnent, utilisent des outils et fonctionnent de manière fiable sur votre appareil.
Installez la dernière version de transformers (compatible avec transformers>=5.0.0):
pip install -U transformers
Ensuite, chargez et exécutez le modèle :
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
#   attn_implementation="flash_attention_2" <- uncomment on compatible GPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_new_tokens=512,
    streamer=streamer,
)
Utilisez-le dans votre agent harness
Servez LFM2.5-24B-A2B localement derrière n’importe quel backend compatible avec OpenAI, puis dirigez votre harnais d’agent vers celui-ci. Par exemple, avec l’Agent Hermes :
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
Le port dépend du backend de service que vous utilisez : llama.cpp et MLX utilisent 8080, vLLM utilise 8000, SGLang utilise 30000, et LM Studio utilise 1234. Consultez la carte de modèle pour les configurations OpenClaw et Pi, et notre guide pour la configuration complète. Rendez-vous également à notre blog de sortie pour des exemples vidéo.
> Commencer avec LFM2.5-24B-A2B
LFM2.5-24B-A2B et LFM2.5-24B-A2B-Base sont de poids ouvert et disponibles sur Hugging Face aujourd’hui :
- Téléchargement : LFM2.5-24B-A2B-Base et LFM2.5-24B-A2B sur Hugging Face.
- Utilisation dans votre harnais : suivez notre guide sur la manière de démarrer un agent local, tels que OpenClaw, Hermes Agent et Pi.
- Affiner : adapter LFM2.5-24B-A2B à votre tâche avec nos tutoriels d’affinement.
Nous n’avons pas hâte de voir ce que vous construirez.
Citation
Si vous utilisez ce travail, veuillez citer le blog de publication :
@article{liquidAI202624BA2B,
  author  = {Liquid AI},
  title   = {LFM2.5-24B-A2B: Built for Fast On-Device Agents},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/lfm2-5-24b-a2b},
}