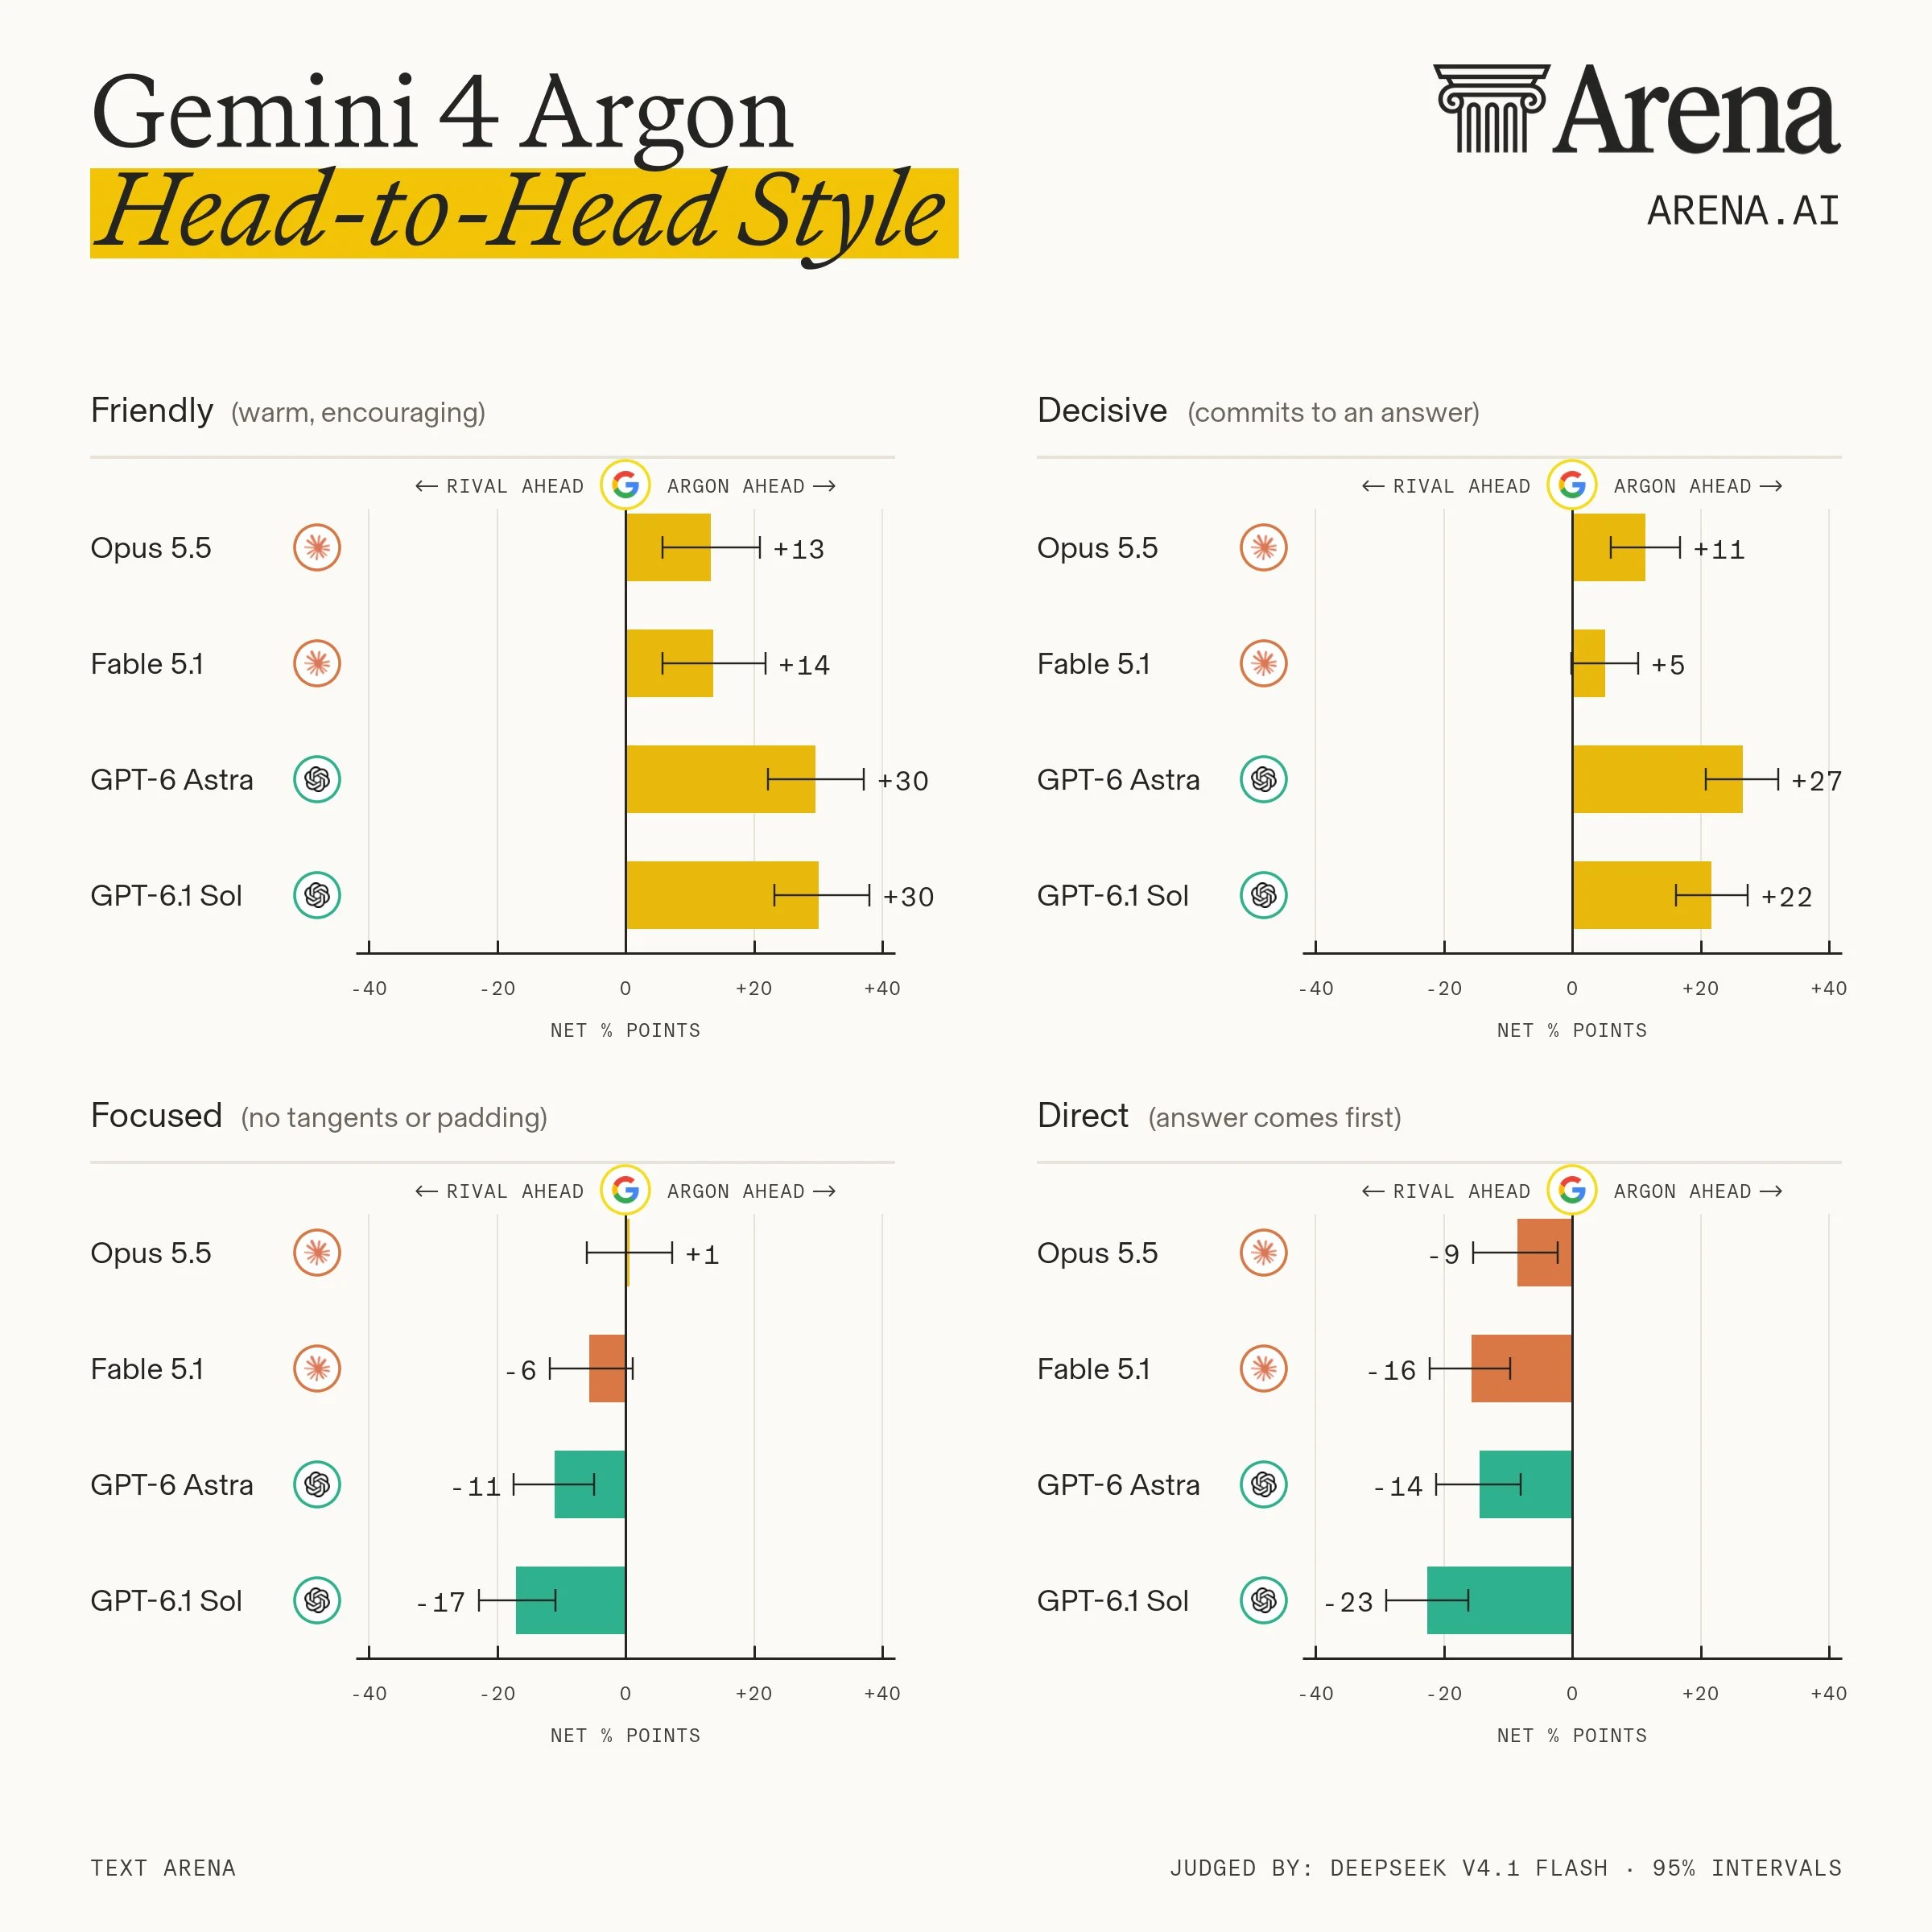
Les battles de Text Arena montrent :
- la nouvelle version de @GoogleDeepMind est plus amicale et plus tranchée. Elle conserve un ton chaleureux, encourageant et clair. Face à GPT-6.1 Sol, le juge IA a jugé Argon plus amicale dans 55% des comparaisons et Sol dans seulement 25%. Face à Opus 5.5, c'est 46% contre 32%.
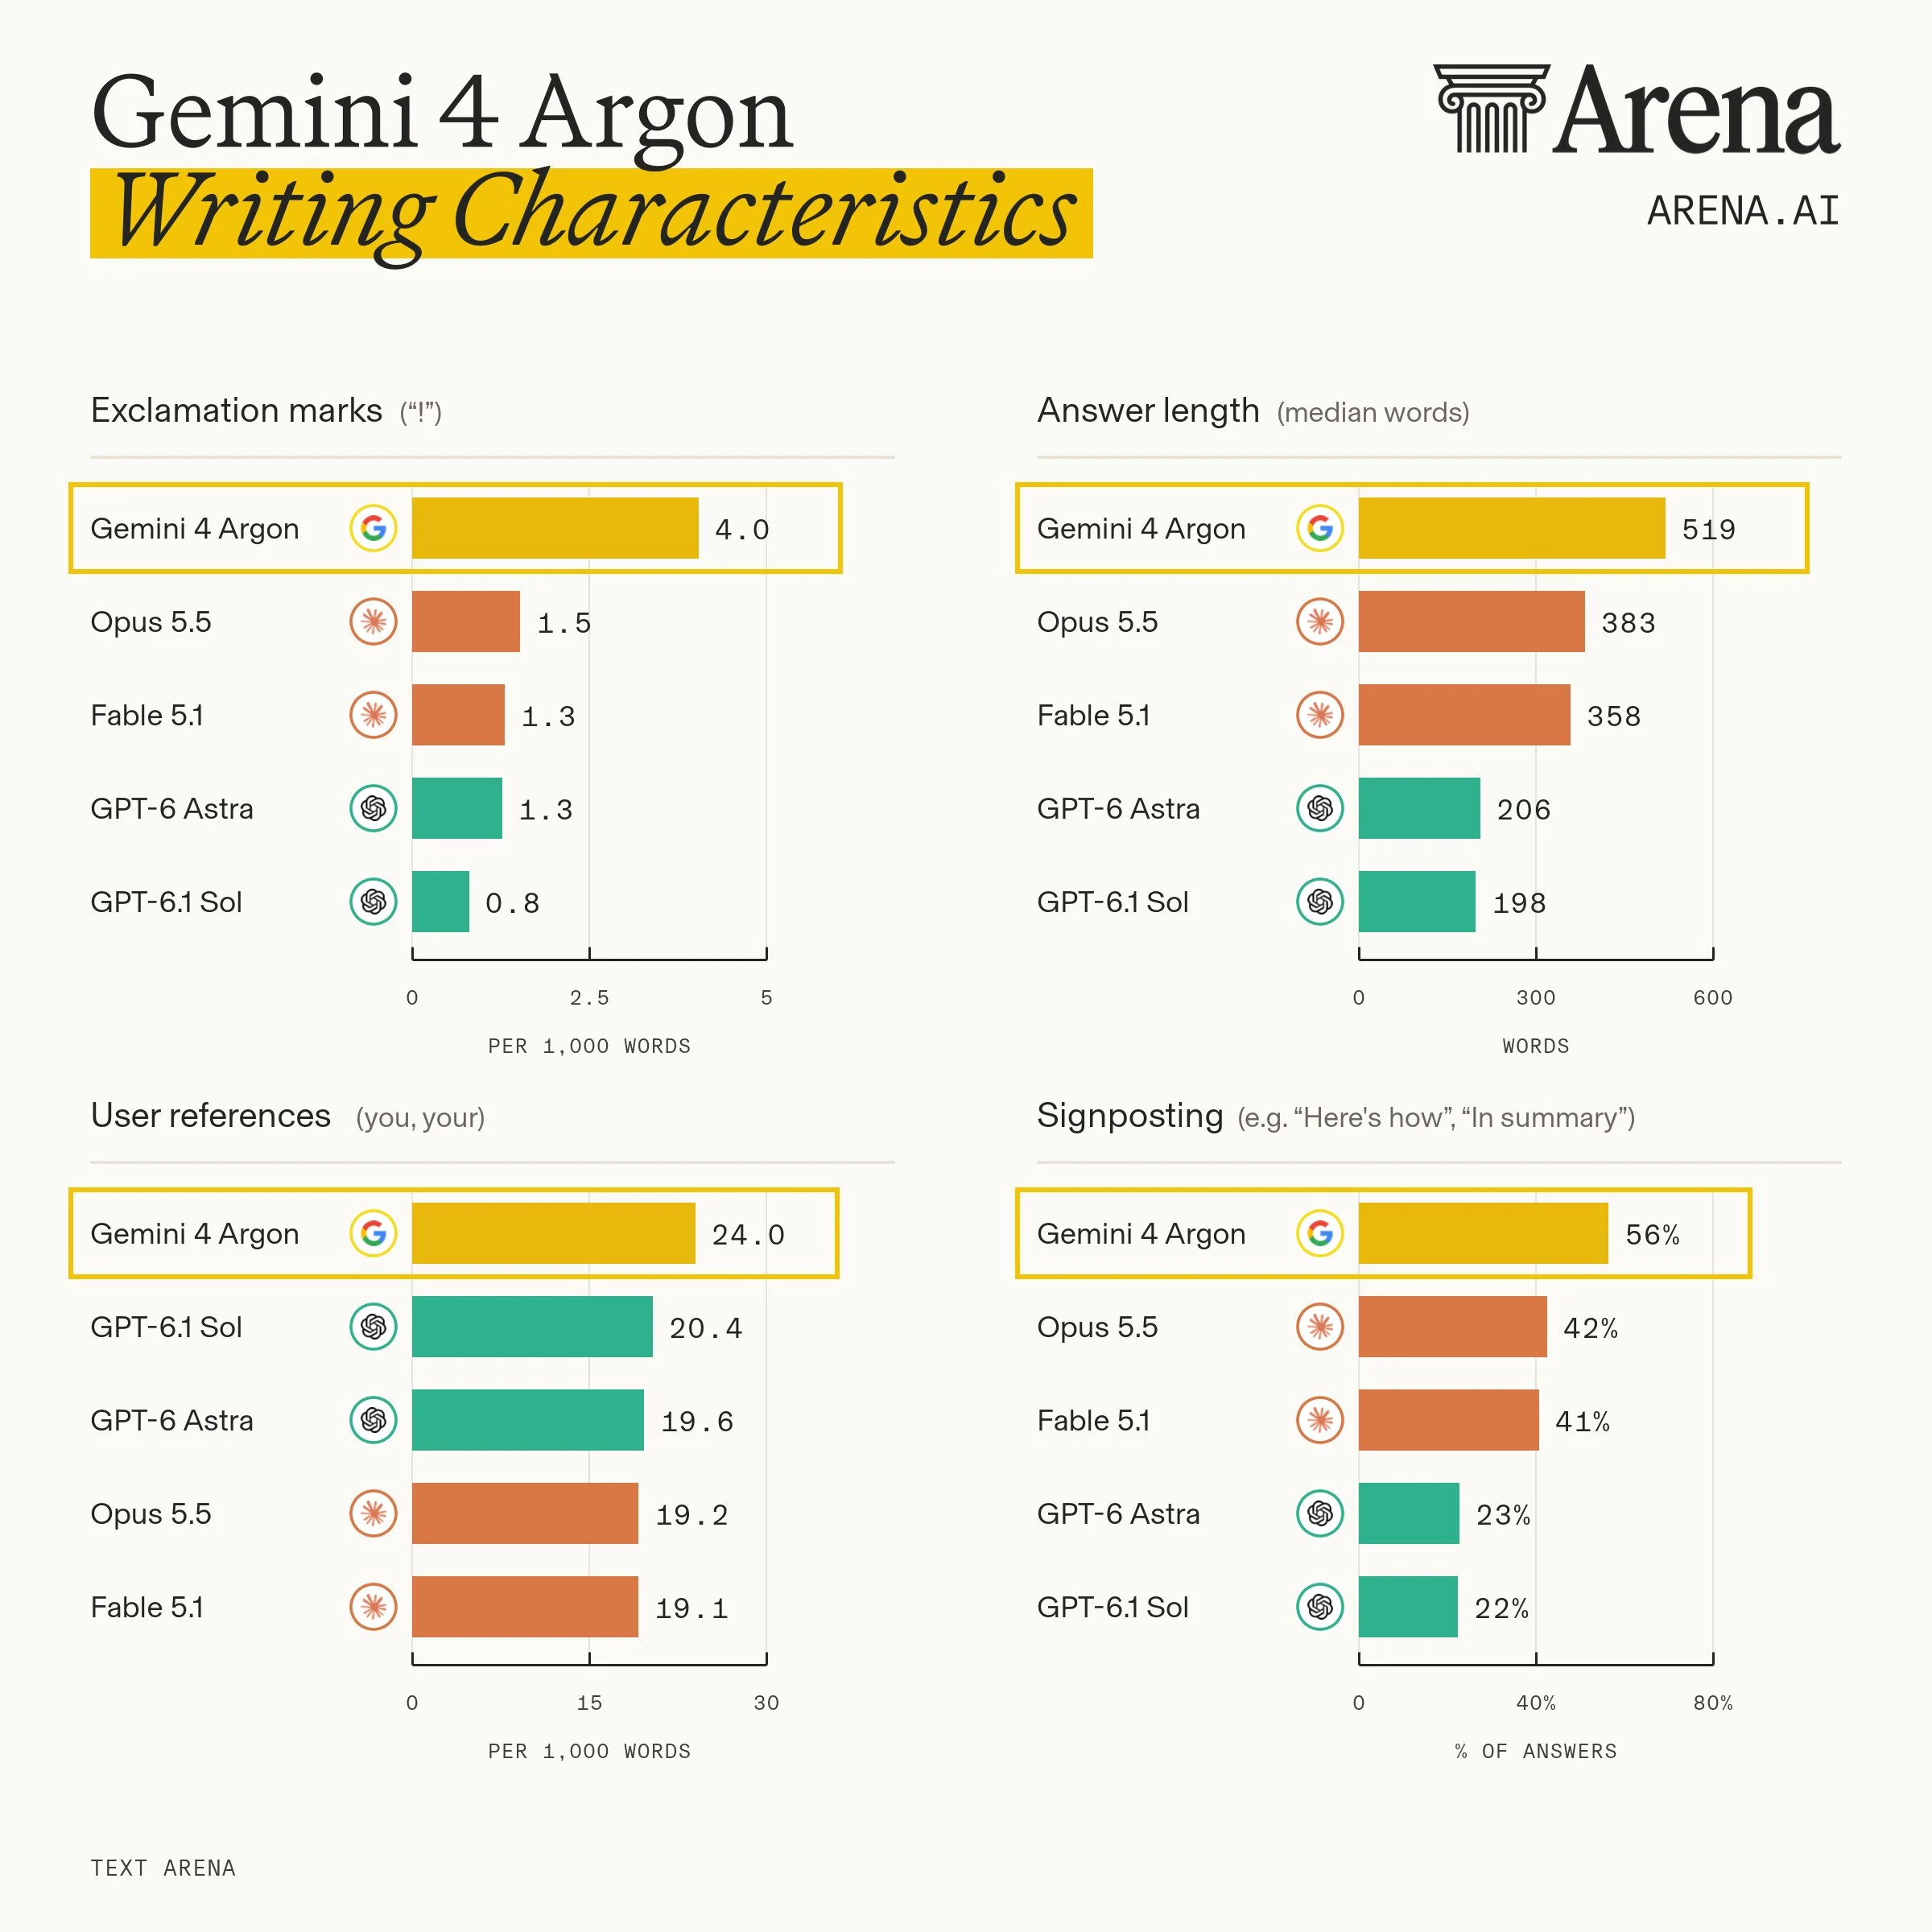
- Elle est plus conversationnelle : le modèle part plus souvent en digressions et est moins direct. Les réponses des concurrents ont été jugées plus directes dans 32-37% des comparaisons, celles d'Argon dans seulement 14-23%. Cela se reflète aussi dans la longueur de ses réponses : la réponse médiane d'Argon compte 519 mots, contre 358-383 pour Claude et environ 200 pour les modèles GPT.
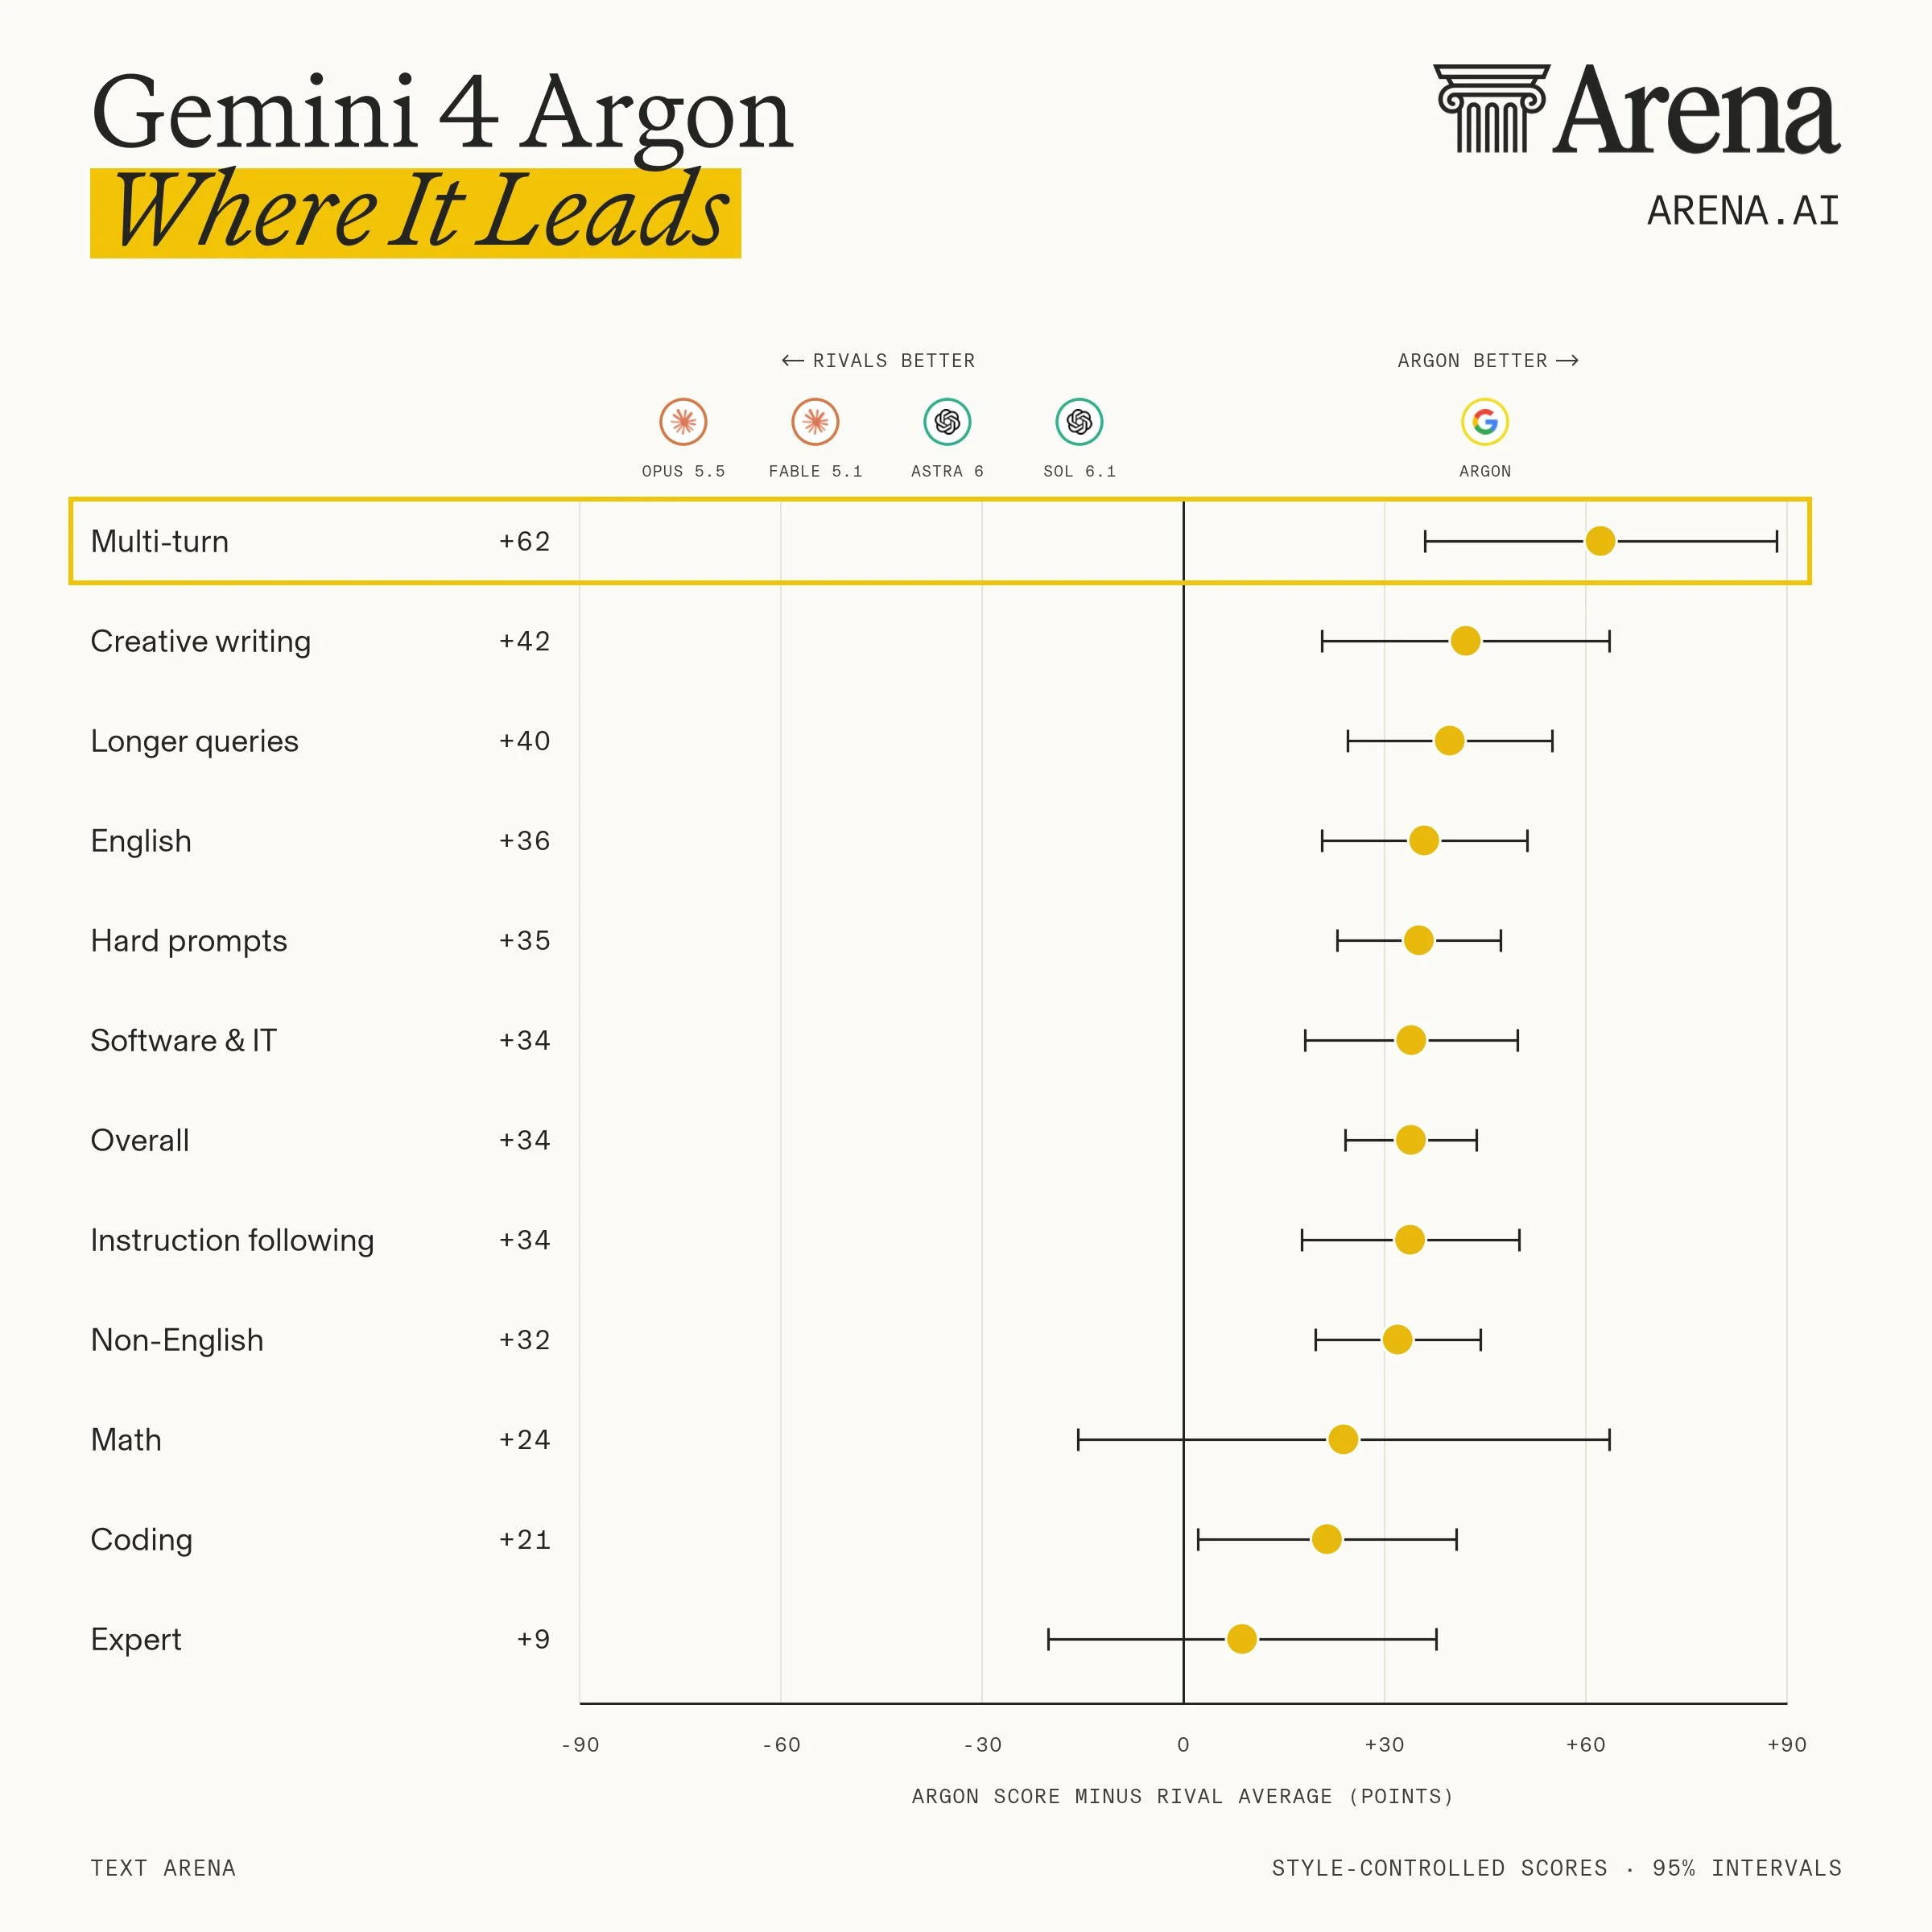
- Ces comportements se retrouvent dans les votes des utilisateurs. Argon possède le plus grand avantage dans les conversations multi-tours (+62 points), l'écriture créative (+42) et les requêtes plus longues (+40), les catégories où une telle personnalité compte le plus.
- Les marqueurs les plus évidents de son style accessible sont son usage des points d'exclamation (environ 3x Opus 5.5 et 5x GPT-6.1 Sol), ses références à l'utilisateur (24 pour 1,000 mots, contre 19-20 pour chaque concurrent) et ses balisages (56% de ses réponses, contre 41-42% pour Claude et 22-23% pour les modèles GPT).