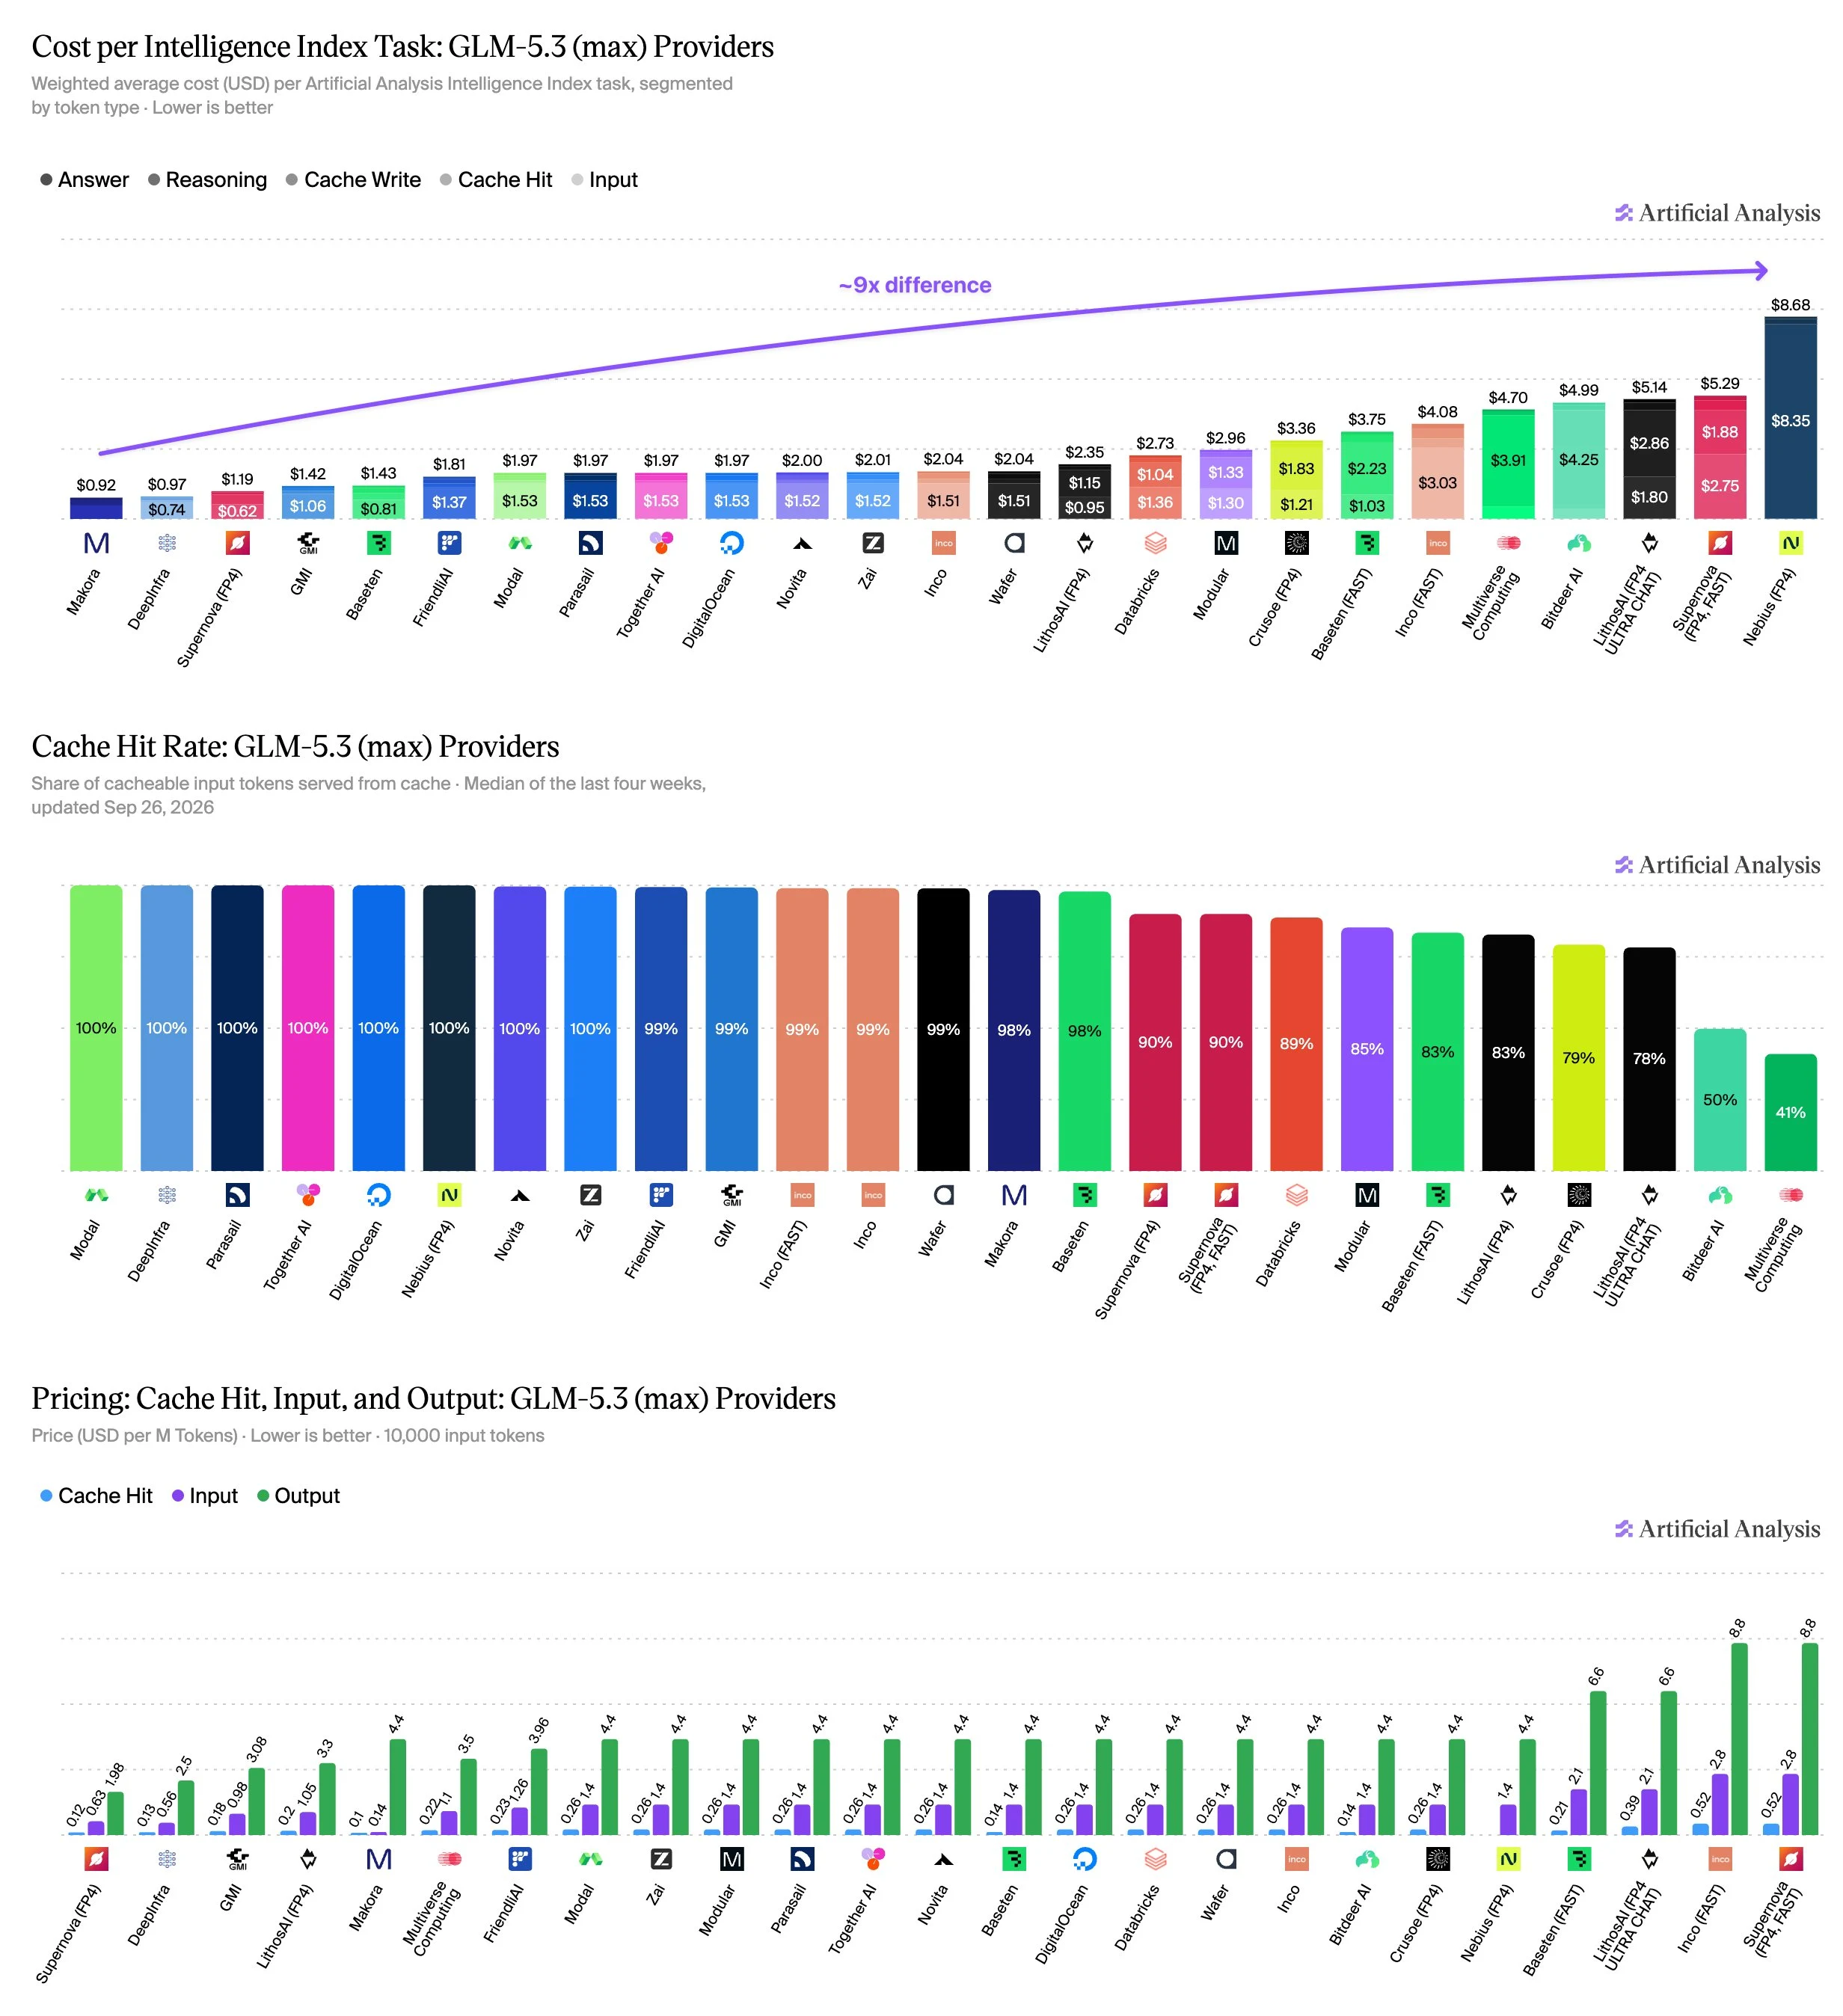
Taux de réussite du cache et Coût par tâche selon le fournisseur sont maintenant disponibles sur Artificial Analysis : Coût par tâche pour GLM-5.3 (max) varie environ 9 fois entre les fournisseurs, en raison d'une combinaison de taux de réussite du cache et de tarification des tokens
Les charges de travail agentiques renvoient l’intégralité du historique de conversation à chaque tour, de sorte que la plupart des tokens d’entrée sont pouvant être mémorisés dans la cache. Les tarifs de la mise en cache et les taux de réussite de la mise en cache expliquent la majorité de l’écart dans le Coût par tâche. Nous utilisons déjà les taux de réussite de la mise en cache mesurés pour calculer le Coût par tâche, et nous les publions désormais pour chaque point d’entrée de modèle que nous suivons.
Quoi de nouveau :
➤ Les taux de réussite du cache sont désormais visibles pour tous les endpoints de première et troisième partie, en mesurant les tâches de codage agentique multi-tour et en lisant les tokens stockés dans le cache provenant de chaque fournisseur. Le taux de réussite du cache représente la part des tokens d’entrée pouvant être stockés dans le cache.
➤ Le coût par tâche est désormais disponible pour chaque fournisseur pour les modèles à poids ouvert, calculé à partir des coûts d’entrée, de sortie, de réussite du cache et d’écriture du cache de chaque fournisseur, appliqués au taux de réussite du cache mesuré. Pour standardiser entre les fournisseurs pour un même modèle, nous utilisons les mêmes comptes d’entrée, de sortie et de tokens pouvant être stockés dans le cache tirés de l’Indice d’Intelligence du modèle.
Points clés:
➤ Le coût par tâche sur GLM-5.3 (max) varie de 9 fois entre les fournisseurs : de 0,92 $ pour Makora à 8,68 $ pour Nebius. Les deux offrent près de tous les données stockées dans la cache (98 % et 100 %) et facturent la même prix de sortie ($4,40 par 1 M de tokens), donc l’écart provient des tarifs des entrées : Makora facture 0,10 $ par 1 M de tokens de données stockées, tandis que Nebius ne propose aucune réduction pour les entrées stockées sur ses endpoints sans serveur partagés et facture tous les tokens au prix complet de 1,40 $.
➤ Le taux de réussite de la mise en cache varie de 41 % à 100 % entre 21 fournisseurs (25 endpoints). 15 endpoints atteignent 98 % ou plus, et huit atteignent 100 % : Modal, DeepInfra, Parasail, Together AI, DigitalOcean, Nebius, Novita et l’API de Z AI. Multiverse Computing a le taux le plus bas à 41 %, suivi par Bitdeer à 50 %.