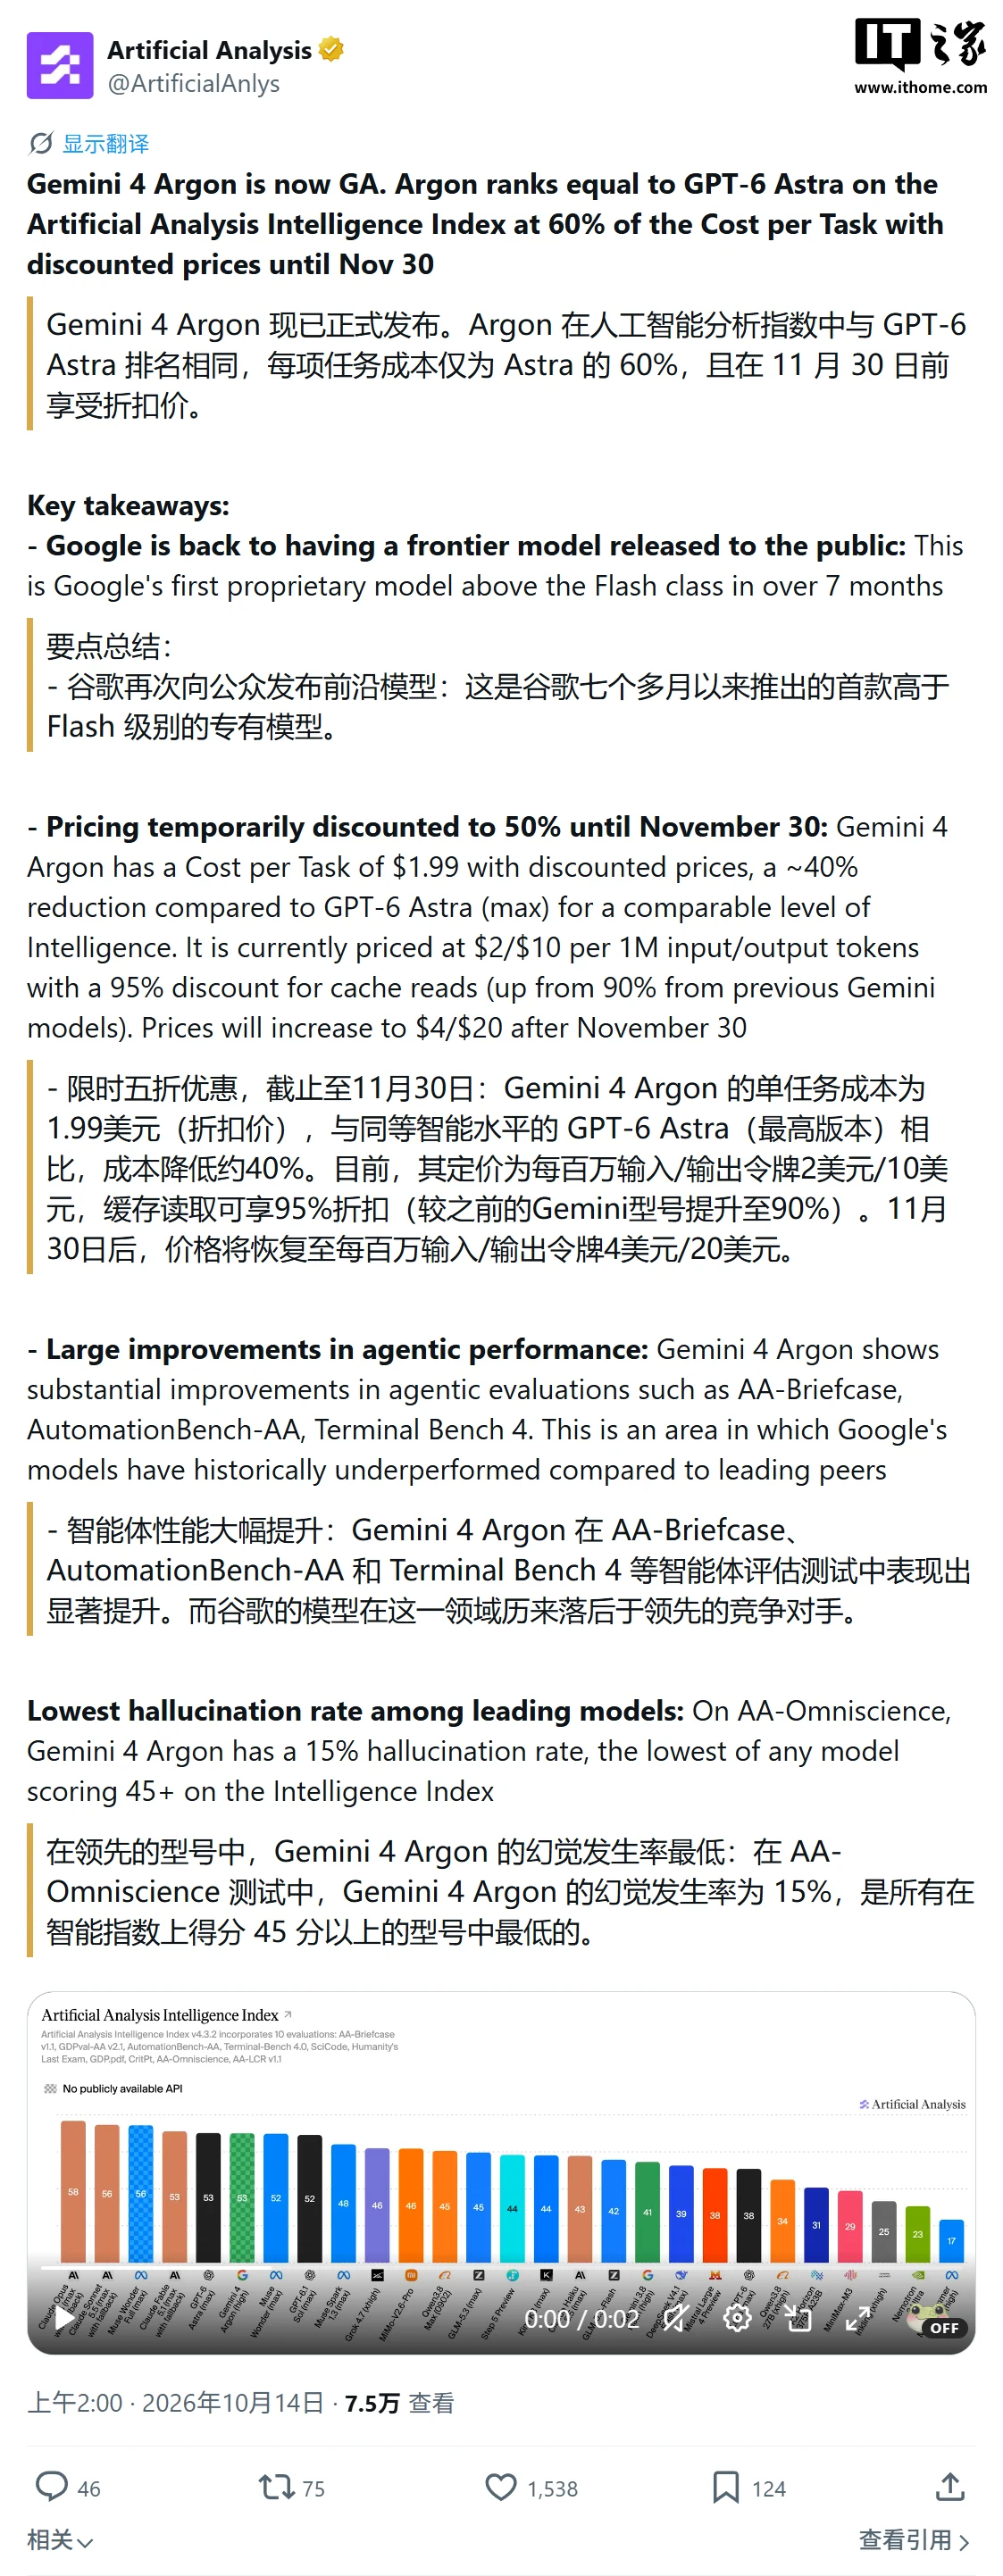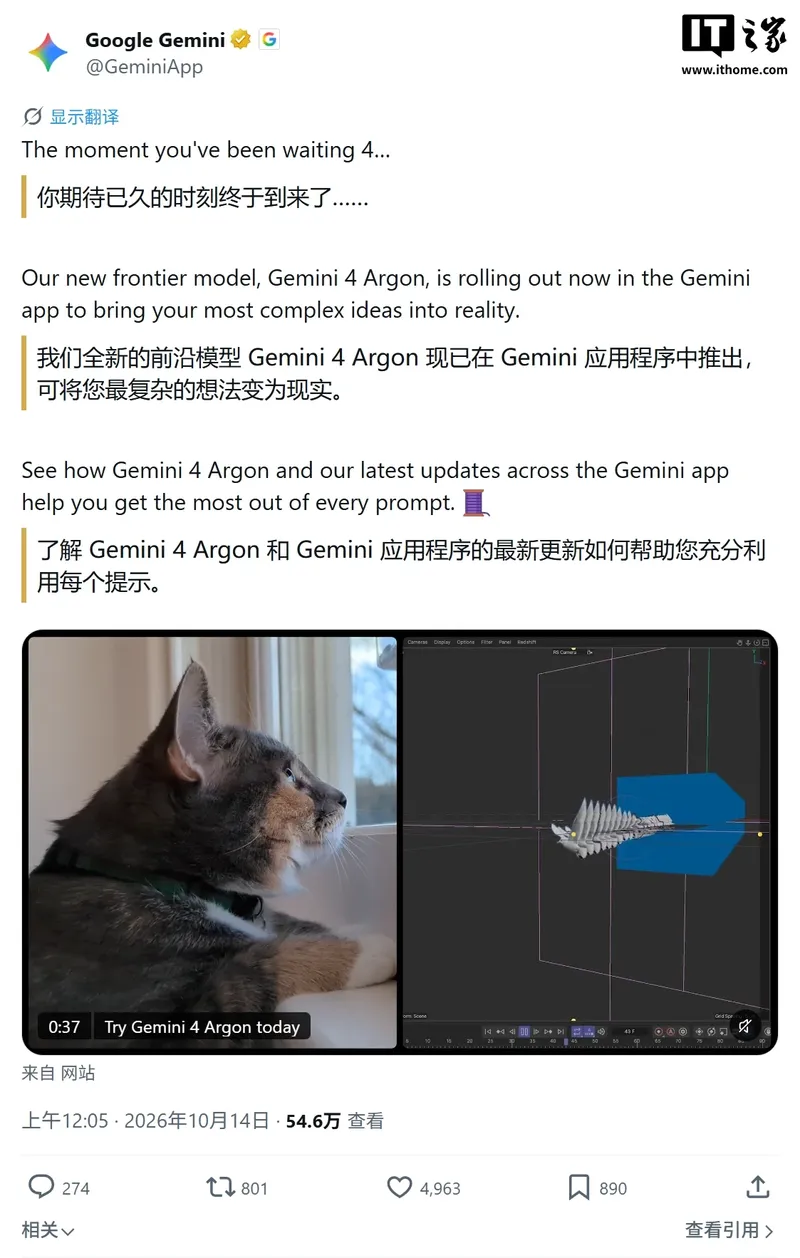
IT之家 Le 14 octobre, Gemini 4 Argon est désormais ouvert aux développeurs et entreprises du monde entier. Il peut être utilisé via l’AI Studio et les API de la plateforme Gemini. Il est également disponible pour les abonnés Google AI Ultra de Google Antigravity, ainsi que pour les abonnés Google AI Ultra et Pro de l’application Gemini et du mode recherche AI.
Le prix d’accès limité pour ce modèle est actuellement le suivant (en taux de change : 1 dollar le 14 octobre 2026 (à l’équivalent du taux de change actuel, environ 6,7 yuans) ≈ 6,6921 yuans) :
Chaque million de tokens coûte 2 dollars (Note de IT Home : le taux de change actuel équivaut à environ 13,4 yuans chinois)
Output : 10 dollars par million de tokens (en valeur de change actuelle, environ 66,9 yuans)
Entrée en cache : 0,1 dollar par million de Tokens (environ 0,7 yuan selon le taux de change actuel)
Le 30 novembre 2026, après la fin de la promotion d’initiation, le tarif est ajusté à :
Entrée : 4 dollars par million de Tokens (environ 26,8 yuans selon le taux de change actuel)
Output : 20 dollars par million de Tokens (soit environ 133,8 yuans au taux de change actuel)
Entrée en cache : 0,2 dollar par million de Tokens (soit environ 1,3 yuan au taux de change actuel)
Gemini 4 Argon est doué pour traiter des tâches complexes dans des domaines tels que l’encodage, la finance, le droit, la sécurité informatique et les sciences. Sa profondeur et sa précision dans les tâches multiétapes lui permettent de surpasser d’autres modèles de pointe dans les tests de référence dans plusieurs domaines. Actuellement, il occupe la première place dans l’Index Vals, qui mesure les performances des modèles dans des domaines économiques clés tels que la finance, l’encodage, le droit et la fiscalité.
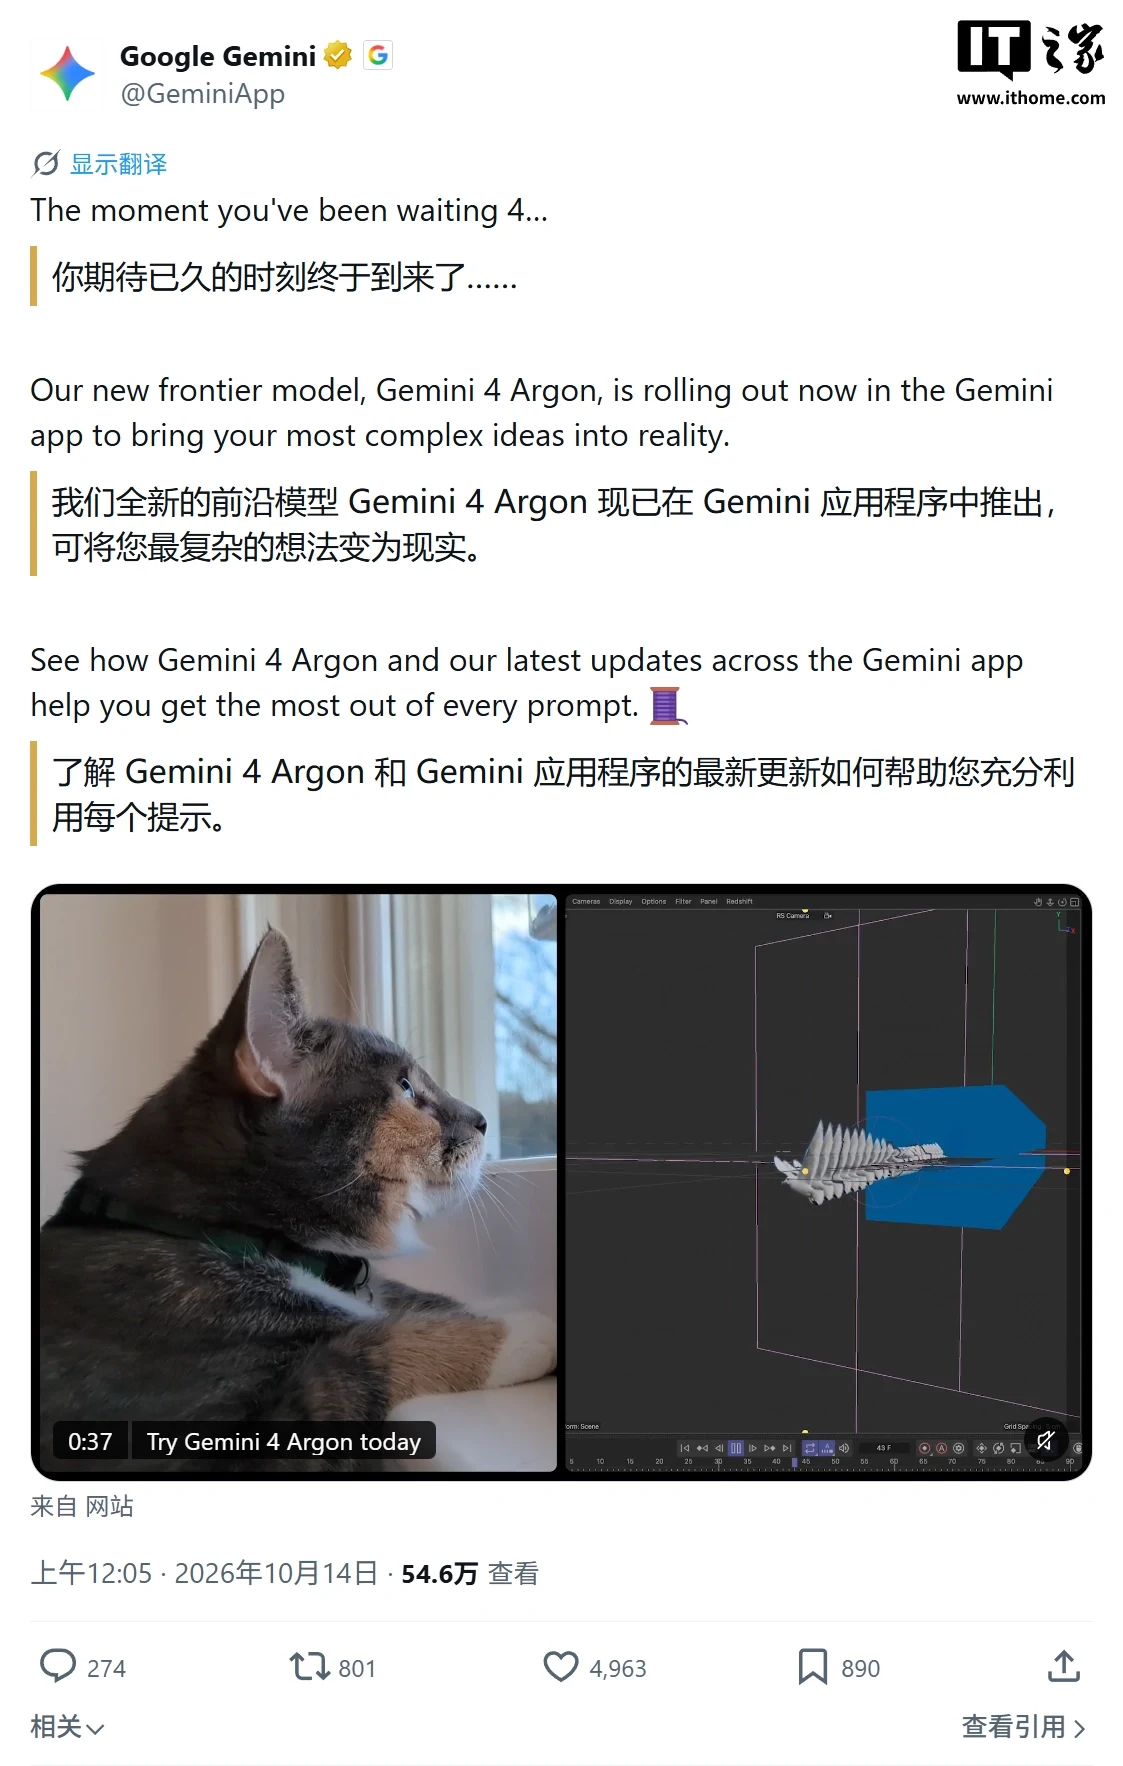
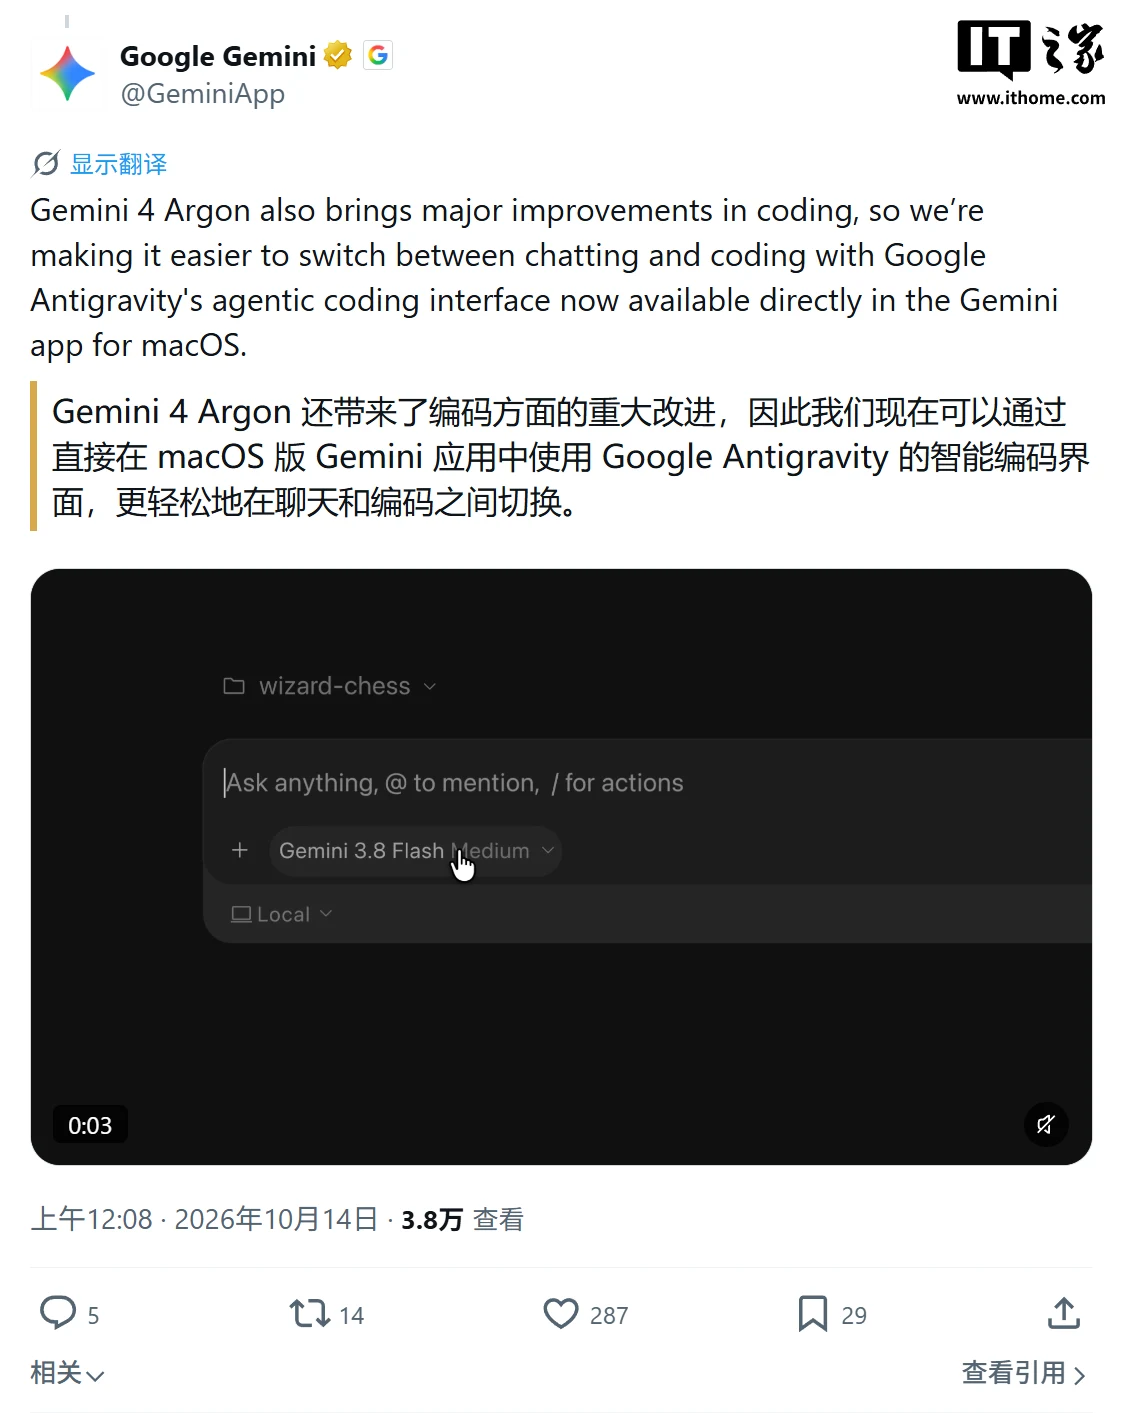
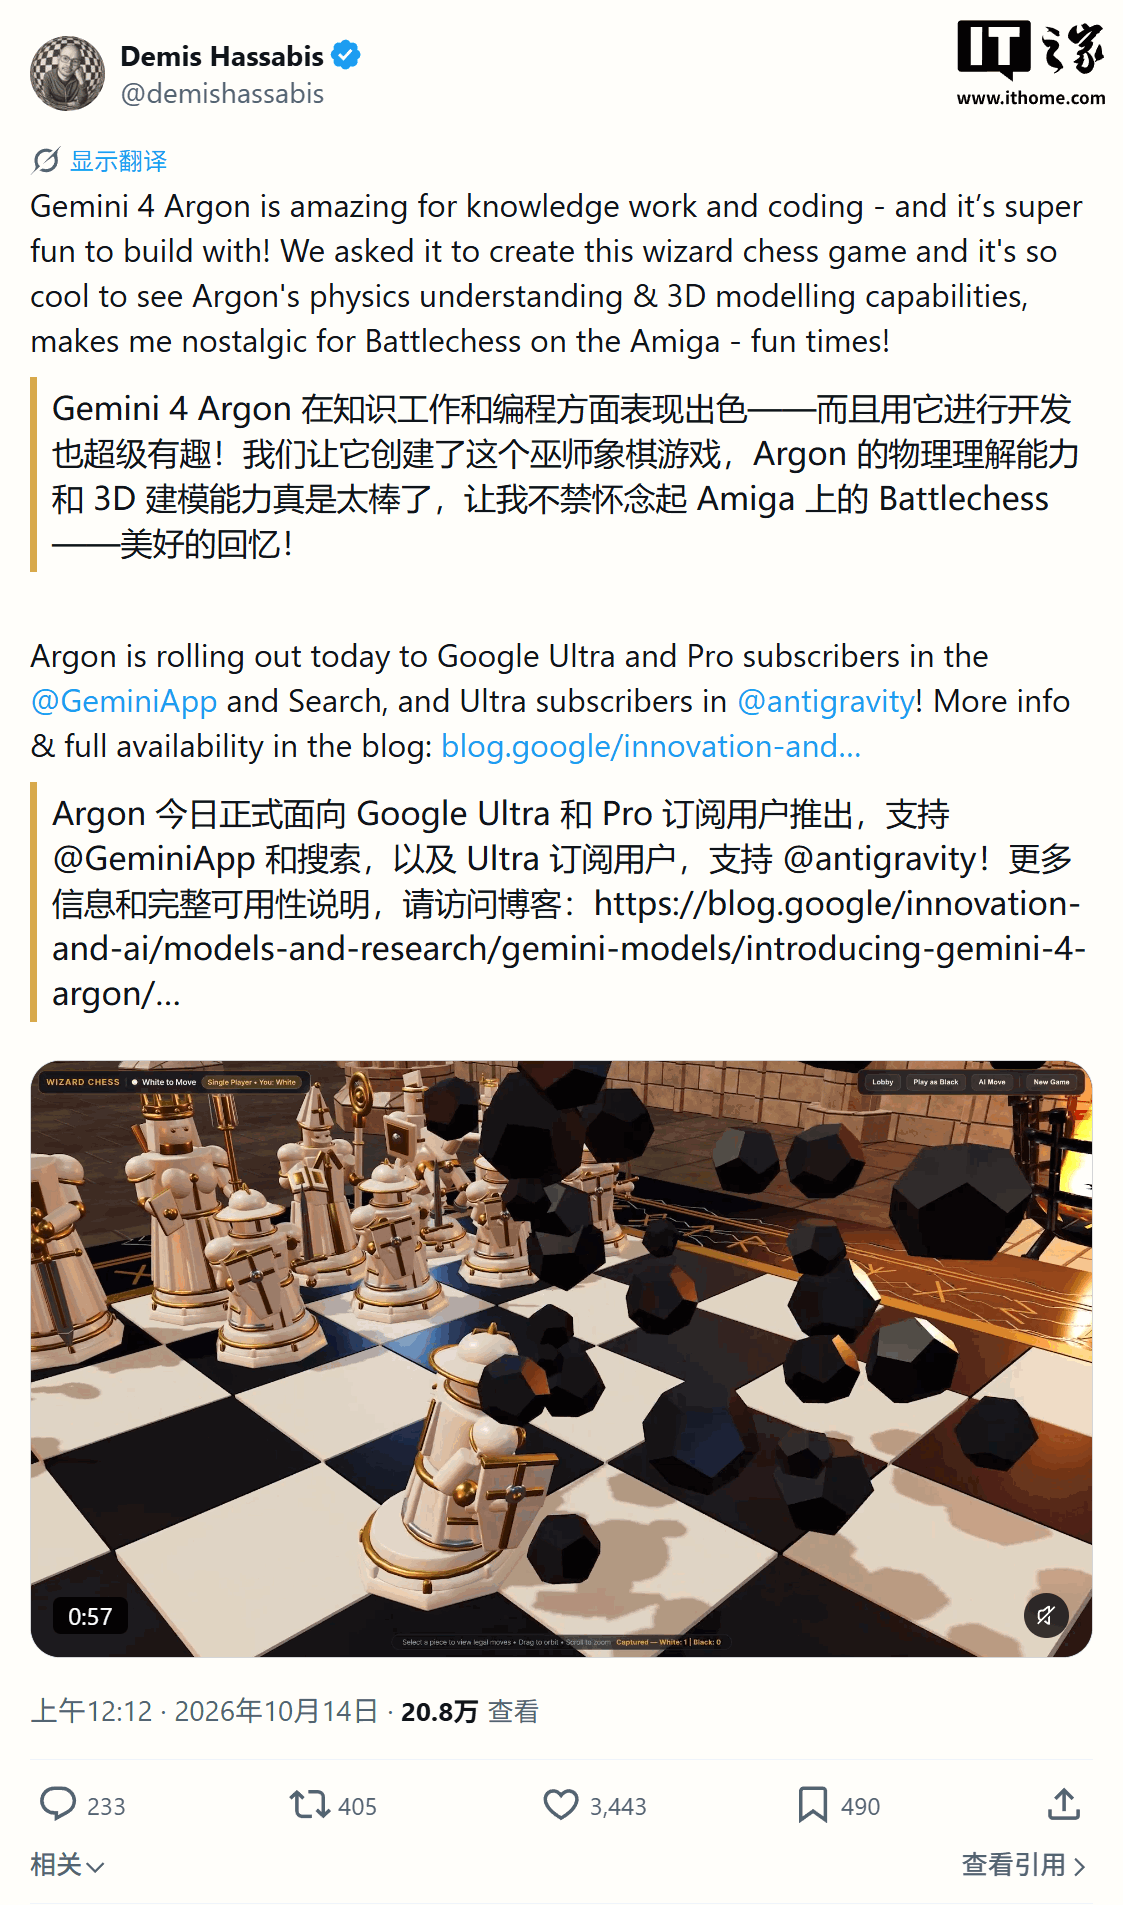
Les entreprises et les équipes de recherche internes et externes à Google ont commencé à utiliser ce modèle pour résoudre divers problèmes, y compris l’optimisation des flux de travail dans les domaines tels que la refonte et l’amélioration de gros bibliothèques de code, l’optimisation juridique et financière, la découverte et la correction de vulnérabilités critiques de la sécurité informatique, ainsi que la promotion de nouveaux progrès dans des domaines tels que le calcul quantique, la fusion nucléaire et les sciences de la vie.
Dans le domaine de l'ingénierie, ce modèle a aidé l'équipe Chrome à réaliser une refonte architecturale de dizaines de millions de lignes de code, réduisant ainsi le travail qui nécessiterait plusieurs mois à quelques semaines ; il a également optimisé automatiquement les performances du projet open source en une nuit, diminuant le temps de préparation des sessions en mémoire de 40 % et accélérant la vitesse d'importation froide de 21 %.
Dans le domaine de la recherche scientifique, Google offre à 10 000 scientifiques un accès gratuit au niveau de utilisation le plus élevé de Google Antigravity pendant 6 mois. Le processus de demande est actuellement ouvert. En matière de sécurité informatique, Google a élargi le cercle des partenaires du projet Fairwind, permettant ainsi davantage de spécialistes en défense de la cybersécurité d’utiliser ce modèle pour détecter et corriger les vulnérabilités.
En matière de sécurité, Google a déployé un système de défense à plusieurs niveaux pour ce modèle, avec des améliorations significatives en matière de résistance à la fuite, de protection contre les injections de prompts et de surveillance de l’alignement des agents. Le taux de violations liées aux requêtes nocives est presque moitié moins élevé que pour les modèles précédents de Gemini.
En termes d’entrée et de sortie, le dernier modèle de Gemini 4 Argon permet une sortie de décodification longue atteignant jusqu’à 1 048 576 tokens (environ 1 million de tokens), mais l’entrée, la réflexion et la sortie utilisent tous ensemble une fenêtre de contexte de 1 million de tokens.