
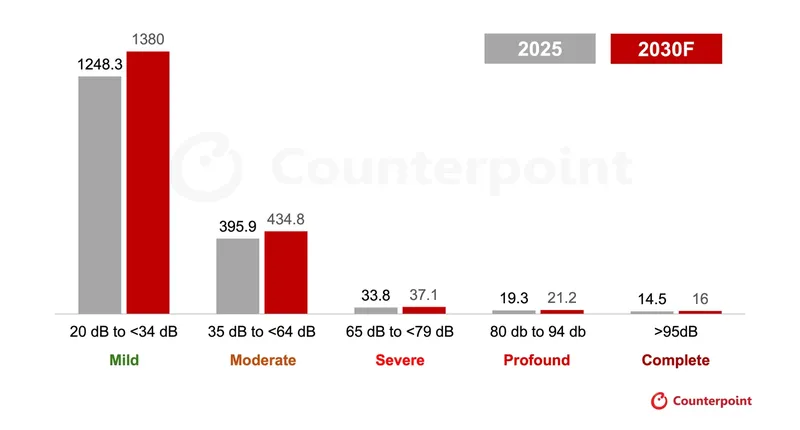
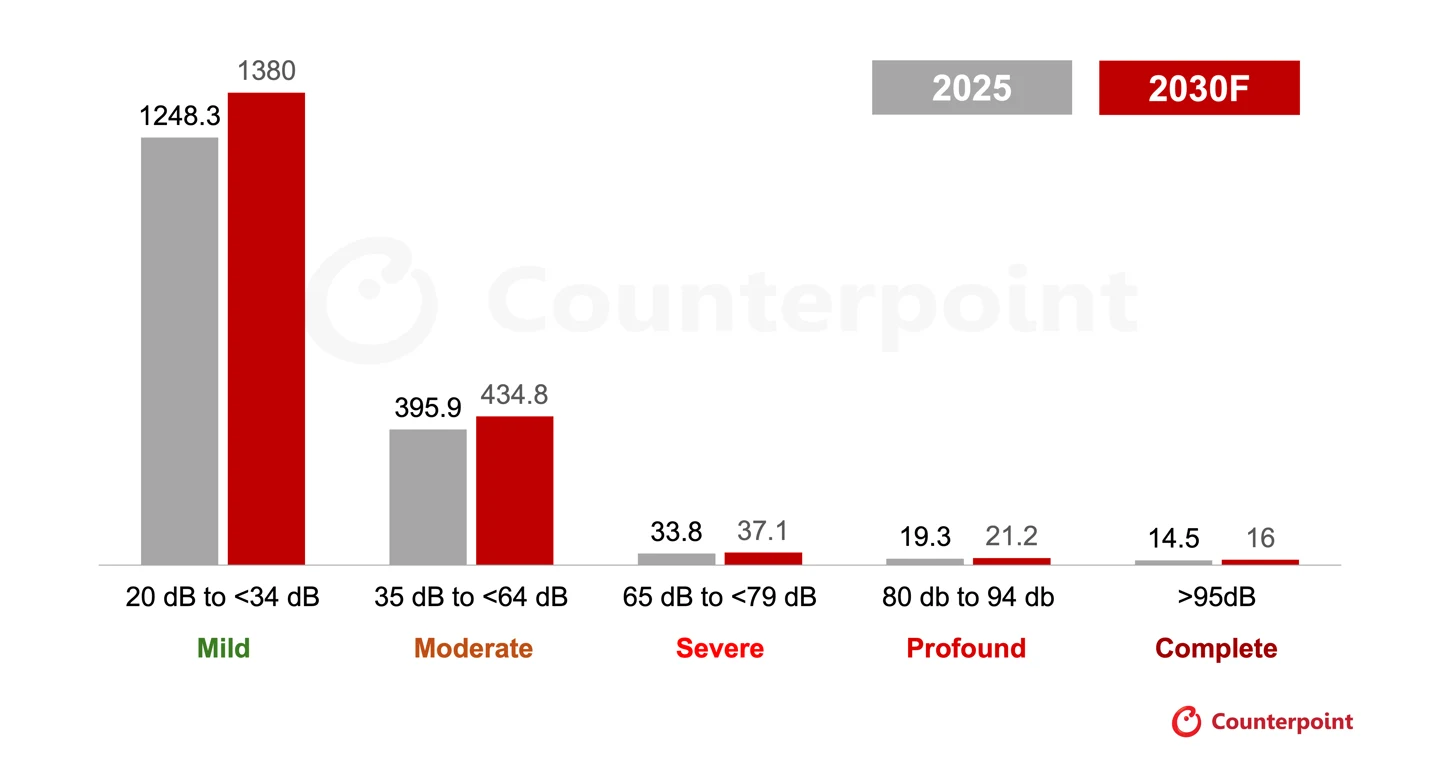
IT之家 – Le 14 octobre, selon le rapport Counterpoint « Prévisions des dispositifs portables d’IA globale », d’ici 2030, les ventes mondiales de prothèses auditives prescrites devraient dépasser 31 millions de unités, avec une croissance annuelle composée de 4 % entre 2025 et 2030. Avec la généralisation de l’utilisation de l’IA dans le domaine des prothèses auditives, on estime qu’en 2030, près de 50 % des produits de prothèses auditives intégreront des capacités d’IA portée.
Au fil des années, les appareils auditifs ont continué à progresser en termes de taille, de connectivité et de autonomie, mais le problème fondamental reste le même : les utilisateurs ont du mal à entendre les conversations dans des environnements bruyants. Les appareils auditifs traditionnels dépendent principalement du traitement du signal numérique (DSP) : le micro capte le son de l’environnement, le processeur analyse les caractéristiques de fréquence et de volume, puis décide via des algorithmes prédéfinis quels sons amplifier ou réduire. Ce système fonctionne bien pour des bruits stables comme les climatiseurs ou les moteurs, mais les situations réelles sont souvent plus complexes. Par exemple, dans un restaurant bondé, plusieurs dialogues, musique et bruits de couverts se produisant en même temps, les systèmes basés sur des règles ont du mal à déterminer quelle voix le utilisateur souhaite vraiment entendre.
L’IA offre une solution complètement différente : les modèles d’IA ne dépendent pas de règles prédéfinies, et peuvent apprendre à distinguer les voix humaines des autres sons. Grâce aux réseaux de neurones profonds (DNN) entraînés sur des millions de groupes de données de voix humaines et de bruit de fond, il est possible d’identifier en temps réel la voix du parlant et d’éliminer le bruit indésirable.
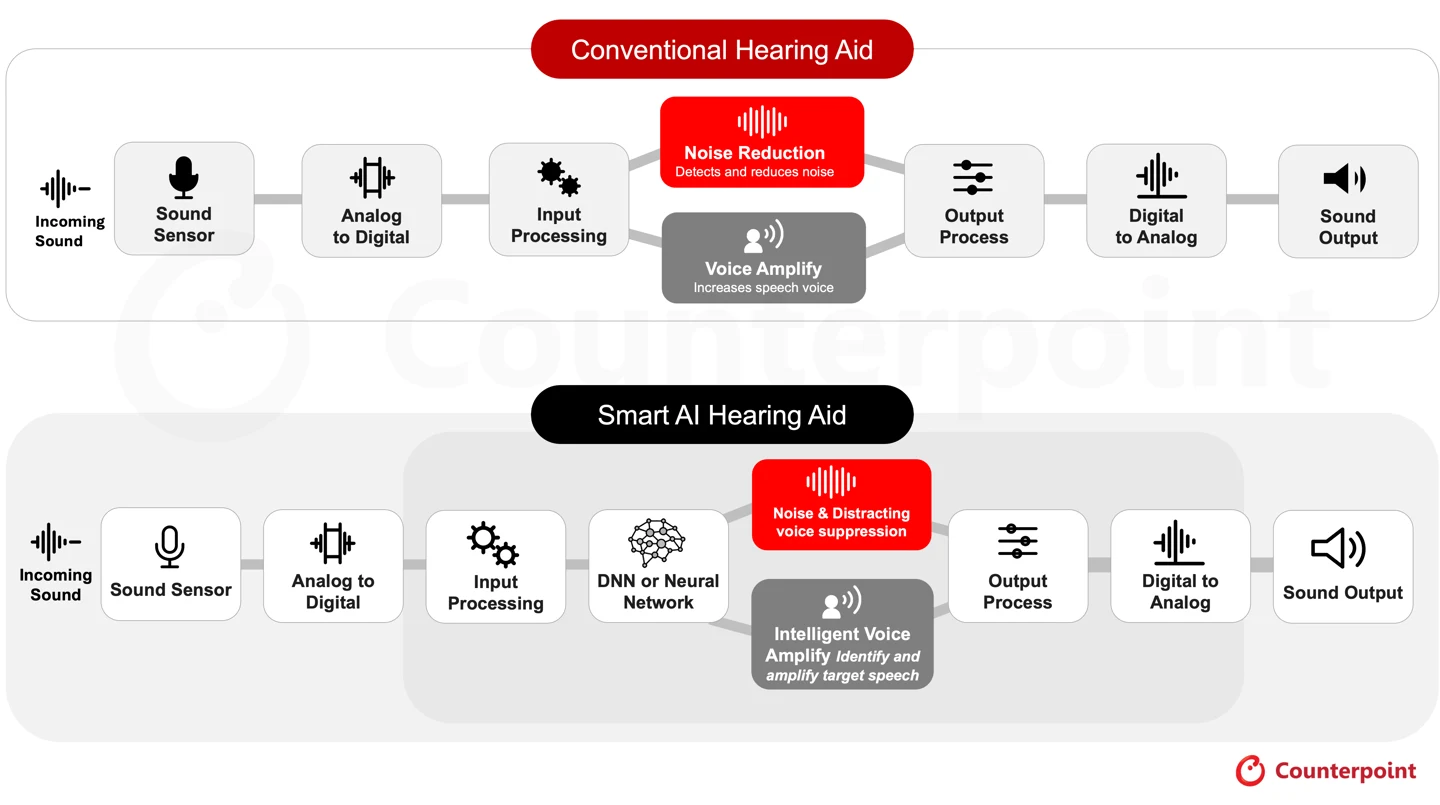
L’IA peut améliorer la capacité de reconnaissance vocale des appareils auditifs dans un environnement réel, en séparant le voix humaine du bruit, en mettant en avant prioritairement le parlant cible, en renforçant la perception spatiale et en s’adaptant continuellement aux changements de l’environnement. L’IA est particulièrement douée pour distinguer des sons subtils et confus tels que « s », « f », « t », « sh » et « th ». Elle peut également aider les utilisateurs à distinguer des chiffres comme 15 et 50, 17 et 70 (Note de IT Home : en anglais, fifteen et fifty se prononcent de manière similaire). En conservant ces caractéristiques sonores précises, l’IA peut non seulement augmenter le volume, mais aussi améliorer la compréhension vocale dans des contextes tels que les restaurants, les réunions ou les rues bondées.
Dans les tests de reconnaissance vocale « bruit clinique », les auditeurs ayant une audition normale ont généralement besoin d’un rapport signal/bruit (SNR) d’environ 2 dB pour reconnaître correctement 50 % des mots-clés ; pour les auditeurs présentant une perte auditive sensorineurophonique légère à modérée, ce besoin atteint environ 8 dB, et l’IA permet justement d’apporter une amélioration mesurable au niveau du rapport signal/bruit. Selon les tests de Phonak, avec la direction fixée vers le micro et les paramètres traditionnels, le rapport signal/bruit peut être augmenté de 6,4 dB par rapport aux micros omnidirectionnels ; avec l’technologie de réduction de bruit par intelligence artificielle, l’amélioration atteint 9 dB par défaut, et jusqu’à 10,2 dB avec les paramètres maximaux, ce qui permet aux utilisateurs de communiquer sans difficulté dans des scénarios de restaurant.
L’IA peut également rendre les appareils auditifs plus automatisés et personnalisés : l’apprentissage automatique permet aux appareils de ajuster l’interprétation sonore en fonction des préférences de l’utilisateur et du contexte d’écoute, réduisant ainsi les ajustements manuels et le fardeau cognitif nécessaire pour suivre une conversation. En conséquence, on observe moins de fatigue auditive et moins de besoin de questions répétées, ce qui augmente la confiance de l’utilisateur dans ses interactions quotidiennes. Cependant, ces améliorations ne sont pas sans coûts : le fonctionnement continu des réseaux de neurones consomme de l’énergie de la batterie et occupe de l’espace sur l’appareil. Par conséquent, les appareils auditifs dotés d’IA les plus performants offrent souvent seulement une petite variété de modèles.
Les appareils auditifs ont des exigences très élevées en matière de retard de traitement : du collecte du son jusqu’à l’exécution du traitement et la transmission au tympan, tout ce processus doit être contrôlé dans 10 millisecondes ou moins pour garantir une expérience naturelle. Cela crée une différence fondamentale entre les appareils auditifs et la plupart des dispositifs AI — les smartphones peuvent télécharger les données sur le cloud, attendre que l’IA fournisse les résultats avant de les traiter, mais les appareils auditifs ne peuvent pas supporter un retard de retour vers le cloud, même un petit retard peut entraîner une désynchronisation entre l’audition et la vision, ou faire que la voix du utilisateur semble inappropriée.
Par conséquent, le traitement audio en temps réel exige que l’IA fonctionne localement sur les appareils auditifs, et non sur le téléphone ou en nuage, ce qui constitue la valeur fondamentale de l’IA côté client : le son est analysé et traité localement, près du micro et du récepteur.
La difficulté réside dans le fait que la capacité de batterie des appareils auditifs est très faible, leur capacité de calcul est limitée et les contraintes de taille sont strictes. Pour intégrer les capacités d’IA dans de tels appareils, il est nécessaire d’optimiser au maximum les modèles d’IA et le processeur afin de réduire la consommation d’énergie, tout en réalisant la séparation du son et le réductionnisme du bruit. Le fonctionnement continu de la réseau de neurones réduit significativement la durée de vie de l’énergie : par exemple, pour le Peugeot 2025 Audéo Infinio Ultra Sphere, la durée de vie à usage normal est de 56 heures, mais si les fonctionnalités AI sont activées en permanence, la durée de vie chute drastiquement à 10 heures. Cela montre également de manière intuitive le coût lié au fonctionnement local des AI.
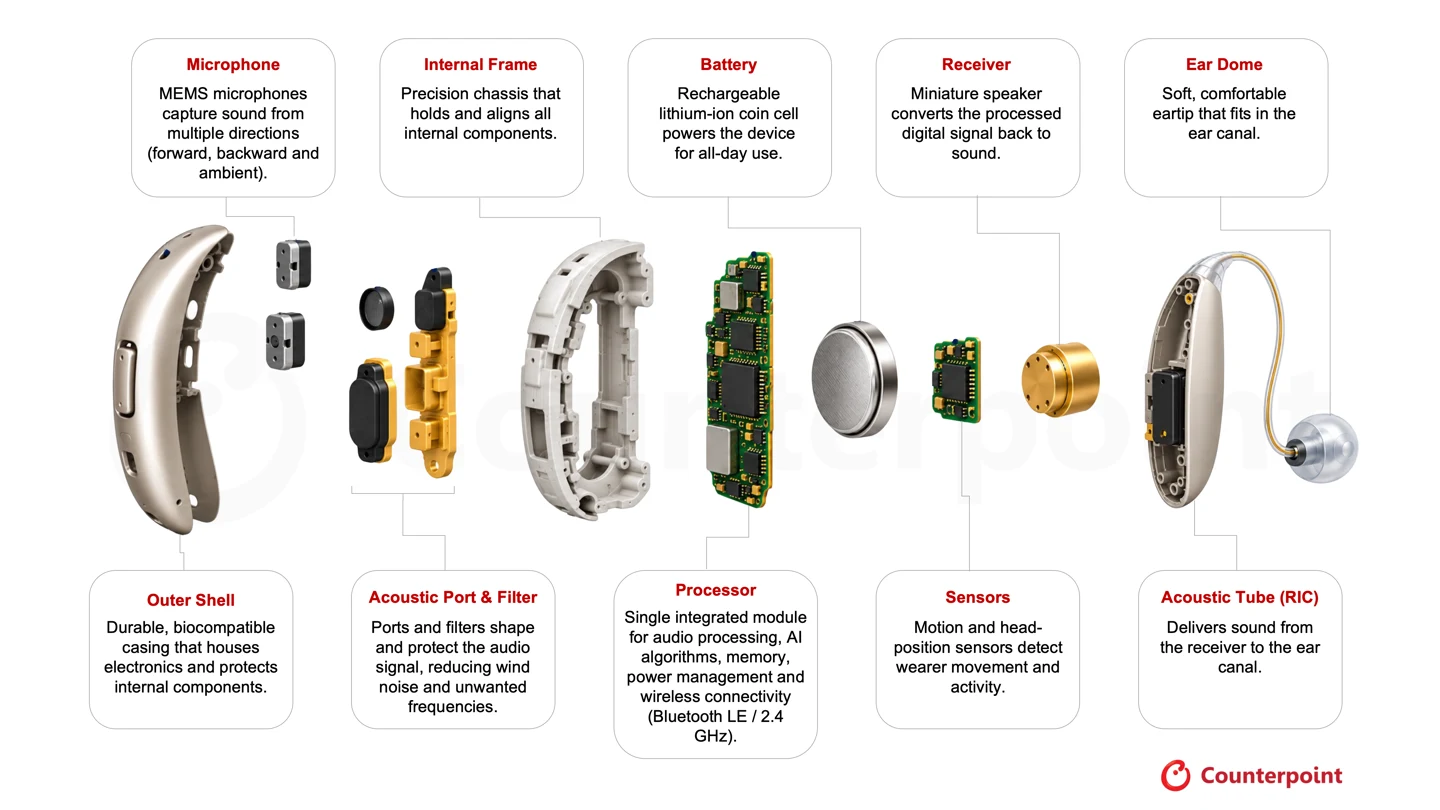
L’intégration de l’IA côté client rend les appareils auditifs « intelligents », mais une intégration efficace reste un défi important dans le développement : chaque petit gain en clarté vocale nécessite des coûts en autonomie et en espace, et les données des produits PowerAid illustrent également ce coût de manière intuitive. La force principale des prochains appareils auditifs réside dans la capacité à faire fonctionner l’IA en silence en arrière-plan, afin de fournir une voix plus claire, un chargement moins élevé et une expérience auditive plus personnalisée, sans consommer trop d’énergie ni augmenter la taille du appareil. La industrie a déjà entamé cette compétition technologique.