
Yun Zhong, provenant du cofré non-temple
Quantum Bit | Publique de compte QbitAI
Plus les données sont collectées, le robot pourra-t-il devenir de plus en plus compétent dans son travail ?
Cette année, en utilisant plus de vingt mille heures de données d’opération humaine fournies par EgoScale, et avec un pré-entraînement de un million d’heures pour Dyna-2, les robots continuent d’étendre l’ampleur de l’apprentissage des comportements humains.
Ces deux études ont utilisé des parcours de formation de modèles différents, mais elles explorent toutes une chose : est-il possible que les données de manipulation humaine dépassent les limites de taille issues de la collecte par le corps robotique, afin de fournir une base pour l’apprentissage de plus de tâches par les robots ?
Une question supplémentaire se pose : lorsque le robot doit marcher, se baisser ou coordonner ses deux mains pour accomplir une tâche, combien d'informations sur l'interaction entre le corps et l'environnement sont conservées dans les données par heure ?
Prendre un paquet : il faut d’abord se déplacer vers une position appropriée, se baisser, tendre les mains, saisir, puis ajuster la posture pour soulever le paquet. Se déplacer le long du lit, aplatir la couverture, les mouvements des pieds et des bras ainsi que la force de contact doivent également être coordonnés de manière continue.
Dans les données Ego axées principalement sur la vision, nous pouvons voir ce que les personnes ont accompli, mais il n’est pas toujours possible de conserver complètement l’état physique qui sous-tend ces actions.
Si le robot doit apprendre à effectuer des mouvements complets et des opérations agiles, se contenter de savoir comment utiliser les mains ne sera probablement pas suffisant.
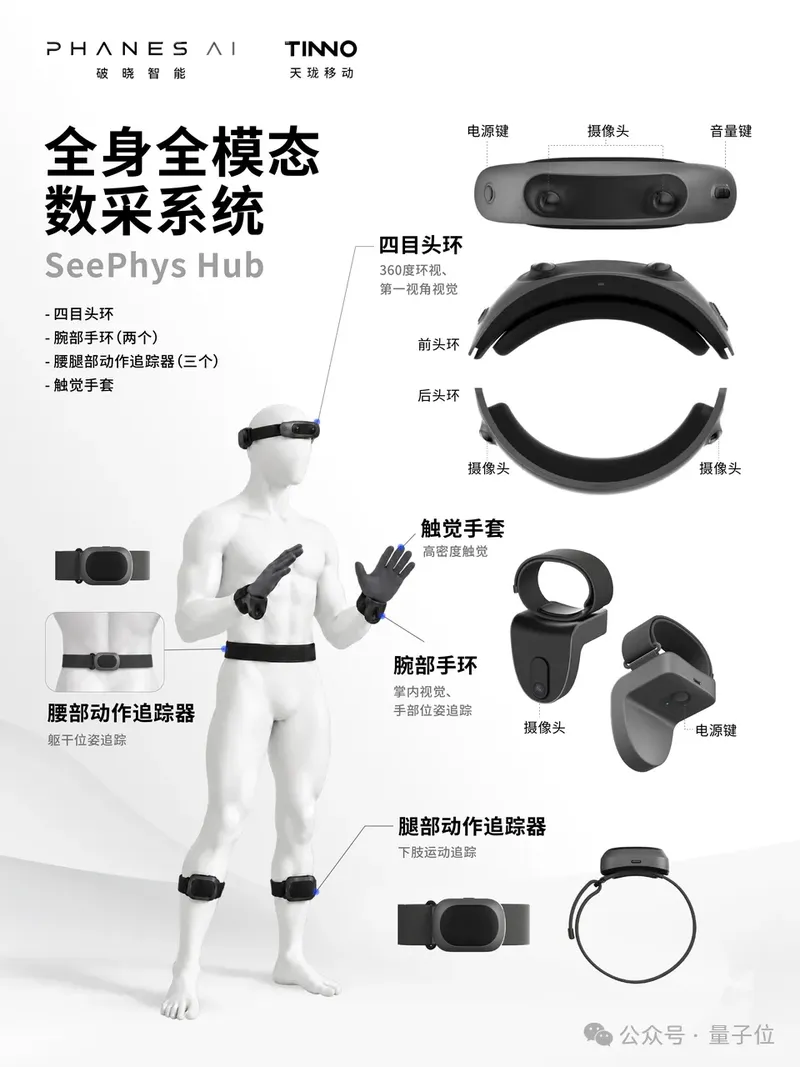
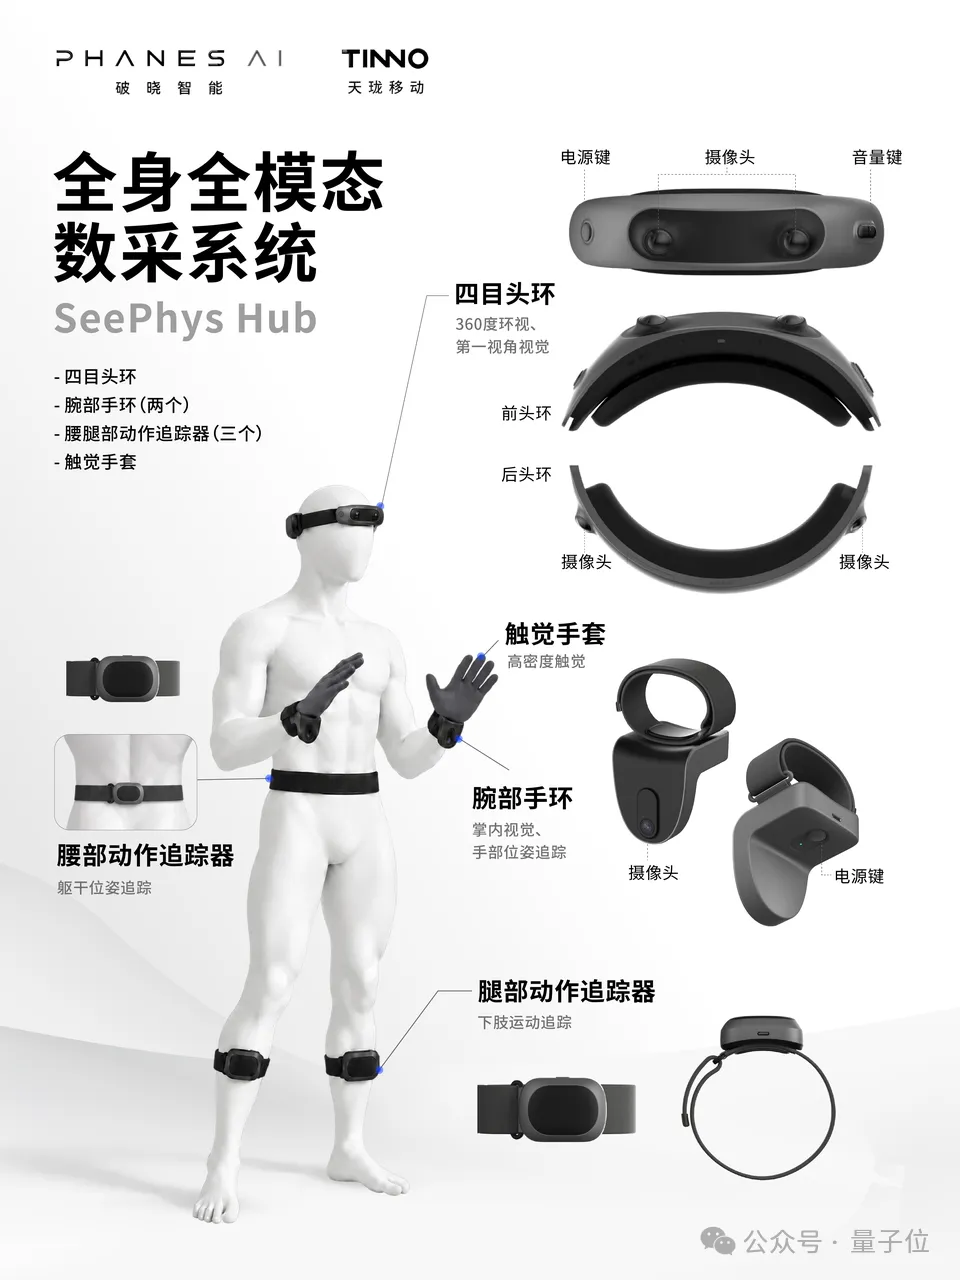
Le 14 octobre, Breoshi Smart et Tianlong Mobile ont publié le système de collecte de données pour tous les modes de modalité SeePhys Hub, dans l’objectif d’ajouter ces informations à Ego.
L’ensemble d’équipement comprend un anneau tête à quatre yeux, deux bracelets poignets, trois capteurs de mouvements pour les jambes et une paire de gants tactiles. Il restaure la posture du corps en fusionnant les signaux visuels et motrices, et collecte la pression des contacts des mains en fonction des besoins du mission.
Il espère conserver les avantages de la légèreté et de la facilité d’échelle du Ego, tout en ramenant les informations liées au mouvement physique et aux sensations tactiles en dehors de la vue.
Pour Breach Smart, il ne s’agit pas simplement d’ajouter plusieurs capteurs, mais d’explorer une autre manière de collecte de données entre les données de motion capture et de véritable appareil à haute précision, avec un coût de collecte élevé, et les données Ego légères mais avec des informations relativement limitées.
Notez les mouvements du corps et la « sensation » ensemble.
Les données collectées en première personne, c’est-à-dire les données Ego, sont devenues une source importante pour la collecte de données avec corps.
Ego est très attrayant ; lorsque l’on porte le dispositif, les opérations se déroulent dans des scénarios quotidiens, et la caméra suit la personne. La collecte ne doit pas toujours se faire autour du corps robotique.
Mais pour les tâches qui nécessitent de se déplacer et une collaboration complète, en ne notant uniquement les images immédiates, une partie des états clés est manquée.
Par exemple, lorsque quelqu’un soulève une chose située en hauteur avec les mains, les épaules, les bras et le tronc doivent être ajustés ensemble. La caméra en première personne peut capturer les mains, mais il n’est pas toujours possible de voir la position des coudes et des jambes. Lorsque le corps lui-même, un objet ou une zone cachée bloque la vue, l’estimation de la posture totale devient encore plus difficile.
Bien que ces mouvements puissent être estimés à l’aide de vidéos, la fiabilité de l’estimation devient un problème majeur lorsque le corps lui-même, des objets ou des zones de vue cachées entravent la vision.
Solution proposée par SeePhys Hub : ajouter quelques nœuds de suivi aux positions clés du corps humain.
Le SeePhys Hub utilise une solution de nœuds éparpillés : trois capteurs de suivi des mouvements sont placés à la taille et sur les deux cuisses, en combinant les informations visuelles de la tête et les données des deux poignets, afin de restaurer la posture du corps entier via un algorithme. Les IMU fournissent les signaux liés au mouvement, l’UWB fournit les informations de mesure entre les nœuds, et lorsqu’ils sont combinés avec la vision, on peut estimer la posture du corps entier.
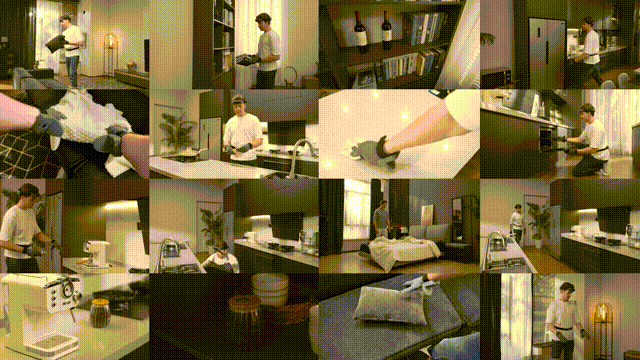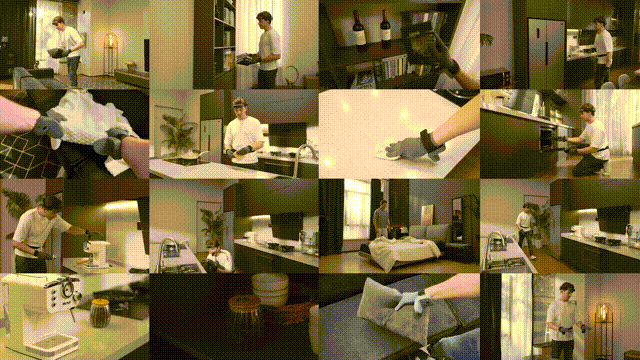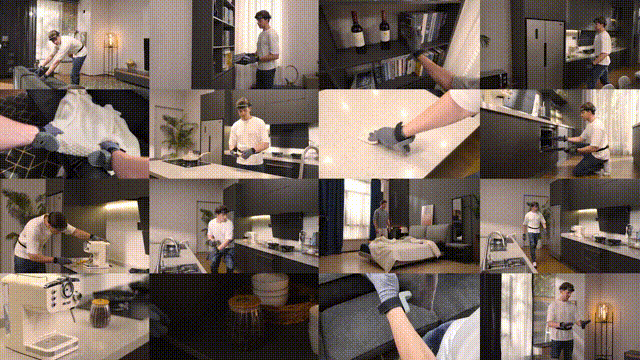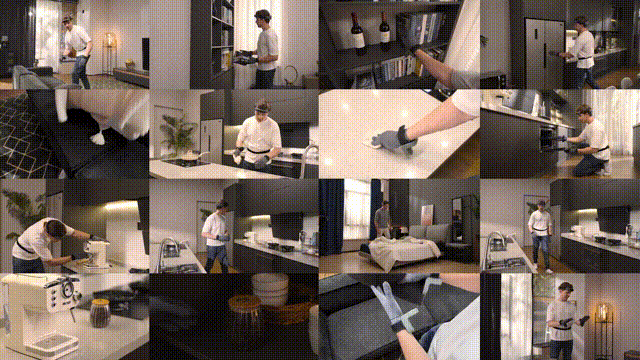
La couverture visuelle a également été étendue. Le bracelet à quatre yeux offre une vue de 360°, tandis que la caméra au poignet complète les détails des opérations à proximité. Les gants tactiles disponibles en option enregistrent les variations de pression lors du contact des deux mains avec un objet. Les informations visuelles, motrices et tactiles sont enregistrées de manière synchronisée, permettant ainsi de reconstituer le véritable processus d’opération humaine.
L’équipe de recherche et développement a donné un exemple : après avoir pris les bouteilles dans le réfrigérateur, la personne se tourne légèrement pour fermer la porte, et la caméra située derrière la tête peut encore enregistrer cette action. Les actions effectuées dans une scène réelle se produisent souvent grâce à de tels détours, mouvements et changements de point de vue.
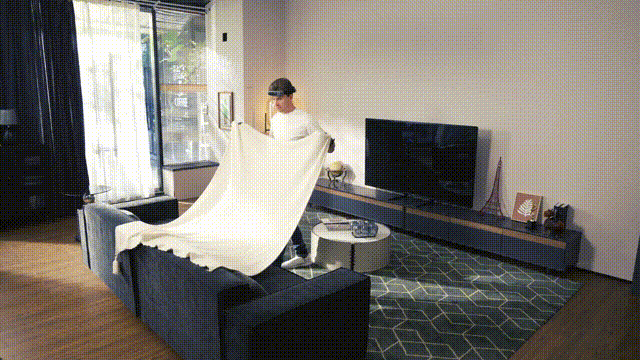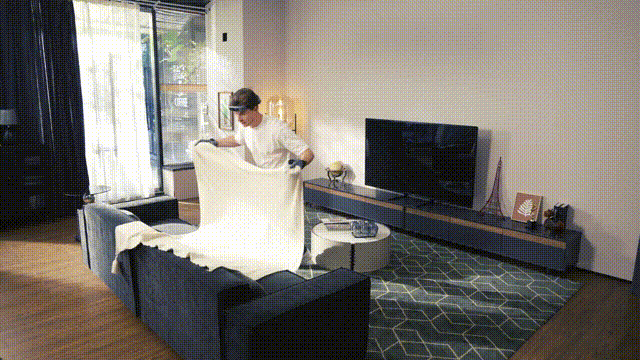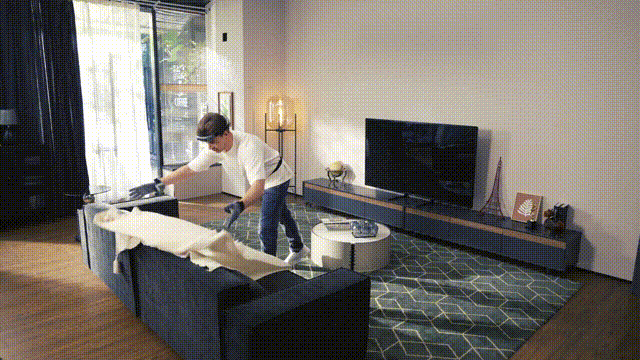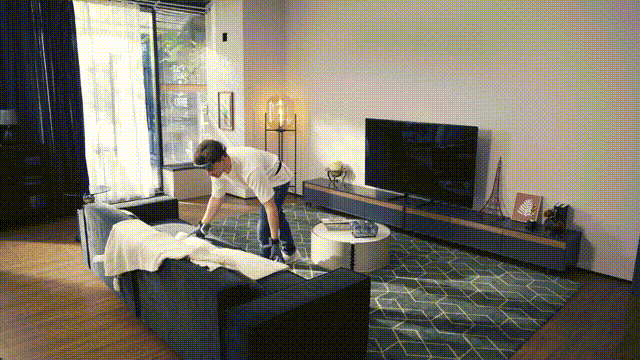
En dessous, c’est “la sensation”.
Porter un raisin, après le toucher, faut-il continuer à appliquer de la force ou s’arrêter et ajuster doucement ? Les personnes corrigent leurs mouvements en fonction de la contact réel. Les gants tactiles enregistrent la pression du contact, ce qui apporte un signal physique correspondant aux mouvements montrés sur la vidéo.
Pour le modèle, ces informations ont la possibilité d’aider à comprendre les relations entre le mouvement du corps, le contact des mains et les changements de l’environnement. Ce que l’équipe souhaite améliorer, c’est le nombre d’informations utiles que les données d’opération par heure peuvent fournir.
Les signaux multiples doivent également être alignés au même instant. Dans la vidéo, au moment où la main touche l’objet, il est nécessaire que les changements de pression et les mouvements du corps correspondent, afin de pouvoir analyser complètement le processus d’interaction. Selon les informations produit, la précision de synchronisation entre la caméra intérieure du bandeau, l’IMU et l’UWB ne dépasse pas 0,5 millisecondes. Ce niveau de travail peu visible affecte également la capacité des données de différents modaux à être reliées efficacement.
Après la collecte, il y a encore une étape de traitement. La plateforme associée à SeePhys Hub est chargée de l’analyse, du nettoyage, de la segmentation des mouvements et de l’annotation sémantique, ainsi que de la reconstruction des scénarios, de l’estimation de la posture et du suivi des mains. La redirection des mouvements permet de traduire les mouvements humains en actions du robot, offrant ainsi un soutien pour les entraînements et l’adaptation ultérieurs.
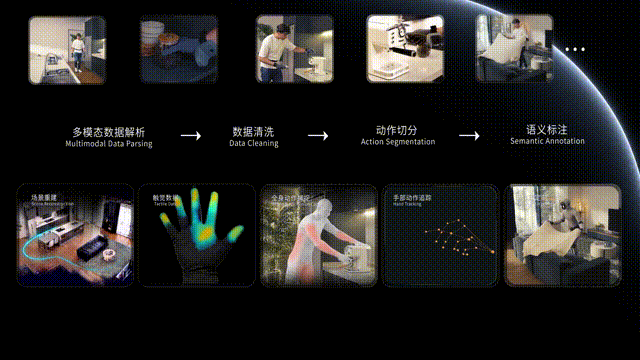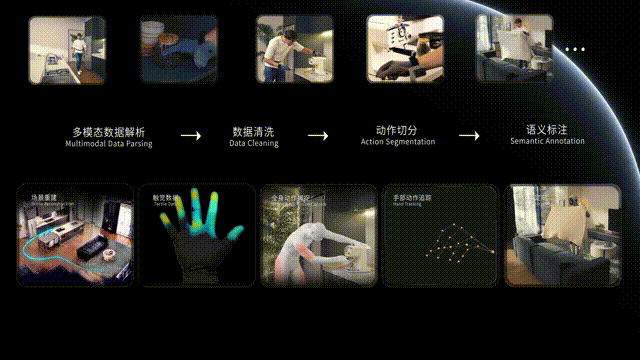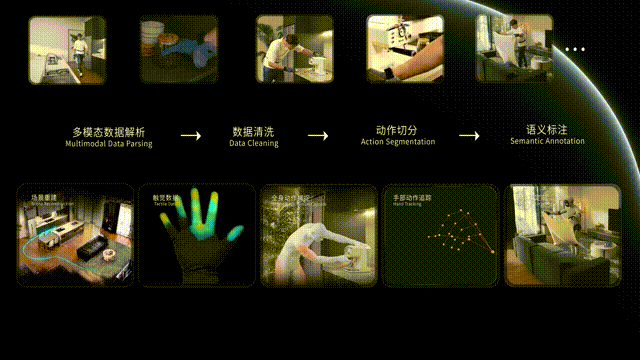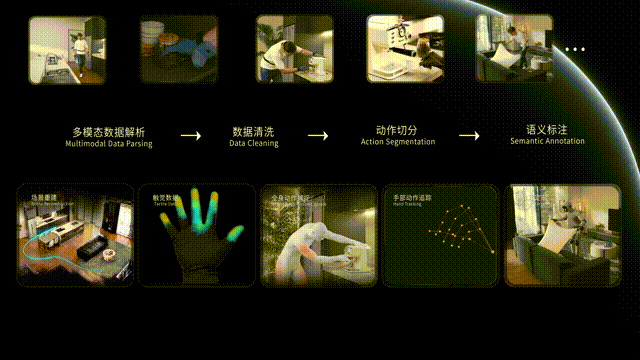
Les capteurs ne sont pas plus nombreux que meilleur ; la collecte à grande échelle nécessite de nouvelles décisions techniques.
Le nouveau modèle de données peut bien sûr fournir davantage d’indices, mais la qualité et l’utilisabilité des données dépendent également de la manière dont elles sont recueillies. Le problème revient donc à l’ingénierie et au produit.
Le choix des produits proposé par Boshuo repose sur une combinaison d’algorithme et d’un petit nombre de nœuds. Le poids du collier ne dépasse pas 220 grammes, et celui du collier au poignet individuel ne dépasse pas 75 grammes. L’équipe a placé la légèreté, le coût et la liberté d’action dans les scénarios réels dans une position importante dans la conception du produit.
Cela explique également sa position dans le plan de collecte.
Dans la pyramide de données en trois niveaux décrite par Yang Shuo, fondateur et PDG de Dawn, le niveau inférieur consiste en des vidéos internet à grande quantité, dont les informations de posture et de toucher sont complétées par des algorithmes ; le niveau supérieur comprend des données de capture dynamique de haute précision et des opérations avec des appareils réels ; SeePhys Hub vise le niveau intermédiaire, en essayant de concilier le potentiel d’une collecte à grande échelle avec une enregistrement plus complet des interactions.
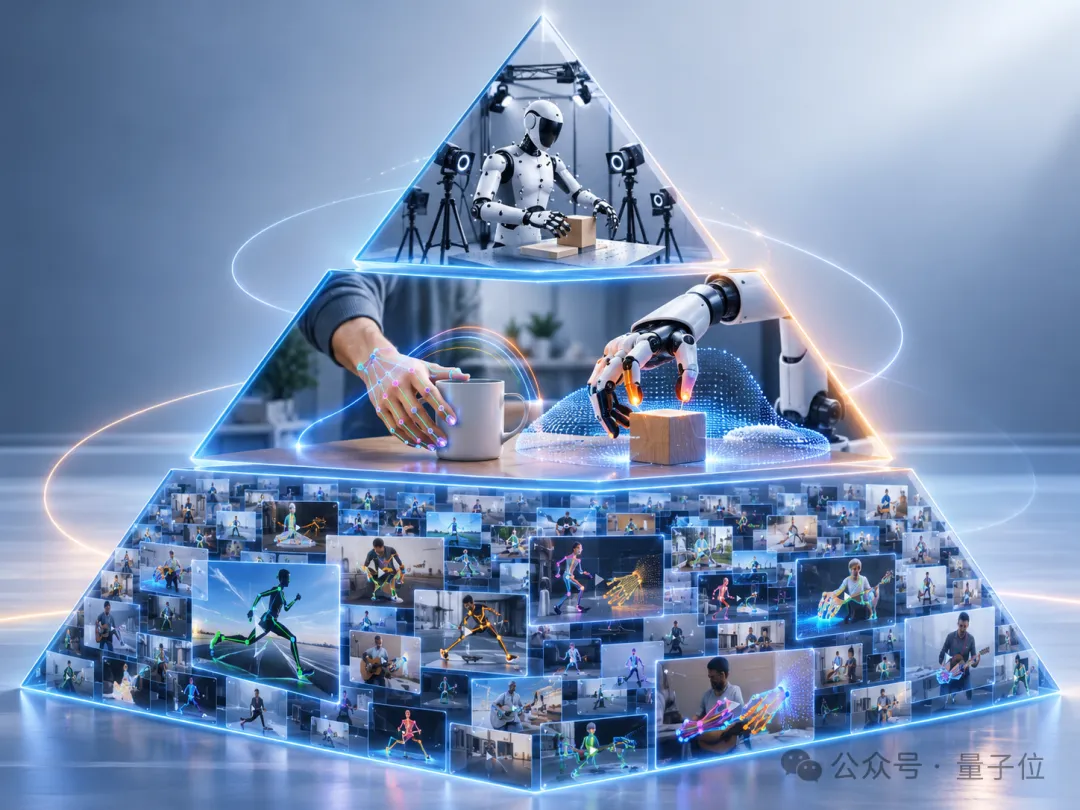 △L'image a été générée par l'IA
Chaque couche remplit une tâche différente. Les données de mouvement et de capture peuvent être utilisées pour superviser l’estimation de la posture, les données provenant d’appareils réels aident à adapter le modèle au robot, tandis que les vidéos humaines offrent davantage de scénarios et d’opérations. Ce qui est complété par les appareils portables, c’est la capacité de pénétrer dans un environnement réel et de enregistrer continuellement en suivant les personnes.
Les gants tactiles sont conçus de manière optionnelle, et reposent également sur les mêmes considérations techniques.
Selon Yang Shuo, l’équipe a eu contact avec certaines entreprises de collecte et d’exploitation de données. « Leur première demande envers nous était de ne pas faire porter des gants à nos personnes. »
Car lorsqu’on rencontre des scénarios spécifiques impliquant la protection contre l’eau, comme laver les assiettes, les opérations détaillées sont affectées par le port des gants, et le capteur lui-même peut également produire du bruit. L’équipe a rencontré dans les tests une situation où, après que les gants ont touché plusieurs récipients d’eau, la pression locale était encore visible lorsqu’on les tendait sans rien porter.
Ce type de bruit qui entre dans les données augmente la difficulté du traitement et de l’entraînement ultérieurs. Si les appareils portables affectent l’opération des personnes, cela affecte également la valeur des enregistrements.
Par conséquent, les bracelets et les gants de SeePhys Hub peuvent être utilisés séparément. Les clients choisissent la configuration en fonction de leur tâche, tandis que l’équipe continue à étudier comment estimer le toucher à partir de la vision, afin d’élargir les sources de données disponibles.
Pour que l’équipement soit vraiment déployé, la chaîne d’approvisionnement et la garantie de qualité sont également essentielles. Dans cette collaboration, Bozhao met l’accent surla conception des produits et les algorithmes, tandis que Tianlong Mobile offrel’expérience en gestion des coûts, de la chaîne d’approvisionnement et de la garantie de qualité.
Les services commerciaux s’articulent également autour des capacités des clients. Conformément à la planification d’équipe, les clients dotés de compétences en algorithmes peuvent acheter du matériel ou traiter les données eux-mêmes ; ceux qui ont besoin d’un programme complet peuvent choisir des algorithmes complémentaires et une mise en place locale ; dans des contextes comme la recherche scientifique, ils peuvent également utiliser une plateforme en ligne pour obtenir des données traitées.
Les opérateurs de collecte de données, les équipes de modèles intégrés, les parties scéniques et les institutions de recherche scientifique sont toutes des utilisateurs visés par l’équipe.
Selon Yang Shuo, l’accumulation derrière les équipements inclut également des algorithmes de détection de posture, ainsi que des données de paire utilisées pour le entraînement et la validation des algorithmes. Il est nécessaire que le matériel, les algorithmes et le traitement des données travaillent ensemble, afin de transformer les capteurs intégrés dans les personnes en enregistrements opérationnels pouvant être utilisés pour l’entraînement.
Une équipe qui travaille sur des modèles mondiaux, pourquoi commencer par la collecte de données ?
« Notre objectif final doit être de bien faire le modèle. » C’est cette réponse que Yang Shuo a donnée en parlant du pourquoi l’équipe de Baoxiao a développé des équipements de collecte de données.
Mais cela suscite inévitablement des questions : pourquoi une société qui souhaite créer des robots pour le cerveau choisirait-elle une approche indirecte, en commençant par les données et les équipements ?
Selon Yang Shuo, le problème réside précisément dans les données nécessaires pour le modèle. Pour modéliser ensemble le mouvement du corps, les contacts des mains et les changements de l’environnement, il est nécessaire d’avoir des enregistrements d’opérations correspondants. Les données requises sont difficiles à obtenir à faible coût et à grande échelle, alors l’équipe a choisi de se charger elle-même de cette partie.
De telles choix sont également liés au contexte de recherche précédent de Yang Shuo et de son équipe.
Fondateur de PHANES AI, Yang Shuo, né en 1998, est actuellement professeur titulaire et directeur des départements de technologie informatique et de science au Hautes Écoles de Technologie de l’Industrie de Harbin (Shenzhen).
Yang Shuo a longtemps mené des recherches dans les grands modèles multimodaux, la vision par ordinateur et l’intelligence comportementale. À l’âge de 26 ans, il a été nommé professeur titulaire et directeur de thèse à l’Université technique de Harbin (Shenzhen), étant ainsi le plus jeune professeur et directeur de thèse dans le domaine de l’intelligence artificielle en Chine.
Depuis sa création, Baoxiao Intelligence a formé une équipe combinant recherche de modèles et expérience en ingénierie. Selon l’entreprise, plus de 90 % des membres clés ont obtenu leur diplôme à l’Université Tsinghua, à l’Université de Pékin, à l’Université de Hong Kong ou à l’Université d’Harbin. Les recherches et les pratiques d’ingénierie couvrent les grands modèles multimodaux, les modèles mondiaux, le traitement de grandes quantités de données et le développement de matériel.
Auparavant, l’équipe avait mené une série de recherches concernant l’obtention, l’extension et l’utilisation des données tactiles.
En mai 2026, le jeu de données EgoTouch et la étude TouchAnything sont publiés. Le premier consiste à enregistrer synchroniquement des vidéos à première vue, les postures des mains et la pression tactile réelle, permettant ainsi aux modèles d’apprendre la relation entre la vision et le contact ; le second tente davantage d’estimer les zones de contact et la distribution de la pression à partir des vidéos, afin d’ajouter des informations tactiles aux données visuelles.
Arrivé à TouchWorld, ces « sensations » commencent à participer aux actions des robots. Le modèle prédit à l’avance les objets visuels et les cibles de contact, et en action, il corrige les écarts en fonction du retour tactile réel. Brancher un connecteur, essuyer une casserole, utiliser du papier toilette : ce sont toutes les tâches réelles sur le véhicule utilisé par l’équipe pour tester son fonctionnement.
SeePhys Hub étend le champ de recherche de l’interaction des deux mains à tous les mouvements du corps. Pour les opérations précises liées aux déplacements corporels, les robots doivent comprendre non seulement comment les mains touchent les objets, mais aussi comment le corps se déplace, comment la posture est ajustée, et quels résultats physiques ces actions entraînent.
Ces sont précisément les contenus que le projet Ablosh espère étudier grâce au modèle du monde entier multimodal. Selon le plan, l’équipe prévoit de lancer le modèle du monde entier multimodal en 2027, et priorisera la validation des applications dans des domaines spécialisés tels que l’industrie, la restauration et le retail.
Cependant, à ce stade, la phase du lever n’est pas encore prête à fabriquer son propre corps robotique.
La considération de Yang Shuo est que les données, les modèles et les scénarios d’implémentation sont encore en évolution. Le fait que le robot doit-il soulever des charges lourdes ou quelle charge est nécessaire influence la conception du corps du robot. Déterminer les composants matériels trop tôt peut également limiter la direction des algorithmes ultérieurs. Il qualifie ce risque de « coût d’immobilisation pur et simple ».
C’est pourquoi il est possible de placer l’objet réel par la suite. Actuellement, l’équipe utilise un modèle de test de l’objet universel et prévoit de collaborer avec les fournisseurs d’objets et les parties concernées pour mettre en place des essais d’application. La question de lancer son propre objet réel sera débattue une fois que les besoins des scénarios et les bénéfices commerciaux seront plus clairs.
Le lever du jour a également sa propre opinion concernant la compétition des modèles. Les robots doivent finalement percevoir, décider et exécuter en temps réel dans un environnement réel, et de nombreux scénarios exigent une déploiement côté utilisateur. Plutôt que d’agrandir uniquement la taille des paramètres, comment permettre à des modèles à taille limitée d’acquérir des capacités d’interaction physique et de réaliser stables les tâches assignées est peut-être un défi plus réaliste.
En regardant en arrière, au cours des dernières années, la collecte de données par robot a toujours été une opération de soustraction : de l’interaction distante vers Ego, se débarrasser du corps physique du robot, simplifier les équipements de collecte, et faire en sorte que plus d’opérations quotidiennes humaines deviennent des données d’entraînement accessibles à une grande échelle.
Mais lorsque les robots commencent à apprendre à marcher, à se pencher, à transporter des objets et à effectuer des opérations précises, les informations sur les mouvements du corps et les contacts en dehors de la caméra deviennent une partie impossible à ignorer.
La sélection du lever de soleil se fait sur cette voie légère, pour compléter les mouvements corporels et les sensations tactiles. SeePhys Hub est chargé de consigner une interaction humaine plus complète, et le modèle mondial complet multimodale de l’avenir devra apprendre davantage sur la relation entre les actions, les contacts et les résultats physiques.
De l’étude du mode de réalisation des tâches par le récenseur, à la capacité des robots à apprendre véritablement à agir de manière autonome. C’est la prochaine étape que Dawnbreak souhaite atteindre grâce aux données multimodales en temps réel.
*Cet article est publié avec l’autorisation de Quantifiable, les opinions appartiennent uniquement à l’auteur original.