
Yunzhong, depuis Ao Feisi
Quantum Bit | Compte public QbitAI
Faire rédiger des rapports hebdomadaires ou analyser des propositions par un Agent est devenu le quotidien de beaucoup. Mais à chaque fois, l'utilisateur doit encore chercher des documents et fournir le contexte, et l'agent doit passer par plusieurs étapes — recherche, lecture, organisation — avant de vraiment commencer la tâche.Changez de tâche, et tout ce processus doit recommencer.Traiter à plusieurs reprises ces documents déjà existants fait perdre du temps et augmente la consommation de tokens. Plus les documents sont nombreux et les étapes longues, plus il est facile de manquer des informations ou de commettre des erreurs, ce qui affecte la précision de l'accomplissement des tâches.
Pour résoudre ces problèmes,WorkSwarm prend en charge nativement pour la première fois l'espace de connaissances personnel。
L'« espace de connaissances personnel » s'appuie sur les multiples sources de documents configurées par l'utilisateur, collecte automatiquement le contenu, et via un traitement par règles, un traitement hybride règles plus grand modèle ou un traitement par agent, organise les documents en connaissances personnellesavec table des matières, liens entre elles et sources traçableset les met à la disposition de l'agent par divulgation progressive.
WorkSwarm organise les documents personnels en connaissances personnelles réutilisables à long terme, réalisant« une seule collecte, utilisation répétée »permettant à l'agent de trouver et d'utiliser plus facilement les informations pertinentes, d'améliorer la précision de l'accomplissement des tâches, tout en réduisant le temps de préparation et la consommation de tokens.
Espace de connaissances personnel openJiuwen : collecte automatique de connaissances personnalisées multi-sources, utilisées à la demande par l'agent bureautique
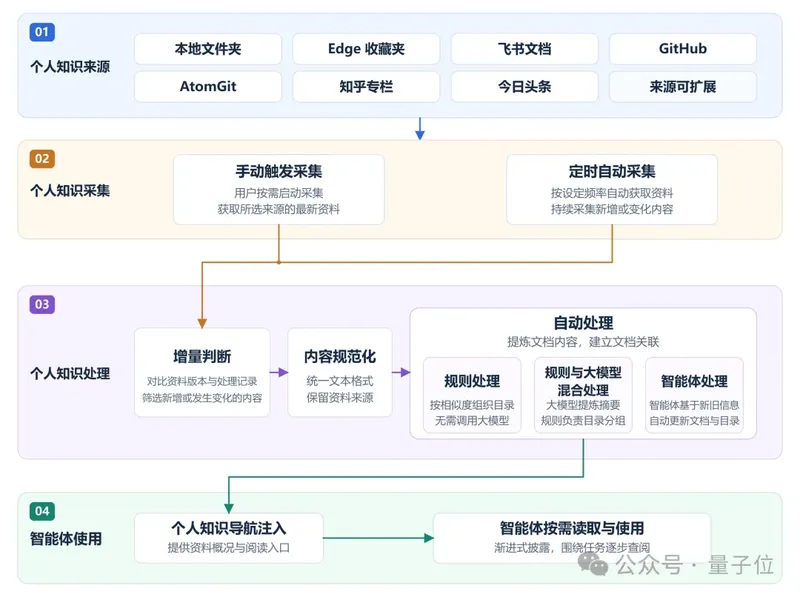
L'espace de connaissances personnel s'articule autour de quatre couches — sources, collecte, traitement et utilisation — pour transformer les documents personnels accumulés au quotidien par l'utilisateur en connaissances de contexte réutilisables de manière durable.
 △ Les quatre couches du processus de l'espace de connaissances personnel : configuration de sources multiples, collecte manuelle et programmée, trois modes de traitement et utilisation à la demande par l'agent
L'utilisateur choisit d'abord les sources de connaissances personnelles et le périmètre de collecte, puis le système récupère le contenu à la demande ou de façon programmée. Les documents collectés passent par une unification de format et une détection incrémentale afin d'identifier les nouveaux contenus et changements à traiter dans ce cycle, puis, selon la configuration, sont organisés par règles, par un mode hybride règles plus grand modèle ou par agent, en répertoires thématiques et pages Markdown, tout en maintenant les liens entre documents et leurs sources. Une fois la structure du répertoire et les références aux sources vérifiées, le résultat de l'organisation est mis à disposition de l'utilisateur pour consultation.
Lorsque l'utilisateur active l'usage pour une tâche, le système fournit à l'agent un aperçu des connaissances personnelles et des points d'entrée de lecture ; l'agent lit alors progressivement les pages pertinentes en fonction du problème en cours, faisant des connaissances existantes le contexte de l'accomplissement de la tâche.
Configuration et collecte de l'espace de connaissances personnel : choix libre des sources de connaissances personnelles, collecte incrémentale manuelle ou programmée prise en charge
Après avoir activé l'espace de connaissances personnel dans la page « Connaissances » des « Paramètres », l'utilisateur peut ajouter des sources telles quedossiers locaux, favoris Edge, colonnes Zhihu, Toutiao, documents Feishu, GitHub et AtomGitChaque source peut être configurée séparément, et l'utilisateur décide lui-même quels documents personnels entrent dans son espace de connaissances personnel.
Une fois la configuration terminée, l'utilisateur peutlancer la collecte manuellementpour mettre à jour activement son espace de connaissances personnel, ou définir unecollecte automatique programméepour récupérer continuellement le contenu selon la fréquence définie. Le système identifie les documents nouveaux ou modifiés en combinant identifiants de source, versions et progression de la collecte, puis traite les documents nouveaux ou modifiés en s'appuyant sur les connaissances personnelles existantes.
La page de gestion des sources affiche la progression de la collecte et les derniers états ; l'utilisateur peut ajuster la fréquence de mise à jour, consulter les résultats du cycle en cours, ou arrêter une collecte en cours.
Activez l'espace de connaissances personnel dans la page « Connaissances » des « Paramètres », puis accédez à « Gestion des sources » dans la page « Connaissances ». La vidéo prend Toutiao en exemple : ajout du lien de la page d'un auteur, lancement manuel de la collecte et consultation de l'état de fonctionnement de la source.
Traitement des connaissances personnelles : trois méthodes d'organisation permettent de transformer des données dispersées en connaissances réutilisables
Les pages web, les documents et le code ont des structures différentes, et les contenus d'un même sujet peuvent être dispersés sur plusieurs sources. L'espace de connaissances personnelles unifie d'abord le format des données, puis en extrait l'essentiel, en organisant le contenu par thème en répertoires et en pages, ce qui permet à l'agent de saisir d'abord une vue d'ensemble, puis de lire progressivement les contenus pertinents, tout en conservant les liens et les sources des documents originaux.
Après la collecte de nouvelles données, le système les intègre et met à jour les connaissances personnelles existantes, permettant ainsi aux connaissances de s'accumuler continuellement dans un même ensemble de fichiers en texte brut.
Dans la page « Connaissances » des « Réglages », les utilisateurs peuvent choisir l'une des trois méthodes de traitement suivantes selon la nature des données et leurs besoins d'organisation :
- Traitement par règles: en s'appuyant sur la pondération des termes BM25 et la similarité de contenu, les pages pertinentes sont classées par thème, et les liens entre répertoires et pages sont maintenus, sans faire appel à un modèle génératif.
- Traitement hybride règles et grand modèle: le grand modèle extrait d'abord le titre, le résumé et les mots-clés des nouvelles données, puis les règles effectuent le regroupement thématique et l'organisation des répertoires, et enfin le grand modèle génère les titres et les introductions des répertoires pour faciliter la compréhension et la consultation.
- Traitement par agent: l'agent analyse la relation entre les nouvelles données et les connaissances personnelles existantes, met à jour ou fusionne en priorité les pages thématiques existantes, crée de nouveaux documents si nécessaire, et maintient en parallèle les descriptions des répertoires et les références croisées entre documents.
Avec les deux dernières méthodes, les utilisateurs peuvent configurer le modèle utilisé pour organiser les données. Une fois l'organisation terminée, le système vérifie la structure des répertoires et les citations des sources ; les contenus validés sont alors disponibles pour la consultation par l'utilisateur et pour l'utilisation par l'agent.
Les utilisateurs peuvent également retrouver les contenus pertinents via l'arborescence de fichiers, le graphe ou la recherche, ouvrir les documents pour lire le texte intégral et remonter aux données sources grâce à l'annotation « Sources ».
Une fois la collecte terminée, les contenus liés à « jev » ont été collectés. L'utilisateur peut rechercher jev dans la page « Connaissances », lire le texte organisé dans le panneau de droite, ou consulter les nœuds associés et leurs relations via le graphe.
Utilisation à la demande : divulgation progressive, permettant à l'agent de commencer à travailler avec les connaissances déjà acquises
Une fois les données organisées en connaissances personnelles, l'utilisateur peut connecter l'agent à son espace de connaissances personnelles via le menu « + » de la zone de saisie des tâches. À réception de la saisie de l'utilisateur, l'agent obtient d'abord une vue d'ensemble de l'espace de connaissances personnelles et les points d'entrée en lecture, prend connaissance du périmètre des connaissances existantes, puis, selon la tâche en cours, consulte progressivement les répertoires et les liens entre documents pour acquérir le contexte nécessaire.
Cette approche de divulgation progressive s'apparente au fait, lorsqu'on reprend un travail, de consulter d'abord le sommaire et la présentation du projet, puis de parcourir les documents pertinents, permettant ainsi à chaque tâche de lire les connaissances existantes selon les besoins.
La collecte et l'utilisation pour les tâches peuvent être contrôlées séparément. L'utilisateur peut laisser le système collecter et organiser les documents en continu, puis activer l'utilisation par l'agent intelligent au besoin. Après avoir désactivé l'utilisation pour les tâches, la collecte des documents peut se poursuivre, et l'utilisateur peut également consulter et rechercher directement les documents existants.
C'est l'utilisateur qui décide quels documents entrent dans son espace de connaissances personnel et quand l'agent intelligent peut les utiliser. Lors du lancement d'une tâche, il suffit de se concentrer sur le problème à résoudre cette fois-ci, tandis que les connaissances déjà accumulées fournissent à l'agent intelligent le contexte pour comprendre et accomplir la tâche.
Après avoir activé l'espace de connaissances personnel, saisissez « présente-moi jev » et envoyez. WorkSwarm consulte ensuite les documents sur Jev dans l'espace de connaissances personnel et génère une présentation couvrant les mécanismes essentiels, les cas d'application concrète, etc.
Comparaison des effets : amélioration du taux de réussite des tâches, réduction du temps et de la consommation de tokens
Une fois l'espace de connaissances personnel activé, l'agent intelligent peut d'abord prendre connaissance du périmètre des documents existants, puis localiser et lire les documents pertinents, ce qui réduit le travail de recherche et d'organisation répétées des sources brutes pendant la tâche.
L'équipe a d'abord réalisé 2 tests comparatifs pour observer l'effet de ce changement sur la qualité d'accomplissement des tâches, le temps nécessaire et la consommation de tokens.
La comparaison montre qu'avec l'espace de connaissances personnel, WorkSwarm est capable de combiner les dossiers clients, les documents de projet et les plans de travail pour produire une synthèse de projet concrète et les prochaines étapes ; en l'absence des connaissances personnelles pertinentes,l'agent intelligenta effectué plusieurs recherches sans obtenir le contexte du projet et n'a pu fournir qu'un cadre générique de préparation de réunion, en demandant à l'utilisateur de compléter les documents.
La comparaison montre qu'après l'activation de l'espace de connaissances personnel, WorkSwarm est capable d'utiliser les connaissances accumulées depuis les favoris du navigateur de l'utilisateur, les colonnes Zhihu et d'autres sources pour accomplir la tâche plus rapidement.
En outre, l'équipe openJiuwen a constitué son propre ensemble de tests comportant 25 questions, fondé sur des documents issus de sept types de sources — articles locaux, favoris du navigateur, documents Feishu, GitHub, AtomGit, Zhihu et Toutiao — couvrant des scénarios tels que la recherche sur une source unique, la synthèse multi-sources, la réutilisation avec un sujet modifié, les faits manquants et les tâches sans rapport, avec des points d'acceptation prédéfinis pour chaque question. Les résultats des tests montrent qu'après l'activation de l'espace de connaissances personnel :
- le taux de réussite des tâches a augmenté de 32%. L'espace de connaissances personnel permet à l'agent intelligent de localiser plus facilement les documents nécessaires et de répondre en combinant les informations personnalisées de différentes sources, réduisant les cas d'échec dus à des documents introuvables ou à des informations omises.
- le temps total des tâches a diminué de 76.2%. Les documents étant collectés et organisés à l'avance, il est possible de consulter directement les documents pertinents pendant la tâche, ce qui réduit les étapes de recherche, de lecture et d'organisation des sources brutes à la volée.
- la consommation totale de tokens durant la phase de tâche a diminué de 84.1%. Les connaissances organisées peuvent être réutilisées dans différentes tâches ; l'agent intelligent lit le contenu pertinent selon les besoins de la tâche, ce qui réduit la consommation de tokens liée à l'organisation répétée des sources brutes et à la transmission de contenus non pertinents.
Cette expérience a utilisé un mode de traitement par agent intelligent ; bien que la phase de prétraitement consomme également des tokens, ce coût peut être maîtrisé en choisissant un modèle adapté à l'organisation des documents et moins cher, puis progressivement amorti grâce à la réutilisation des résultats d'organisation dans plusieurs tâches.
Conclusion
L'espace de connaissances personnel d'openJiuwen transforme des documents personnels dispersés en connaissances réutilisables de manière durable. L'utilisateur choisit librement ses sources, le système collecte et met à jour en continu, de sorte que les documents soient à la fois faciles à consulter et lisibles à la demande par l'agent intelligent, fournissant un contexte pour différentes tâches.
À l'avenir, l'espace de connaissances personnel d'openJiuwen prévoit de s'appuyer sur les traces d'utilisation des utilisateurs pour identifier les objectifs de travail et les lacunes en connaissances, et compléter proactivement les documents, afin que l'accumulation de connaissances réponde davantage aux besoins réels et que l'agent de bureau vous comprenne de mieux en mieux au fil de l'usage.
L'espace de connaissances personnel fait de vos documents accumulés le point de départ de votre prochaine collaboration avec un Agent.
L'espace de connaissances personnel est désormais disponible dans WorkSwarm ; les utilisateurs intéressés peuvent se rendre sur le site officiel pour le télécharger en un clic et l'essayer immédiatement :
Site officiel de WorkSwarm : https://openjiuwen.com/workswarm
GitHub : https://github.com/openJiuwen-ai/jiuwenswarm
AtomGit : https://atomgit.com/openJiuwen/
*Cet article est republié par QbitAI avec autorisation ; les opinions exprimées appartiennent uniquement à l'auteur original.