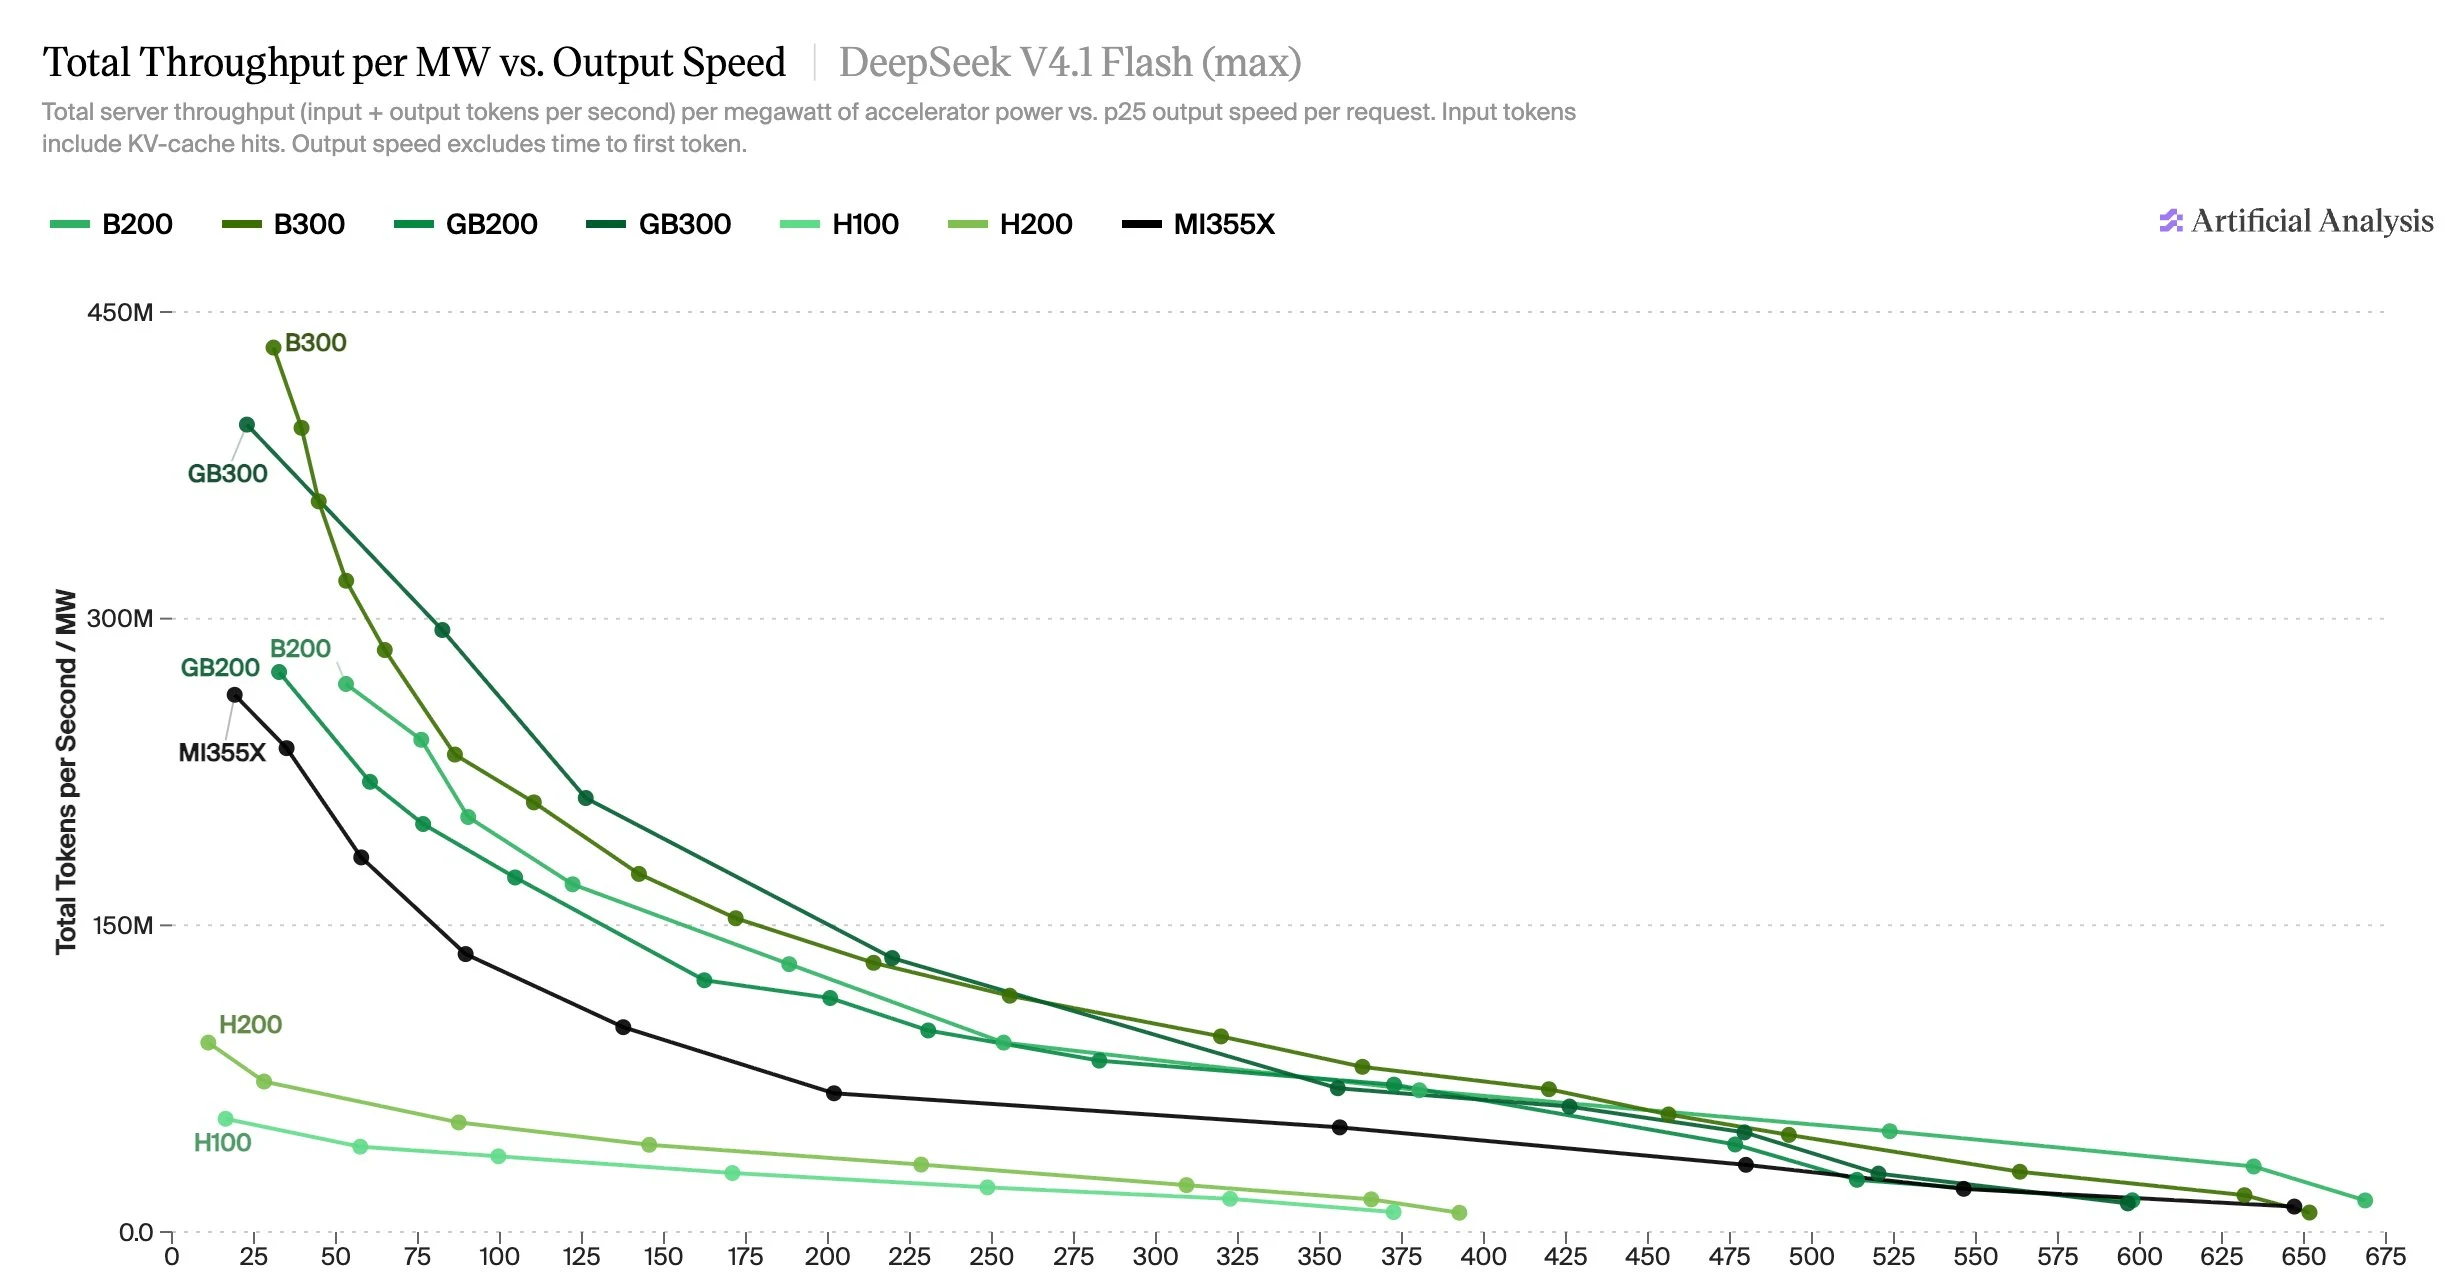
Nous avons ajouté DeepSeek V4.1 Flash à AA-AgentPerf, avec des résultats pour les matériels NVIDIA et AMD. À 100 tokens/s par utilisateur, le NVIDIA GB300 occupe la première place, avec un débit de 261M tokens/s par MW.
AA-AgentPerf est notre benchmark de performance d’inférence d’agent. Il reproduit des sessions de codage d’agent réelles, y compris le stockage des prompts et les retards lors des appels aux outils, afin de fournir une mesure réaliste de la performance d’inférence dans les tâches quotidiennes d’agent. Nous mesurons le débit total du système par mégawatt d’énergie utilisée, ainsi que la vitesse de sortie par agent à différents niveaux de concurrence, afin de montrer le compromis entre l’utilisation du système et l’expérience utilisateur individuelle.
DeepSeek V4.1 Flash intègre le classement aujourd’hui. Il fait passer le nombre de modèles présentés à quatre, aux côtés de DeepSeek V4 Pro 0813, Kimi K3 et GLM-5.2/5.3. Nous développons les modèles présentés à mesure que de nouveaux modèles open-weight populaires sont sortis, et nous présenterons également les résultats du jour 0 pour les prochaines versions majeures.
Contexte sur DeepSeek v4.1 Flash :
➤ Il obtient 39 points sur l’Indice d’Intelligence en Analyse Artificielle, devant le V4 Pro 0813 précédent de DeepSeek qui n’a obtenu que 36 points, avec environ un tiers de paramètres (552B de « colonne vertébrale » et 16B actifs, contre 1,6T et 49B).
➤ Il est construit sur une nouvelle architecture, avec un design encodeur-décodeur causal qui active 8B paramètres par token d’entrée et 16B par token de sortie. Il utilise en outre 196B de paramètres de mémoire Engram n-gram qui peuvent se trouver dans la mémoire hôte plutôt que sur l’accélérateur, ainsi que une attention compressée et sparse nécessitant environ un quart de la capacité de cache KV du modèle Flash V4 précédent par token.
➤ Cela rend le service beaucoup plus efficace, car les poids s’adaptent à moins de GPU et la petite mémoire KV permet une plus grande nombre de agents simultanés par GPU
Résultats initiaux du AA-AgentPerf pour DeepSeek V4.1 Flash:
➤ V4.1 Flash fonctionne avec seulement 2 GPU, donc les systèmes en rack ne bénéficient pas autant que les nœuds monolithiques à 8 GPU comme B300, qui reste à environ 20 % de la performance du GB300 NVL72 en rack, et se place à l’extrémité supérieure ou inférieure.
➤ À 100 tok/s par utilisateur, GB300 se classe en tête avec environ 261M de tokens/s par MW, devant B300 (~220M), B200 (~193M), GB200 (~178M) et MI355X (~128M)
➤ Chaque système Blackwell et MI355X peut atteindre une vitesse de sortie d’environ 600 à 670 tok/s pour un seul agent (c’est-à-dire avec un grandeur de lot de un), contre 372 à 392 tok/s sur H100 et H200
➤ V4.1 Flash est à la fois plus intelligent que V4 Pro 0813 et beaucoup moins cher à héberger, ce qui entraîne un débit de ~1,3x (GB300) à ~6,2x (B200) par MW pour chaque utilisateur à 100 tok/s, par rapport à son cousin plus grand.