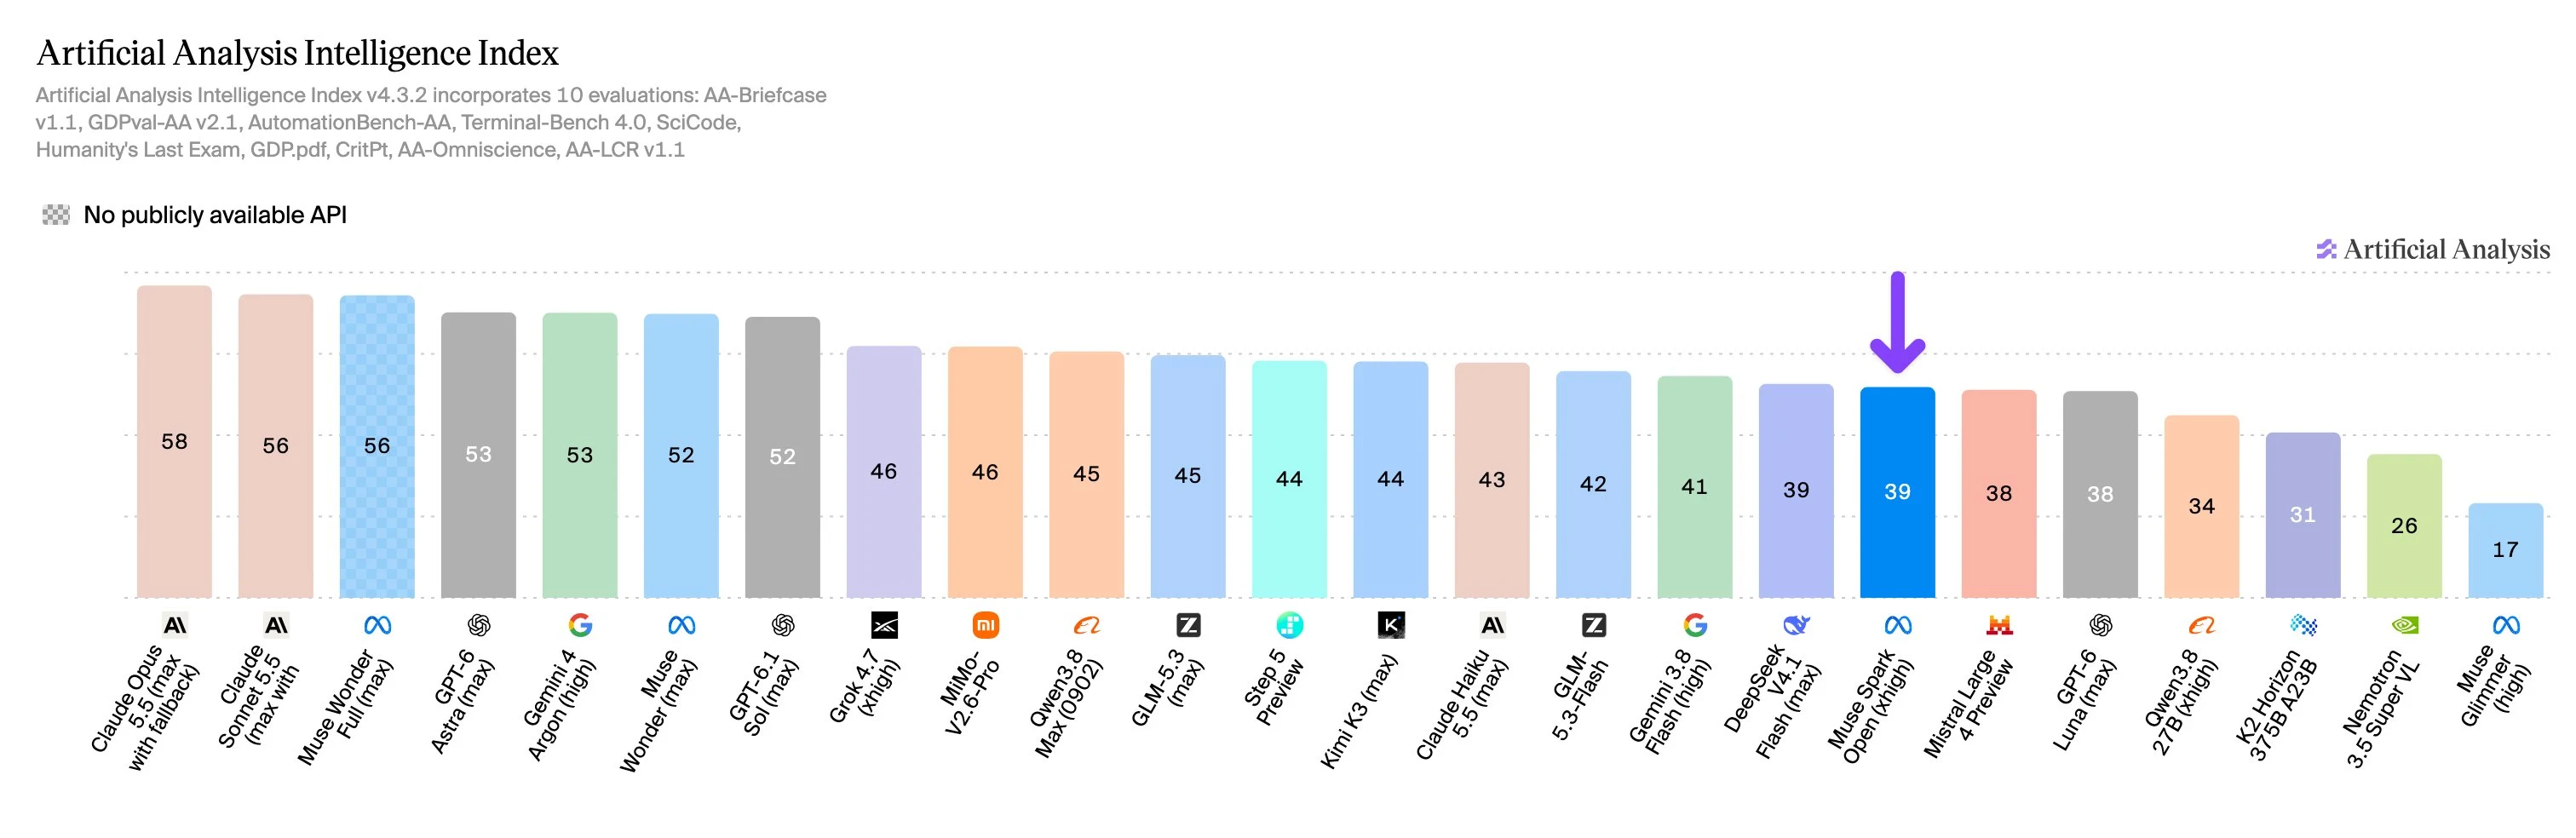
Meta a publié Muse Spark Open, un modèle à poids ouverts de 816B (42B actifs) qui obtient un score de 39 sur l'Artificial Analysis Intelligence Index, ce qui en fait le modèle américain à poids ouverts n°1
Muse Spark Open (xhigh) obtient 22 points de plus que Muse Glimmer (high, 17), le modèle dense à poids ouverts de 30B de Meta sorti en août. Il devance également le Nemotron 3.5 Super VL de NVIDIA (26), le modèle américain à poids ouverts le mieux classé suivant, lancé aujourd'hui
@AIatMeta nous a partagé l'accès avant la publication publique pour le benchmarking. Félicitations à @AIatMeta, @finkd et @alexandr_wang pour cette publication !
Points clés :
➤ Des poids ouverts au niveau du modèle phare d'août de Meta. Muse Spark Open obtient un score à moins d'un point de Muse Spark 1.2 (xhigh, 40). Il est plus performant sur AutomationBench-AA et affiche un taux d'hallucination plus faible, mais est moins performant sur GDPval-AA v2.1, CritPt et la précision AA-Omniscience. Dans la gamme actuelle de Meta, il se situe 13 points derrière Muse Wonder (max, 52) et 17 points derrière Muse Wonder Full (max, 56)
➤ Économe en tokens, à un coût modéré par tâche. Muse Spark Open utilise 40k tokens de sortie par tâche de l'Intelligence Index, le moins parmi les neuf modèles à poids ouverts les mieux notés : par exemple 16% de moins que Muse Spark 1.2 (xhigh, 48k) et 43% de moins que GLM-5.3 (max, 71k), son plus proche homologue chinois par la taille. Together AI, Fireworks et Baseten le proposent au lancement pour 1,25 $/4,25 $ par 1M de tokens d'entrée/sortie (0,15 $ en entrée en cache). À ce tarif, il coûte 0,84 $ par tâche de l'Intelligence Index. C'est moins que Muse Spark 1.2 (0,97 $) aux mêmes prix par token et moins de la moitié de GLM-5.3 (max, 2,01 $), mais environ trois fois DeepSeek V4.1 Flash (max, 0,27 $)
➤ Une faiblesse relative dans le travail agentique par rapport aux leaders chinois des poids ouverts. Parmi les neuf modèles à poids ouverts les mieux notés, Muse Spark Open se classe dernier sur les quatre évaluations agentiques de l'indice mais quatrième sur les six autres combinées, et il devance tous les modèles à poids ouverts sur AA-Omniscience (25). GLM-5.3 (max), le modèle chinois le plus proche par la taille, doit l'intégralité de son avance de 6 points aux évaluations agentiques
➤ Auto-hébergeable sur un seul nœud, ou deux Mac Studios. Les poids BF16 pèsent ~1,6 To. Le checkpoint NVFP4 de Meta ne quantifie que les 256 experts, réduisant les poids à ~530 Go. Meta indique que cela fonctionne sur quatre GPU Blackwell Ultra ou huit H200, ou sur deux Mac Studios M5 Ultra de 512 Go utilisant MLX. L'architecture utilise 62 couches avec une attention grouped-query (16 têtes KV), 8 des 256 experts actifs par token, et un Perception Encoder de 1,8B de paramètres pour la vision
Autres détails du modèle :
➤ Paramètres : 816B au total, 42B actifs (MoE)
➤ Fenêtre de contexte : 1M de tokens
➤ Licence : Muse Model License, une licence personnalisée qui exige l'attribution « Built with Muse Spark Open » et un accord séparé avec Meta pour les entreprises de Model-as-a-Service réalisant plus de 20M $ de revenus annuels
➤ Modalités d'entrée : texte, image, vidéo et audio. Sortie : texte
➤ Disponibilité : poids sur Hugging Face (BF16 et NVFP4), avec accès API via Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter et Together AI