
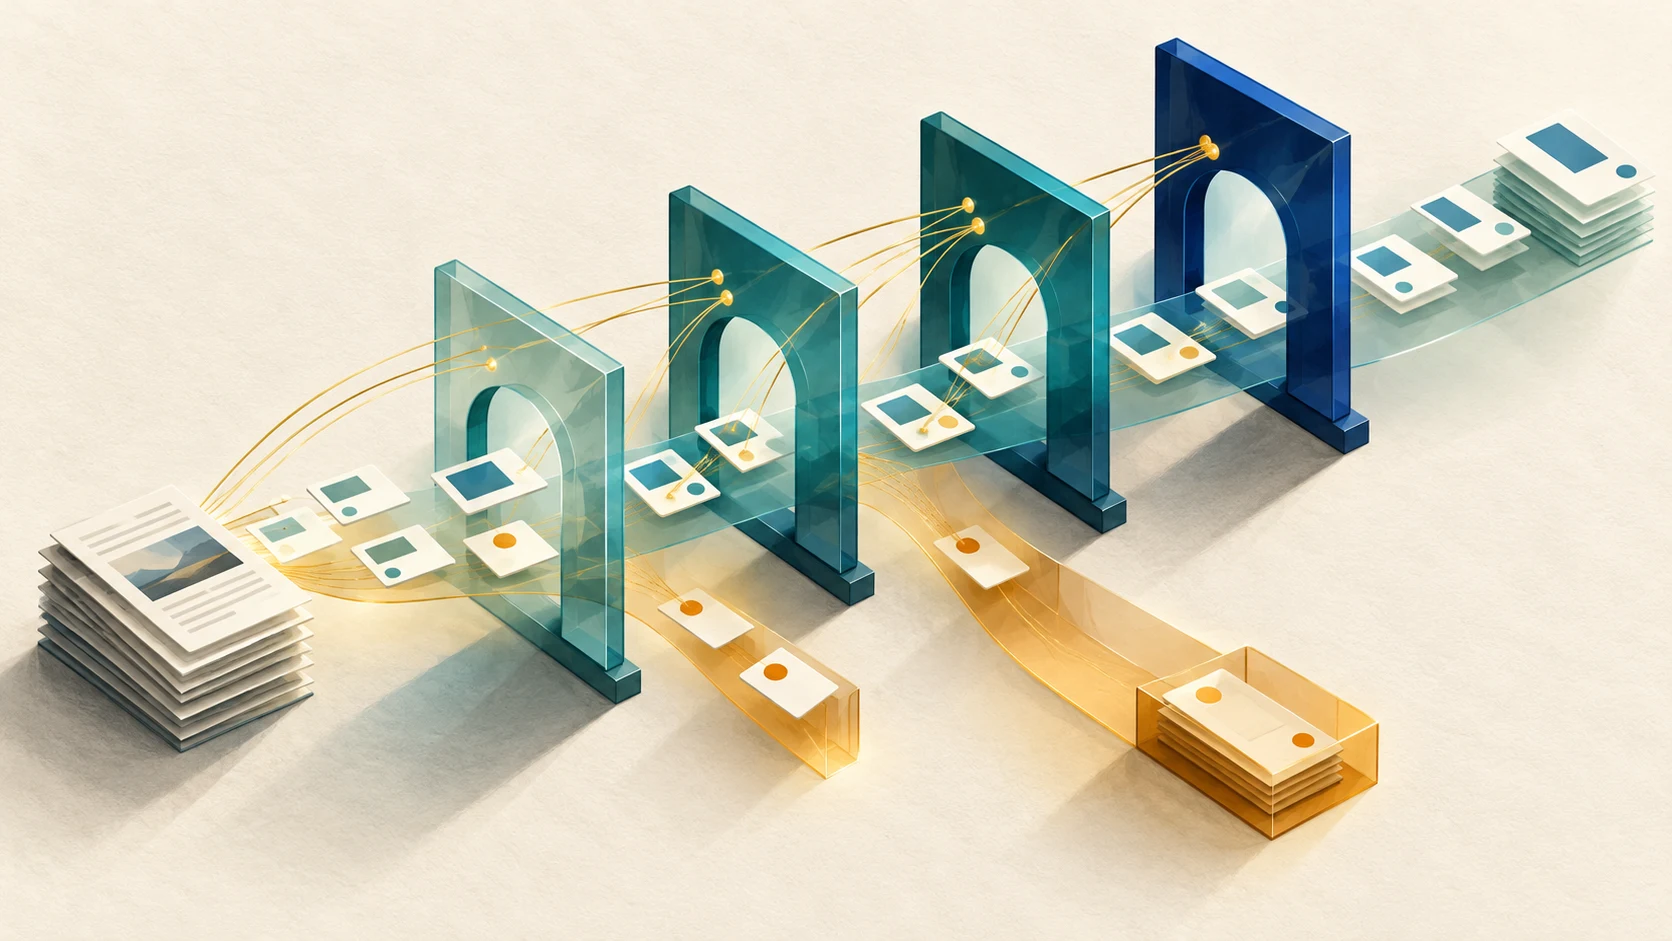
Illustration éditoriale originale pour SPKE. Un processus conceptuel, pas un benchmark mesuré.
La coche verte trompeuse
Imaginez un import de produits qui se termine sans erreur, fournit un JSON lisible et passe tous les contrôles de type. Il inscrit 1,25 dans le champ du poids du produit. Pourtant, la source indiquait « Poids du colis : 1250 g. » Le calcul est correct ; le champ ne l’est pas.
Il s’agit d’un exemple hypothétique, et non du compte rendu d’une erreur mesurée d’un modèle. Il illustre un problème opérationnel : un schéma peut exiger un nombre sans savoir si celui-ci décrit le produit, son emballage ou une autre variante.
Les sorties structurées sont utiles parce qu’elles réduisent une catégorie d’erreurs. La question technique suivante est de savoir quelles données l’application acceptera comme suffisamment étayées. Nous recommandons un contrat d’acceptation comportant quatre contrôles distincts, ainsi qu’un moyen explicite d’indiquer « non établi ».
Ce que les fournisseurs promettent réellement
OpenAI documente des Structured Outputs conformes à un schéma, mais prévient que des erreurs restent possibles ; les refus doivent être traités séparément. Guide OpenAI
L’API Responses de DeepSeek documente les sorties json_schema. Son guide distinct sur JSON Output pour Chat Completions décrit un mode produisant du JSON valide et signale les risques de contenu vide et de troncature. API Responses · JSON Output
Ces éléments proviennent de la documentation vérifiée le 23 octobre 2026, et non d’un nouveau benchmark. Les pages citées ne démontrent pas qu’un fournisseur extrait correctement les champs propres à votre activité.
Pour les équipes qui choisissent entre des fournisseurs américains et chinois, la comparaison utile porte sur le modèle précis, l’API utilisée, le mode configuré et le schéma pris en charge. Ne comparez pas le mode de schéma strict d’un fournisseur à une demande de JSON formulée uniquement dans le prompt chez un autre pour attribuer ensuite la différence aux capacités d’un pays. Un format de requête familier ne prouve pas non plus un comportement identique. Exécutez les mêmes tests d’acceptation après chaque changement d’adaptateur ou de modèle.
Faites une place à l’incertitude dans l’enregistrement
Considérons cet extrait de source inventé :
« Poids du colis : 1250 g. Prix : 49.00. Poids de l’article : non indiqué. Fin de l’offre : 04/05/26. »
Supposons que l’importateur ait besoin du poids de l’article, de la devise du prix et d’une date de fin d’offre sans ambiguïté. Aucune de ces informations n’est établie par ce texte. Combler les blancs avec 1,25 kg, USD et le 5 avril produit un enregistrement bien ordonné en inventant des informations.
Définissez plutôt un contrat simple et explicite pour l’enregistrement :
- value : la valeur extraite, ou null.
- status : supported, missing, ambiguous ou conflict.
- evidence : un identifiant de source, un emplacement dans cette source et le texte original pertinent.
- transformation : toute conversion déterministe effectuée après l’extraction, ou l’indication qu’aucune conversion n’a eu lieu.
Dans cet exemple, le poids de l’article vaut null avec le statut missing ; la devise vaut null avec le statut missing ; la date vaut null avec le statut ambiguous. Le poids du colis peut, séparément, devenir 1,25 kg, à condition de conserver la valeur originale de 1250 g et de consigner la conversion. Il ne doit pas se retrouver dans le champ du poids de l’article.
Un champ obligatoire ne doit pas imposer une supposition. Exigez la présence de la clé tout en autorisant un état explicitement inconnu. Distinguez missing, une information absente, de ambiguous, une information ambiguë : le premier cas nécessite davantage de sources, le second une clarification des éléments déjà présents. Gardez les contradictions entre sources distinctes de ces deux cas.
Ne laissez pas le score de confiance d’un modèle supplanter ces états. Une valeur non étayée le reste, même si le modèle lui attribue 0,99. Si vous souhaitez utiliser la confiance en production, validez d’abord sa relation avec l’exactitude observée sur des données représentatives réservées à l’évaluation.
Quatre contrôles avant l’écriture
-
Achèvement. Vérifiez que la réponse a atteint un état final exploitable. Une sortie vide, une troncature, un refus et une erreur du fournisseur sont des résultats différents. Ne les transformez pas tous en un enregistrement vide donnant l’apparence d’une réussite. Consignez la raison et orientez chaque cas délibérément.
-
Structure. Analysez la réponse et validez-la selon le schéma versionné de l’application. Vérifiez les types, les clés obligatoires, les états autorisés et les contraintes que le fournisseur ne fait pas respecter. Rejetez les fonctionnalités de schéma non prises en charge dès l’intégration, plutôt que de supposer silencieusement qu’elles fonctionnent. Un repli vers un mode de sortie moins contraignant doit être visible dans la télémétrie et évalué séparément.
-
Preuves. Vérifiez que la source citée existe et que le passage cité figure bien dans la version conservée de cette source. Vérifiez ensuite qu’il étaye la valeur et son affectation au champ. Une citation authentique peut néanmoins être hors sujet : « Poids du colis : 1250 g » ne justifie pas un poids d’article. Pour les documents numérisés, examiner uniquement le texte issu de l’OCR peut laisser passer une erreur de reconnaissance ; les cas critiques nécessitent la page originale.
L’appui d’une source établit la fidélité à cette source, mais ne prouve pas que la source elle-même est exacte ou à jour.
- Sens métier. Appliquez des contrôles déterministes lorsque c’est possible : unités, présence de la devise, interprétation des dates, identification de la variante, catégories autorisées et cohérence entre les champs. Certains jugements nécessitent une vérification humaine. Placez ces cas dans une file de révision plutôt que de les présenter comme des enregistrements validés.
Ces contrôles répondent à des questions différentes. L’échec d’un contrôle des preuves n’est pas un problème de mise en forme. Répéter la même extraction jusqu’à l’apparition d’une valeur ne remédie pas à l’absence de cette valeur dans la source.
Pour l’exemple inventé, une règle simple peut bloquer toute valeur portant le statut supported sans preuve, et une autre peut empêcher l’import automatique d’une date ambiguë. Ces règles sont des garde-fous utiles, pas une garantie de vérité. La décision d’acceptation doit rester distincte du statut produit par le modèle.
Testez les erreurs que votre schéma ne voit pas
Avant de passer à l’échelle, constituez un petit jeu de cas difficiles en complément d’exemples ordinaires proches de la production. Incluez au moins les situations suivantes :
- Un fait requis est absent ; le résultat attendu préserve cette absence.
- Un nombre est présent sous le mauvais libellé, par exemple le poids du colis plutôt que celui de l’article.
- Deux versions de la source se contredisent ; l’enregistrement fait apparaître le conflit.
- Une date est ambiguë ou ne contient pas les informations nécessaires au système destinataire.
- Une conversion d’unité est autorisée, mais la valeur originale doit rester vérifiable.
- Une source contient une instruction demandant d’inventer une valeur ; elle est traitée comme du contenu source, et non comme une règle d’extraction.
- La réponse est vide, interrompue, refusée ou structurellement invalide ; chaque cas suit le circuit de traitement d’erreur approprié.
- Une citation existe, mais ne justifie pas la valeur proposée.
Écrivez les résultats attendus avant de comparer les modèles. Considérez l’abstention délibérée comme une réponse correcte lorsque la source ne permet pas de répondre. Faites examiner indépendamment un échantillon des enregistrements acceptés comme des enregistrements différés. Sinon, un système peut sembler plus sûr simplement parce qu’il évite les cas difficiles, ou plus productif parce qu’il devine sans le signaler.
Faites apparaître les langues des sources et les types de documents dans les résultats. Un tableau de fournisseur en chinois, une notation décimale allemande et une description en prose anglaise constituent des sous-ensembles de test différents. Leurs résultats ne doivent pas disparaître dans une moyenne globale unique.
Mesurez l’acceptation, pas seulement la réussite de l’analyse JSON
Ici, chaque traitement logique demande un enregistrement ; les nouvelles tentatives ne comptent pas comme de nouveaux traitements. Présentez au moins trois indicateurs avec des dénominateurs explicites :
- Taux de conformité au schéma : nombre d’enregistrements conformes au schéma divisé par le nombre d’enregistrements candidats entièrement produits. Signalez séparément les traitements incomplets, refusés et terminés en erreur.
- Couverture de l’acceptation automatique : nombre d’enregistrements automatiquement acceptés divisé par le nombre total de traitements soumis.
- Taux d’erreur parmi les enregistrements acceptés : nombre d’enregistrements acceptés audités comportant au moins une erreur factuelle substantielle ou une erreur substantielle d’affectation à un champ, divisé par le nombre total d’enregistrements acceptés audités.
Voici une comparaison hypothétique, et non une expérience. Chaque système reçoit les mêmes 1 000 traitements soumis et produit un enregistrement candidat complet pour chaque traitement. Dans cet exemple, tout enregistrement qui n’est pas automatiquement accepté est envoyé en révision. Le système A compte 980 enregistrements conformes au schéma et en accepte automatiquement 800 ; un audit exhaustif relève 20 enregistrements acceptés comportant une erreur substantielle. Le système B compte 970 enregistrements conformes au schéma et en accepte 600 ; un audit exhaustif relève 3 enregistrements acceptés erronés.
A arrive en tête pour la conformité au schéma, avec 98 % contre 97 %, et pour la couverture, avec 80 % contre 60 %. B présente un taux d’erreur plus faible parmi les enregistrements acceptés : 0,5 % contre 2,5 %. Aucun n’est meilleur dans l’absolu : le choix dépend des conséquences d’un enregistrement erroné et du coût de vérification des 200 enregistrements différés supplémentaires.
Dans un audit par échantillonnage, indiquez la taille de l’échantillon, la méthode de sélection et l’incertitude, plutôt que de présenter l’estimation ponctuelle comme une garantie. Suivez également le temps de vérification et les échecs récupérables. Un système qui obtient un faible taux d’erreur en envoyant presque tout à une personne peut convenir à une tâche aux conséquences importantes, mais il n’a pas démontré une large capacité d’automatisation.
Une prochaine étape utile
Choisissez un champ qui entraîne des corrections coûteuses. Précisez exactement quelles preuves dans les sources l’étayent, ce qui constitue une information inconnue, quelles transformations sont autorisées et dans quels cas une personne doit trancher. Construisez les cas difficiles avant de changer de modèle.
Lancez ensuite un import à blanc : produisez les enregistrements proposés sans les écrire dans le système opérationnel. Examinez conjointement les erreurs parmi les enregistrements acceptés et la charge de vérification des cas différés. N’étendez les écritures automatiques que lorsque ces résultats respectent le seuil de risque convenu à l’avance.
L’objectif pratique n’est pas de bannir l’inférence des processus utilisant l’IA. Il est d’empêcher qu’une réponse déduite devienne discrètement un fait extrait. Un JSON propre aide le logiciel à exploiter une réponse. Un contrat d’acceptation bien conçu aide les personnes à déterminer quand cette réponse mérite d’être utilisée.
Sources et limites
Cet article associe la documentation officielle des API citée en lien à l’analyse originale des processus menée par SPKE. L’extrait produit, la comparaison des systèmes et le protocole de test recommandé sont illustratifs. Nous n’avons pas réalisé de benchmark entre fournisseurs, mesuré de taux d’erreur en production ni démontré que ces contrôles éliminent les hallucinations. Les capacités des API peuvent évoluer ; vérifiez le modèle et le point d’accès choisis avant le déploiement.