
Du boulier, des engrenages, des bandes de papier et des puces aux réseaux neuronaux et à un horizon ouvert. Illustration conceptuelle originale générée par IA, et non photographie d’une scène historique.
Posé à côté d’un ordinateur actuel, un boulier semble appartenir à un autre monde. L’un fonctionne avec des perles déplacées du bout des doigts ; l’autre écrit du code, reconnaît des photographies et peut même utiliser des logiciels à notre place. Pourtant, ils répondent à la même question : peut-on faire sortir une partie du travail de notre tête ?
Le boulier a inscrit la valeur de position des nombres dans un objet. L’ordinateur a confié l’exécution des règles à une machine. L’apprentissage automatique a franchi un pas supplémentaire : les humains n’ont plus besoin de rédiger toutes les règles, la machine peut apprendre à partir d’exemples. Avec les grands modèles de langage et les agents, nous commençons à déléguer les tâches elles-mêmes : obtenir une réponse ne suffit plus, il s’agit de chercher des informations, d’écrire un programme, de corriger les erreurs et de livrer un résultat.
Cette histoire ne suit pas une ligne droite. Elle a connu des promesses excessives, des financements taris et de longues périodes de stagnation. Elle a aussi avancé grâce à un travail moins spectaculaire : de meilleures méthodes statistiques, des jeux de données plus vastes, des puces moins chères et des logiciels plus fiables. L’accélération actuelle tient à la rencontre de ces progrès accumulés.
Cet article a été écrit le 9/10/2026. Sa première partie raconte ce qui s’est déjà produit. La seconde se tourne vers l’avenir de l’AGI, dont aucune date d’arrivée ne fait consensus. Nous prendrons le risque de parier sur une année, sans faire passer ce pari pour un fait.
Les humains ont d’abord appris à sortir les nombres de leur tête
Le boulier mérite d’ouvrir ce récit, mais il serait imprudent d’en faire « le lieu où l’humanité a inventé la numération positionnelle ». Tables de calcul antiques, baguettes et bouliers à perles appartiennent à une vaste famille ; leur apparition et leur évolution sont des histoires distinctes. En Chine, le boulier à perles a progressivement remplacé les baguettes de calcul vers l’an 1300. Unités, dizaines et centaines y ont chacune leur place, et les retenues ne reposent plus seulement sur la mémoire. Son apport essentiel est d’avoir rendu le calcul positionnel visible et tangible.[1]
Le binaire répond à une autre question : peut-on représenter tous les nombres à l’aide de deux états seulement ? Leibniz a exposé systématiquement cette arithmétique en 1703. Bien plus tard, les circuits électroniques se sont révélés particulièrement aptes à distinguer deux états stables ; le binaire est ainsi devenu le socle du calcul moderne. Il ne pense pas pour autant : il fournit un mode de représentation que les machines peuvent facilement stocker et manipuler.[2]
Babbage a commencé à concevoir la machine analytique en 1834, réunissant calcul, mémoire et commande par programme dans un même projet. La machine n’a jamais été entièrement construite de son vivant, mais l’idée a survécu. Dans ses notes publiées en 1843, Ada Lovelace a exploré plus avant la possibilité de traiter des symboles selon une suite d’instructions. Ce qu’une machine peut faire ne dépend pas seulement de ses engrenages ou de ses circuits, mais aussi de notre capacité à exprimer un problème sous forme de programme.[3] CHM
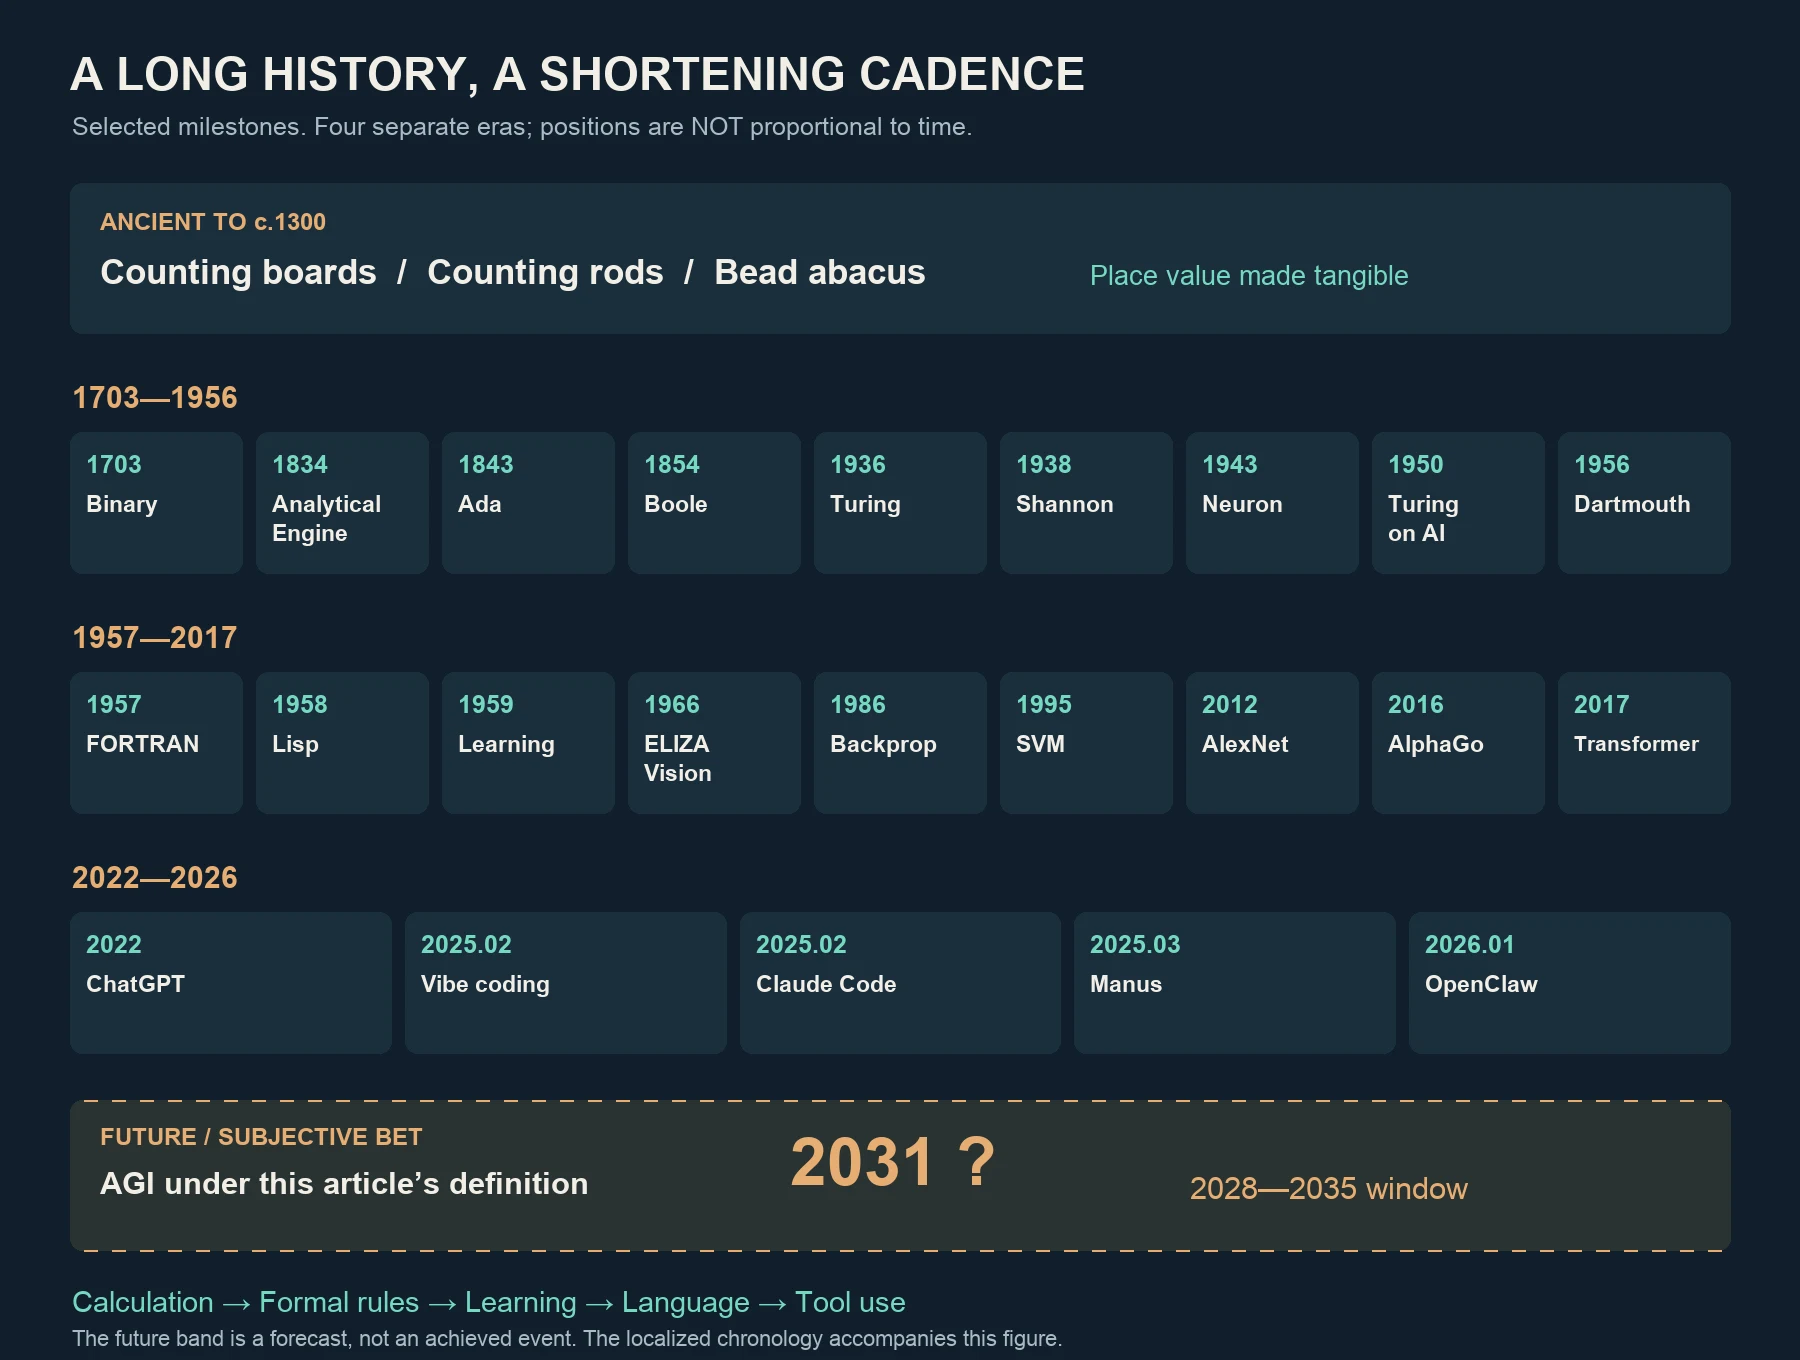
L’histoire du calcul est présentée en quatre périodes : Antiquité, 1703–1956, 1957–2017 et 2022–2026. Les événements suivent l’ordre chronologique, mais leur espacement ne représente pas le temps écoulé. La bande en pointillés montre un pari subjectif sur 2031, dans la fenêtre 2028–2035, et non un événement déjà survenu. Les noms renvoient à la chronologie ci-dessous.
| Date | Jalon | Ce qu’il a apporté |
|---|---|---|
| Antiquité ; vers 1300 | Tables de calcul, baguettes et bouliers à perles | Le calcul peut s’appuyer sur des objets extérieurs ; valeur de position et retenues deviennent des gestes.[1] |
| 1703 | Leibniz expose systématiquement le binaire | Deux symboles suffisent à représenter les nombres, dans un format qui conviendra aux circuits numériques.[2] |
| 1834 ; 1843 | Projet de machine analytique ; notes de Lovelace | Calcul, mémoire et commande par programme commencent à se rejoindre ; le programme se conçoit au-delà d’une opération arithmétique isolée.[3] CHM |
| 1854 | Algèbre de Boole | La logique peut s’exprimer par l’algèbre, qui deviendra un outil intellectuel important pour analyser les circuits numériques.[4] |
| 1936 | Turing propose un modèle abstrait de calcul | La machine de Turing formalise le calcul selon des règles et montre que le calcul a des limites.[5] |
| 1938 | Article de Shannon sur les circuits de commutation | La logique booléenne est reliée aux circuits à relais.Article original |
| 1943 | Modèle de neurone artificiel de McCulloch et Pitts | Une relation mathématique influente est établie entre activité neuronale et opérations logiques.Article original |
| 1950 | Turing publie « Computing Machinery and Intelligence » | La question de savoir si une machine peut penser est déplacée vers son comportement observable dans une interaction.Texte original |
| 1955 ; 1956 | Proposition de Dartmouth ; programme de recherche d’été | « Intelligence artificielle » devient le nom d’un programme de recherche, puis d’un domaine.[6] |
| 1957 ; 1958 | FORTRAN ; Lisp | Le premier fait avancer le calcul scientifique ; le second devient un langage essentiel aux débuts de l’IA.[7][8] |
La machine de Turing n’est pas un ordinateur intelligent prêt à l’emploi. C’est un modèle abstrait qui précise ce que signifie effectuer un calcul en suivant des règles finies. Le travail de Turing en 1936 n’a pas non plus garanti que « tout problème finira par être calculable ». Cette distinction compte : aucun succès ultérieur de l’IA n’a aboli les limites propres aux problèmes.[5]
Dans les années 1950, les chercheurs commencent à demander aux machines autre chose que de « calculer vite » : ils veulent les voir « se comporter de manière intelligente ». La proposition de Dartmouth est rédigée en 1955, et le programme de recherche se tient à l’été 1956. C’est un point de départ majeur de l’IA moderne, pas la première fois que les humains imaginent une intelligence artificielle. Les langages de programmation permettent ensuite de moins manipuler les instructions élémentaires une par une, pour se consacrer davantage aux symboles, à la recherche et au raisonnement.[6][7][8]
Les machines apprennent à voir, à entendre et à estimer
Aux débuts de l’IA, les règles inspirent une grande confiance. Il semble suffire de consigner le savoir des experts pour qu’une machine puisse diagnostiquer des maladies, comprendre des phrases ou commander des équipements. Les difficultés apparaissent vite : le réel comporte trop d’exceptions, et le bon sens se laisse mal écrire dans son intégralité. Les systèmes à règles n’ont pas disparu, mais la recherche s’est peu à peu orientée vers une méthode plus pragmatique : fournir assez d’exemples à la machine pour qu’elle apprenne à décider dans l’incertitude.
La reconnaissance d’images cherche à identifier des objets à partir de pixels ; la reconnaissance vocale, à transformer des sons en texte ; le traitement du langage naturel, ou NLP, à traiter la structure, le sens et l’usage de la langue. Ces domaines ont longtemps suivi des chemins séparés, avant de converger progressivement avec l’apprentissage profond et les modèles multimodaux.
| Date | Jalon | Ce qu’il a apporté |
|---|---|---|
| 1952 | Audrey, système de reconnaissance vocale des chiffres des Bell Labs | Dans des conditions limitées, une machine peut reconnaître des chiffres prononcés ; on reste loin d’une conversation libre.Archives historiques du CHM |
| 1958 | Article de Rosenblatt sur le perceptron | L’ajustement de paramètres à partir d’exemples d’entraînement devient une voie importante des débuts de l’apprentissage automatique.[10] |
| 1959 | Article de Samuel sur l’apprentissage automatique aux dames | Une machine peut améliorer ses performances grâce à l’expérience ; les humains doivent toujours concevoir l’algorithme et l’objectif d’apprentissage.[9] |
| 1966 | ELIZA | Des règles textuelles simples peuvent donner le sentiment d’être compris ; une conversation fluide n’équivaut pas à une compréhension réelle.[11] |
| 1966 | Projet d’été du MIT sur la vision | Les chercheurs tentent de transformer les structures d’une image en descriptions exploitables par une machine ; la tâche s’avérera bien plus difficile que prévu.Document original |
| Années 1970—1980 | Hivers de l’IA et essor puis déclin des systèmes experts | Attentes, puissance de calcul et capacités réelles ne coïncident pas ; l’histoire de l’IA n’est pas une courbe de hausse continue.[12] CHM |
| 1986 | Article de référence sur la rétropropagation | Une méthode d’entraînement plus influente facilite l’apprentissage des réseaux multicouches ; les idées apparentées ne naissent pas cette année-là.[13] |
| Années 1980—1990 | Reconnaissance vocale et NLP statistiques | Les probabilités servent à traiter ambiguïtés et bruit, en remplaçant peu à peu l’espoir de rédiger toutes les règles.Synthèse sur la parole ; article sur la traduction statistique |
| 1995 | Article de Cortes et Vapnik sur les machines à vecteurs de support | Des frontières de classification robustes peuvent être construites avec un nombre limité d’exemples ; c’est un outil majeur de l’apprentissage automatique.[14] |
| 1997 | Deep Blue bat Kasparov | Un système spécialisé peut dépasser un joueur d’élite ; cette force aux échecs ne se transforme pas automatiquement en aptitude générale.[15] |
| 1998 | Article de référence sur LeNet | Les réseaux convolutifs montrent leur utilité pratique dans la reconnaissance de chiffres manuscrits et de documents, entre autres tâches.[16] |
| Années 2000—2010 ; 2013 | Prédiction du taux de clic à grande échelle ; article de référence de Google | L’apprentissage automatique entre dans la décision commerciale en temps réel, et affine ses prédictions grâce à des retours massifs.[19] |
| 2009 ; 2012 | Jeu de données ImageNet ; AlexNet | Données massives, GPU et réseaux profonds convergent ; la reconnaissance d’images connaît une percée notable.[17][18] |
| 2012 | Synthèse sur la reconnaissance vocale par réseaux neuronaux profonds | L’apprentissage profond transforme la modélisation acoustique et ouvre une nouvelle phase d’amélioration des systèmes vocaux.Synthèse de recherche |
| 2014 | GAN | L’entraînement antagoniste élargit les voies des modèles génératifs.Article original |
| 2016 ; 2017 | AlphaGo bat Lee Sedol, puis Ke Jie | Réseaux profonds, recherche et apprentissage par renforcement se combinent pour maîtriser le go, jusque-là extrêmement difficile.[20] BGA |
| 2017 | Transformer | L’attention fournit une architecture mieux adaptée à l’entraînement parallèle, qui deviendra une base essentielle des grands modèles de langage.[21] |
| 2018 | BERT | Le préentraînement bidirectionnel fait progresser les tâches de compréhension du langage ; les modèles commencent à partager des représentations linguistiques plus générales.Article original |
| 2020 | GPT-3 | Les prompts à quelques exemples montrent qu’un grand modèle peut accomplir diverses tâches grâce au contexte, malgré des limites de fiabilité.[22] |
| 2020 | DDPM | Les modèles de diffusion par débruitage font avancer la génération d’images ; ce n’est pas l’origine de toutes les idées de diffusion.Article original |
| 2020 ; 2021 | Percée d’AlphaFold à CASP14 ; article décrivant la méthode | La prédiction de la structure des protéines fait un bond majeur ; prédire une structure ne signifie pas qu’un nouveau médicament a déjà été validé.Article original |
Les machines à vecteurs de support, ou SVM, incarnent bien l’esprit de cette époque : même sans les fenêtres de dialogue d’aujourd’hui, l’apprentissage automatique résout des problèmes sérieux et concrets. Reconnaître un courrier indésirable ou classer une image est souvent plus utile que proclamer que les machines pensent.[14]
La prédiction du taux de clic porte cette capacité à l’échelle industrielle. Le système estime « la probabilité que cette impression publicitaire suscite un clic dans ce contexte », généralement désignée par CTR. Il ne lit pas dans les pensées et ne garantit pas qu’une personne cliquera. Les probabilités doivent être calibrées, et les systèmes affrontent aussi les changements de distribution, les contraintes de confidentialité et les biais de rétroaction. L’enjeu est là : l’apprentissage automatique entre dans une boucle qui fonctionne en continu et influence les revenus comme la circulation de l’information.[19]
La percée de la reconnaissance d’images en 2012 a redonné à beaucoup confiance dans les réseaux neuronaux. AlphaGo a rendu ce changement visible au grand public en 2016. Le score de 4:1 était celui d’un défi en cinq parties contre Lee Sedol, pas d’une victoire dans un championnat du monde ; face à Ke Jie, en 2017, le résultat du match en trois parties a été de 3:0. Ces victoires sont assez stupéfiantes pour qu’on n’y ajoute pas un titre de « champion » inexact.[18][20] BGA
Après ChatGPT, il ne s’agit plus de répondre, mais de livrer
Le 30/11/2022, ChatGPT s’ouvre au public. Son importance ne tient pas seulement à la puissance du modèle : les non-spécialistes disposent enfin d’une porte d’entrée d’une simplicité remarquable. Sans savoir programmer, ils peuvent parler directement à la machine pour obtenir des explications, des reformulations, des traductions ou des programmes. L’IA cesse d’être uniquement une fonction cachée dans les produits ; elle devient un outil que les gens choisissent d’utiliser.[23]
L’évolution dépasse vite la fenêtre de dialogue. Les modèles peuvent lire davantage de documents et se connecter à la recherche, aux fichiers, aux moteurs d’exécution de code et aux navigateurs. Un agent désigne ici un système d’exécution construit autour d’un modèle : il conserve l’état de la tâche, appelle des outils, vérifie les résultats et décide de l’étape suivante. Le modèle produit des inférences, le système d’exécution les relie au monde. Tous deux peuvent se tromper.
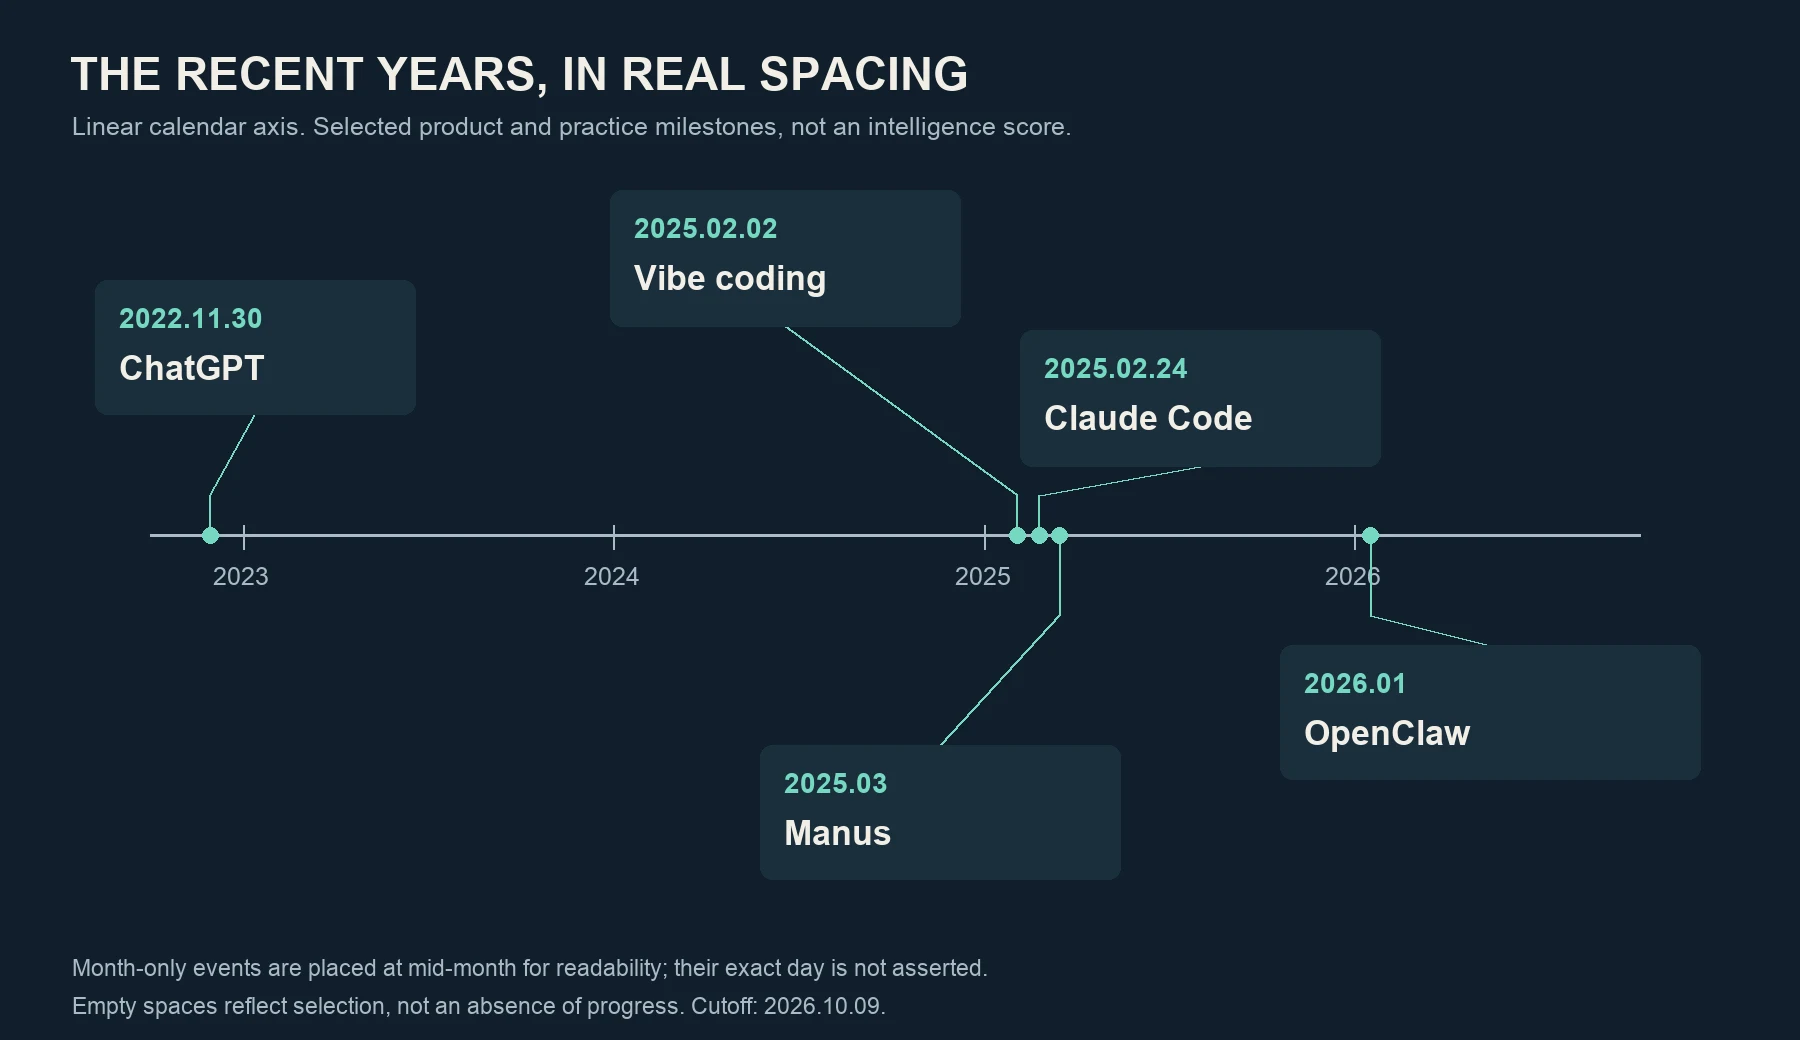
La chronologie récente de 2022—2026 utilise une échelle linéaire des années : les jalons ChatGPT, vibe coding, Claude Code, Manus et OpenClaw sont nettement rapprochés. Seuls les événements retenus dans cet article y figurent ; leur nombre ne mesure pas un niveau d’intelligence générale. Les événements dont seul le mois est connu sont placés au milieu du mois, sans prétendre connaître le jour exact.
| Date | Jalon | Comment le comprendre |
|---|---|---|
| 30/11/2022 | Lancement public de ChatGPT | Le langage naturel devient la porte d’entrée de l’IA générative pour le grand public.[23] |
| 2/2025 | Diffusion de l’expression « vibe coding » | Karpathy décrit une pratique qui s’appuie fortement sur le code généré et accorde moins de place à sa compréhension ligne par ligne ; ce n’est pas un synonyme de tout développement assisté par IA.Copie du message original |
| 24/2/2025 | Avant-première de recherche de Claude Code | L’assistant de programmation arrive dans le terminal et peut travailler avec les dépôts de code et les outils.[24] |
| 3/2025 | Première présentation publique de Manus | Ce produit d’agent destiné à livrer des tâches en plusieurs étapes met la délégation au premier plan.[25] |
| 1/2026 | Changement de nom et diffusion publique d’OpenClaw | Les interfaces de messagerie, l’état persistant et les connexions aux outils d’un agent personnel autogéré attirent l’attention ; il s’agit d’un système d’exécution, pas d’un nouveau modèle de fondation.[26] |
Claude Code et le vibe coding sont souvent cités ensemble, mais ne sont pas interchangeables. Le premier est un outil ; le second, une manière de l’utiliser. Des développeurs professionnels peuvent employer le même outil tout en lisant attentivement le code, en examinant les modifications et en lançant des tests. Faire écrire plus vite la machine ne fait pas disparaître la responsabilité.[24] Copie du message original de Karpathy
Manus et OpenClaw illustrent deux choix de produit représentatifs : confier à un service des tâches en plusieurs étapes, ou relier un assistant permanent à son propre environnement. Ils rendent visible le potentiel de l’exécution autonome, tout en soulevant de nouvelles difficultés : quels droits accorder, comment détecter un échec, comment réparer une opération déjà effectuée à tort ? Ces questions comptent autant que la capacité d’un modèle à répondre correctement.[25][26]
L’accélération est réelle, mais il faut préciser ce qui accélère
Il a fallu aux humains un temps immense pour conserver et transmettre les connaissances, des décennies pour confier des règles aux machines électroniques, puis quelques années seulement pour passer des assistants de conversation grand public à l’exécution par des outils quotidiens. À l’échelle d’une vie, la compression est saisissante. Autrefois, une personne pouvait conserver les mêmes méthodes de travail de son entrée dans l’âge adulte à la fin de sa carrière ; désormais, les interfaces et les limites des outils peuvent changer plusieurs fois en quelques années.
On peut le dire ainsi : les cycles de renouvellement de nombreux outils cognitifs sont passés de plusieurs générations à une seule vie, puis de quelques décennies à quelques années. Cela ne permet pas d’affirmer que la « quantité totale de progrès » des dernières années dépasse celle des décennies précédentes, ni que ces décennies dépassent toute l’évolution biologique humaine. Ces comparaisons n’ont pas d’unité de mesure commune. Les outils de pierre, l’écriture, l’agriculture, la révolution industrielle et les modèles de langage ne sont pas des scores que l’on peut additionner.
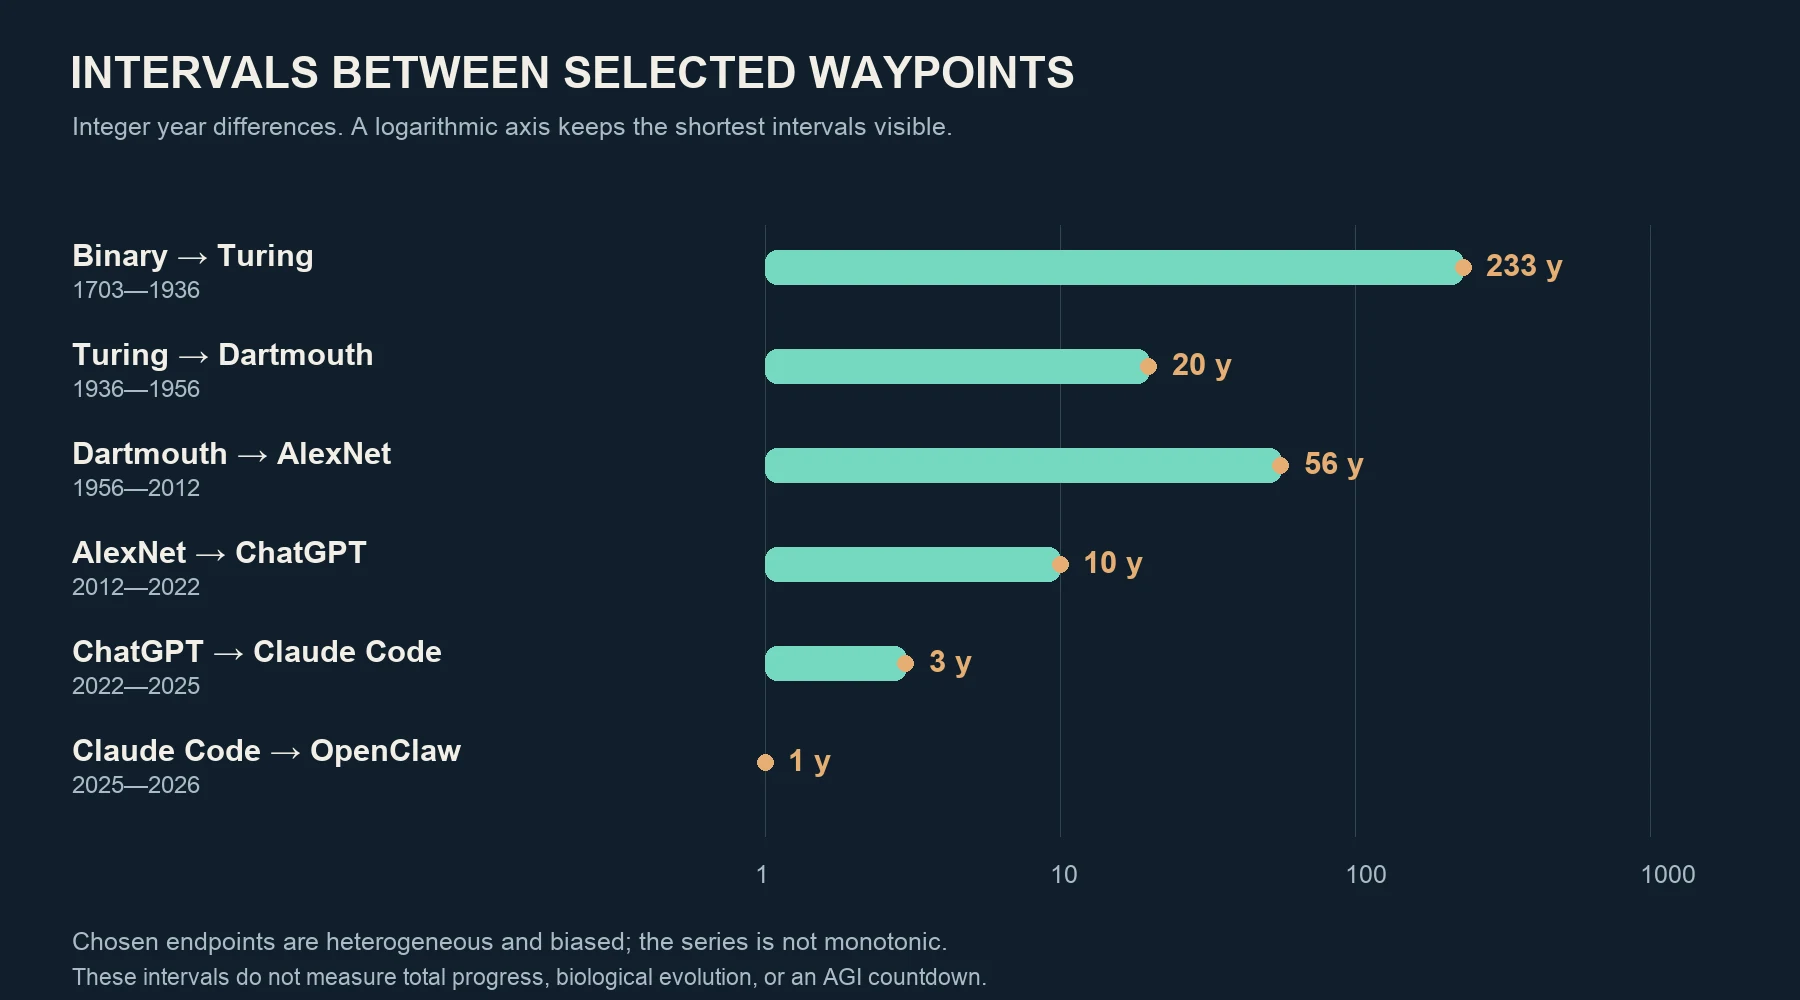
Intervalles entre quelques jalons choisis : 1703—1936 représente 233 ans, 1936—1956 20 ans, 1956—2012 56 ans, 2012—2022 10 ans, 2022—2025 3 ans et 2025—2026 1 an. La longueur des barres suit une échelle logarithmique ; les valeurs sont des différences entre années entières. La sélection est biaisée et les intervalles ne diminuent pas toujours : on ne peut pas en déduire un taux de croissance de l’intelligence.
Des preuves plus solides de l’accélération viennent de mesures précises. L’AI Index 2025 de Stanford indique que, pour atteindre une performance MMLU du niveau de GPT-3.5, le coût d’inférence est passé de 20 dollars par million de tokens en 11/2022 à 0.07 dollar en 10/2024, soit une baisse d’un facteur supérieur à 280. La comparaison porte sur le coût à un seuil de capacité précis ; elle ne signifie pas que tous les modèles sont devenus moins chers dans les mêmes proportions.[28]
Dans une étude publiée en 2025, METR observe un changement plus proche de la question « quelle longueur de tâche peut être accomplie ? ». Sur son ensemble de tâches logicielles et de raisonnement, la durée de travail d’un expert humain correspondant aux tâches que les IA de pointe réussissent avec une probabilité de 50% a approximativement doublé tous les 7 mois depuis 2019. Il s’agit bien du temps nécessaire à un humain pour effectuer la tâche ; réussir la moitié des tentatives n’est pas une livraison fiable. L’étude donne des raisons d’extrapoler, mais laisse subsister de fortes limites à la généralisation dans le monde réel.[27]
L’accélération peut aussi créer ses propres conditions. Une IA meilleure aide à écrire des logiciels, à mener des expériences et à optimiser des systèmes, travaux qui peuvent à leur tour améliorer la génération d’IA suivante. Mais une boucle de rétroaction n’est pas forcément une boucle sans fin. Qualité des données, énergie, puces, rythme des expériences, fiabilité et adoption par les organisations peuvent freiner le mouvement. Les hivers passés le rappellent : une courbe a pu monter pendant un temps sans que cela exclue des paliers et des reculs.
Je parie sur 2031, à condition de définir d’abord le seuil de l’AGI
AGI signifie généralement intelligence artificielle générale, mais le degré de « généralité » n’a pas de définition unanime. Certains attendent une couverture de la plupart des tâches économiques, d’autres mettent l’accent sur l’apprentissage de compétences inconnues, d’autres encore y ajoutent l’autonomie. Les travaux sur les niveaux d’AGI distinguent capacité, étendue et autonomie : une approche plus utile que de débattre d’un slogan.[29]
Cet article s’intéresse uniquement à une AGI pratique : dans un environnement numérique où les droits sont explicitement accordés, elle peut apprendre de nouvelles tâches et accomplir de manière stable un large éventail de travaux cognitifs professionnels, à un coût acceptable. Cela n’exige ni conscience ni corps humain, et ne désigne pas une superintelligence supérieure à tous les humains dans tous les domaines.
Pour rendre la prévision vérifiable à l’avenir, fixons un seuil conventionnel. C’est la définition opérationnelle de cet article, et non une norme de l’industrie ou une certification de sécurité :
| Critère | Seuil retenu dans cet article |
|---|---|
| Étendue | Dans au moins 5 des 6 catégories suivantes — génie logiciel, analyse documentaire, assistance à la recherche, compréhension multimodale, planification et apprentissage de nouveaux outils — atteindre le niveau médian d’humains qualifiés. |
| Tâches inconnues | Au moins 100 tâches non publiques par catégorie ; contrôler les fuites de données d’entraînement, tout en autorisant un usage raisonnable des outils et l’apprentissage de nouvelles tâches. |
| Fiabilité | Dans chacun des domaines qui satisfont au seuil, réussir au moins 90% des tâches ; les résultats sont jugés selon des critères vérifiables fixés à l’avance. |
| Tâches longues | Les tests comprennent des tâches demandant au moins 8 heures à un expert humain ; au maximum 2 demandes de clarification humaine par tâche, sans sauvetages incessants par des personnes. |
| Coût | En comptant inférence, outils, vérification et reprises, le coût par tâche ne dépasse pas celui d’un humain soumis aux mêmes critères de réception. |
| Reproductibilité | Au moins 2 organismes d’évaluation indépendants reproduisent les résultats ; le système maintient ces performances pendant 90 jours d’évaluation continue, au lieu de se limiter à une démonstration brillante. |
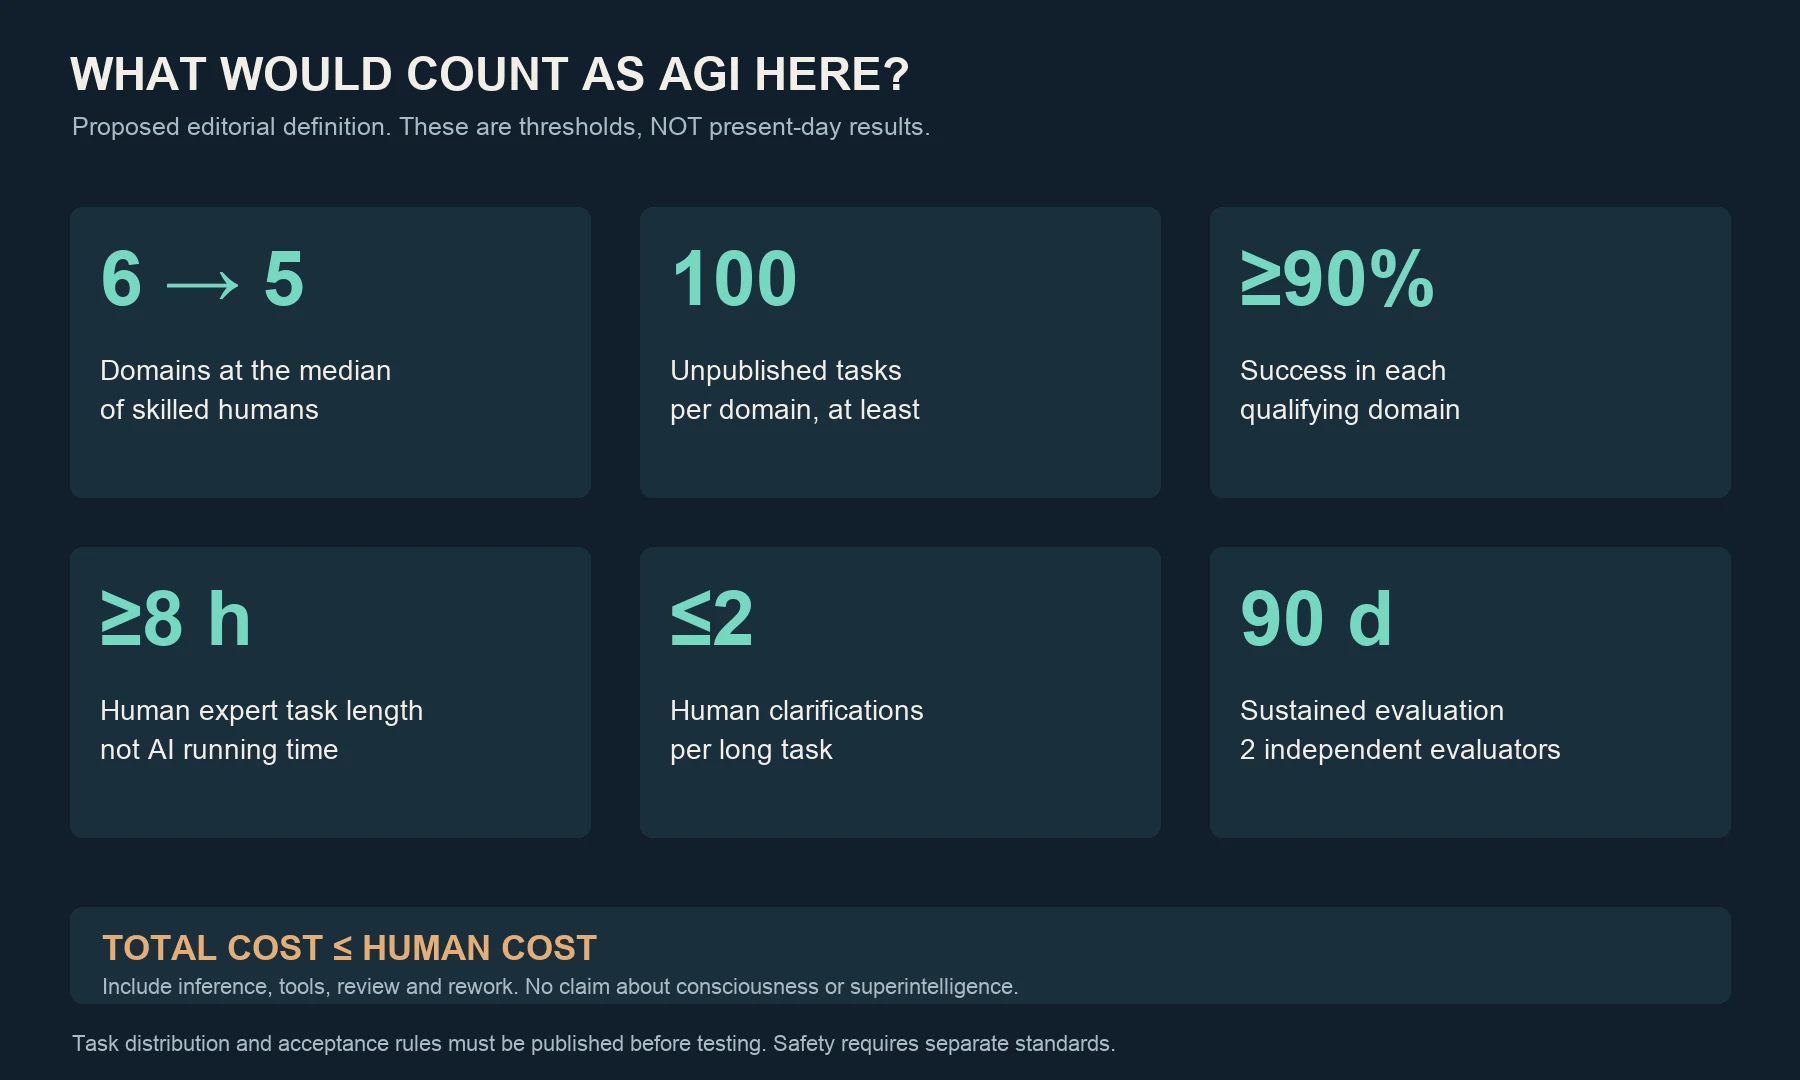
Schéma du seuil d’AGI retenu ici : au moins 5 catégories sur 6, 100 tâches non publiques, 90% de réussite, des tâches longues de 8 heures humaines, au maximum 2 clarifications et une reproduction sur 90 jours. Les chiffres sont des exigences conventionnelles de réception, pas des performances mesurées de systèmes actuels ni une norme consensuelle de l’AGI.
Ces critères restent discutables. Il faut publier à l’avance l’échantillonnage des tâches, le recrutement des humains qualifiés et la manière de juger l’aide à la recherche ; les tâches touchant à la sécurité des personnes exigent aussi des règles professionnelles et réglementaires distinctes. Leur utilité est de remplacer « on a l’impression d’y être » par un jugement que l’on peut contester, retester et réfuter.
S’il faut choisir une année, je parie sur 2031. Je préfère regarder la fenêtre 2028—2035 plutôt que deviner un mois ou un jour. Voici mes probabilités cumulées subjectives à la date de l’article, concernant la première confirmation indépendante selon les critères ci-dessus ; elles ne sont calibrées par aucun modèle statistique et ne représentent pas un consensus d’experts :
| Première confirmation | Ma probabilité cumulée subjective |
|---|---|
| D’ici fin 2028 | 20% |
| D’ici fin 2031 | 50% |
| D’ici fin 2035 | 75% |
| Après 2035, ou si les approches actuelles n’atteignent finalement pas ce seuil | Les 25% restants |
2031 est le jugement médian de cette distribution subjective, pas une échéance technique. Les 75% à l’horizon 2035 incluent déjà les probabilités précédentes : il ne faut pas additionner les lignes du tableau. Les 25% restants ne signifient pas non plus que l’AGI n’arrivera jamais ; ils recouvrent une arrivée plus tardive et l’échec des approches actuelles.
Je fais ce pari parce que langage, vision, programmation et usage des outils convergent, tandis que les capacités sur les tâches longues et les coûts dessinent des tendances qui méritent d’être prises au sérieux. Mais les difficultés les plus ardues sont peut-être celles de la dernière étape : apprendre durablement de nouvelles compétences, reconnaître ses propres erreurs, rester fiable dans des environnements inconnus et accomplir un travail qui demande des retours expérimentaux. Si ces obstacles résistent davantage que prévu, il faudra repousser l’année.[27][28][29]
Qu’est-ce qui me ferait changer d’avis ? Une amélioration continue de la réussite des tâches longues avec peu d’intervention humaine, du transfert aux tâches inconnues et du coût total, reproduite de manière indépendante, augmenterait ma probabilité d’une arrivée précoce. Si la hausse des classements tient surtout à des sujets familiers, si les humains continuent à prendre le relais pour les tâches longues ou si la baisse des coûts s’arrête, je la réduirais. Davantage de conférences de lancement et de démonstrations ne suffiraient pas, en soi, à modifier mon jugement.
L’arrivée de l’AGI pourrait d’ailleurs ne pas être annoncée par un coup de cloche net. Certains la jugeront déjà suffisante pour leur travail, quand d’autres buteront encore sur ses échecs ; des évaluateurs confirmeront ses capacités, puis la société changera progressivement. Franchir un seuil technique, adopter un produit et adapter les institutions sont des événements distincts.
L’avenir optimiste : les capacités humaines deviennent moins rares
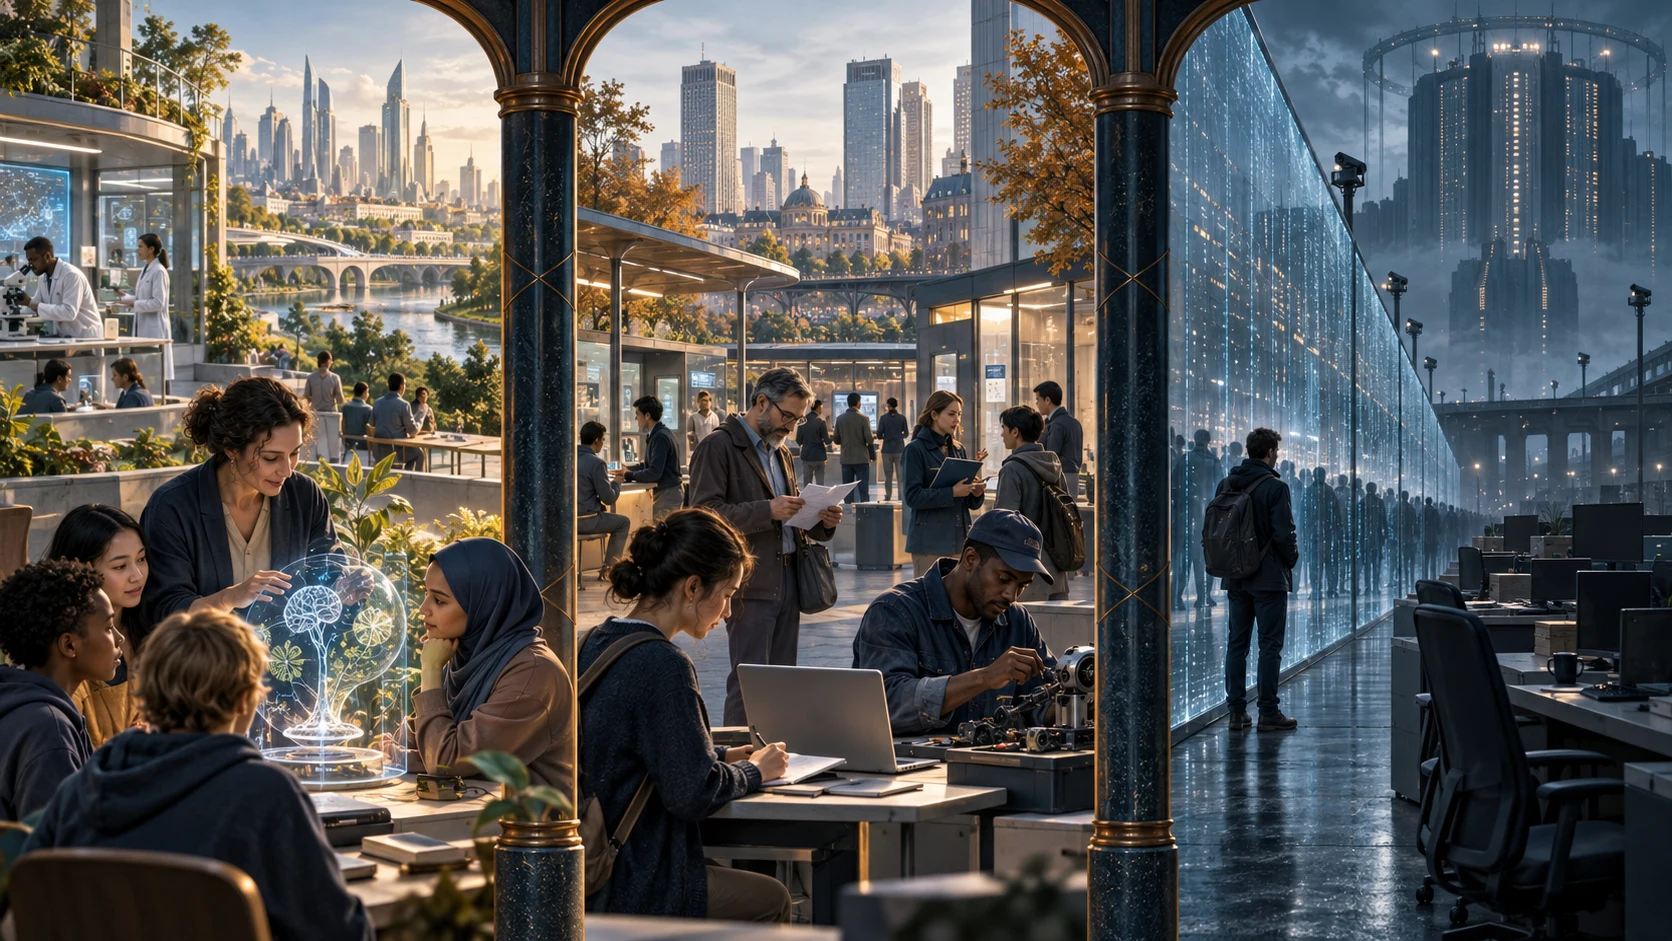
À gauche, partage du savoir et progrès médicaux ; au centre, transition professionnelle et ajustements quotidiens ; à droite, concentration du pouvoir et pression du chômage. Illustration conceptuelle originale générée par IA : trois avenirs conditionnels, sans indication de leur probabilité.
Le scénario optimiste suppose que les capacités soient largement accessibles, que les déploiements restent fiables et que la société accepte de partager les gains de productivité avec davantage de personnes. Si seules quelques institutions peuvent s’offrir les meilleurs systèmes, le récit change dès le départ.
En science, l’AGI pourrait aider à lire la littérature, à concevoir des expériences possibles et à analyser leurs résultats, en réduisant le travail répétitif des essais et des erreurs. Une petite équipe disposerait peut-être de capacités de calcul et d’analyse autrefois réservées à de grands groupes. La recherche sur les médicaments, les matériaux et l’énergie pourrait accélérer, mais les molécules candidates devraient toujours être validées, les essais cliniques prendraient toujours du temps et les équipements de laboratoire ne surgiraient pas d’un texte généré. Le progrès optimiste est de trouver plus vite des résultats fiables, pas de promettre la disparition des maladies en une nuit.
Dans l’éducation et les soins, chacun pourrait bénéficier d’un accompagnement continu et patient à moindre coût. Les enseignants auraient plus de temps pour prendre en compte les différences entre élèves, les médecins pour comprendre la situation de leurs patients. Les régions éloignées gagneraient peut-être d’abord un accès à une information mieux organisée, au dépistage initial et à l’assistance à distance. Pour que l’amélioration soit équitable, il faudrait des réseaux accessibles, les langues locales, la protection de la vie privée et une personne responsable de la décision finale.
Le travail pourrait aussi laisser plus de marge. Avec moins de rédaction administrative, de vérifications et de coordination répétitives, les humains consacreraient davantage de temps à la communication, au jugement, au soin et à la création. De petites entreprises réaliseraient ce qui leur demandait autrefois une équipe spécialisée hors de portée ; il serait plus facile de transformer une idée en produit. Si les gains de productivité se traduisaient par un coût de la vie réduit, des horaires plus courts et de meilleurs services publics, la vie de la majorité s’améliorerait.
Cela ne se produirait pas automatiquement. Salaires, fiscalité, politique de concurrence et investissements publics déterminent la répartition des bénéfices. Une meilleure technologie agrandit ce que l’on peut partager ; elle ne décide pas à la place de la société comment le partager. Dans ce scénario, la valeur humaine se déplacerait peu à peu de « combien de tâches standardisées puis-je faire ? » vers « que veux-je faire, quelles responsabilités suis-je prêt à prendre et comment vivre avec les autres ? ».
L’optimisme n’exige pas non plus de cesser d’apprendre. Les connaissances fondamentales permettent de repérer les absurdités de la machine ; l’expérience professionnelle aide à décider si un résultat mérite d’être utilisé. Ce qui change, c’est que l’apprentissage ne sert plus uniquement à suivre chaque nouvel outil : il sert à poser de meilleures questions et à conserver son jugement.
L’avenir pessimiste : des machines puissantes, une société dépassée
Le scénario pessimiste n’exige pas que les machines aient d’abord de mauvaises intentions. Il suffit que le remplacement du travail soit plus rapide que les reconversions, et que les bénéfices se concentrent chez les propriétaires de la puissance de calcul, du capital, des données et des accès à la distribution. Beaucoup pourraient perdre leur revenu avant de voir apparaître la hausse de productivité dans les statistiques nationales.
Les premiers emplois sous pression seraient peut-être ceux dont les tâches sont faciles à numériser et les résultats faciles à vérifier. Cela ne condamne pas une profession entière : chaque métier rassemble des tâches différentes. Mais si la demande de rédaction débutante, d’analyse élémentaire, de développement simple et de service client courant chute fortement, les jeunes rencontreront un problème particulièrement difficile : les premiers emplois qui permettaient d’acquérir de l’expérience disparaîtront, alors que le jugement avancé exigera toujours cette expérience. En recrutant moins de débutants, les entreprises priveront peu à peu la société de l’échelle qui permet de former ses experts.
La concentration du pouvoir amplifierait cette pression. Si quelques organisations contrôlent les meilleurs modèles, la puissance de calcul et les interfaces d’exécution, elles ne fixent pas seulement les prix : elles peuvent influencer l’accès au savoir, les critères d’évaluation des personnes et la visibilité des contenus. Surveillance, fraude et persuasion ciblée peuvent prendre de l’ampleur grâce à une intelligence moins coûteuse. L’information devient plus abondante, mais le débat public peut avoir plus de mal à établir ce qui est vrai.
Les risques de sécurité comportent une autre dimension. Avec un objectif mal défini, des autorisations trop larges ou des contrôles absents, un système puissant peut enchaîner l’exécution de ses erreurs. Il peut envoyer des messages à tort, divulguer des données, produire des logiciels défectueux, voire causer des dommages concrets dans des environnements sensibles. Les scénarios plus extrêmes de perte de contrôle impliquent tromperie, contournement de la supervision ou acquisition de ressources supplémentaires. Ce sont des mécanismes possibles à étudier et à prévenir ; une chronologie historique ne suffit pas à leur attribuer des probabilités crédibles.
Les États pourraient aussi traiter l’IA avancée comme une ressource stratégique sur laquelle ils ne peuvent se laisser distancer. La pression de la course pousserait des institutions à raccourcir les évaluations, à dissimuler les échecs ou à connecter les systèmes à des infrastructures critiques. Le danger ne viendrait plus d’une réponse incorrecte, mais de nombreuses organisations acceptant simultanément des risques excessifs. Armements, cyberattaques et déploiement dans les systèmes critiques demandent tout particulièrement d’inscrire autorisations, audits, isolation et responsabilité humaine dans les institutions.
Les pertes individuelles seraient plus discrètes. Déléguer durablement son jugement à la machine pourrait affaiblir l’écriture, le raisonnement, l’orientation et les aptitudes sociales. La commodité éroderait progressivement l’autonomie ; ce n’est qu’après une interruption de service, une hausse des prix ou une manipulation des réponses que l’on découvrirait l’absence de solution de rechange. Dans cet avenir, des technologies toujours plus puissantes ne rendraient pas nécessairement les humains plus libres.
Le scénario neutre : de grands changements, de longs ajustements
Le quotidien que j’imagine le plus facilement mêle les trois scénarios. Certaines tâches deviennent vite moins coûteuses, certains métiers évoluent lentement, et quelques domaines restent dirigés par des humains pour des raisons de sécurité et de responsabilité. Des entreprises réussissent, des déploiements échouent ; certains gagnent du temps, d’autres perdent du pouvoir de négociation.
Si l’AGI franchit d’abord le seuil de cet article dans le travail numérique, elle ne saura pas immédiatement réparer une conduite, s’occuper des personnes âgées ou construire un réseau électrique. Le monde réel comporte des corps, des matériaux, des lieux et des chaînes de responsabilité. Fabrication des robots, renouvellement des infrastructures, autorisations et procédures des organisations demandent chacun leur propre temps. Le coût du travail cognitif pourrait changer en premier, sans que les prix du logement, de l’énergie ou des soins baissent au même rythme.
Sur le marché du travail, le premier effet sera probablement une recomposition des tâches. Une équipe emploie moins de personnes pour les premières versions et consacre davantage de travail à la réception et à la coordination ; une personne gère plus de projets, tout en portant une responsabilité accrue en cas d’erreur. Productivité et intensité du travail pourraient même augmenter ensemble. L’étude de l’ILO sur l’exposition professionnelle à l’IA générative rappelle elle aussi qu’une tâche affectée n’implique pas nécessairement le remplacement intégral d’un emploi. On ne peut pas transformer directement ce constat en prévision des effets de l’AGI sur l’emploi, mais la distinction doit rester présente dans l’analyse.[30]
Les institutions tenteront de rattraper la réalité. Les écoles modifieront leurs évaluations, les entreprises réorganiseront les droits d’accès, tribunaux et régulateurs traiteront les responsabilités, assurances et audits commenceront à fixer leurs prix. Dans bien des endroits, la transition pourrait suivre une règle : « l’action est autorisée par défaut, les étapes critiques exigent une signature humaine ». Cela ressemblerait moins à une mise à niveau générale de la société qu’à une succession de réparations disputées.
L’évolution psychologique prendra elle aussi du retard sur les outils. Voir une compétence maîtrisée perdre soudain sa rareté peut provoquer amertume et inquiétude ; les nouvelles possibilités enthousiasment, mais la poursuite sans fin peut aussi lasser. Une efficacité accrue n’apporte pas automatiquement un sentiment d’identité stable. Le soin, l’amitié, l’expérience du corps, le goût esthétique et la participation à la vie publique resteront des repères importants pour organiser sa vie.
Même en pariant sur 2031, je ne parie donc ni sur « le chômage pour tous à partir de cette année-là », ni sur « la prospérité pour tous dès cette année-là ». Les percées techniques peuvent se concentrer dans le temps ; leurs conséquences sociales se déploieront selon les régions, les secteurs et les groupes de population. L’avenir neutre ne signifie pas un petit changement, mais un changement immense, des résultats inégaux et une adaptation lente.
Ce qu’il faut préparer, ce sont nos jugements et nos choix
Cette histoire donne de l’élan, et un peu le vertige. Le boulier ne calcule que lorsque des doigts déplacent ses perles ; les machines actuelles peuvent déjà saisir une demande vague et chercher comment la satisfaire. Nous faisons sortir une part croissante du travail cognitif de notre tête, tout en apprenant encore à juger le résultat, à assumer les responsabilités et à répartir les bénéfices.
Pour chacun, il vaut la peine de préserver ses bases professionnelles, ses habitudes de vérification, ses compétences transférables et des façons de travailler qui ne dépendent pas d’un service unique. Les entreprises ont intérêt à investir dans des procédures vérifiables, des évaluations sur des tâches réelles, des droits clairs et des opérations dont on peut réparer les effets. Pour la société, le plus difficile sera d’éviter que les gains de productivité deviennent seulement l’avantage de quelques-uns, et que les exigences de sécurité restent de simples déclarations.
On peut se tromper sur l’année de l’AGI. Le pari à ne pas faire est qu’une machine suffisamment intelligente donnera automatiquement à l’humanité un bel avenir. Depuis le boulier, les outils étendent la puissance humaine. La question qui vient est de savoir qui détiendra cette puissance, comment elle sera employée et quelle vie nous voulons construire avec elle.