
Parfois, le monde ressemble vraiment à une organisation montée à la va-vite.
À suivre le secteur de l’IA, on se croirait déjà au seuil du futur. Les modèles écrivent du code, résolvent des problèmes difficiles, et les agents sont censés prendre en charge des processus entiers. Le débat sur le travail qui restera aux humains s’anime un peu plus chaque jour. Puis vient le moment où l’on a besoin de ces outils pour travailler, et la réponse n’arrive pas.
Même DeepSeek, que beaucoup considèrent comme une référence de l’IA, peut tomber en panne.
Selon l’avis publié par DeepSeek, une défaillance de ses systèmes a empêché l’utilisation normale de son API le 15 octobre 2026, de 8 h 11 à 13 h 04, heure de Pékin, UTC+8. Ces horaires représentent exactement quatre heures et 53 minutes, presque cinq heures. Dire que le service est resté en panne « une demi-journée » traduit l’agacement ; avoir perdu l’essentiel d’une matinée de travail est bien réel.[1][2]
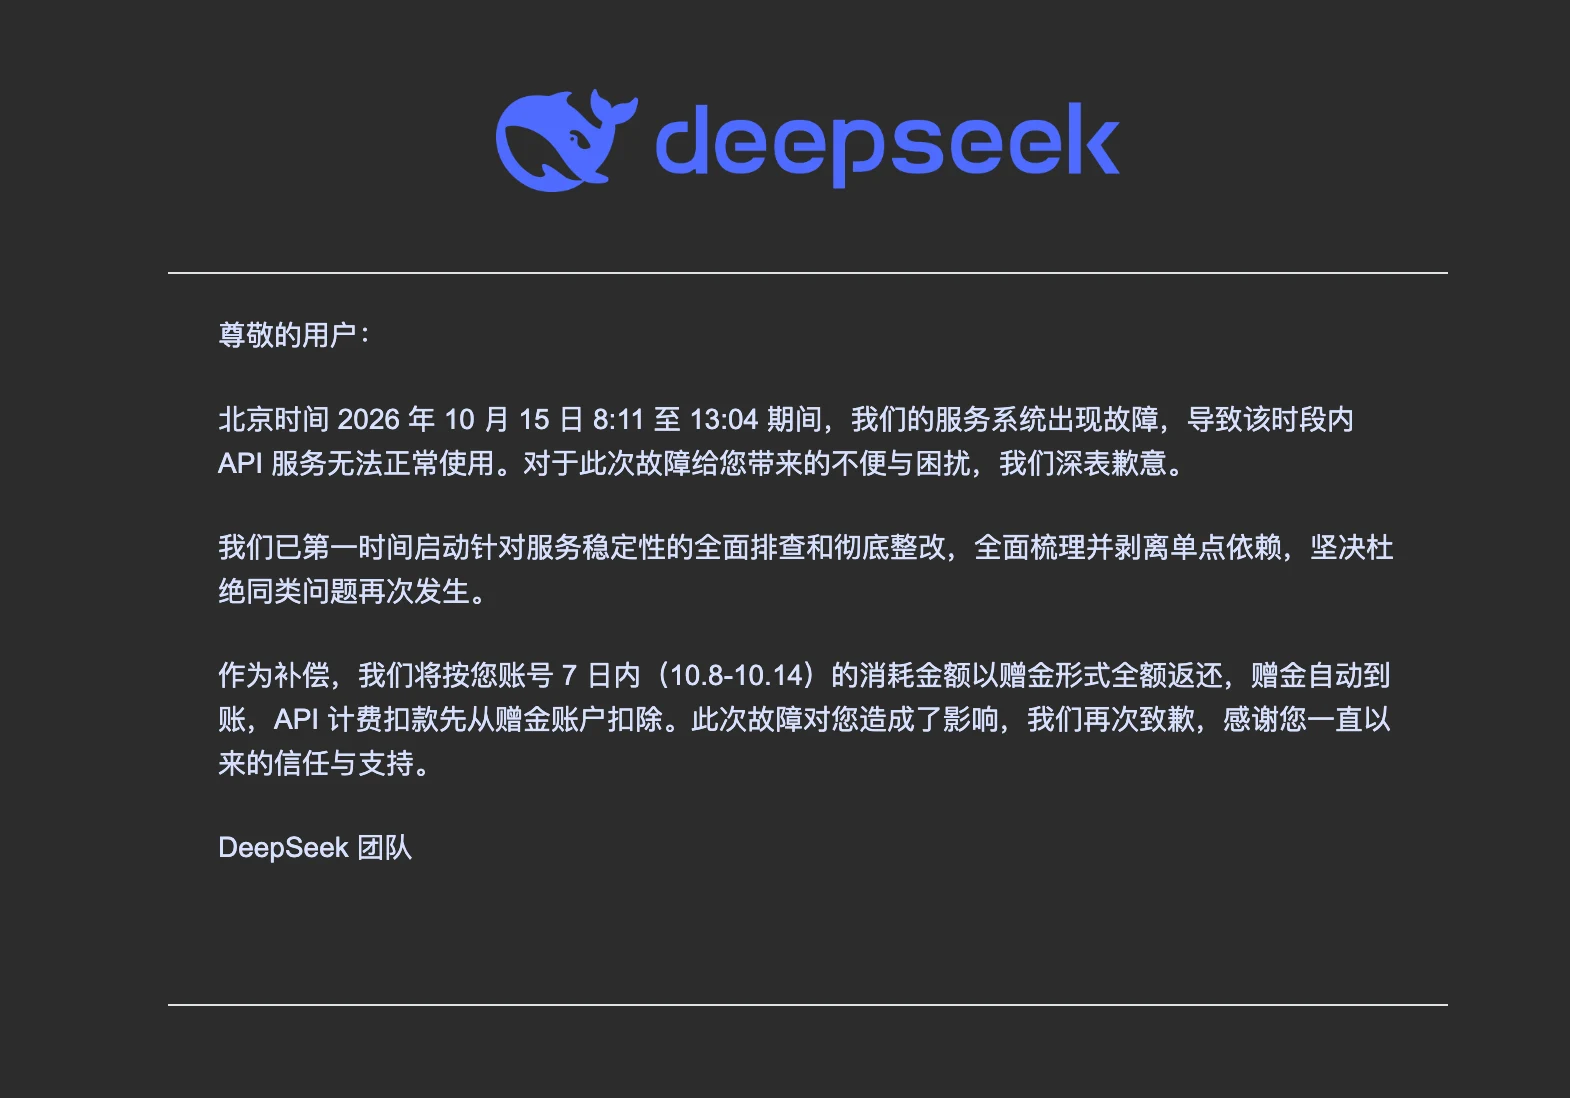
Avis de DeepSeek sur le rétablissement du service et l’indemnisation, fourni par un lecteur. Les horaires et les modalités d’indemnisation correspondent aux informations publiées le même jour.
Pour une simple conversation, on peut fermer la fenêtre et revenir plus tard. Mais dès qu’une API entre dans un produit, un service client, un traitement de contenus ou un processus interne, une interruption en amont peut obliger toute la chaîne à attendre. Les utilisateurs réclament votre livraison, les clients s’adressent à votre équipe. Les bonnes performances habituelles du modèle ne leur font pas accepter automatiquement plusieurs heures de silence.
Cette panne rappelle une exigence essentielle : les capacités du modèle et la fiabilité du service doivent chacune faire leurs preuves.
Répondre correctement à une question est une chose. Fournir cette réponse au moment où l’activité en a besoin en est une autre. La première trouve facilement sa place dans les classements et les conférences de lancement. La seconde ne fait souvent l’objet d’un débat sérieux qu’après un incident. Pour ceux qui travaillent réellement avec l’IA, les deux sont indispensables.
C’est de ce décalage que naît l’impression d’un monde qui tient par des arrangements de fortune. Nous voyons une intelligence capable de parler de l’univers et d’écrire des logiciels. Derrière elle restent pourtant des machines, des programmes et des personnes qui peuvent faillir. Aucun prestige technologique ne dispense de tâches très concrètes : surveiller, prévoir de la redondance et rétablir le service après une panne.
Cela dit, au-delà des critiques, l’indemnisation proposée par DeepSeek mérite d’être appréciée équitablement.
L’avis indique que chaque compte recevra des crédits équivalant à la totalité de sa consommation réelle des sept jours précédents, du 8 au 14 octobre. Ces crédits seront versés automatiquement et utilisés en priorité pour régler les prochaines factures de l’API.[1][2]
Par exemple, un compte ayant consommé 100 yuans pendant cette période recevrait 100 yuans de crédits selon les modalités annoncées. DeepSeek n’a pas limité l’indemnisation aux frais correspondant aux quelques heures d’interruption. L’entreprise a choisi une semaine entière de consommation passée comme base de calcul. Le geste a du poids.
Bien sûr, un crédit n’est pas un remboursement en espèces. L’offre ne signifie pas non plus que les sept prochains jours seront gratuits et sans limite. Le montant dépend de la consommation réelle des sept jours précédents et servira à déduire les frais futurs de l’API. Préciser ces conditions n’enlève rien au mérite de l’indemnisation.
Ce qui donne le sentiment d’une entreprise qui assume ses responsabilités, c’est sa volonté de supporter un coût précis pour cette panne. Le versement automatique évite aussi aux utilisateurs de devoir chacun produire des justificatifs et multiplier les demandes. Pour les développeurs qui continueront à utiliser le service, des crédits immédiatement disponibles et directement déduits des prochaines factures ont une valeur concrète.
La valeur de l’indemnisation ne tient pas à l’étiquette d’entreprise « qui ne manque pas d’argent ». Ce qui mérite d’être salué, c’est de transformer des excuses en crédits dont les utilisateurs pourront réellement se servir.
Mais saluer l’indemnisation ne doit pas transformer la panne en bonne nouvelle.
La facture de l’API ne représente qu’une partie du coût. Il faut aussi compter les risques d’interruption de l’activité, de retard de livraison et de perte de clients. Des crédits ne couvriront pas nécessairement les pertes de chaque équipe. L’argent peut se compenser ; le temps perdu et la confiance abîmée demandent parfois bien plus longtemps à se réparer. DeepSeek mérite d’être salué pour sa réponse et doit continuer à rendre des comptes sur la stabilité de son service.
L’avis indique également que DeepSeek va identifier et supprimer les points uniques de dépendance.[1] Où le service d’un modèle aussi puissant peut-il se retrouver bloqué ? La panne a commencé à 8 h 11, heure de Pékin. Cet horaire fait penser à une possibilité qui mérite vérification : une modification déployée dans la nuit, dont la faiblesse ne se révèle que face au trafic du matin.
Précisons d’abord ce que nous ignorons : cet avis ne donne pas la cause technique de l’incident. Un déploiement nocturne et une hausse du trafic matinal doivent tous deux être confirmés par les journaux et les mesures de surveillance. Suivons seulement ce scénario possible pour voir comment il pourrait se dérouler.
Imaginons qu’un service partagé ait été mis à jour pendant la nuit. Il vérifie les clés d’API et le crédit disponible avant que les requêtes n’atteignent le modèle. La nouvelle version fonctionne et passe ses contrôles, mais une vérification qui pouvait auparavant lire dans un cache interroge désormais la base de données à chaque requête. Ce service et cette modification servent d’exemple ; ce ne sont pas des éléments établis de l’infrastructure de DeepSeek.
La nuit, les requêtes sont peu nombreuses. Une consultation supplémentaire paraît sans conséquence. L’interface répond toujours, les tests ne signalent aucune erreur et les voyants de surveillance peuvent même rester au vert. Pourtant, une partie de la capacité de traitement du système a discrètement disparu.
Le matin arrive, les gens commencent à travailler, les appels des produits et les tâches de fond affluent. Les requêtes finissent par arriver plus vite que ce service partagé ne peut les traiter. Elles commencent à faire la queue pour obtenir une connexion à la base de données. Les requêtes en attente retiennent davantage de ressources, et les nouvelles doivent attendre encore plus longtemps.
Imaginez un petit restaurant du matin avec une seule caisse ouverte. La cuisine fonctionne, les cuisiniers sont là, mais tout le monde doit d’abord passer à cette caisse. Une fois l’entrée engorgée, une cuisine plus grande n’est pas d’un grand secours.
Le problème commence alors à se nourrir lui-même. Faute de réponse, les applications clientes atteignent leur délai d’attente et réessaient. Certains produits en aval réessaient aussi pour leurs utilisateurs. Si les requêtes précédentes n’ont pas été annulées à temps, de nouvelles tâches s’empilent sur celles qui ne sont pas terminées. Le volume de nouvelles opérations n’a pas forcément explosé, mais la charge subie par le système continue de grossir.
À ce stade, même un retour à la version précédente ne rétablit pas forcément le service aussitôt. Les requêtes accumulées sont toujours là, les pools de connexions n’ont pas récupéré et les nouvelles tentatives continuent de frapper à la porte. À peine le service reprend-il son souffle que la charge le remet à terre. Pour rétablir la situation, il peut falloir limiter le trafic entrant, interrompre les tentatives inutiles, éliminer les tâches expirées, puis rouvrir progressivement le passage. Corriger le code et remettre le système sur pied sont parfois deux batailles distinctes.
Dans ce scénario, une modification introduit le problème, le trafic le révèle, puis l’accumulation et les nouvelles tentatives l’amplifient. Les coûteux clusters d’inférence peuvent être parfaitement sains, tandis que les requêtes restent coincées dans le passage étroit qui les précède. Le point unique de dépendance n’est pas nécessairement un serveur isolé. Il peut s’agir d’une même dépendance dont toutes les répliques ont besoin.
Ce type d’amplification a un précédent documenté. Le compte rendu de l’incident de juin 2025 chez Google Cloud explique que des données de politique de quotas ont provoqué des plantages de Service Control, puis que des redémarrages simultanés pendant la reprise ont surchargé une base de données sous-jacente, retardant le rétablissement dans certaines régions.[3] Cela montre qu’un système peut rester engorgé après la correction de l’élément déclencheur. Cela ne prouve pas que DeepSeek a connu le même enchaînement.
Pour vérifier ce scénario, il faudrait superposer plusieurs chronologies : ce qui a changé avant l’incident, le moment où le trafic a augmenté, celui où la latence, les files d’attente et l’utilisation des connexions du service partagé sont devenues anormales, l’éventuelle hausse des nouvelles tentatives et ce qui s’est passé après le retour en arrière ou la limitation du trafic. Si ces étapes s’enchaînent de façon cohérente, l’hypothèse prend du poids. L’heure de 8 h 11 suffit à poser une question, pas à déclarer l’enquête résolue.
Empêcher le retour du même problème est une promesse. C’est l’historique du service dans les mois qui suivent qui dira si elle a été tenue.
L’incident adresse aussi un rappel à tous ceux qui intègrent l’IA à leur activité : il faut prévoir une solution de repli.
Pour les processus importants, il faut décider à l’avance si le travail peut être mis en attente, confié à un autre service déjà testé ou repris par une personne lorsque le modèle en amont est momentanément indisponible. Si de nouvelles tentatives sont nécessaires, il faut en limiter le nombre, allonger progressivement les intervalles et les décaler dans le temps pour ne pas jeter de l’huile sur le feu. Les processus qui effectuent des paiements, envoient des messages ou modifient des données doivent aussi éviter les doubles exécutions après le rétablissement du service.
Ces préparatifs n’ont rien de futuriste. Ils peuvent pourtant protéger l’activité d’aujourd’hui lors de la prochaine panne. Plus on utilise l’IA sérieusement, moins on peut tout miser sur l’idée qu’une entreprise aussi compétente ne rencontrera aucun problème.
DeepSeek mérite des critiques pour une panne de presque cinq heures. Un service d’IA qui suscite autant d’attentes doit aussi faire ses preuves en matière de fiabilité. L’indemnisation calculée sur les sept jours de consommation précédents mérite elle aussi d’être saluée. Reconnaître le problème, en supporter le coût, puis regagner la confiance grâce à un service durablement stable : cette attitude mérite d’être encouragée.
Le monde fonctionne peut-être davantage à l’improvisation qu’on ne voudrait le croire. Nous avons de bonnes raisons d’exiger moins de pannes, et tout autant de reconnaître, quand quelqu’un prend ses responsabilités, que cette fois la réponse a été honnête.