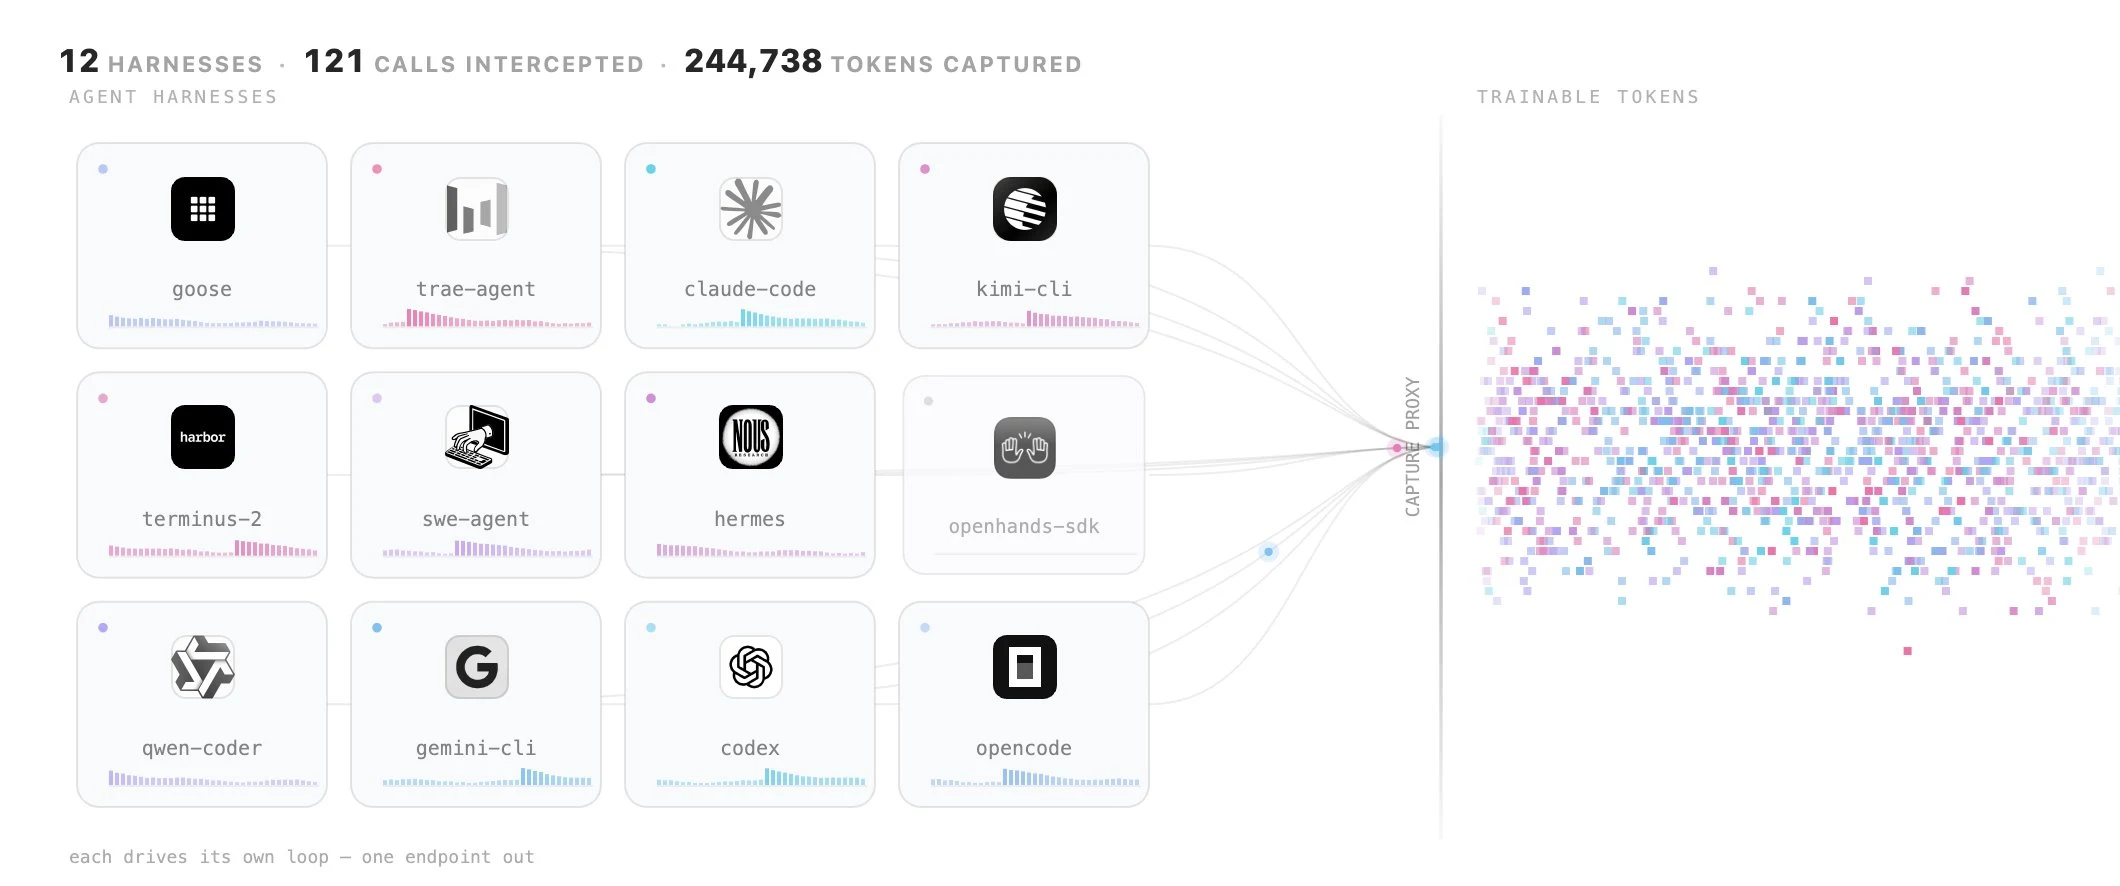
私たちはClaude Code、Codex、Hermes、Pi、@opencodeなどのコーディングハーネスをRL環境に変えました。ハーネスには一切変更を加えず、トレーニングコードにも変更はありません。任意のオープンモデル、任意のタスクセット、完全にオープンソースですよ、皆さん!
同じモデル、同じ重みで:Mini-SWE-Agentでは62%、Claude Codeでは33%。しかし実際のハーネス内でトレーニングするということは、通常そのハーネスを環境として再実装することを意味するため、ほとんどのモデルは実際には誰も出荷していないスキャフォールドの中でトレーニングされています。
その解決策は書き直しではなく、プロキシです。ハーネスは自分がモデルAPIと通信していると思っています。実際には、コーディングエージェントが使う4つのフォーマット(OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、Gemini)を話すキャプチャプロキシと通信しており、このプロキシは@vllm_projectへ転送し、vLLMがサンプリングした正確なトークンIDとlogprobを記録し、TRLにトレーニング可能なシーケンスを渡します。ハーネスがそのまま環境になります。本日、10のハーネスがこれを通じて動作し、1つも変更されていません。
しかも報酬を自分で制御できるので、ハーネスが求めていない動作も形作ることができます。少ないツール呼び出しでタスクを解いた場合の小さなボーナスを追加したところ、すでに解けていたタスクで、モデルは31%少ない呼び出しを使うようになり、これはすべてのハーネスで当てはまり、Codexでは約半分になりました。
@liquidaiのLFM2.5-2.6Bでテスト済み:
→ 1つのハーネスでトレーニング:主にそのハーネスで向上(OpenCode 34% → 58%)。
→ 4つ同時にトレーニング:4つすべてで向上(42% → 54%)。
→ 代わりにQwen3.8-27Bからの3,189個のロールアウトでSFTした場合:47.5%で頭打ちになり、どちらのRL実行よりも下回りました。
すべてがオープンで再現可能です:OpenEnvのキャプチャプロキシ、TRLのトレーナー、タスク、SFTデータ、トレーニングコード、そしてトレーニング済みの全7モデル。次はより大きなモデルとより大規模な実行です。
完全ガイド: https://huggingface.co/spaces/FineEnvs/multi-harness-rl