
マルチエージェントシステムが実験から本番環境へと移行する際に浮かび上がる重要な課題は、これらのシステムが実世界のシナリオにおいて一貫して有用で、正確かつ説明可能であることを保証することです。企業は、データソース、ツール、ビジネス上の制約にわたる推論を必要とする複雑な実世界の問題を解決するために、マルチエージェントシステムの採用をますます進めています。サプライチェーン計画から財務分析、顧客業務に至るまで、これらのシステムは単純な質問応答の枠を超えています。複数の専門化されたエージェントを調整し、意思決定を行い、ワークフローを実行し、実行可能な推奨事項を生成します。
大規模言語モデルは流暢な応答を生成できますが、エンタープライズアプリケーションにははるかに深い保証が求められます。そこではエージェントが確実に指示に従い、適切なツールを選択し、制約を守り、出力の背後にある明確な推論を提示しなければなりません。
Amazon Bedrock AgentCore 任意のフレームワークやモデルで、エージェントを大規模に構築、接続、最適化するためのプラットフォームです。 Amazon Bedrock AgentCore Evaluationsは、Amazon Bedrock AgentCore の機能の一つであり、開発から本番環境にわたるエージェントのパフォーマンスを評価する完全マネージド型の機能として、この課題に対応するために設計されています。これにより、チームは複数の品質次元にわたって精度、タスク成功率、動作を測定できます。モデルの応答品質のみに焦点を当てた従来の評価手法では、ツールの選択、ワークフローの実行、ビジネス制約の遵守によって正確性が決まるエージェント型システムには不十分です。評価に加えて、エージェント型システムの本番環境への展開には、責任あるAIに関する管理機能も必要です。 Amazon Bedrock Guardrails コンテンツフィルタリング、拒否トピックの検出、グラウンディング検証など、設定可能なセーフガードを提供し、評価フレームワークを補完します。評価はエージェントの実行後の品質を査定するのに対し、Guardrailsは実行中に安全上の制約を強制します。この投稿では、組み込み評価ツールとカスタム評価ツールの両方をサポートするAmazon Bedrock AgentCore Evaluationsを使用して、この評価フレームワークを運用化することに焦点を当てます。組み込み評価ツールは、有用性、タスクの成功、指示の遵守といった一般的な品質次元に対する事前定義された査定を提供するため、追加のセットアップなしでチームは迅速にエージェントのパフォーマンスのベースラインを取ることができます。しかし、エンタープライズのユースケースでは、より深い、ドメイン固有の検証が必要です。カスタム評価ツールはこれに対応し、ビジネスに即したチェックを定義できます。
また、説明可能性を第一級の評価軸として特に重点的に扱います。組み込みの評価器が応答の一般的な明瞭さを評価できる仕組みを示します。さらに、カスタム評価器を用いることで、エージェントが判断の根拠を明示的に言語化しているか、根拠となるデータやツールの出力を参照しているか、コストとサービスレベルといったトレードオフを説明しているかを検証できることを紹介します。これらの評価器を組み合わせることで、AgentCore Evaluations が表層的な応答品質にとどまらず、エージェントがどのように、なぜその判断に至ったのかについての構造的で測定可能な知見を提供できることを示します。
これらの概念を具体的にするために、以下のセクションでは、これらのコンポーネントが実際にどのように連携するかを示すリファレンスアーキテクチャと実装を順を追って説明します。
ソリューション概要
この投稿では、AnyCompany Retail という架空のグローバル小売企業を使用します。AnyCompany Retail は、EC チャネル、地域のフルフィルメントセンター、配送センター、そして数千の実店舗を運営する多国籍小売業者です。AnyCompany は頻繁に在庫の偏りに悩まされており、一部の地域ではプロモーション期間中に在庫切れが発生する一方、他の地域では過剰在庫を抱えています。輸送チームもまた、配送スピード、配送業者のキャパシティ、コストのバランスを取る必要があります。同社は、プランナーが在庫配分の最適化、配送調整の推奨、在庫の健全性の分析、ルーティングやフルフィルメントのシナリオのシミュレーションを支援できるエージェント型アシスタントを求めています。
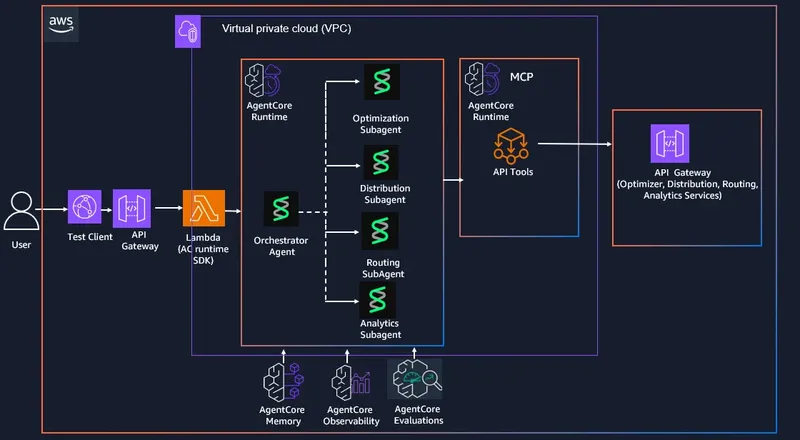
以下を使用してマルチエージェントのサプライチェーン意思決定システムを構築・評価します Strands Agents SDK, Amazon Bedrock AgentCore MCP Server および Amazon Bedrock AgentCore Evaluations。このソリューションは、Strands Agents を使用し、オーケストレーターエージェントと、最適化エージェント、配布エージェント、ルーティングエージェント、分析エージェントの 4 つの専門サブエージェントで構成されています。各エージェントは Amazon Bedrock AgentCore ランタイム とともに Amazon Bedrock AgentCore メモリ および Amazon Bedrock AgentCore Observability 有効です。
オーケストレーターエージェントはプランナーのリクエストを受け取り、ツールとして公開されている専門エージェントに作業を委任します。最適化エージェントはモックに基づくMCPツールを呼び出し Amazon API Gateway 最適化の意思決定を返すRESTインターフェースです。配分エージェントはレコメンデーションAPIを呼び出して、フルフィルメントセンター、店舗、デジタルチャネル全体での在庫再配置を提案します。ルーティングエージェントは物流APIを呼び出して、配送業者と経路の選択肢を推奨し、アナリティクスエージェントはサプライチェーンの診断に関する質問に回答します。このソリューションでは、エージェントループに Amazon Bedrock の基盤モデルを使用します。リージョンごとのモデルの利用可否については、次を参照してください。 Amazon BedrockのAWSリージョン別対応モデル。
このソリューションは、有用性やタスク完了といった一般的な品質の側面を評価する組み込みの評価ツールを使用しています。また、制約の充足、ルートの実現可能性、SQLの正確性、在庫の裏付け、説明の品質といったサプライチェーン固有の挙動を評価するカスタム評価ツールも提供しています。AnyCompanyは、応答の言語品質とエージェントの意思決定のビジネス上の妥当性の両方を評価できます。
このソリューションは、Amazon Bedrock AgentCore Evaluations でオンデマンドモードとオンラインモードの両方をサポートしています。オンデマンドモードは、開発時のベンチマーク、回帰テスト、継続的インテグレーションおよび継続的デリバリー(CI/CD)のゲートに使用されます。オンラインモードは、本番環境での継続的なモニタリングとアラートに使用されます。どちらのモードも、ユーザーからのフィードバックを基にループを閉じて対応するのに役立ちます。オンデマンド評価に使用したカスタムエバリュエーター(サプライチェーンソリューションの制約充足、ルート実行可能性、SQL 正当性、説明可能性の各エバリュエーターなど)は、エバリュエーターの Amazon Resource Names(ARN)を参照し、サンプリングレート(たとえば、本番トレースの 1–10%)とオプションのセッションフィルターを指定する OnlineEvaluationConfig オブジェクトを使用して、そのままオンライン評価に再利用されます。その後、サービスは AgentCore Observability からトレースを自動的に読み取り、スコアを付けて結果を次へストリーミングします。 Amazon CloudWatch ダッシュボードおよびアラーム。この記事では、オンデマンドモードを使用してソリューションをテストします。
次のアーキテクチャ図は、当社ソリューションのさまざまなコンポーネントを示しています。
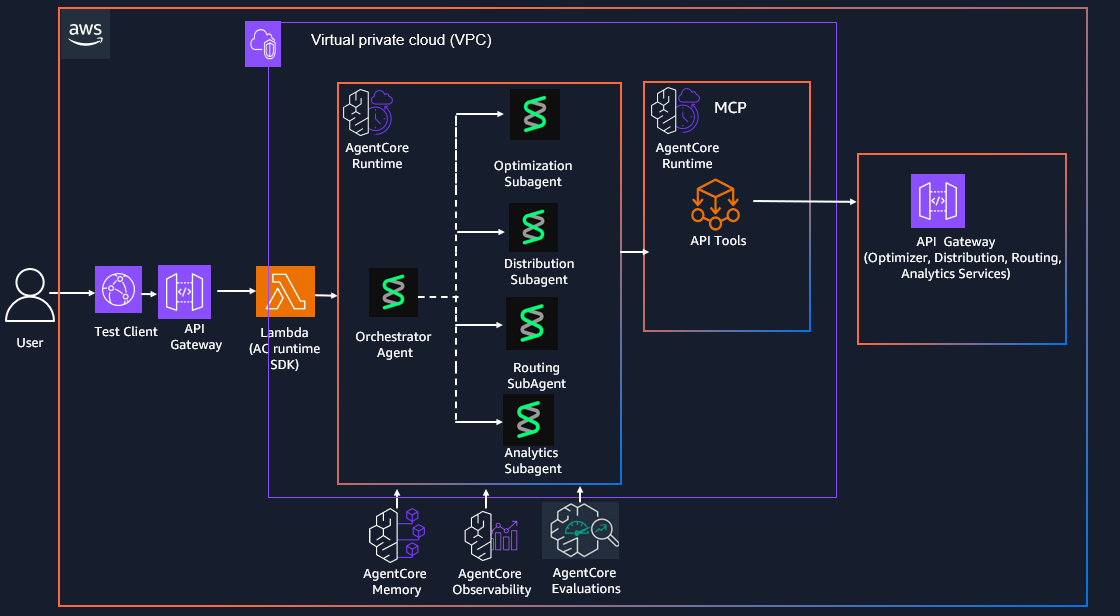
Figure 1: マルチエージェント型サプライチェーン意思決定ソリューションのアーキテクチャ
評価フレームワーク
この記事では、エンタープライズの信頼を段階的に構築する、マルチエージェントシステム向けの3層評価アプローチを使用します。このアプローチは、明確な段階に従っており、まず一般的な品質のための組み込み評価ツールから始め、次にビジネス上の正確性のためのカスタム評価ツールを追加し、最後に信頼性と監査可能性のための説明可能性評価ツールを重ねていきます。
第一層では、セットアップ不要の組み込み評価器を使用します。汎用ベースラインとしてHelpfulnessを適用し、さらに各エージェントの主要な失敗モードを対象とするエージェント固有の評価器を第2の評価器として加えます。オーケストレーターにはTool Selection Accuracy、最適化と配信にはResponse Relevance、ルーティングにはInstruction Following、アナリティクスにはFaithfulnessを使用します。
2つ目のレイヤーでは、ドメイン固有のビジネスルールをエンコードしたカスタム評価器を追加します。最適化のための制約充足、流通のためのデータグラウンディング、ルーティングのための経路実現可能性、分析のためのSQL正確性、そしてオーケストレーションのための計画一貫性です。これらはビジネス上の妥当性を検証します。つまり、推奨事項が予算制限を遵守したか、実際の在庫データを使用したか、そして運用上正しい出力を生成したかを確認するのです。
以下の表は、ここで実装する各エージェントに対して選択した2つの組み込み評価器とカスタム評価器の対応を示したものです。2つ目の組み込み評価器は各エージェントの主要な失敗モードを対象とし、カスタム評価器は運用上の正しさを検証するドメイン固有のビジネスルールをコード化しています。
| エージェント | 組み込みエバリュエーター | カスタム評価ツール |
| オーケストレーターエージェント | 役に立つ度; ツール選択の正確さ | 計画一貫性評価器:サブエージェントの出力を、矛盾のない有効な推奨事項として統合できたか? ツール軌跡評価器:正しいサブエージェントへルーティングしたか? |
| 最適化エージェント | 役立ち度; 回答の関連性 | 制約充足評価器:予算、在庫カバー率(需要 ≤ 数量 ≤ 2× 需要)、および倉庫容量の制約。主要業績評価指標(KPI)達成評価器:充填率/売上改善目標の達成。 |
| 配布エージェント | 役立ち度;回答の関連性 | 推奨事項の根拠評価器:推奨事項が現在の在庫/需要データに基づいていることを評価します。リスク影響評価器:推奨事項が在庫切れ/過剰在庫のリスクを改善することを評価します。 |
| ルーティングエージェント | 役に立つこと; 指示への従順さ | 経路実行可能性評価: 経路が納期ウィンドウ、コスト、配送業者の能力、地域の制約を遵守しているかを評価します。サービスレベル合意 (SLA) 評価: 予想納期が目標サービスレベルを満たしているかを評価します。 |
| アナリティクスエージェント | 有用性;忠実性 | SQL正確性評価器:クエリがユーザーの意図に合致しているかを評価します。データグラウンディング評価器:レスポンスがAmazon Relational Database Service (Amazon RDS) のクエリ結果によって裏付けられているかを評価します。未サポートの主張がないかを評価する評価器。 |
説明可能性
評価アプローチの第3層では、説明可能性の評価器を、エージェント全体にわたる独立した横断的なチェックとして適用します。これらは、エージェントが推薦の判断根拠を明確に説明しているか、ツール出力からの裏付けとなる証拠を引用しているか、どの制約が応答に影響したかを説明しているか、競合する目的間のトレードオフを説明しているか、特定のサブエージェントが呼び出された理由を明確にしているか、そしてデータが不完全な場合に前提条件を開示しているかを独立に評価します。説明可能性を独自の評価層として分離することで、透明性を独立して測定できます。推薦は正確でありながら説明不可能である場合があり(カスタム評価器には合格するが説明可能性では不合格)、これにより、チームはより優れた意思決定ロジックではなく、より優れた推論の明示化をエージェントが必要としているかどうかについて、実行可能なシグナルを得ることができます。
次の表は、ここで実装し、横断的な層としてエージェント全体に適用する6つの独立した説明可能性評価器を定義したものです。これらは、エージェントが推論を明確に説明し、証拠を引用し、制約とトレードオフを説明し、前提条件を開示しているかどうかを評価します。これらは精度とは別に測定されるため、チームは説明不可能だが正しい応答と、よく説明されているが誤っている応答を区別できます。
| 評価器 | 対象エージェント | チェック内容 |
| 意思決定根拠の品質 | すべて | エージェントはなぜその推薦を行ったのかを説明したか? |
| 証拠の帰属 | Analytics、Distribution、Routing | 使用したデータフィールド、API応答、またはSQL結果を引用したか? |
| 制約の推論 | Optimization、Routing | どの制約が最終的な応答に影響したかを説明したか? |
| トレードオフの説明 | Optimization、Distribution、Routing | コスト、サービスレベル、在庫リスク間のトレードオフを説明したか? |
| ツール使用の説明可能性 | Orchestrator | 各サブエージェントまたはMCPツールが呼び出された理由を説明したか? |
| 前提条件の開示 | すべてのエージェント | データが不完全な場合に前提条件を明確に示したか? |
前提条件
このソリューションをデプロイする前に、以下のツールで開発環境をセットアップしてください。
- 以下をインストールします: AWS Command Line Interface (AWS CLI)
- 以下をインストールします: AWS Serverless Application Model (AWS SAM) CLI v1.100.0+
- 以下をインストールします: Docker v20.x+
- インストール: Node.js v18.x+
- インストール Python v3.11+
依存関係
Strands Agentsの実装では、DockerFileにパッケージ化されている以下の依存関係も必要です:
- strands-agents # Strands Agents マルチエージェントフレームワーク
- strands-agents-tools # Strands エージェントツールおよびユーティリティ
- requests # API 呼び出し用の HTTP ライブラリ
- bedrock-agentcore # Amazon Bedrock エージェントコア機能
- boto3 # AWS SDK for Python (Boto3)
ソリューションのデプロイと実行
このソリューションは私たちの GitHub リポジトリ からダウンロードでき、AWS 環境にソリューションをデプロイしてアクセスするためのワンステップデプロイを提供します:
# Edit terraform.tfvars: set vpc_id and runtime_subnet_azs
cd terraform
cp terraform.tfvars.example terraform.tfvars
terraform init
terraform apply
出力には、ランタイム ARN、AnyCompany Retail API URL、エバリュエーター API URL、およびメモリ ARN が含まれます。
ソリューションの実行
以下の手順に従ってソリューションを実行してください:
test_client/ フォルダには、エンドツーエンドの機能を検証するために、デプロイされた Supply Chain エージェントを 20 件のサンプルクエリ(サブエージェントごとに 5 件)で呼び出す Python スクリプトが含まれています。各カテゴリはマルチターンセッションとして実行され、セッション ID はエバリュエーター API で使用できるよう最後に出力されます。
cd test_client
pip install -r requirements.txt
cd terraform
terraform output supply_chain_arn
すべてのクエリを実行(合計 20 件、4 セッション)
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" --region <your_region>
特定のサブエージェントカテゴリを実行
#Only optimization queries (1 session, 5 turns)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category optimization
#Only routing and analytics (2 sessions, 5 turns each)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category routing analytics
テストクライアントは各クエリとエージェントの完全な応答を出力します。最後に、エバリュエーターで使用するためのセッション ID を出力します。
評価の作成と実行
test_evaluators/ フォルダには、エージェントセッションに対して評価を実行するスクリプトが含まれています。これらの評価は非同期で実行され、結果は S3 にマークダウンファイルとして保存されます。
トレース付きのエージェントセッションを生成するために、まず前述のとおりサプライチェーン判定マルチエージェントソリューションを呼び出し、テストクライアント実行の最後に出力されたセッション ID を書き留めておく必要があります。最後に、トレースが CloudWatch に伝播するまで、ソリューションの実行後 3〜5 分待ちます。
cd test_evaluators
pip install -r requirements.txt
cd terraform
terraform output evaluators_api_url
カスタムエバリュエーターの作成
python test_evaluator.py --api-url "https://<evaluators-api-url>" createこれにより、カスタムエバリュエーターが登録され、その ID が出力されます。実行コマンドで使用できるよう、これらを保存しておいてください。
評価の実行
エバリュエーター ID(カスタムまたは組み込み)のカンマ区切りリストを渡します。最低 1 つが必要です:
# Run custom + built-in evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<session-id-from-test-client>" \
--evaluators " sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>,Builtin.Correctness,Builtin.GoalSuccessRate"
API は即座に 202 を返します。結果は非同期で S3 の次の場所に保存されます:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<session-id>/<timestamp>/EvaluationResults.mdエバリュエーターの削除
python test_evaluator.py --api-url "https://<evaluators-api-url>" delete \
--evaluator-ids "sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>"
最適化評価の実行
評価フレームワークを理解し、ソリューションをデプロイしたところで、最適化エージェントに焦点を当てたエンドツーエンドの評価を通して見ていきましょう。このウォークスルーでは、カスタムのビジネス精度エバリュエーター(レイヤー 2)と説明可能性エバリュエーター(レイヤー 3)を組み合わせて、最適化の意思決定の正確性と透明性の両方を評価する方法を示します。
ステップ 1: 最適化クエリの実行
まず、最適化カテゴリのみを指定してテストクライアントを呼び出し、焦点を絞ったセッションを生成します:
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" \
--category optimization \
--region <your_region>
これにより、5 件の最適化クエリがマルチターンセッションとして実行されます。エージェントは「prod-001 の今後 30 日間の最適な在庫レベルは何ですか?」といったリクエストを処理します。各クエリでは、最適化エージェントが MCP ツールを呼び出し、需要予測を取得し、予算、在庫カバー率、倉庫容量の制約を遵守する在庫補充推奨を生成する必要があります。実行の最後に、テストクライアントは最適化セッション ID を出力します。
ステップ 2: Constraint Satisfaction エバリュエーターの実行(レイヤー 2: ビジネス精度)
最適化セッションが生成されたら、カスタムの Constraint Satisfaction エバリュエーターを実行し、エージェントの在庫補充推奨がビジネスルールを遵守しているかどうかを検証します。このエバリュエーターは 3 つの制約を同時にチェックします:
- 予算: 増分の在庫保持コストが残り予算(budget_limit − budget_used)の範囲内に収まっているか。
- 在庫カバー率: 推奨水準が需要予測以上(欠品を回避)であり、かつ需要の2×以下(過剰在庫を回避)であるか。
- 倉庫容量: 推奨レベルは利用可能な倉庫スペースに収まりますか?
組み込みの Helpfulness および Response Relevance エバリュエーターと共にエバリュエーターを実行します。
cd test_evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_optimization_constraint-<id>,Builtin.Helpfulness,Builtin.ResponseRelevance"
APIは即座にHTTP 202を返します。評価は非同期で実行されます。結果はS3に保存されます:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<optimization-session-id>/<timestamp>/EvaluationResults.mdステップ 3: 説明可能性の評価ツールを実行する(レイヤー 3: 信頼性と監査可能性)
最適化エージェントが制約を満たす推奨を生成することを確認した後、次の疑問は、その推論を説明できるかどうかです。推奨は正確でありながら不透明な場合があります。そのような推奨は制約評価器は通過しますが、なぜ特定の在庫水準を選んだのかを説明できません。
ステップ1で使用したのと同じ最適化セッションIDを使って、最適化エージェントに適用される2つの説明可能性評価ツールを実行します。
- 判断理由の質 — エージェントはなぜその推奨を行ったのかを説明したか?(例:「需要予測が1,200で安全係数1.25倍を目標としているため、1,500単位を推奨します」)
- 制約の推論 — エージェントは、最終的な回答がどのような制約によって形作られたかを説明しましたか?(例:「予算は最大1,800ユニットまで許容されますが、倉庫の容量が1,600に制限するため、1,500をお勧めします」)
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_decision_rationale-<id>,sc_constraint_reasoning-<id>"
これらの評価者は透明性を独自に評価します。それらは精度とは別に測定されます。
統合された結果の解釈
3つの評価器すべてを同じ最適化セッションに対して実行することで、エージェントの品質を2つの次元から俯瞰できます:
| 寸法 | 評価者 | 質問は解決済みです |
| ビジネス精度(レイヤー2) | 制約充足 | これらの推奨事項は運用面で正しいか? |
| 説明可能性(レイヤー3) | 判断理由の質 | なぜ エージェントはこの推奨を行うのでしょうか? |
| 説明可能性(レイヤー3) | 制約推論 | どの制約 対応を形作ったのか? |
表3:品質次元における評価カバレッジ
この階層的なアプローチにより、的を絞った改善が可能になります。制約充足スコアが高いのに説明可能性スコアが低い場合、エージェントの意思決定ロジックは妥当ですが、コミュニケーションに改善の余地があるということです。逆に、説明可能性が高いのに制約に違反している場合は、エージェントは推論を適切に言語化できていますが、誤ったロジックを適用していることになります。各失敗モードにはそれぞれ異なる改善手順があり、この評価フレームワークによってその区別が測定可能になります。
クリーンアップ
継続的な課金を避けるため、ソリューションを試した後、AWSアカウントを1ステップでクリーンアップしましょう。
terraform destroy結論
この記事では、Amazon Bedrock AgentCore Evaluations を使用してマルチエージェントのサプライチェーン意思決定システムを構築および評価する方法を紹介しました。ポイントは、エージェントの動作が単に機能するだけでなく、有用性、正確性、説明可能性の面でも検証されていることです。AnyCompany Retail Group のシナリオを通じて、オーケストレーターエージェントと専門のサブエージェントが連携し、在庫配分、流通計画、ルーティング最適化、サプライチェーン診断といった複雑な問題を解決しながら、エンタープライズデータソースや API と統合する様子を示しました。アーキテクチャ全体を通して示したように、エージェントシステムにおける正確性は応答の品質にとどまりません。それは、適切なツールの選択、正しいワークフローの実行、ビジネス制約の遵守、そして出力をデータに根拠付けることに依存します。
組み込みの評価ツールとカスタム評価ツールを組み合わせることで、チームは一般的な応答品質とドメイン固有の意思決定の正確性の両方を体系的に検証できます。説明可能性を重視した評価ツールを取り入れることで、エージェントが自らの推論を明確に示し、根拠となるデータを参照し、ビジネスユーザーが信頼して行動に移せる形でトレードオフを説明することが保証されます。この評価駆動型のアプローチにより、実際の実行データを活用した継続的な改善が可能になり、本番環境への展開前の品質ゲートが確立され、一貫性があり透明性の高い、ビジネスに沿ったマルチエージェントシステムを提供するためのスケーラブルなフレームワークが実現します。
始めるには、 Amazon Bedrock AgentCore Evaluations を調べ、これらのパターンを独自のマルチエージェントアプリケーションに適用してください。完全なソースコードは、GitHub の Amazon Bedrock AgentCore サンプルリポジトリ にあります。まずオブザーバビリティを有効にし、ユースケースに応じた主要な評価ディメンションを定義した上で、組み込みおよびカスタムのエバリュエーターを段階的に導入し、最も重要な事柄を測定できるようにしてください。詳細については、
Amazon Bedrock AgentCore のサービスページをご覧いただくか、 Amazon Bedrock コンソール で直接始めてください。.
関連記事:
- Amazon Bedrock AgentCore Evaluations で信頼性の高い AI エージェントを構築する
- Amazon Bedrock AgentCore を活用して AWS 上で高拡張性のサーバーレス LangGraph マルチエージェントシステムを構築する
- AI エージェントの評価: Amazon でのエージェント型システム構築から得た実践的な教訓