
ユーザーがLangChainで構築された検索拡張生成(RAG)アプリケーションであるサポートアシスタントに、2つの製品を3つの観点で比較するよう問いかけるとき、実質的には同時に6つの質問を投げかけていることになります。類似性検索では、1つのクエリベクトルですべての意図をカプセル化します。そしてリトリーバーが、それらの意図の平均の最良の近似値を生成します。結果として返される回答は簡潔です。検索はエラーなしで実行されます。関連性スコアも妥当に見えます。それでも、取得されたチャンクはトピック的には関連しているものの、質問が実際に求めていた内容のほんの一部しかカバーしていません。
この記事では、Amazon Bedrock マネージドナレッジベースを使用した RAG アプリケーションをご紹介します。使用するのは以下の通りです: LangChain同じ複数パートの質問を標準検索とエージェント型検索の両方に通し、トレースイベントを読んでモデルが生成したプランを確認します。また、2つの検索経路それぞれのコストと、より安価な方が適切な選択となる状況についても取り上げます。
Agentic retrievalは、Amazon Bedrock Managed Knowledge Baseで利用できます。1回の検索ではなく、Amazon Bedrock Managed Knowledge Baseは検索を計画します。質問をサブクエリに分解して実行し、十分な証拠が揃っているかを判断し、不足していれば再検索します。The langchain-aws このパッケージはエージェント型と標準型の両方の検索を公開しているため、LangChainアプリケーションからどちらでも利用できます。
ソリューション概要
Amazon Bedrock マネージドナレッジベースAmazon Bedrockの完全マネージド型RAG機能である、はRAGアーキテクチャから自己管理のベクトルストア、埋め込み、再ランクモデルを取り除きます。データソースを設定すると、Amazon Bedrock Managed Knowledge Basesがチャンキング、埋め込み、保存、検索を処理します。このウォークスルーでは次を使用します Amazon Simple Storage Service (Amazon S3).
Amazon Bedrock マネージドナレッジベースは2つのAPIを提供しています。この記事では、それらの違いを簡単に説明します。この 取得 API はハイブリッド検索を 1 回実行し、スコア付きのチャンクを返します。 AgenticRetrieveStream API はプランニングループを実行し、ステップをトレースイベントとしてリアルタイムに返します。 langchain-aws パッケージでは、前者はチェーンにそのまま組み込める標準の LangChain リトリーバーです。後者は、ナレッジベースから直接検索を行う関数です。
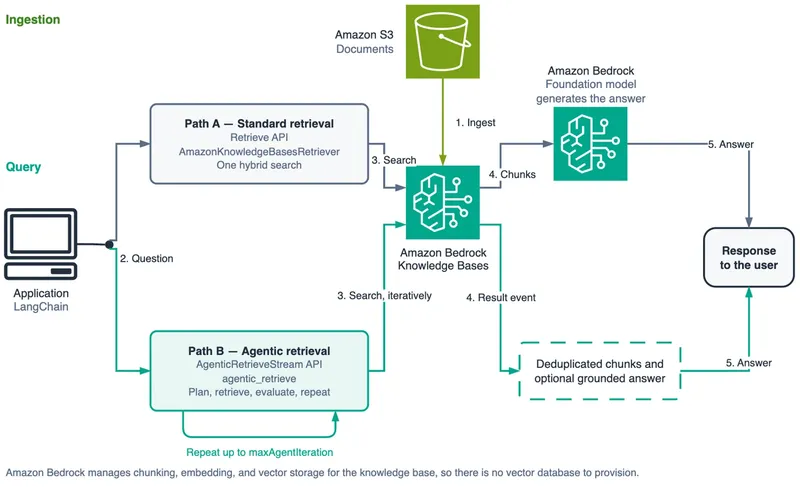
次の図は、ソリューションのアーキテクチャを示しています。アプリケーションは、Retrieve API(標準のシングルショット)または AgenticRetrieveStream API(マルチステップのプランニングループ)のいずれかを使用して Amazon Bedrock Knowledge Bases に問い合わせます。どちらの経路でもナレッジベースからドキュメントチャンクが返され、アプリケーションはそれを使って根拠に基づいたレスポンスを生成します。
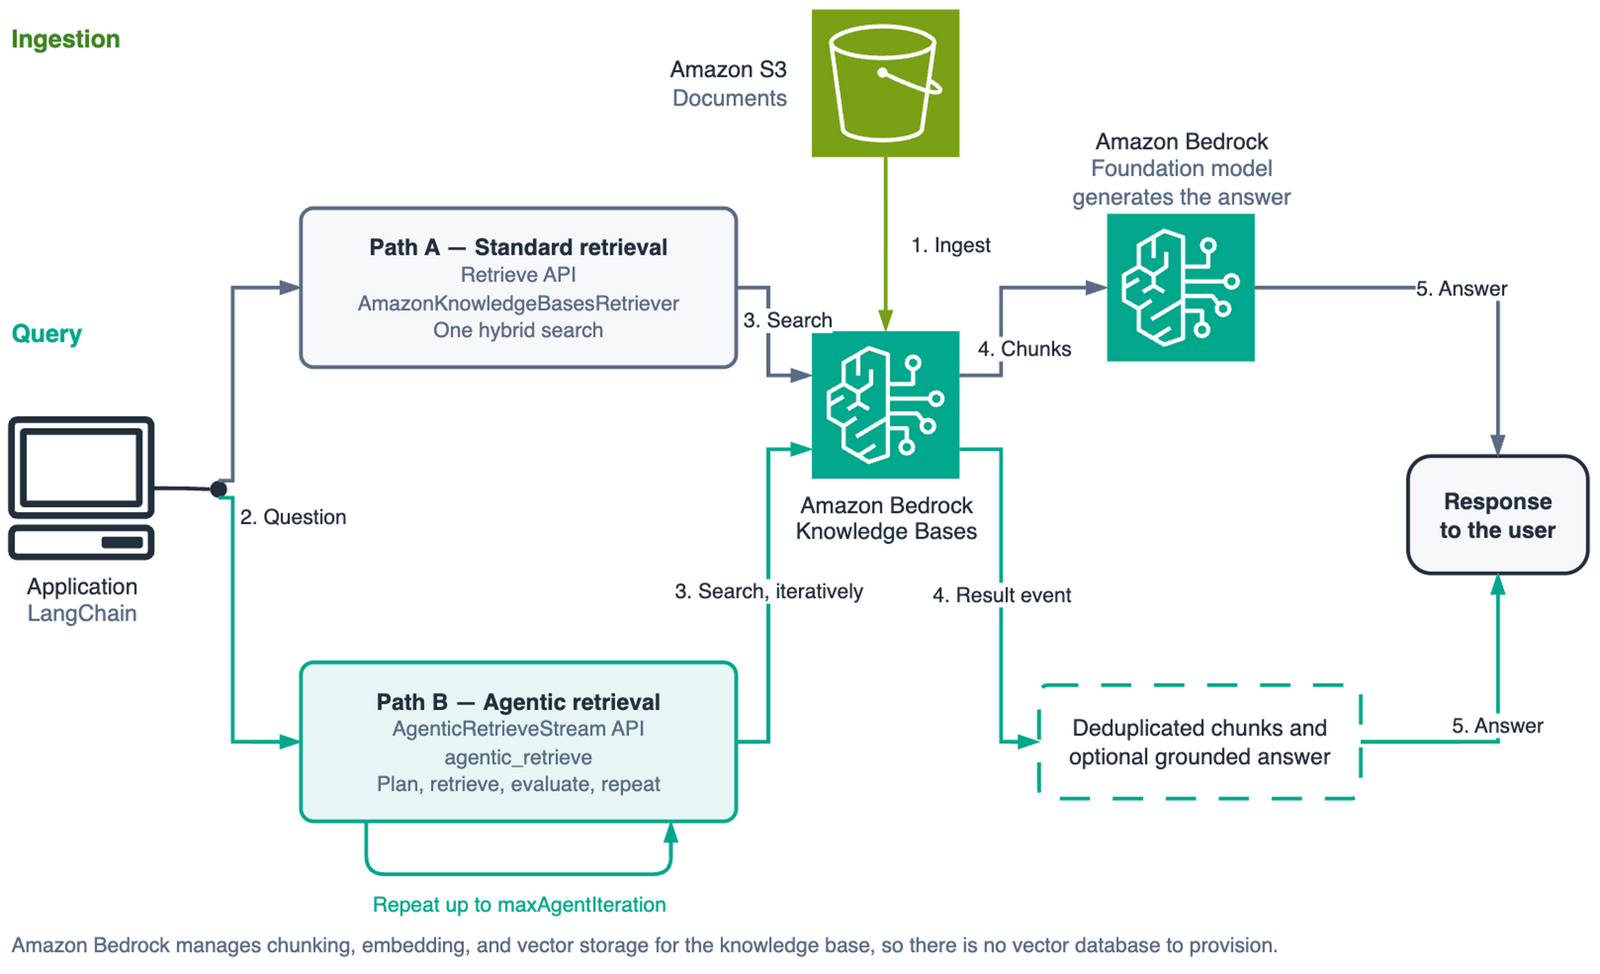
図 1: Retrieve API と AgenticRetrieveStream API を使用して Amazon Bedrock Knowledge Bases に問い合わせるソリューションアーキテクチャ
実装のウォークスルー
以下のセクションでは、ナレッジベースの作成、両方の検索方法による問い合わせ、そしてアジェンティックプランナーが生成するトレースイベントの読み取り方法を順に説明します。
前提条件
この手順を実行するには、以下が必要です:
- Amazon Bedrock Managed Knowledge Bases とアジェンティック検索が利用可能なリージョンの Amazon Bedrock にアクセスできる AWS アカウント。このウォークスルーでは米国東部 (バージニア北部) リージョン (
us-east-1) を使用し、コード全体でそのリージョンを前提としています。その他のリージョンでの利用可否とサポートについては、AWS の ドキュメント を確認してください。 - 次のセクションで説明する 2 つの AWS Identity and Access Management (IAM) アイデンティティ: ナレッジベースが引き受けるサービスロールと、API を呼び出すアイデンティティに対する権限。
- Python 3.12 以降。
- サンプルドキュメントを格納するS3バケット。コーパスには、重複するトピックを扱う複数のドキュメントが必要です。そうすることで比較質問に対応先が生まれます。単一のフラットなドキュメントではクエリプランニングを実証できません。
パッケージをインストールします。 Boto3 のバージョンが重要です: agentic_retrieve_stream は1.43.32より前には存在しませんでした。
langchain-aws>=1.6.3
langchain>=1.0
boto3>=1.43.32
権限
2つの識別情報が関わり、それらを意図的に分離することには価値があります。ナレッジベースは、ドキュメントの読み取りと埋め込みモデルの呼び出しのためにサービスロールを前提としています。アプリケーションは、クエリに AWS Security Token Service (AWS STS) の呼び出し元識別情報を使用します。どちらも相手の権限を必要としません。
Amazon Bedrock では、許可すればサービスロールを自動的に作成してもらえます。自分で用意する場合は、Amazon Bedrock がそのロールを引き受けることを許可する信頼ポリシーを付与してください。スコープは次のように設定します: aws:SourceAccount および aws:SourceArn 別のアカウントが「confused deputy(混乱した代理人)」としてそれを利用できないようにするためです:
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "bedrock.amazonaws.com"},
        "Action": "sts:AssumeRole",
        "Condition": {
            "StringEquals": {"aws:SourceAccount": "111122223333"},
            "ArnLike": {
                "aws:SourceArn": "arn:aws:bedrock:us-east-1:111122223333:knowledge-base/*"
            }
        }
    }]
}
サービスロールにも必要です s3:ListBucket お使いのバケット上の、および s3:GetObject その内容に基づき、両方とも以下を条件とする aws:ResourceAccount. スコープを定める knowledge-base/* 作成済みの特定のナレッジベースIDまでワイルドカード文字で絞り込むことができます。
AWS STS の呼び出し元 ID には、異なるセットが必要です。 bedrock:AgenticRetrieveStream および bedrock:InvokeModelWithResponseStream ナレッジベースの Amazon Resource Name (ARN) にスコープを限定することはできません。 bedrock:Retrieve および bedrock:GetDocumentContent できます:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "AgenticRetrievalAndPlannerModel",
            "Effect": "Allow",
            "Action": [
                "bedrock:AgenticRetrieveStream",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Sid": "RetrieveAndFullDocumentExpansion",
            "Effect": "Allow",
            "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
            "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
        },
        {
            "Sid": "GenerateAnswersInTheChains",
            "Effect": "Allow",
            "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
            "Resource": "*"
        }
    ]
}
bedrock:GetDocumentContent 見落とされがちである。エージェンティック検索は、次の場合にそれを呼び出す: FullDocumentExpansion ステップが、その一節には質問に答えるための文脈が欠けていると判断します。次の要素のみを持つポリシーは、 bedrock:Retrieve プランナーがドキュメント全体にアクセスしようとした時点までは動作し、その後クエリの途中で失敗する。
ナレッジベース自体を作成・管理するには、呼び出し元のロールにさらに以下が必要です。 bedrock:CreateKnowledgeBase on *、そして GetKnowledgeBase, UpdateKnowledgeBase, DeleteKnowledgeBase, StartIngestionJob, GetIngestionJob、さらに ListIngestionJobs アクション knowledge-base/*。ガードレールを使用している場合は、 bedrock:GetGuardrail および bedrock:ApplyGuardrail.
このウォークスルーを実行すると、ナレッジベースでのドキュメントの保存と取り込み、取得呼び出し、基盤モデル(FM)の推論にかかるコストが発生する可能性があります。
料金の詳細については、以下のナレッジベースのセクションをご覧ください。 Amazon Bedrock の料金.
この実験が完了したら、リソースを削除してください。
ナレッジベースの作成とデータの投入
ナレッジベースを次の方法で作成します: managedKnowledgeBaseConfiguration設定 embeddingModelType に MANAGED サービス管理の埋め込みモデルを使用します。
import boto3
import os

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name=KB_NAME,
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
そんなことはありません。 storageConfiguration そのリクエスト内で指定します。セルフマネージド型のナレッジベースの場合は、自分のベクトルストアを記述したものを渡します。Amazon Bedrock Managed Knowledge Base はこれを受け取らないので、それがストレージレイヤーを Amazon Bedrock が所有していることを示す API 上の最も明確なシグナルです。
S3バケットをデータソースとしてアタッチし、その後インジェストジョブを開始します。インジェストは非同期であるため、一定間隔スリープして完了を願うのではなく、ジョブが終端状態に達するまでポーリングしてください。
import time

SUCCESS_STATES = frozenset({"COMPLETE"})
FAILURE_STATES = frozenset({"FAILED", "STOPPED"})

def wait_for_ingestion(kb_id, ds_id, job_id, timeout_s=1800):
    """Poll an ingestion job until it reaches a terminal state."""
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        job = bedrock_agent.get_ingestion_job(
            knowledgeBaseId=kb_id,
            dataSourceId=ds_id,
            ingestionJobId=job_id,
        )["ingestionJob"]
        status = job["status"]
        if status in SUCCESS_STATES:
            return job
        if status in FAILURE_STATES:
            reasons = job.get("failureReasons") or ["no reason reported"]
            raise RuntimeError(f"Ingestion job {job_id} finished as {status}: " + "; ".join(reasons))
        time.sleep(15)
    raise TimeoutError(f"Ingestion job {job_id} did not finish in {timeout_s}s")
データソースの完全な設定とエラー処理は以下にあります。 サンプルリポジトリ.
LangChainレトリーバーによるクエリ
AmazonKnowledgeBasesRetriever Retrieve API をラップし、他の LangChain リトリーバーと同様に動作します。Amazon Bedrock Managed Knowledge Bases の場合は、次を渡します。 managedSearchConfiguration. ここが多くの人がつまずく部分です: vectorSearchConfiguration は、独自のベクトルストアを運用する、ナレッジベース向けの従来のパスです。既存のほとんどの例が示しているのはこの方法です。
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever

SIMPLE_QUERY = "What is the restore time objective for the checkout service?"

retriever = AmazonKnowledgeBasesRetriever(
    knowledge_base_id=KB_ID,
    region_name=REGION,
    retrieval_config={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
        }
    },
)
docs = retriever.invoke(SIMPLE_QUERY)
各結果はLangChainの Document。関連性スコアは次のとおりです。 metadata["score"]、またソース文書自体のメタデータは次のとおりです: metadata["source_metadata"], 名前の衝突を避けるためにリネームされます。低信頼度の結果を除外したい場合は、 min_score_confidence その代わりにリトリーバー上で行い、後からフィルタリングするのではありません。
意図が1つに明確な質問に対しては、これが正しいツールです。呼び出しは1回で済みます。レイテンシは2つの選択肢のうち最も低く、回答がどのように生成されるかを完全に制御できます。本番環境のアシスタントが受ける問い合わせの大部分はこの形であり、こうした質問にプランニングループを使うのはお金と時間の無駄です。
単一ショット検索が限界を迎える場所
次に、同じ検索器に複数の部分から成る質問を与えてみます。
COMPLEX_QUERY = (
    "Compare the checkout and inventory services across on-call escalation, backup and "
    "restore targets, and deployment rollback procedure. Where do they differ?"
)

docs = retriever.invoke(COMPLEX_QUERY)
その質問全体の1つのembeddingに対するハイブリッドスコアによってランク付けされた5つのチャンクが返ってきます。
その質問には、3つの次元にわたる2つのサービスという6つの意図が含まれています。取得されたテキストをそれぞれの意図の証拠について採点することで、単一の埋め込みが何を回復できるかについての具体的な指標が得られます。
| numberOfResults | チャンク | コーパスの構成比率 | 対応するサブインテント | 欠落 |
| 5 | 5 | 10% | 6件中4件目 | チェックアウト時のオンコール対応、在庫復元 |
| 10 | 10 | 19% | 6 / 6 | なし |
5件の結果では、6つの意図を表す1つの埋め込みがそのうち2つをカバーできません。10件では6つすべてをカバーしますが、無駄が見て取れます。2つのサブ意見は二重にカバーされ、1つのチャンクは何もカバーしていません。
検索器はその役割を果たしました。限界は構造的なものです。1つのベクトルでは6つの意図を表現できず、返されたエビデンスがその質問に答えるのに十分かどうかを問うステップがプロセスには存在しないのです。
エージェント型検索の実行
アージェンティック検索はLangChainのレトリーバーではなく、Amazon Bedrock Managed Knowledge Basesの機能です。この langchain-aws パッケージはそれをスタンドアロンの関数として公開し、 agentic_retrieve基盤となる API が結果をストリーミングし、同期型の BaseRetriever インターフェース。フラグは付いていません AmazonKnowledgeBasesRetriever それをオンに切り替えるものです。
from langchain_aws.retrievers.bedrock import agentic_retrieve

result = agentic_retrieve(
    knowledge_base_id=KB_ID,
    query=COMPLEX_QUERY,
    region_name=REGION,
    generate_response=True,
    number_of_results=10,
)
print(result["generatedResponse"]["answer"])
では generate_response=True、このサービスは検索されたチャンクとともに根拠のある回答と引用を返すため、別途モデル呼び出しを組み込むことなく回答を得ることができます。この関数は Amazon Bedrock Managed Knowledge Base に対してのみ動作します。
内部的には、このサービスは計画を立て、検索を行い、証拠が十分かどうかを評価し、不十分であれば反復します。ヘルパーはそのすべてを隠して最終的なチャンクだけを返してくれるため便利ですが、計画を見ることはできません。
トレースイベントの読み取り
モデルが質問を分解する様子を見るには、次を呼び出してください agentic_retrieve_stream その上に bedrock-agent-runtime クライアントに直接つながります。このチュートリアルの中で、あえて扱わずに進むのがこの一箇所です。 langchain-aws、ヘルパーがトレースイベントを破棄し、公開しないため maxAgentIteration またはカスタムプランナーモデル。
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}],
    retrievers=[{
        "configuration": {
            "knowledgeBase": {
                "knowledgeBaseId": KB_ID,
                "retrievalOverrides": {"maxNumberOfResults": 10},
            }
        }
    }],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        # 5 is the API default. Below 4 the planner stops decomposing entirely.
        "maxAgentIteration": 5,
    },
    generateResponse=False,
)

for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f" sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])
設定 generateResponse から False 検索の動作だけが必要な場合向けです。APIはデフォルトで根拠に基づく回答を生成するため、プランを確認している間には不要なモデル呼び出しが追加で発生します。
トレースイベントの step プランナーの位置を示します。 SpeculativeRetrieval 遅延を削減するための最初のプランの前に実行され、イテレーション予算にはカウントされません。 Planning モデルが質問とそれまでの結果を読み込み、サブクエリを出力する部分です。 Retrieval サブクエリごとに1回発火します。 FullDocumentExpansion モデルがパッセージに回答のための文脈が不足していると判断し、文書全体を代わりに取得した場合に表示されます。それぞれに次のステータスが付与されます: IN_PROGRESS, SUCCEEDED、または FAILED、および人間が読めるメッセージ。
最後のチャンクは別々に届く。「The」という result は第5のステップではなく独自のイベント型であり、応答生成が有効な場合、グラウンディングされた回答とともに各反復の重複排除済みチャンクを保持します。前述のループが示すように、最終的なステップ値を期待するのではなく、イベントキーで分岐してください。
サブクエリのテキストは、ロギングする価値のある部分です。それは attributes.actions[].retrieve.inputQuery.text内にあり、トップレベルのトレースフィールドにはないため、 step のみを読み取るハンドラーでは、プランニングが行われたことは分かりますが、何を決定したかは分かりません。 status と
の違いに注意してください。次の図は、エージェント型リトリーバルのプランニングループを示しています。投機的リトリーバル、プランニング、サブクエリリトリーバル、評価、およびオプションの再プランニングのステップが含まれます。
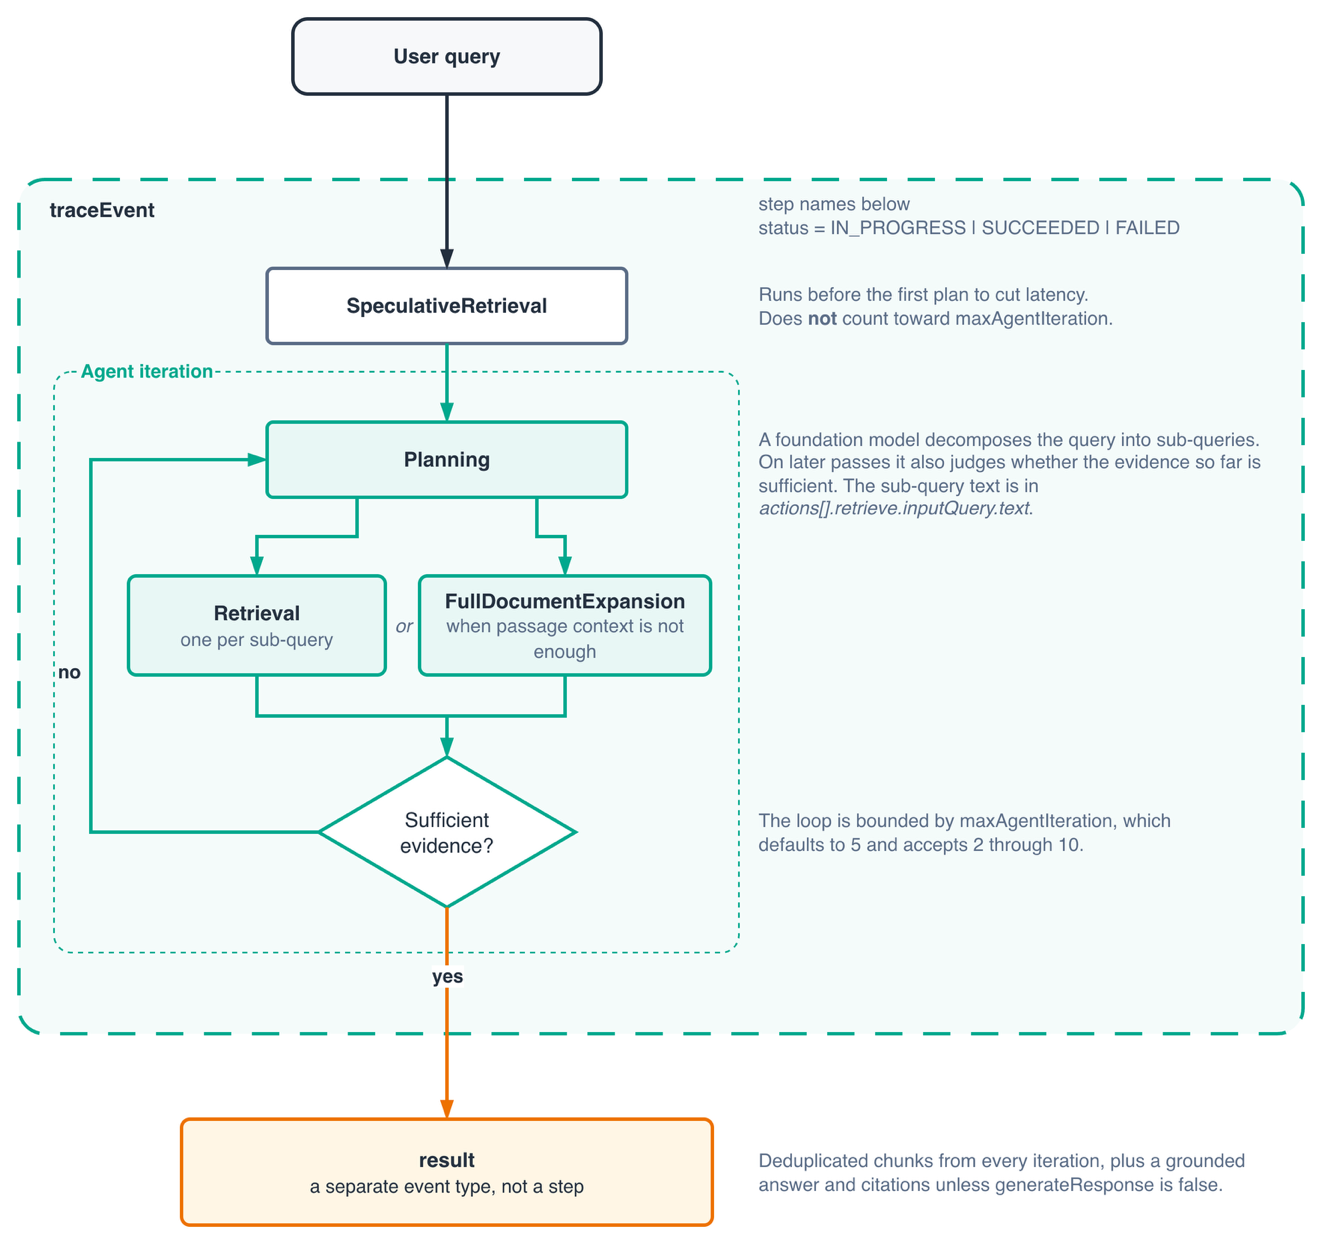
図 2: エージェント型リトリーバルのプランニングループのステップ
これを基に構築する前に知っておくべき2つの詳細があります。重複排除は result イベントにのみ適用されるため、3つのサブクエリで取得されたチャンクは、最後には1回だけ現れますが、トレース全体では3回現れます。
2つ目はスコアに関するものです。Retrieveレスポンスは、各チャンクにクエリとの関連性を保持する型付きの score フィールドを与えます。エージェント型リトリーバルの結果は content, metadataと sourceRetrieverを保持しますが、同等の型付きフィールドはありません。APIを切り替えた後に result["score"] を読み取るコードは何も取得できません。関連性でランク付けやフィルタリングを行う場合は、この違いに備えてください。
本番環境では、Amazon Bedrock Guardrailsを使用して、生成されたレスポンスに対するコンテンツポリシーとグラウンディングチェックを強制してください。両方のリトリーバルパスがガードレールをサポートしています。エージェント型リトリーバルは、LangChainリトリーバーが取る policyConfiguration.bedrockGuardrailConfiguration 引数ではなく guardrail_config を通じてガードレールをサポートしており、 BLOCK モードのみをサポートしています。 MASK モードに依存している場合、それがRetrieve APIを使い続ける理由になります。
maxAgentIteration は2から10を受け付け、デフォルトは5です。デフォルトのままにしてください。2または3では、プランナーは1サイクルを実行し、サブクエリを生成せず、投機的リトリーバルのステップですでに見つかったものを返します。これはエージェント型の価格でのシングルショット動作です。分解は4から始まります。プランナーは証拠が十分であると判断すると早く停止することが多いため、上限は目標ではなく境界です。
2つのリトリーバルパスの比較
大規模時の動作に関する背景として、AWSは公開されているマルチホップベンチマークであるMuSiQueでエージェント型リトリーバルを評価しました。評価では、シングルショットリトリーバルよりもリコールが向上し、最も難しい質問で最大の改善が見られました。シングルホップの質問では5ポイント未満の改善でした。この最後の数値はトレードオフの形状と一致しています。分解すべきものがある場合に分解は役立ちます。
RAGチェーンの構築
標準のリトリーバーでは、通常の LangChain Expression Language (LCEL) による構成がそのまま機能します:
from langchain_aws import ChatBedrockConverse
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

llm = ChatBedrockConverse(model=MODEL_ID, region_name=REGION)
prompt = ChatPromptTemplate.from_template(PROMPT_TEMPLATE)

chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
format_docs 見た目以上に重要です。通過する Document オブジェクトをプロンプトに直接放り込むと、その repr、そしてモデルはメタデータのノイズがコンテキストに混入した状態になります。
エージェント的検索を同じ立場に置くには、それを RunnableLambda、リトリーバーではなく関数であるため:
from langchain_core.runnables import RunnableLambda

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
ご注意ください。 generate_response はここでオフです。このサービス自体が回答を生成できますが、チェーンの中では通常、独自のプロンプトとモデルを使いたいため、チャンクを取得して下流で生成します。呼び出しを1回で済ませコード量を減らしたい場合はサービスの生成を、プロンプトを自分で制御したい場合はラップ版を使いましょう。
標準検索とエージェント型検索のどちらを選ぶか
Retrieve は短く範囲が限られた質問に使用してください。より安価で高速であり、自己管理型のナレッジベースに対して機能し、結果にスコアを返します。本番環境のトラフィックの多くはこのような形です。
複数の部分から成る質問、比較的な質問、探索的な質問の場合、または根拠が複数のナレッジベースにまたがる場合は、AgenticRetrieveStream を使用してください。1回のリクエストで最大5つのナレッジベースを登録でき、それぞれに付与した自然言語の説明に基づいてサブクエリをルーティングします。もう一方のAPIではこれはまったくできません。呼び出しごとのコストは高く、複数回のモデル呼び出しを行うため、両者の中でレイテンシは高くなります。
すべてに単一の手法を使うのではなく、クエリの形状に基づいてルーティングすることが、私たちが推奨するパターンです。質問に対する分類器やヒューリスティックを使えば、トラフィックの大部分を低コストの経路に振り向け、プランナーはそれを必要とする質問のために確保できます。
リソースのクリーンアップ
作成したナレッジベース、そのデータソース、S3オブジェクトとバケット、IAMロールを削除してください。ドキュメントが含まれたナレッジベースは、ストレージ料金が発生し続けます。
bedrock_agent.delete_data_source(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)
bedrock_agent.delete_knowledge_base(knowledgeBaseId=KB_ID)
The リポジトリ バケットを空にしてロールを削除するクリーンアップスクリプトも含まれています。
結論
Amazon Bedrock Knowledge Bases と LangChain を使って RAG アプリケーションを構築する方法と、エージェンティック検索が、単一発の検索ではうまく回答できない複数部分からなる質問をどのように処理するかを示しました。また、現在の統合における摩擦点についても示しました。エージェンティック検索は LangChain のリトリーバーではなく関数であるため、必要なのは RunnableLambda 連鎖して並ぶこと。クエリプランを表示するトレースイベントには、直接の boto3 呼び出し。
エージェント型リトリーバルは、マルチホップの質問での想起精度を向上させるために、1回の呼び出しあたりのコスト増を引き換えとし、クエリ計画に組み込みモデルを使用します。次に有効なステップは、すべてのクエリをプランナーに通す前に、自身のクエリ構成を測定することです。
始めるには、Amazon Bedrock Knowledge Bases をご覧ください ドキュメント および付属のサンプルコードをご覧ください。ご自身のワークロードへの適用についてサポートが必要な場合は、AWSのアカウントチームにお問い合わせください。