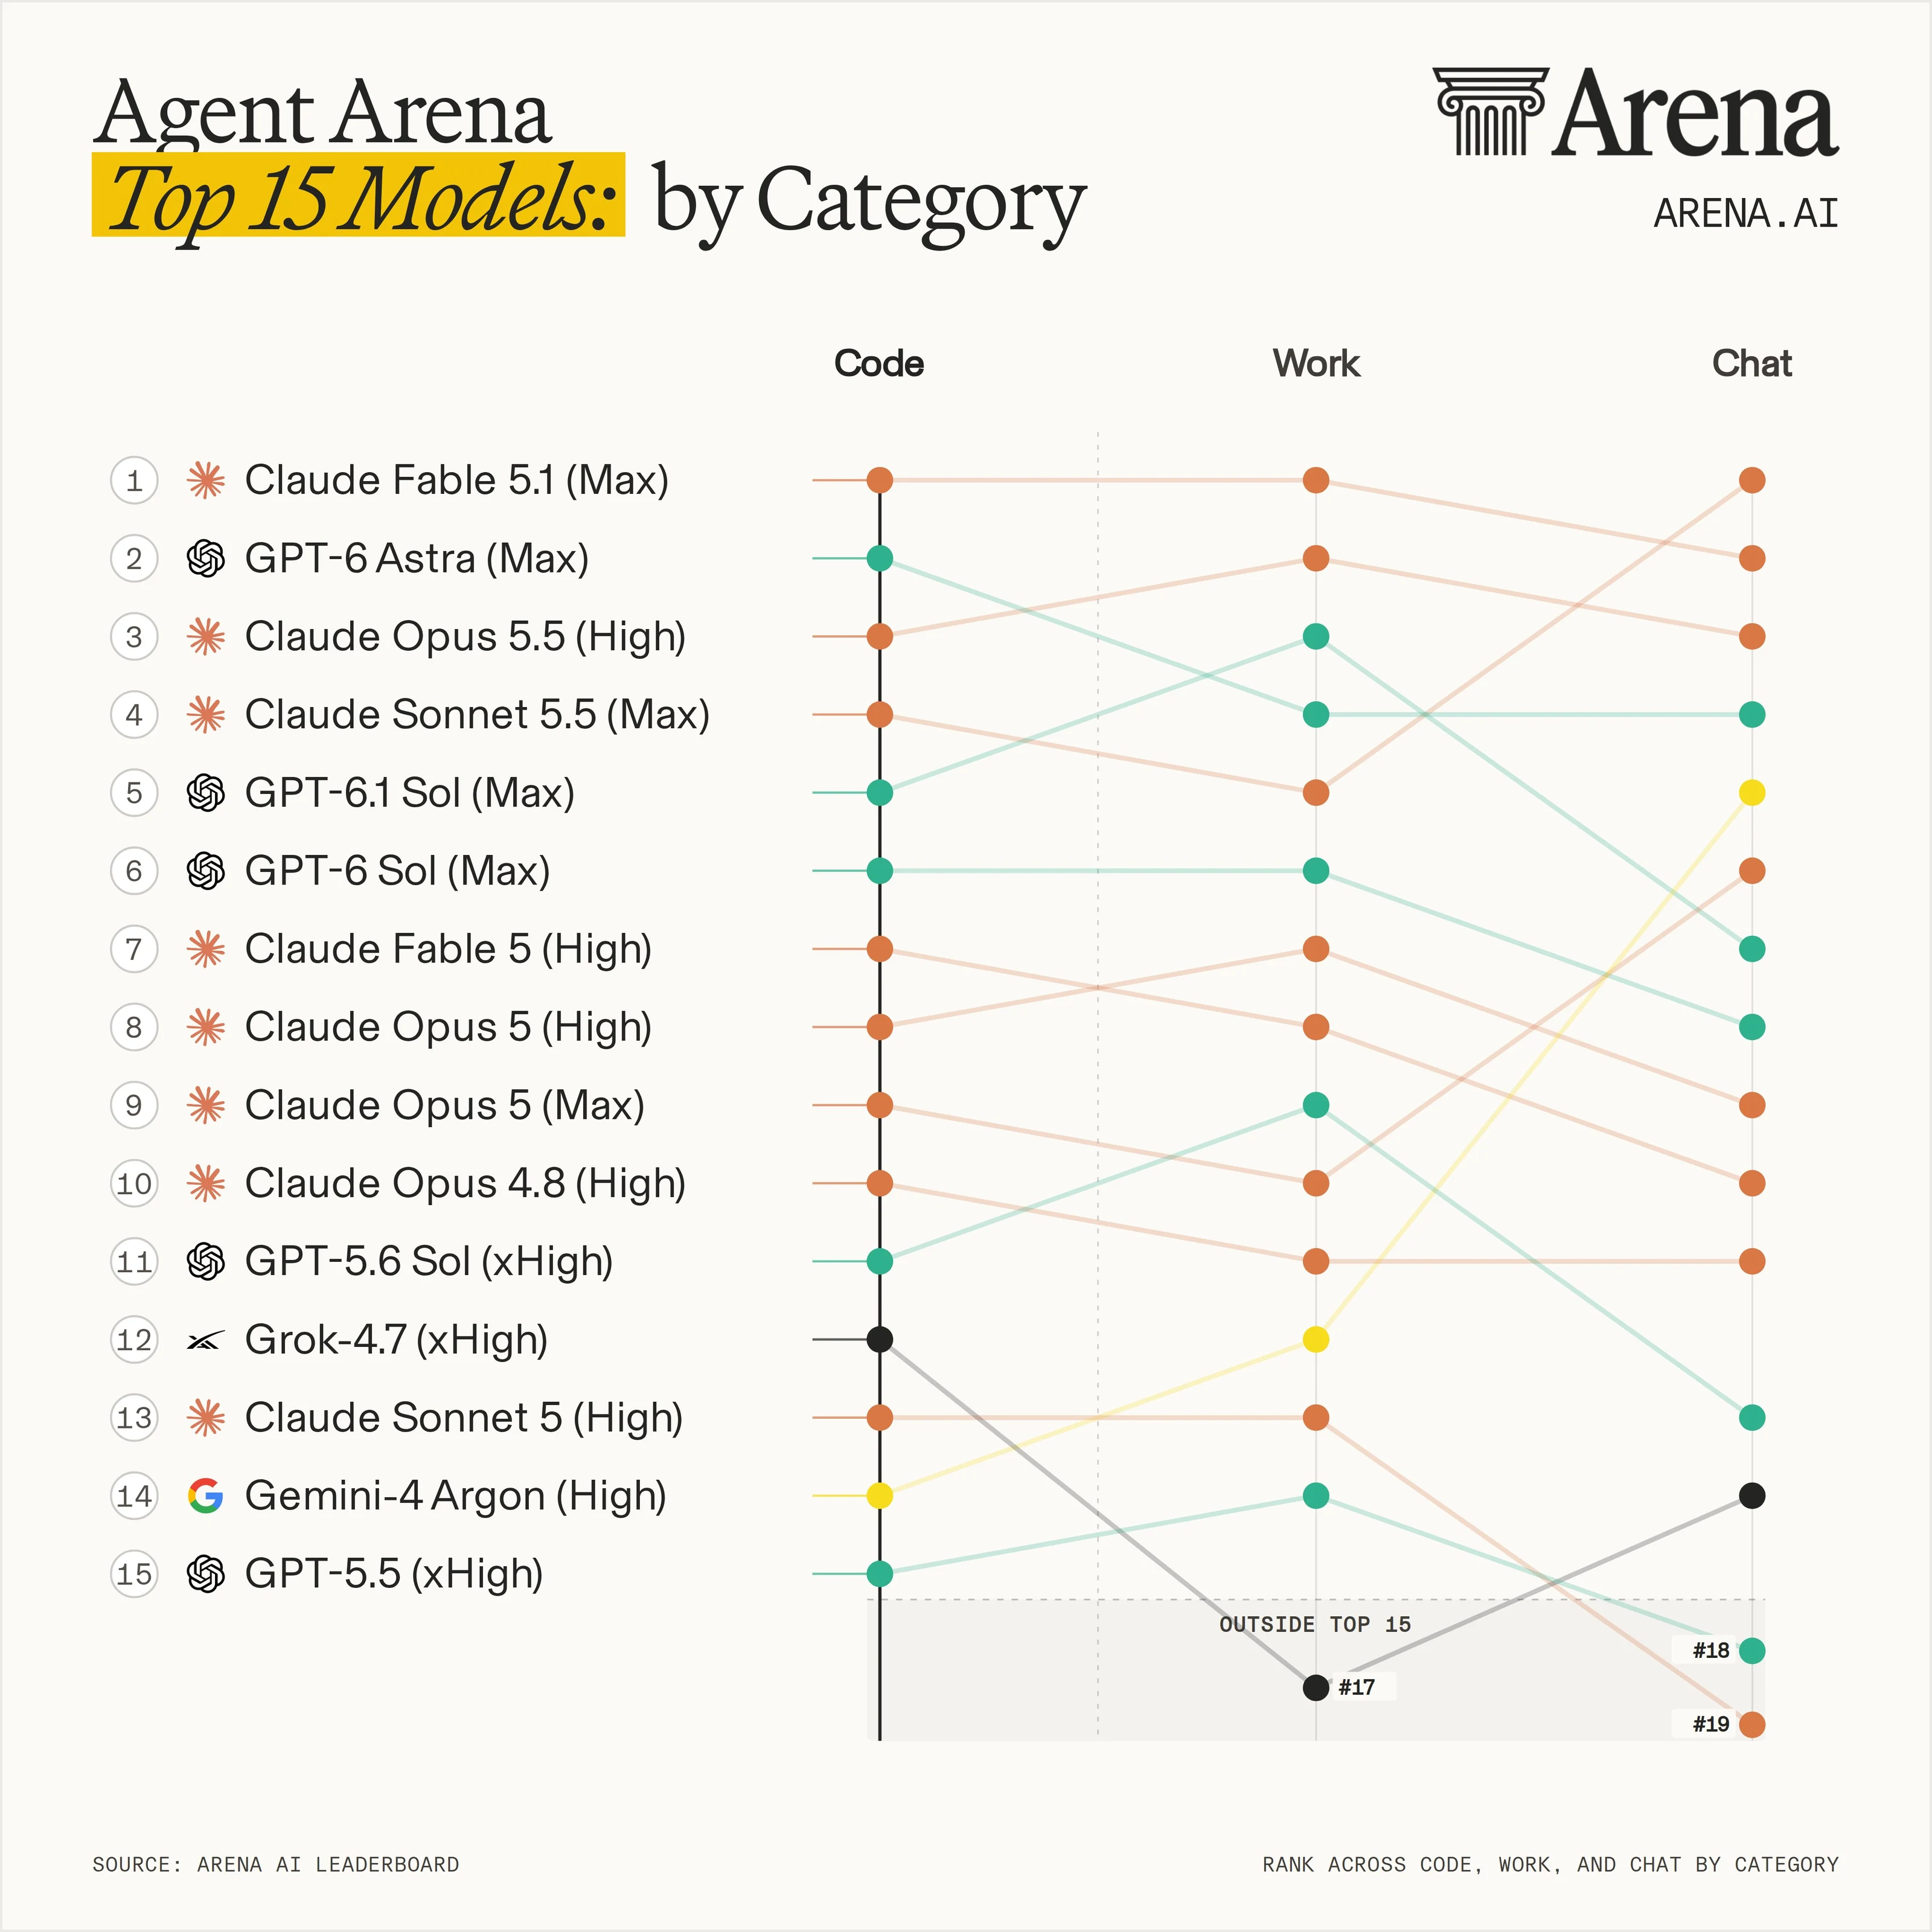
Agent Arenaは、異なる分野における問題解決能力を評価する。
米国のラボは全分野で首位を占める:
- @AnthropicAIのモデルはCode、Work、Chatの各カテゴリーで第1位に位置する
- @OpenAIのGPT 6 Astra (Max)は3つのカテゴリーすべてでトップ4に入り、Codeでは第2位、WorkとChatでは第4位である
トップモデルは各カテゴリーで強いままですが、順位が変わります:
- Claude Fable 5.1 (Max)がCodeとWorkの両方で首位となり、Chatでは2位です
- Claude Sonnet 5.5 (Max)がChatで首位となり、Codeでは4位、Workでは5位です
コードとワークのランキングはChatよりも密接に連動しています:
- 例えばGemini 4 Argon(High)は、コードで#14、ワークで#12の位置ですが、Chatでは#5の位置であり、対話型エージェントタスクにおける明確な強みを示しています
Agent Arenaは、現在のフロンティアに対する全体的なネット改善度と、エージェント型タスクの特定のカテゴリーにおける性能を基準にモデルをランキング付けします。これらのランキングは、世界中の人が提出した実世界のタスクを解決しようとするエージェントから収集されたライブトレースに基づいています。
- コード:コードの書き込みとデバッグ、ワークフローの自動化、データ分析
- チャット:創作的な執筆、学習、個人的な質問、日常の研究、メディア作成
- 作業:文書、専門的な研究、計画、専門的な執筆
この視覚的な図は、2026年10月5日時点で、Agent Arenaのカテゴリーごとに選ばれたモデルがどのように比較されるかを示しています。