
コーディングとエージェンタルワークロードは、AIモデルにこれまで以上の要求を突きつけている:数百件のファイルからなるリポジトリをリファクタリングし、コンテキストを失わずに数時間に及ぶエージェンタルワークフローを維持し、各ステップでツールを利用して複雑なシステム問題を解決する。これらの要求に対応するためには、オープンウェイトモデルを用いると、歴史的に自らインフィーダンスインフラを構築し運用する必要があった。
Z.aiのGLM 5.3(Zhipu AI)は、現在Amazon Bedrockで利用可能です。Hugging Face Hubに公開されているGLM 5.3は、コーディングや長期視野のエージェント型タスクに最適化された753Bパラメータの混合専門モデルです。特に、Z.aiによると、このモデルは顕著なサイバーセキュリティ機能を持っていると報告されています。Amazon Bedrockでは、クロスリージョン推理、プロンプトキャッシング、サービステージを含む完全管理型APIを通じて利用でき、インフラ構築は不要です。Bedrock上のGLM 5.3へのアクセスは、該当する企業顧客に提供されます。
この記事では、OpenAIと互換性のあるAPIを使用してAmazon Bedrock上でGLM 5.3を実行する方法を示します。また、プロンプトキャッシングによってコストと遅延を削減します。その後、モデルを現実的なエージェント型ワークフローで利用します。つまり、オープンソースのAIペネトレーションテストエージェントであるStrixを使って、自身のアプリケーションに対する承認されたセキュリティテストを実行するということです。
GLM 5と比べて新しい点は何ですか
GLM 5は今年早々にAmazon Bedrockに登場しました。GLM 5.3は同じ系列を踏襲しており、多くの重要な改善が行われています。
- より強力なコーディング: Z.aiは DeepSWE、Terminal Bench 3.0、FrontierSWEを含む様々なコーディングベンチマークにおいて競争力のある性能を発表しています。また、自身の内部コーディングベンチマークではGLM 5.2よりも50%の改善が見られたとも報告しています。 GLM 5との直接比較は報告されていません。なぜなら、改善の度合いが大きすぎて、GLM 5.1の発表以降、ベンチマークテスト自体を更新する必要が生じたからです。
- 新たに発展するサイバーセキュリティ能力: セキュリティタスクに関するベンチマーク性能が際立っており、このモデルは防御的なセキュリティワークフローに最適です。例えば、Z.ai 測定された リリース時のCyberGymベンチマークで84.5という高得点を記録した。
- より広範なAmazon Bedrock連携:クロスリージョンの推論プロファイル、暗黙的・明示的なプロンプトキャッシュ、およびInvokeおよびConverseと共にOpenAI互換性のある応答とChat Completions APIの機能同等性の向上。
主要機能
- フロンティアコーディングとエージェント型パフォーマンス。 GLM 5.3は、複雑なシステム工学や長期的なエージェント型タスクに向いて設計されています。これには、多段階的な推論、ツールを活用したワークフロー、そして大規模なコードベースにおける持続的なコンテキストが含まれます。
- 柔軟なAPIアクセス。 GLM 5.3を、OpenAI互換のResponsesおよびChat Completions API、またはAmazon Bedrock InvokeおよびConverse APIを通じて呼び出すことができます。
- プロンプトのキャッシュ処理。GLM 5.3はデフォルトで暗黙的(自動的)なプロンプトキャッシュ機能をサポートしており、ResponsesおよびChat Completions APIでは明示的なキャッシュ制御(推奨)も可能です。各ターンで大きなシステムプロンプトやリポジトリのコンテキストを再送するエージェント型ワークロードにおいて、キャッシュ処理によりレイテンシと入力コストの両方が低減されます。
- クロスリージョン推論。 GLM 5.3は、USクロスリージョン推論(
us.zai.glm-5.3)およびGlobalクロスリージョン推論(global.zai.glm-5.3)プロファイルを通じて利用可能です。選択したAWSリージョンの「ソース」にリクエストを送信し、Amazon Bedrockが各リクエストを安全に処理するようにルーティングします。詳細については、Amazon Bedrockユーザガイドを参照してください。 - サービス等級。 時間的により重要でコストを抑えた作業にはFlexを、遅延が重要なリクエストに優先処理を提供する代わりに高い価格が必要な場合はPriorityを、価格と速度のバランスが理想的な場合はStandardを選択してください。
前提条件
以下の使用例については、以下のものが必要です:
- Amazon BedrockにアクセスできるAWSアカウント。
- AWS Identity and Access Management (IAM) 権限を使って、ベースモデルとターゲット推論プロファイルを呼び出すには:
bedrock:InvokeModel、bedrock:InvokeModelWithResponseStream、bedrock:CallWithBearerTokenです。 - (コードベースのデモンストレーションの場合)Python 3.10以降。
- (オプションのセキュリティテストデモのみ)Dockerをインストールし、Bedrockエクストラを含むStrixを使用する。
Amazon BedrockコンソールでGLM 5.3を試してみてください
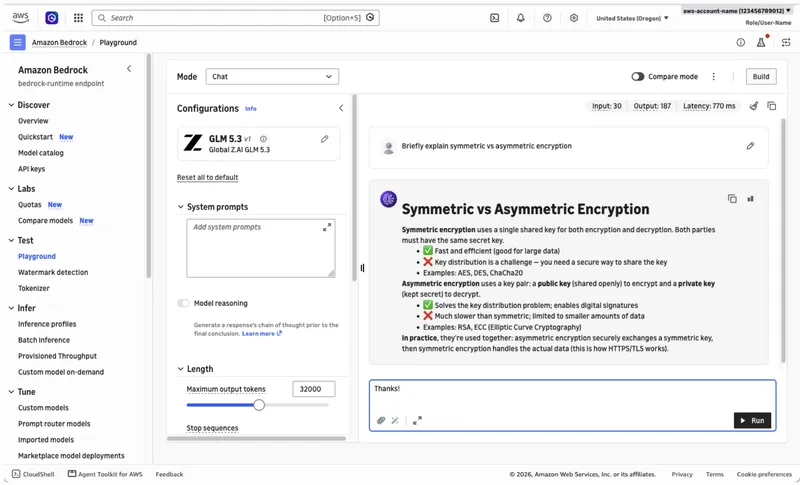
AWS Management ConsoleでGLM 5.3にプロンプトを送信することができます。コードを書いたり開発ツールをインストールしたりする必要はありません。始めるには、Amazon Bedrockに移動し、左側のサイドバーメニューからTest > Playgroundを選択します。
このプレイロードインターフェースから、モデルリストからGLM 5.3を選択し、以下のスクリーンショットに示されているように、チャットUIを通じて最初のプロンプトを送信できます。
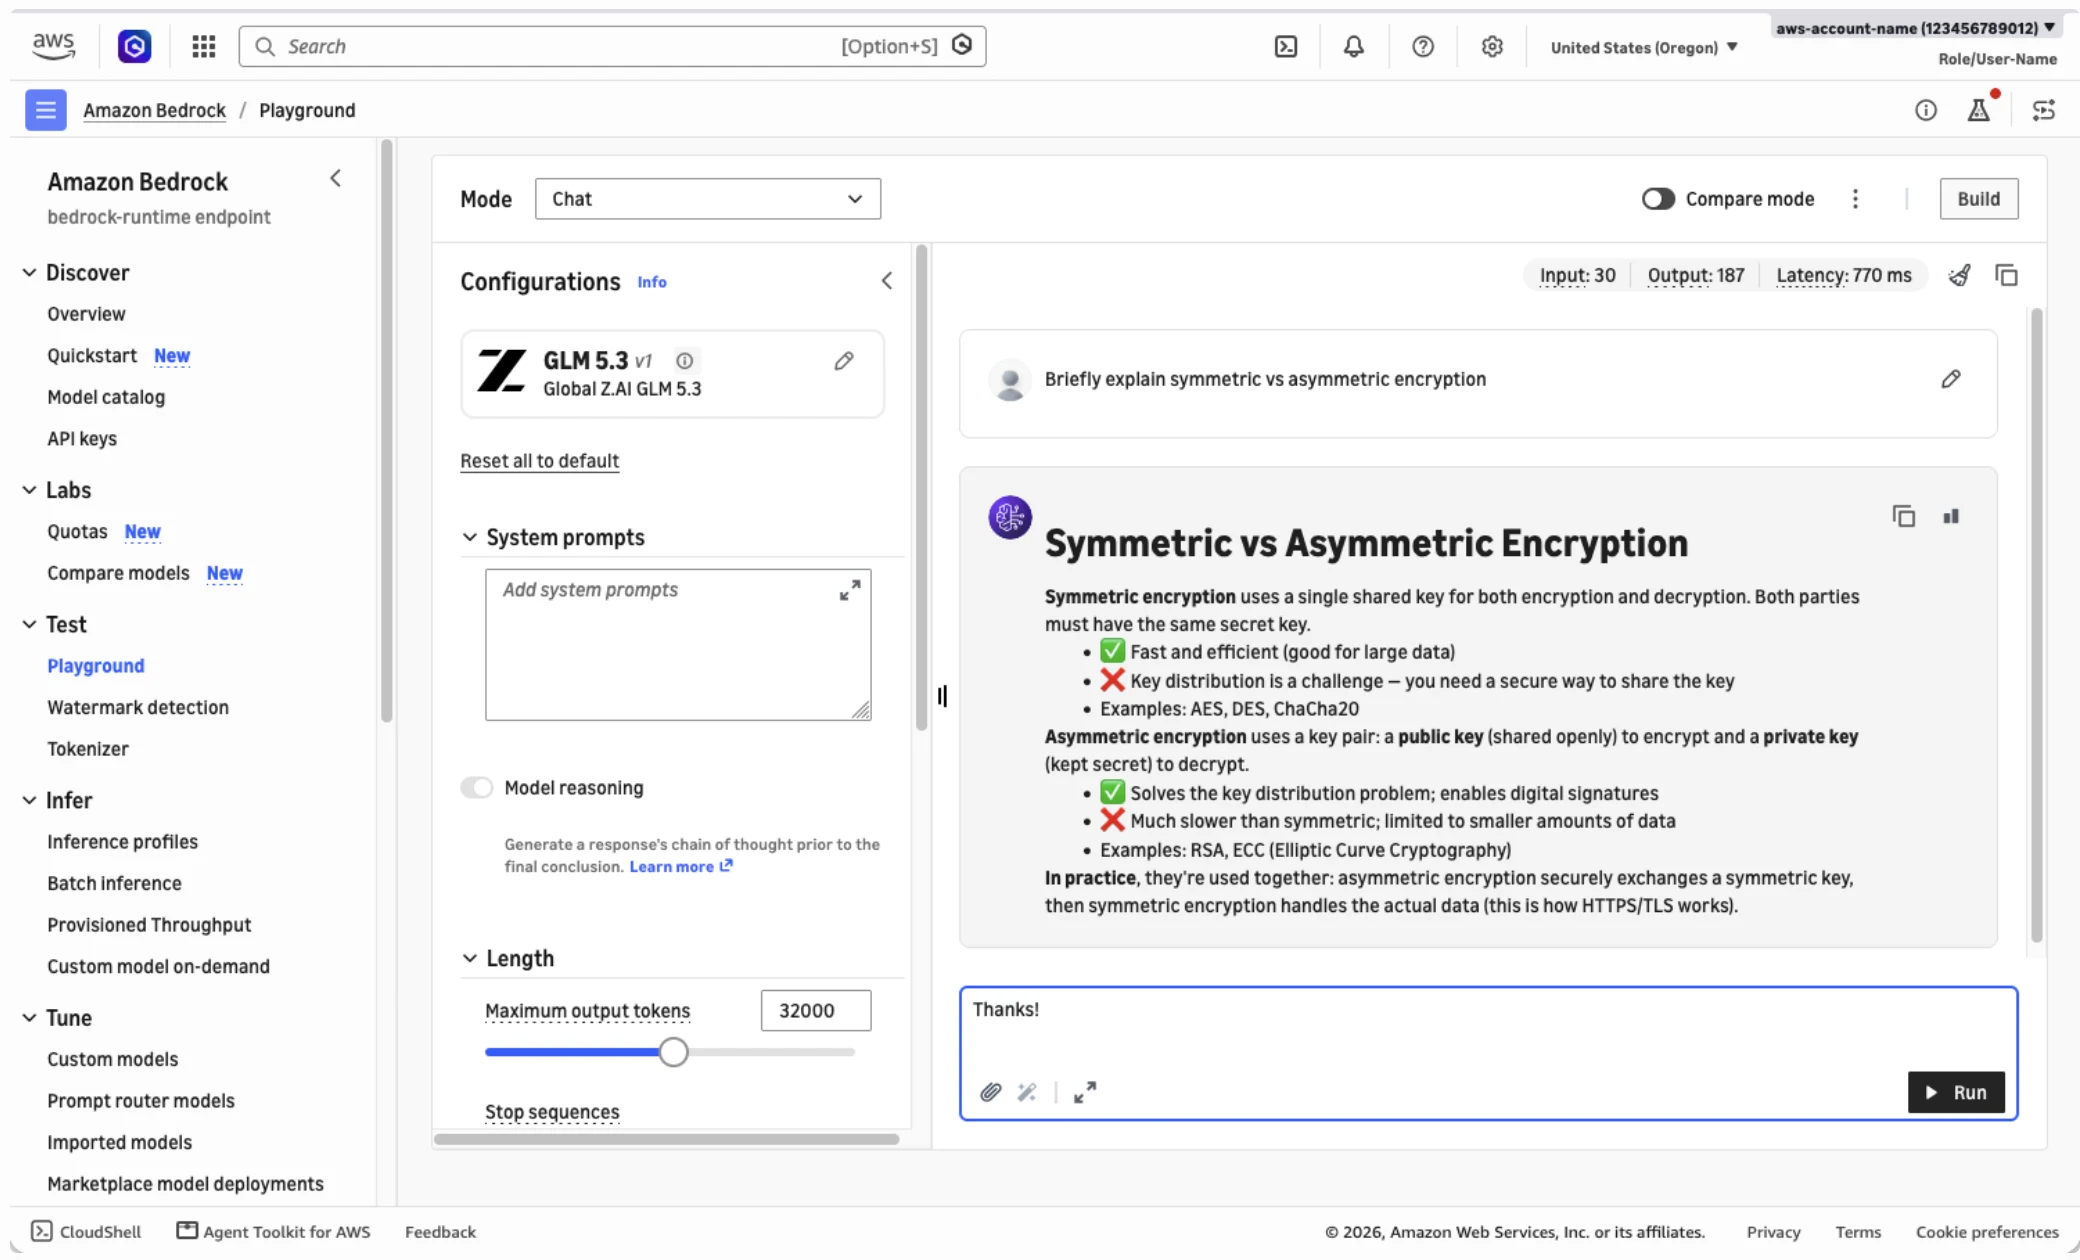
図1:Amazon Bedrockコンソール上でGLM 5.3とチャットする
Responses APIを使って始めましょう
プログラム的に、bedrock-runtimeエンドポイントを通じてモデルを呼び出すことができます。これにより、OpenAI互換のResponses APIやChat Completions API、そしてAmazon BedrockのInvoke APIおよび GLM 5.3のConverse APIがサポートされます。新しいアプリケーションについては、より完全な機能セットをサポートするため、OpenAI互換のAPIを推奨します。
Amazon Bedrockは、OpenAIと互換性のある統合処理に必要なAPIキー生成をサポートしています。しかし、可能な限り長期間有効なAPIキーよりも短期間有効な認証情報の方が好ましいと強く推奨します。
以下の例では、OpenAI Python SDKを使用してPythonからResponses APIを呼び出し、aws-bedrock-token-generatorライブラリを用いて、標準のAWS CLI認証情報から短期トークンを生成します。
- 必要なパッケージをインストールする。
pip install -U openai aws-bedrock-token-generator - 以下のコードを
bedrock-request.pyとして保存してください。from aws_bedrock_token_generator import provide_token from openai import OpenAI region = "us-west-2" # Your source AWS Region client = OpenAI( api_key=provide_token(region=region), base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1", ) resp = client.responses.create( input="Refactor this Python function to be iterative instead of recursive: ...", model="global.zai.glm-5.3", ) print(resp.output_text) - スクリプトを実行すると、モデルの出力が表示されます。
python bedrock-request.py
明示的なプロンプトキャッシングで推論を最適化する
長期にわたるコーディングや知識ワークフローでは、システムプロンプト、ツール定義、リポジトリファイルなど、複数の会話ターンを通じて安定したコンテキストが再送信されることがよくあります。
Amazon BedrockのGLM 5.3は、デフォルトで暗黙のプロンプトキャッシングをサポートしており、同じ初期プロンプトパスを共有する繰り返し呼び出しにおいて、応答の遅延時間と入力トークンコストを低減するのに役立ちます。
明示的なプロンプトキャッシングモードでは、再利用可能なプロンプトの先頭文字を具体的に指定でき、これによりキャッシュヒット率がさらに向上し(したがって遅延とコスト削減も得られる)。
以下の例に示されているように、GLM 5.3で明示的なプロンプトキャッシングを使用する。
- 要求時に
prompt_cache_optionsを通じて明示的なキャッシュモードを選択してください。 - 再利用可能なプロンプトプレフィックスの終了(含む)を示すために、入力コンテンツブロックに1つ以上の
prompt_cache_breakpointマーカーを追加する。各ブレークポイントには少なくとも1,024トークンが含まれていなければ、キャッシュ対象となる。
resp = client.responses.create(
    model="global.zai.glm-5.3",
    # Enable explicit caching mode:
    extra_body={"prompt_cache_options": {"mode": "explicit"}},
    input=[
        {
            "type": "message",
            "role": "system",
            "content": [
                {
                    "type": "input_text",
                    "text": SYSTEM_PROMPT,
                    # A long, static system prompt is a great target for caching:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ]
        },
        {
            "type": "message",
            "role": "user",
            "content": [
                {
                    "type": "input_text",
                    "text": USER_INPUT,
                    # Multiple breakpoints can also be defined, for layered cache:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ],
        },
    ],
)

if resp.usage.input_tokens_details.cached_tokens:
print("Hit cache!")詳細については、Amazon Bedrockユーザーガイドのプロンプトキャッシングセクションを参照してください。
エージェント型ワークロードの例:Strixによる承認されたセキュリティテスト
GLM 5.3の強みから直接恩恵を受けるワークロードの一つは、自社アプリケーションの自動化セキュリティテストです。StrixはオープンソースのAIペネトレーションテストエージェントで、コードを動的に実行し、脆弱性を発見し、概念実証テストによってそれらを検証します。この記事の時点で、StrixのドキュメントはGLM 5.3をデフォルトモデルとして使用しています。第三方インフレーションプロバイダーではなく、Amazon BedrockでGLM 5.3を使用するようにStrixを設定できます。したがって、モデルの推論はAWSアカウントの制御下で実行されます。
テストできるのは、自分が所有しているもの、または明確な書面による許可を得たもののみです。自分が所有していないシステムに対する無許可のセキュリティテストは、ほとんどの地域において違法であり、AWSの適切な使用ポリシーにも反します。このワークショップでは、対象はOWASP Juice Shopです。これは、あなたのマシン上でローカルに実行される、意図的に脆弱なサンプルアプリケーションです。
自らオープンソースエージェントを実行するだけでは不十分で、完全に管理された継続的なセキュリティテストが必要な場合、AWS Continuumは、管理サービスとしてオンデマンドのペネトレーションテストやその他のセキュリティ分析を提供します。これら二つのアプローチは相互補完的です。Strixのようなオープンソースエージェントでは、開発者主導の、ループ内での、深くカスタマイズ可能なローカルビルドに対するテストが行われますが、AWS Continuumでは大規模な管理された評価が実施されます。
承認されたセキュリティテストを実施する
- 例のJuice Shop targetアプリケーションをローカルで起動する。
docker run --rm -p 3000:3000 bkimminich/juice-shop - StrixをAmazon BedrockでGLM 5.3を使用するように設定する。Strixは内側でLiteLLMを利用しているため(Amazon Bedrockに関する彼らのドキュメントで説明されている通り)、AWS CLIの認証情報が自動的に取得される。これによりAPIキーは不要だが、
AWS_PROFILEやAWS_REGIONのような環境変数を設定して接続を構成することをお勧めする。現在、LiteLLMはbedrock/global.zai.glm-5.3を解決していない。これが修正されるまで、以下のサンプルに示すようにConverse APIルートとインフィニティーププロファイルAmazon Resource Name(ARN)を明示的に指定する。# Fill in the REGION and ACCOUNT_ID placeholders below before running! export STRIX_LLM="bedrock/converse/arn:aws:bedrock:{AWS_REGION}:{AWS_ACCOUNT_ID}:inference-profile/global.zai.glm-5.3" - ローカルターゲットに対してStrixを実行する。
strix --target http://localhost:3000 - ルートのStrixエージェントが完了するのを待ち、その後結果を確認します。
Strixはサブエージェントチームを動かし、脅威の状況を把握し、さまざまな潜在的な脆弱性のカテゴリーを調査し、各発見結果を実際の概念実証で検証しようと試みる。これにより、誤検出を処理する時間を最小限に抑えることができる。成功した実行後は、各発見結果について深刻度、証拠、修正ガイドを含む報告書が生成される。
以下の動画では、例のアプリケーションでStrixを設定し、実行するまでの全プロセスと、得られた結果の検討が示されています。
図2:GLM 5.3およびStrixを使用した例のセキュリティテストの実行
クリーンアップ
ジュースショップのコンテナを停止する Ctrl+C 実行中のターミナル内、または実行する docker ps コンテナIDを見つけて、それを停止する docker stop <container-id>Amazon Bedrockの推論はトークンごとの料金であり、永続的なリソースは含まれないため、要求が完了した後に追加の料金はかかりません。この説明のためにAmazon Bedrock APIキーを生成した場合、もはや必要でない場合は、Amazon Bedrockコンソール上で削除してください。
利用可能性
GLM 5.3を試してみてください。 Amazon Bedrockコンソール、OpenCodeのようなコーディングアシスタントを通じて使用することができます。 キミK3に関する最近の投稿、またはサポートされているAPIを通じて自分のカスタムアプリケーションを接続する。
Amazon Bedrockがどのようにチームをサポートするかに興味がありますか? 私たちと連絡を取る で、話し合いを始めましょう。