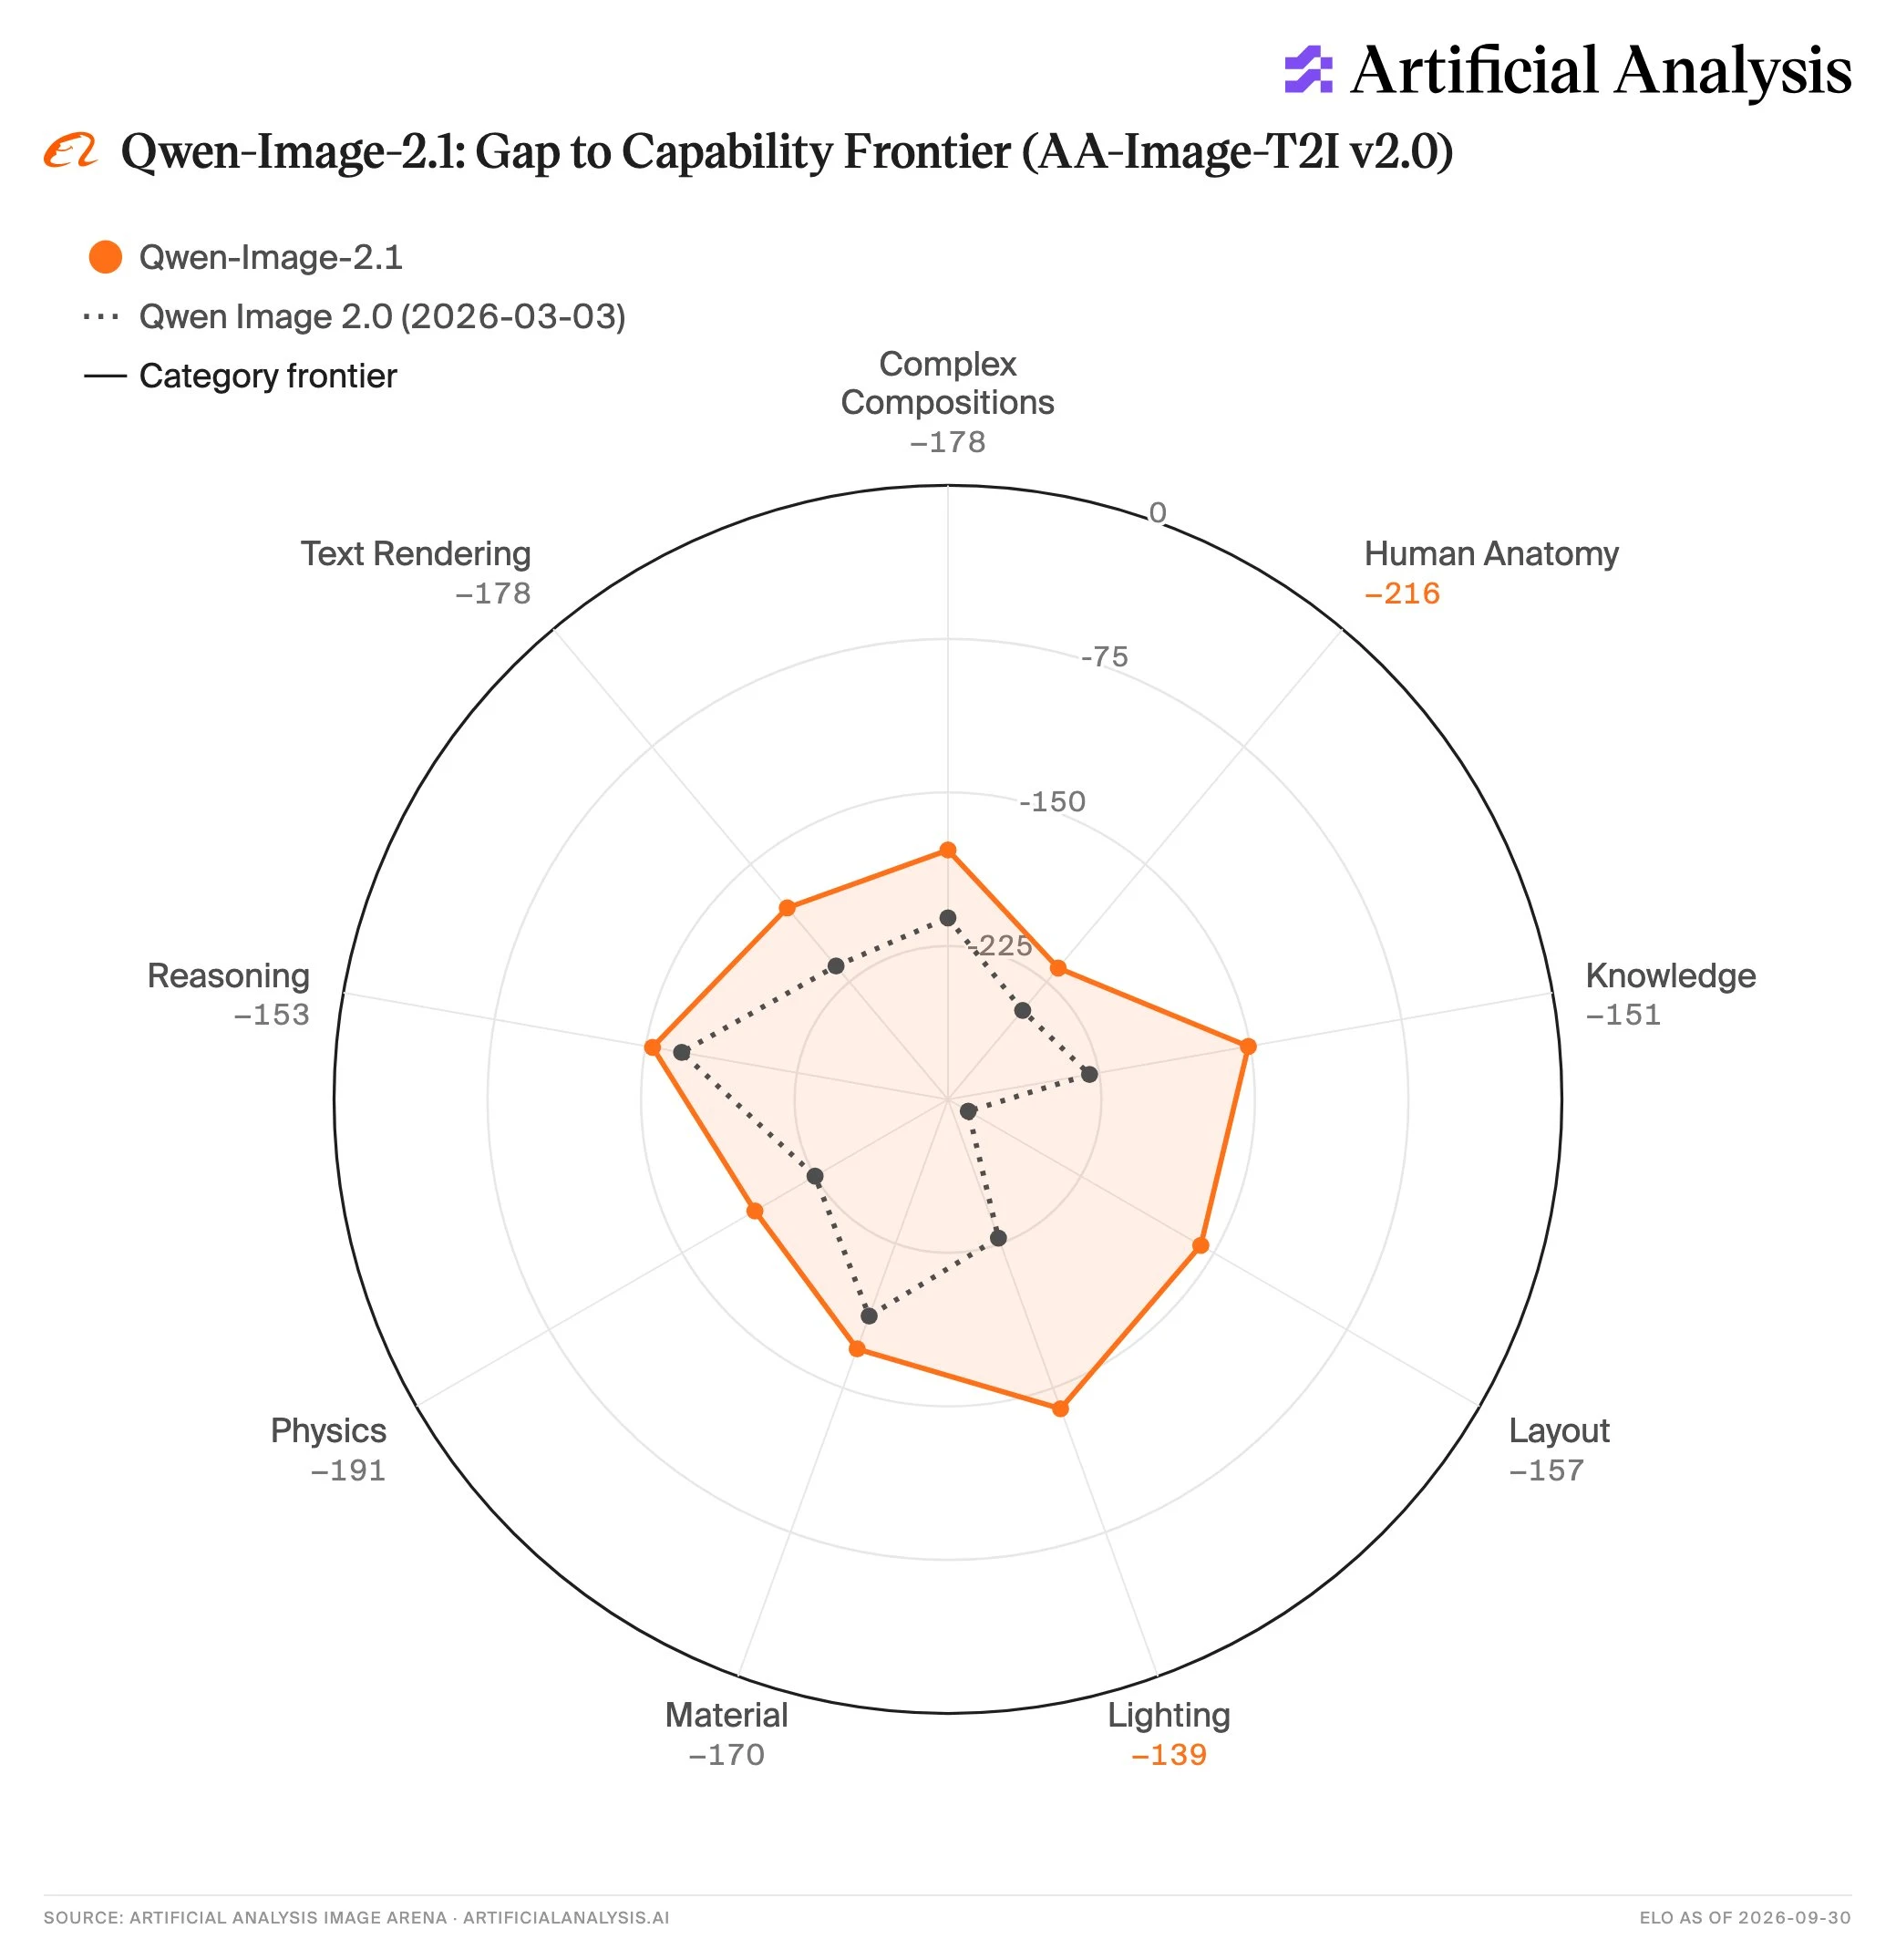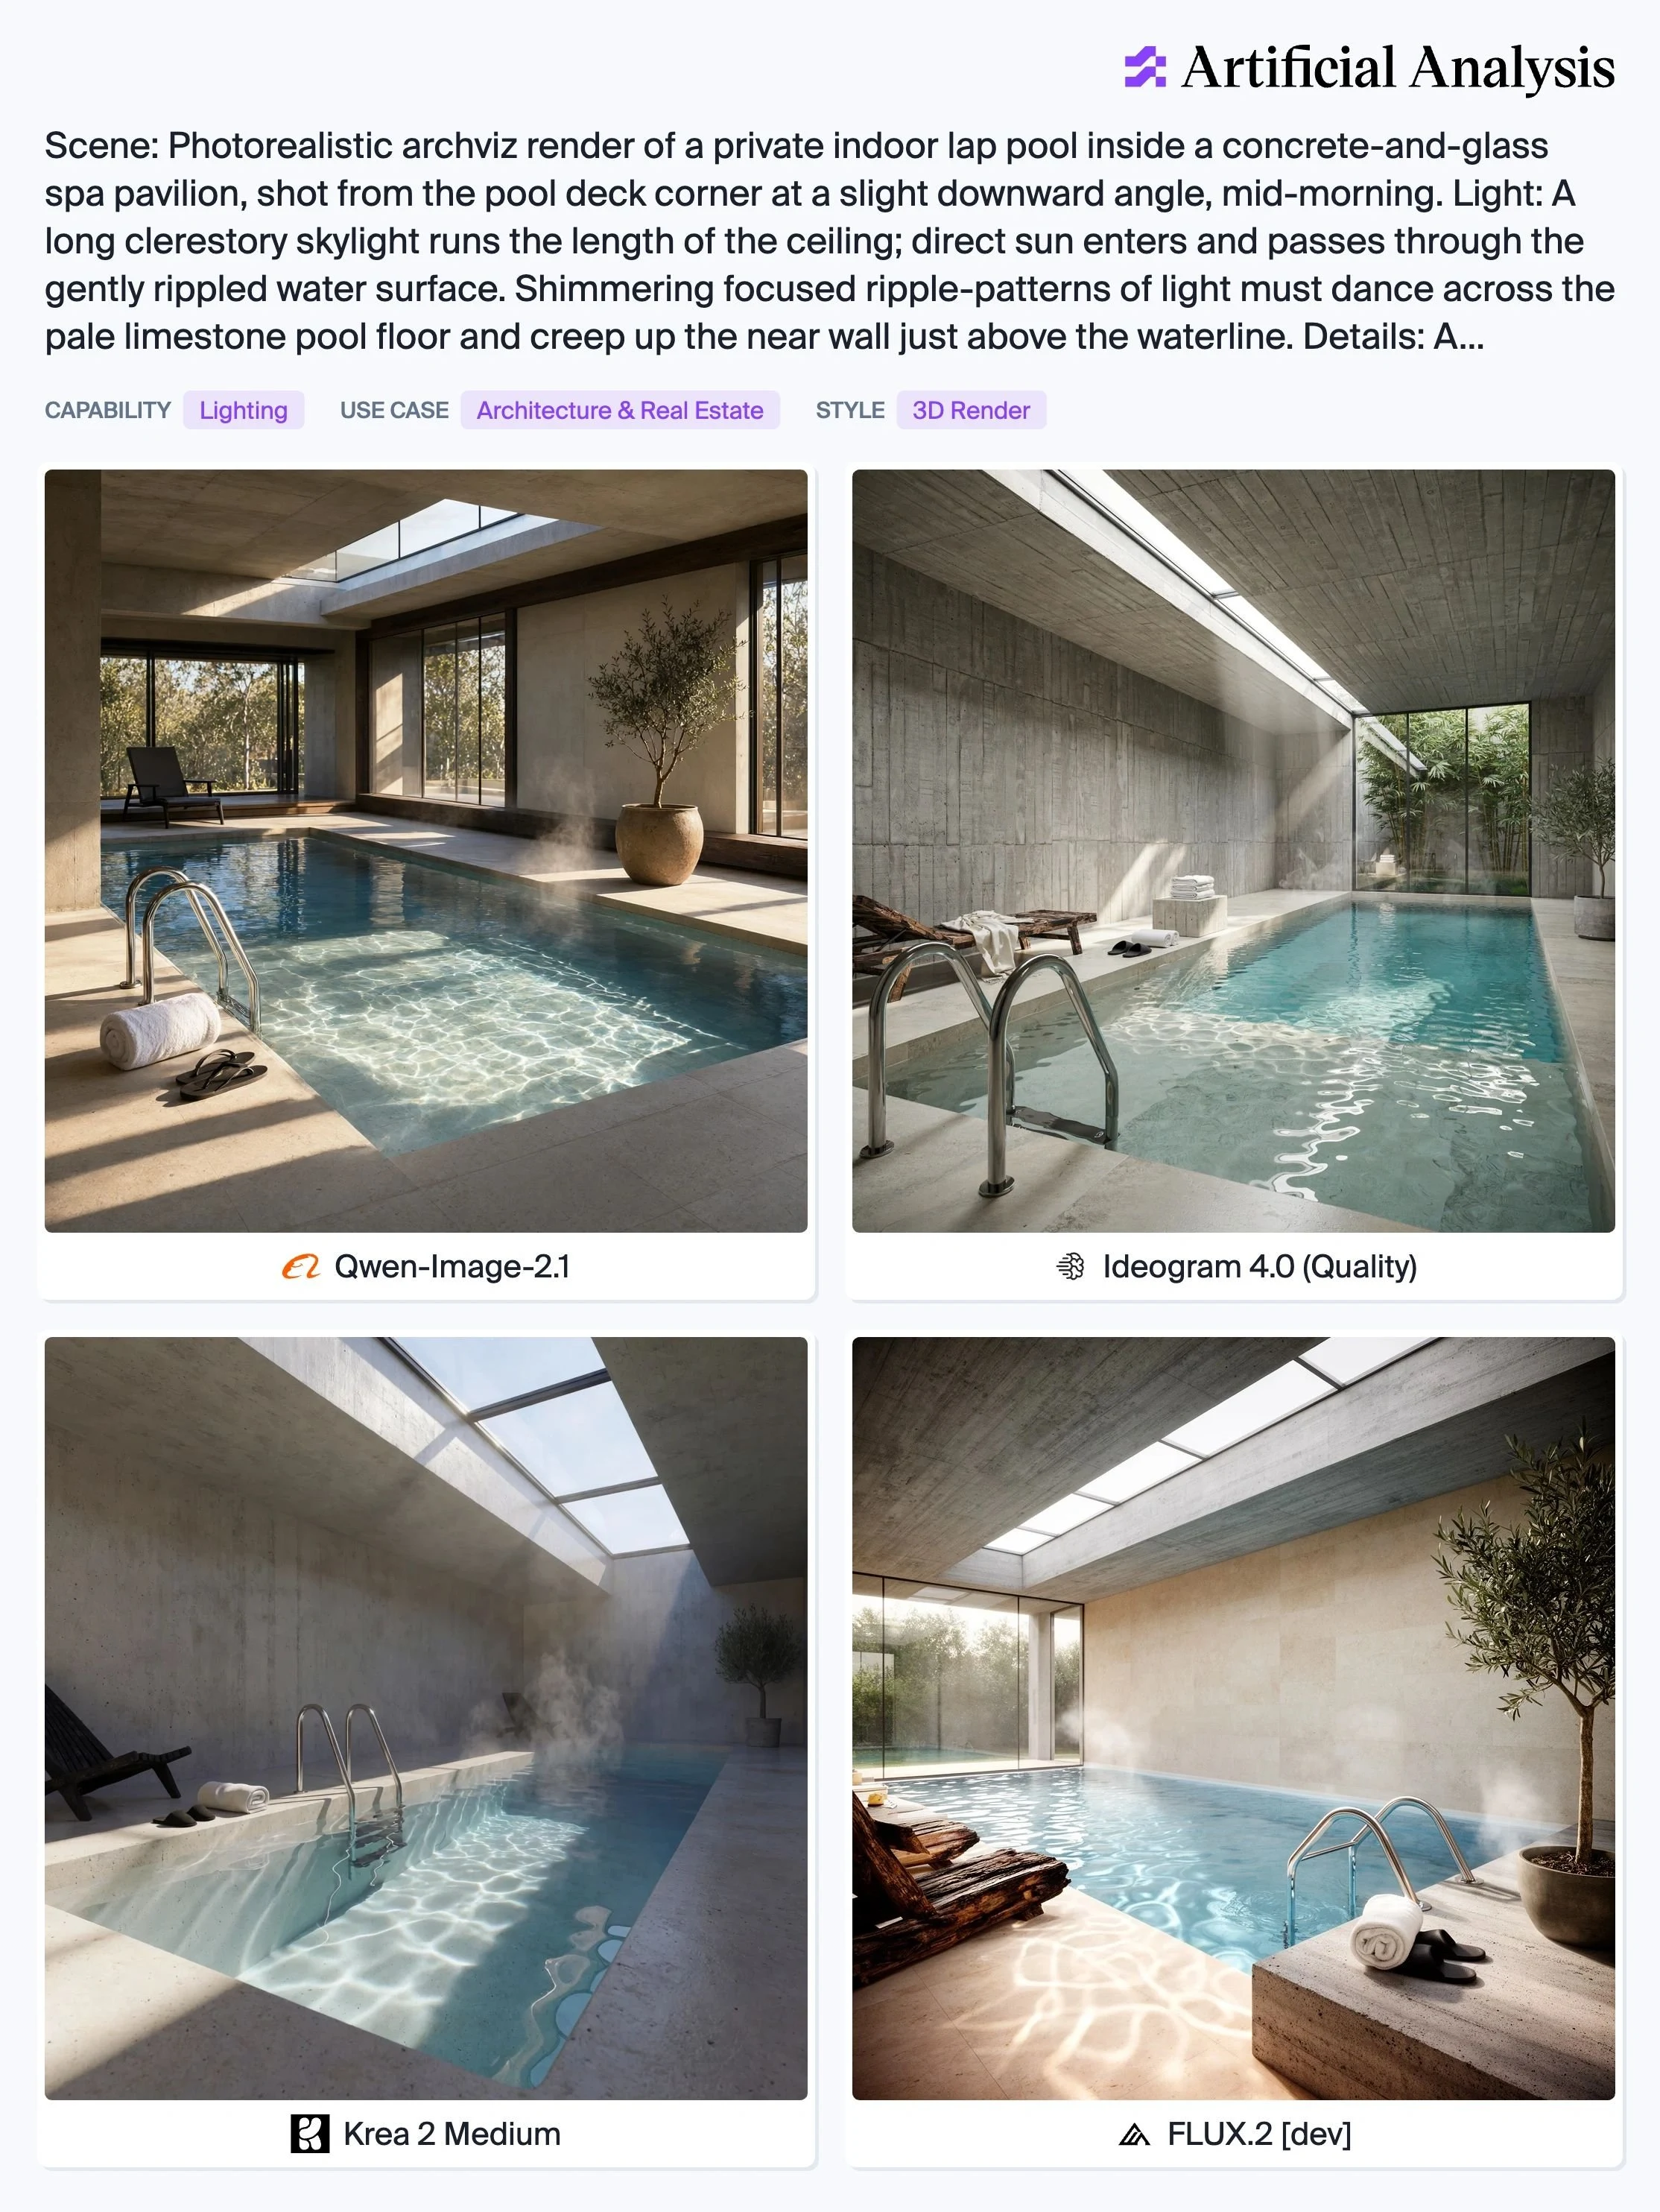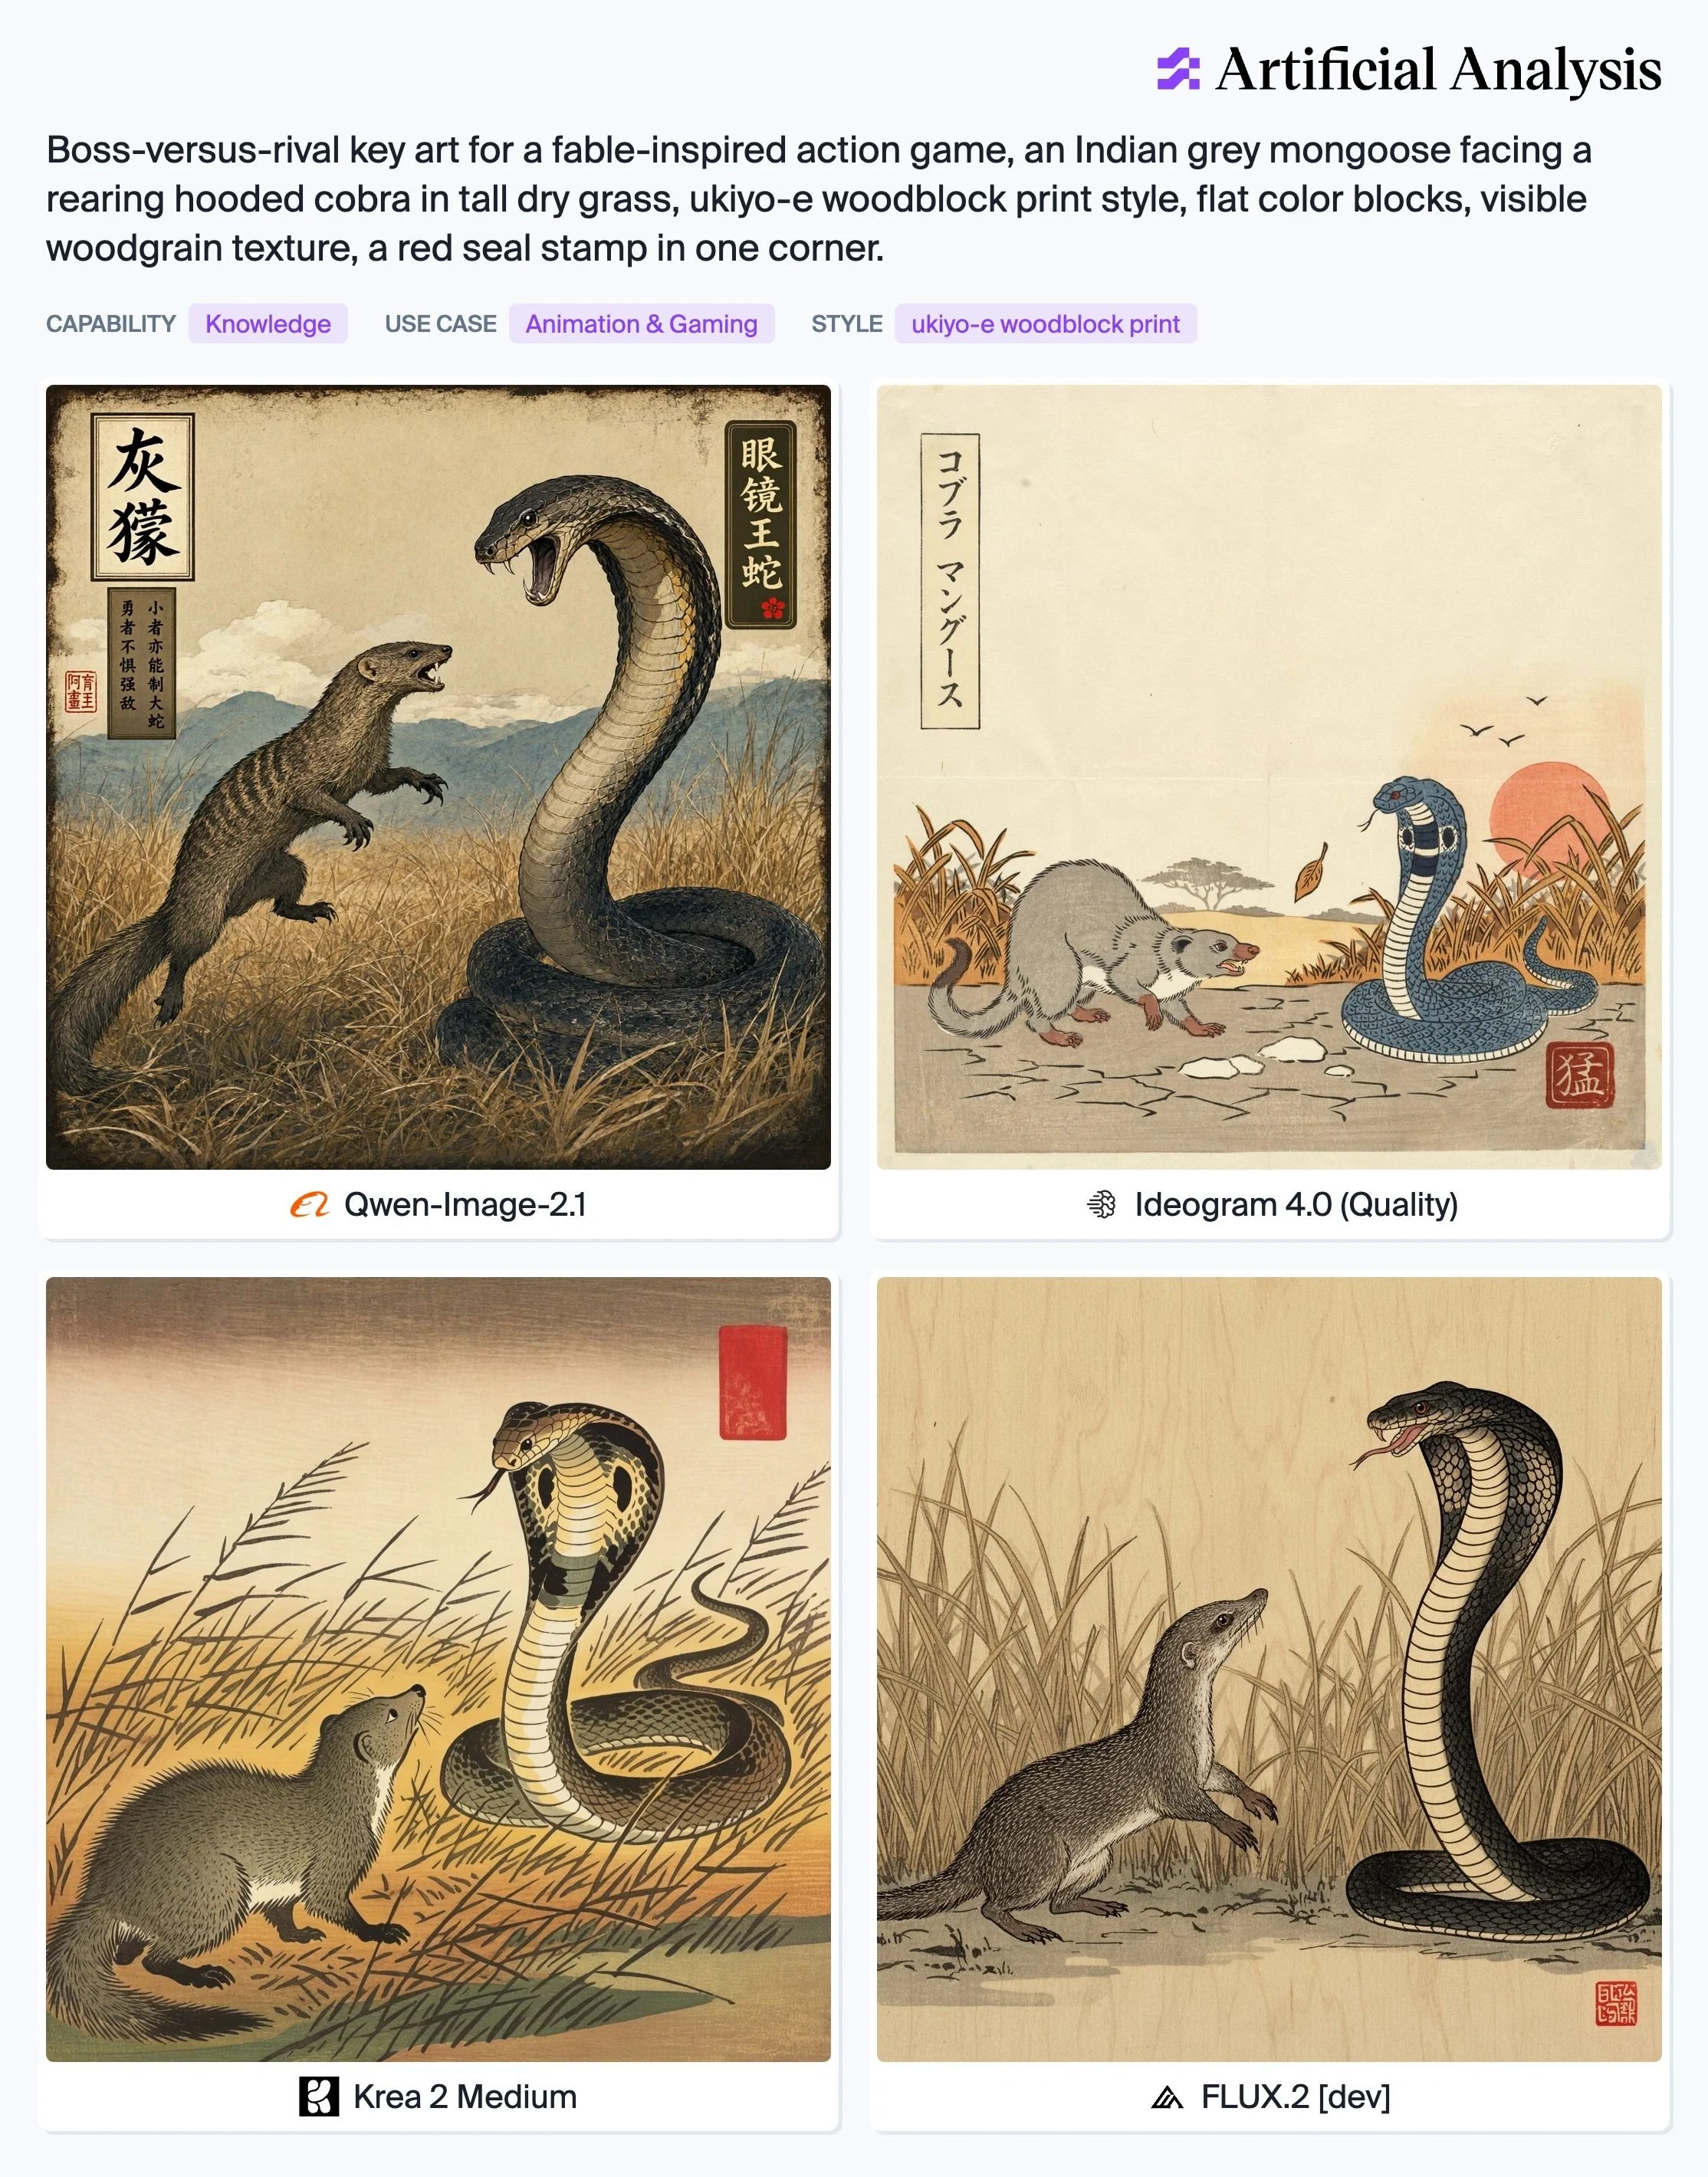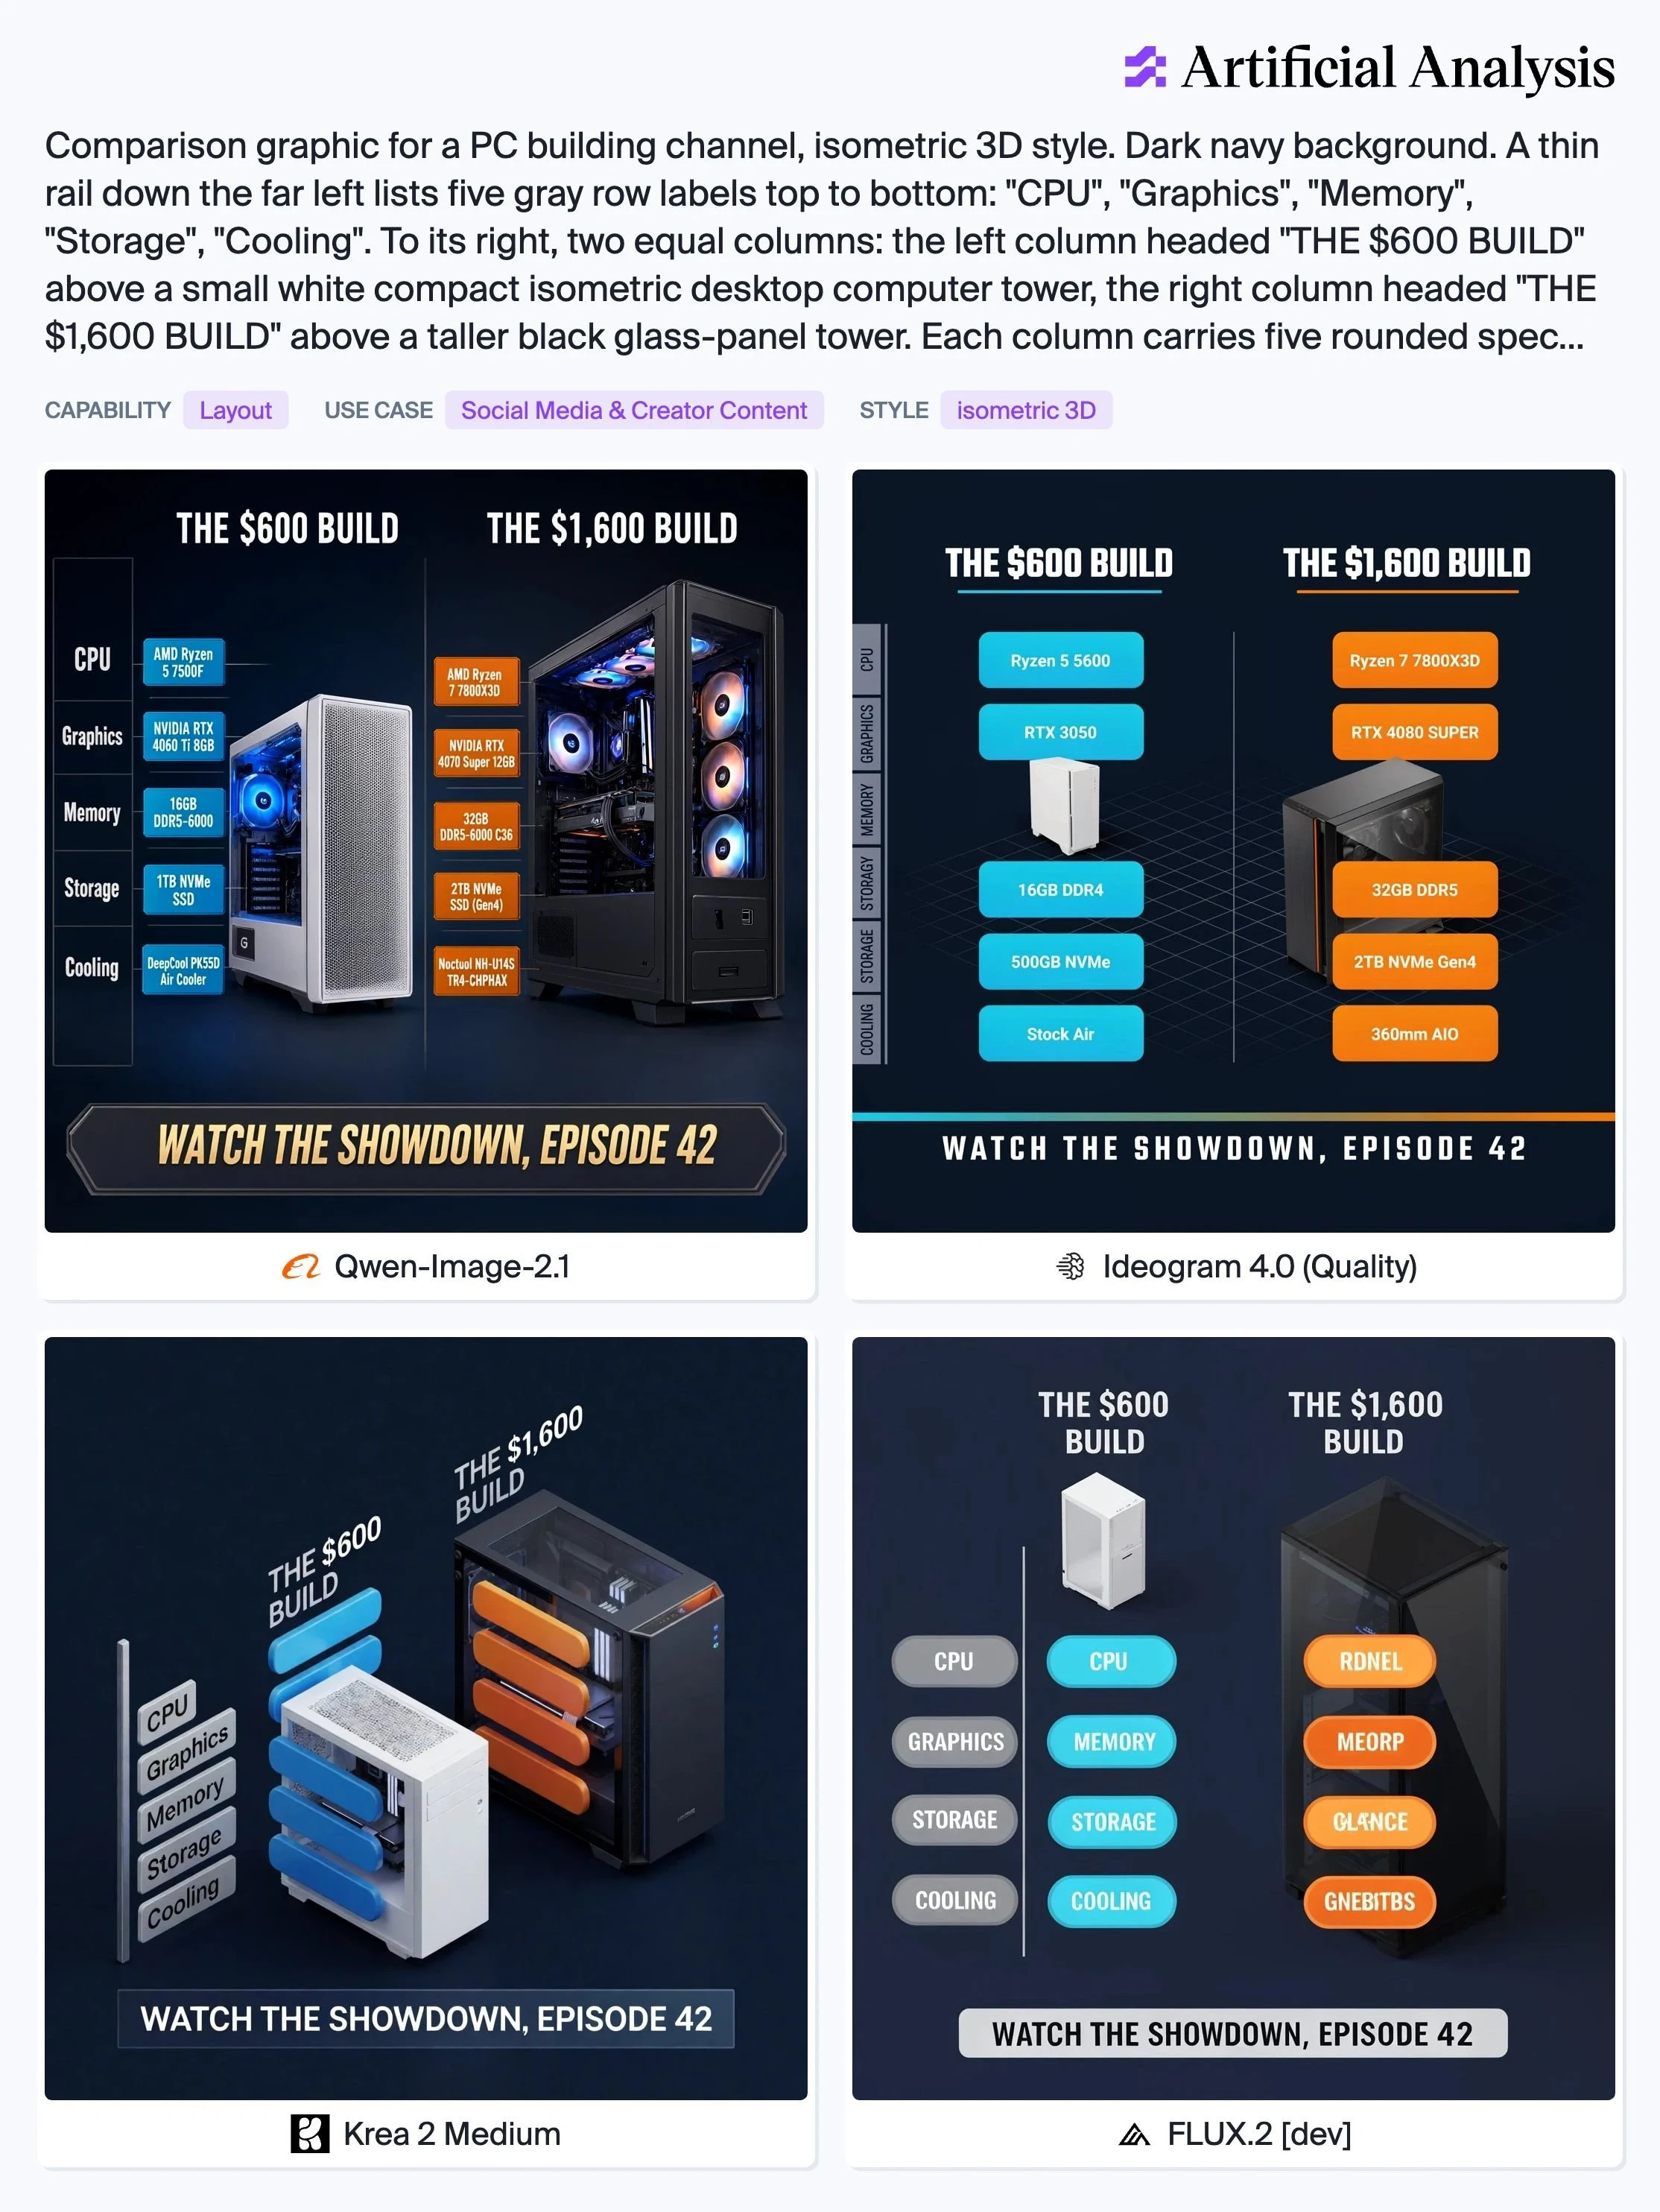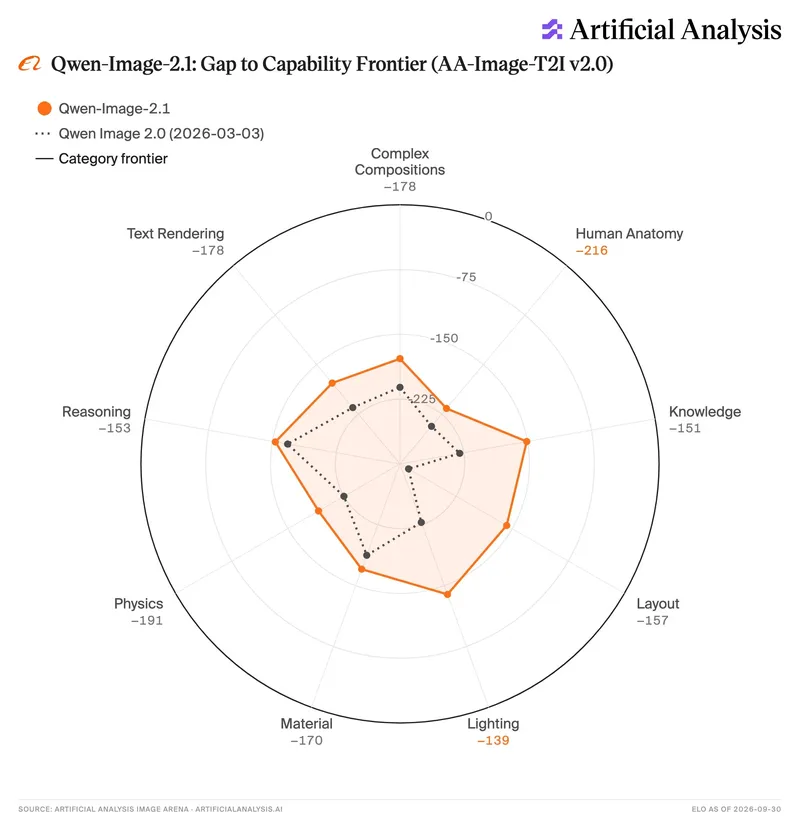
Text to ImageにおけるQwen-Image-2.1の最も強い点:Lighting、Knowledge、Reasoningの各カテゴリで全モデル中フロンティアに最も接近
私たちのText to Imageタクソノミーは、9つの能力と10のユースケースを測定し、それぞれに個別のリーダーボードがあります。能力とは、画像を作り上げるための個々のスキルです。
Qwen-Image-2.1はLightingでカテゴリのフロンティアに最も接近しており、次いでKnowledge、Reasoning、Layoutと続きます。Qwen Image 2.0と比較すると、すべての能力でフロンティアとの差を縮めており、特にLayout、Lighting、Knowledgeで大きな向上を示しています。
➤ Lightingは、反射、屈折、影、コースティクスをカバーします。
➤ Knowledgeは、実在するランドマーク、種、科学や常識に関するドメインの事実をカバーします。
➤ Reasoningは、慣用句の解釈、数学と科学、空間的・時間的推論、概念の混合をカバーします。