
市販のAIアシスタントは個々の質問には適切に答えますが、別の側面で不足しています。それは連続性です。今日、状態のないアシスタントに庭のことを尋ねても、3週間前に排水が速い植木鉢について、有機肥料のみを使っていること、またはペットタニアが暑さの影響を受けていることなど、全く知りません。すべての会話はゼロから始まり、文脈を再説する負担はユーザーのものとなります。
問題は回答の質ではなく、アシスタントがあなたを記憶していないことです。この投稿では、Amazon Bedrock AgentCoreの機能であるAgentCore runtime上で動作するオープンソースのエージェントシステムOpenClawを使用して、コンテキストを蓄積する個人アシスタントを構築する方法が示されています。AgentCore memoryもAmazon Bedrock AgentCoreの機能であり、使い捨てられたチャットを永続的な知識に変えます。また、現在の質問に関連する記録を取得するために、これらの記憶に構造化されたメタデータを付け加える方法も紹介されています。
私たちの実行例はGardening AssistantであるSproutですが、そのアーキテクチャはドメインに依存しません。人物像やスキルマニフェストを変更するだけで、同じパイプラインをサポートボット、フィットネスコーチ、または内部ヘルプデスクに利用できます。全体のシステムは単一のAWS CloudFormationテンプレートに含まれており、1つのコマンドでデプロイされ、月間数ドルのコストで軽度の個人使用に適した消費型モデルで動作します。 途中で、このスタック上で構築されるアシスタントに適用できるデザインガイドラインを共有します。
解決策の概要
AgentCoreは、任意のフレームワークやモデルを使用してエージェントを構築、接続、最適化するためのプラットフォームです。以下の図は、インバウンドのTelegramウェブホックからAgentCore実行環境および関連するAWSサービスを通じて行われるエンドツーエンドのリクエストフローを示しています。
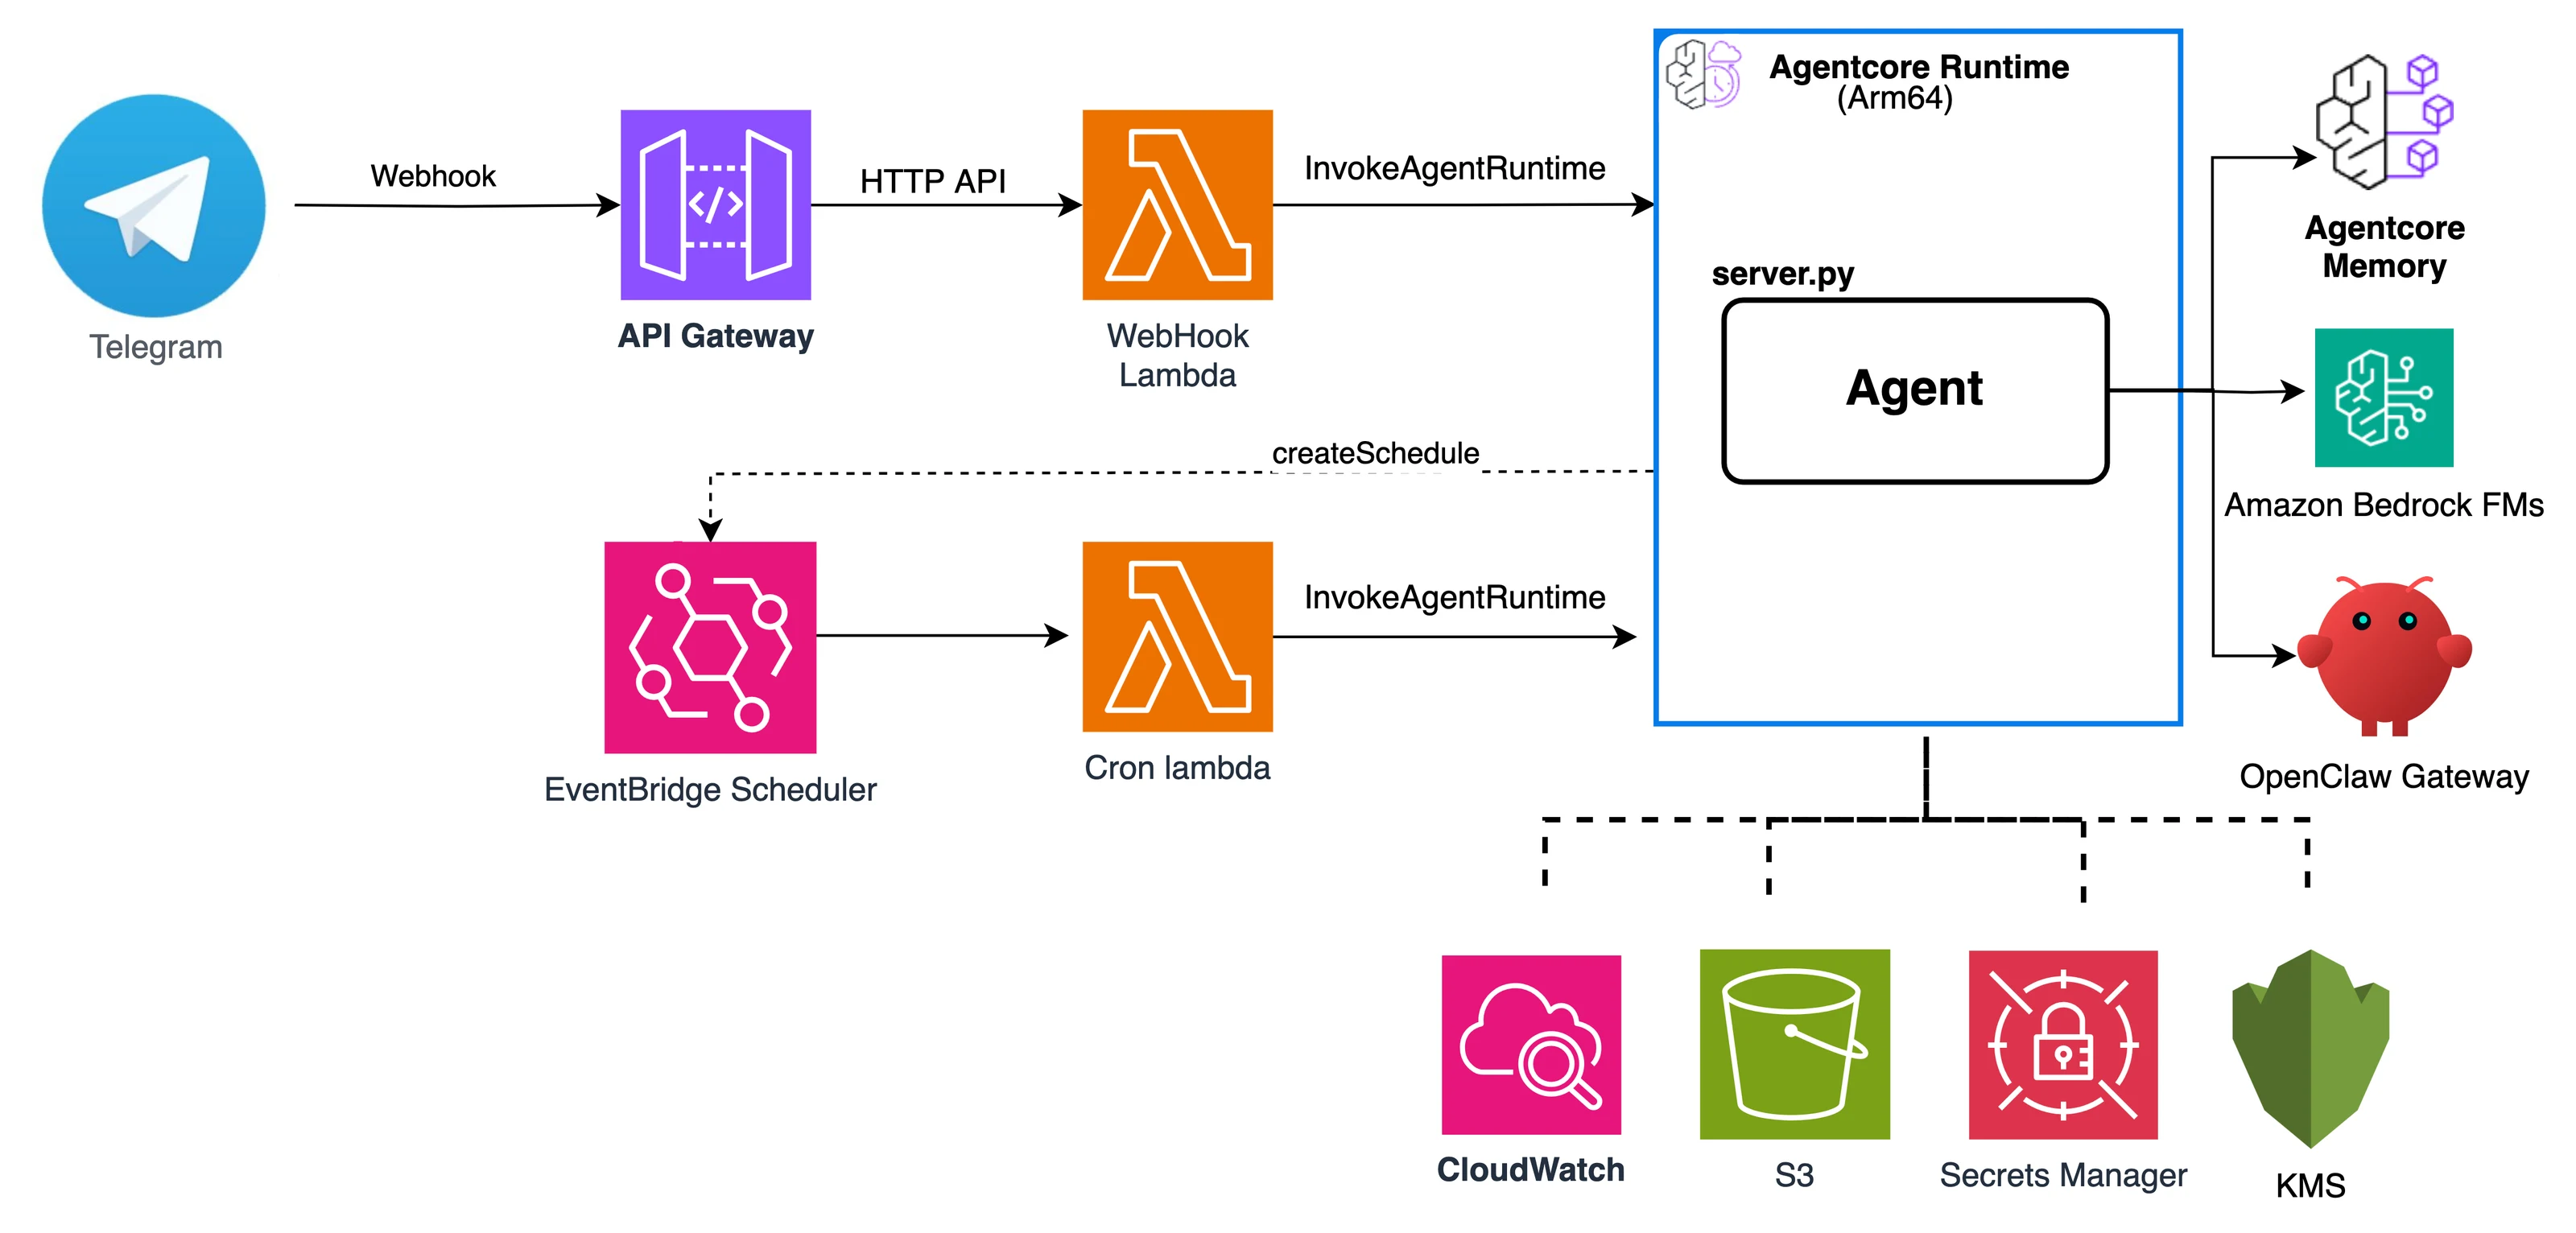
図1:TelegramウェブホックとAmazon EventBridgeスケジュールは、共に同じAgentCoreランタイムエージェントを呼び出し、これがOpenClawゲートウェイ、AgentCoreメモリ、およびAmazon Bedrockを調整する
2つのエントリポイントが1つのエージェントに集約される。TelegramメッセージはAmazon API GatewayとAWS Lambda関数のウェブホックを通じて届き、朝の水やりのリマインダーなどのスケジュールされたジョブはAmazon EventBridge Schedulerとcronjob Lambda関数を通じて届く。両方ともエージェントCoreの実行環境上のInvokeAgentRuntime APIを呼び出し、そこでは薄いserver.pyプロセスがOpenClawゲートウェイ、エージェントCoreのメモリ、およびAmazon Bedrock Converse APIを調整する。Amazon Simple Storage Service(Amazon S3)はワークスペースのストレージを提供し、AWS Key Management Service(AWS KMS)が暗号化を行い、AWS Secrets Managerがボットトークンを管理し、Amazon CloudWatchがログとメトリクスを収集する。
前提条件
Launch Stackボタンやscripts/deploy.sh(Grow your ownセクションで説明されている)を使って自分のバージョンを配布するには、以下が必要です:
- Amazon Bedrock AgentCoreへのアクセス、AgentCoreの実行環境およびAgentCoreのメモリを含む。
- ルーティングするモデルについて、以下のモデルのアクセスが許可されました:テキスト用のClaude Haiku 4.5およびビジョン用のClaude Sonnet 4.5(またはお客様のアカウントで利用可能な同等のモデル)。
- Dockerが
linux/arm64ビルド対応機能をサポートし、AWSコマンドラインインターフェース(AWS CLI)も設定されている。これは、自分自身のイメージをビルドしてプッシュする予定がある場合にのみ必要である。 - アシスタントのフロントドアとして機能する、BotFatherから得られたTelegramボットトークン。
- エージェントオーケストレーションの概念とCloudFormationに関する基本的な理解。
アーキテクチャ:AgentCore実行環境上のサーバーレスエージェント
各コンポーネントは一つのCloudFormationテンプレートに存在し、起動するために何のビルドツールも必要ありません。以下のセクションでは、負荷を支えるための決定事項について説明します。
エージェントコア実行時間:稼働中の計算のみを支払う
エージェントはAgentCore実行環境上のコンテナに存在し、消費ベースの料金体系を採用しています。エージェントが実際に使用する計算処理に対して請求されますが、ウォールクロックの稼働時間や、モデル応答などのI/O待ち時間については請求されません。短時間で使用されるパーソナルアシスタントの場合、月あたり約1~2ドルの基準と、常時稼働するAmazon Elastic Compute Cloud(Amazon EC2)インスタンスの月あたり約35ドルの差になります。これらの数字は2026年7月時点での軽度な個人使用に対する推定値です。現在の料金についてはAgentCoreの料金体系を参照してください。
実行時間は最小限のコンテナ契約を強制する:ポート8080でリスニングし、ヘルス状態のためにGET /pingを、エージェントのエントリポイントとしてPOST /invocationsを公開する。私たちのコンテナはlinux/arm64であり、公式のOpenClawイメージにPython層を加えてマルチステージで構築されている。
OpenClawをエージェント基盤として
OpenClawはエージェントループ、ツールの使用、スキルシステムを提供します。ウィジェッターを実行します(server.py) それを適応させるもの AgentCore HTTPプロトコル契約:
- コンテナが起動すると、
server.pyはopenclaw gateway runをプロセスとして実行し、健康状態をチェックします。 GET /pingはすぐに正常な状態を返すため、AgentCoreの準備状態チェックが通過します。POST /invocationsが実際の作業を行います:ペイロードを解析し、メモリを取得し、コンテキストを構築し、ゲートウェイに転送し、結果を保持します。一つ注意点:AgentCoreは、サブプロセスが終了した凍結されたコンテナを解凍することができます。そのため、呼び出しパスはゲートウェイが動いていることを前提とせず、ensure_openclaw_ready()ヘルパーを呼び出し、健康状態を再確認し(必要ならゲートウェイを再起動)、転送を行います。
このラッパーパターンは他の使用ケースにも一般化できます。ローカルプロセスとして実行される任意のエージェントフレームワークも、フレームワーク自体を変更することなく、同じ方法でAgentCore実行環境に適応させることができます。
タスク別にルーティングされる2つのモデル
チャットや画像理解には異なるコストと品質のトレードオフがあるため、アシスタントはそれぞれをBedrock上の異なるClaudeモデルにルーティングする:
- Claude Haiku 4.5のテキスト用版:日常的な使用で多くの会話が発生する場合、迅速で安価です。
- Claude Sonnet 4.5 for vision: 写真から植物を診断するという、あまり頻度は低いがより難しいタスクに対して、より強力な多モダル推論能力を提供します。
OpenClawゲートウェイを通じてテキストが流れ、スキルとセッション状態が提供される。画像はserver.pyからBedrockの大規模言語モデル(LLM)に直接呼び出され、画像バイトデータを多モーダルコンテンツブロックとして渡される。私たちは意図的に画像をゲートウェイ内を迂回する:容器内のOpenClawビルドは、image_urlコンテンツ部分がBedrockに到達する前に削除されるため、server.pyから直接Converse APIを呼び出すことで、モデルが実際のピクセルを見ることを確保する。両方の経路は同じシステムプロンプト(パーソナとメモリ)を共有するため、体験は一貫性を保つ。
モデルIDは環境変数(MODEL_ID、VISION_MODEL_ID)です。そのため、イメージを再構築することなく、デプロイごとにモデルを交換することができます。
スキルは再利用可能な能力単位である
能力はcommunity-skills.jsonマニフェスト内のスキルとして宣言される。デプロイ時のスクリプトがそれらをコンテナに実装し、イメージを作成する前にOpenClawの設定に登録する。Sproutはこの投稿を公開した時点で、天気、リマインダー、植物に関するメモのスキルを提供している。マニフェストを交換すると、同じパイプラインが異なるドメインに対応する。これにより、全体が再利用可能なパターンとなり、単一のボットではなくなる。
Telegramはサーバーレス前門のようなものです
Telegramはウェブホック方式を採用しているため、個人アシスタントにとって実用的なチャンネルです。すべてがサーバーレスで運用されます。クライアント開発は不要で、ユーザが既に所有しているすべてのデバイスで動作し、ボットAPIを通じてテキスト、画像、豊富なフォーマットをサポートします。BotFatherがボットトークンを発行し、そのトークンはSecrets Managerに保存されます。デプロイ後、ウェブホックがTelegramをAPIゲートウェイエンドポイントに接続します。ユーザがメッセージを送信すると、Telegramはそのペイロードを検証しInvokeAgentRuntimeを呼び出すために、ウェブホックのLambda関数に送ります。返信は再びTelegramボットAPIを通じて戻ってきます。
注意すべきフォーマットのポイント:Telegramの古いMarkdownモデルは、エスケープ文字を含まない文字には厳しいです。モデル応答に一つのアンダースコアが含まれてしまうと、メッセージが送信できなくなることがあります。返信をHTML形式で表示する方が確実なため、アシスタントはモデル出力をTelegramで安全なHTMLに変換してから送信します。
記憶:使い捨てのチャットを長続きする知識に変える
これまで説明したアーキテクチャは、有能で安価なサーバーレスエージェントですが、単独では会話の間にあなたを忘れます。記憶こそがそれを変えるものです。数週間前に有機的な庭園を育てていると言ったとします。今日、アシスタントが処方を提案し、合成肥料を使っていないから有機的な選択肢を選んだと独自に付け加えます。ステートレスモデルではそうはできません。
メンタルモデル:短期の出来事、長期的な抽出
AgentCoreメモリには2つの層があります。短期記憶は、すべての会話をCreateEventを通じてイベントとして保存し、actorId(TelegramチャットID)とsessionIdでキー付けされます。これが生の記録です。長期記憶は非同期に管理された抽出戦略によって、永続的で構造化された記録として生成されます。私たちは3つの戦略を設定しました:
USER_PREFERENCE: 庭師が述べた明確な選択(“有機肥料のみを使用する”)。SEMANTIC: 推測された事実(“Corten鋼製の培地でメキシコ種ピクルスを育てる”)SUMMARIZATION: エピソード別セッションの要約(“熱波中の下葉の黄化について議論した”)
名前空間:庭師一人につき一つの庭
スプラウファイルは各ユーザーの名前空間に記録されるため、二つのチャットが混ざることはない:
sprout/{chat_id}/long_term: プレファレンスとセマンティックな事実。sprout/{chat_id}/episodic/{session_id}: セッションの要約。
チャットIDが唯一の変数セグメントであるため、隔離を考えることやテストすることが容易になります。各ユニークな庭師は正確に1つの名前空間に対応し、2人の庭師が衝突することはありません。
取得、組み立て、インジェクションパイプライン
各ターンで、エージェントは関連する長期的記録を取得し、それらをランキング付けして、システムプロンプトに注入します。server.py内の各メッセージで起こることとは、以下の通りです:
- 取得する。 電話する
RetrieveMemoryRecords対してsprout/{chat_id}/long_termユーザーのメッセージを検索クエリとして使用し、50件の結果まで、3秒以内に表示する。取得時間が超過したりエラーが発生した場合は、失敗せずに柔軟に対応し、記憶を持たない形で回答する。
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
サンプル文1:現在のターンにおける長期記録の取得(代表例。完全なソースはリポジトリを参照してください)。
Assemble関数は追加のカスタムロジックを加えます。明示的な選択肢が推測された事実よりも優先され、各クラス内の順序は安定しており、インジェクション前に結果が上限に制限されることが望ましいです:
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
サンプル文2:アセンブリステップは、推測された事実よりも明示的な好みを優先する。
メタデータ:名前空間内の記憶のサブグループ化
名前空間は記録が属するメモリを答えますが、メタデータはそれが何についてかを答えます。sprout/{chat_id}/long_term内では、「私のパティナリアが枯れてしまう」という意味で近いものすべてが検索結果になります。庭師にとって、これは3月からの肥料の選択やイチジクの剪定に関する注意事項も、実際に重要な記録と共にランキングされることを意味します。そして、構造化されたメタデータにより、プロンプトに到達する前にメモの範囲を絞り込むことができます。
ここでは一つのルールがすべての決定を形作っています。メタデータキーは、インデックスされたキーとして宣言されている場合にのみサーバーサイドでフィルター可能です。詳細はAmazon Bedrock AgentCore Memoryにおけるメタデータを用いた構造化メモリフィルタリングをご覧ください。この場合、sproutは3つのインデックスされたキーを使用します。
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
Type: STRINGLIST各エントリはキーを指定し、フィルタリング可能になるためにはインデックスされたキーと一致する必要があり、extractionTypeをイベントから渡されるSTRICTLY_CONSISTENTまたは会話から抽出されるLLM_INFERREDのいずれかに設定します。推測されたキーの場合、抽出設定によって値を固定リストに制限することができます。Sproutは正確にそのように行うため、両方の書き込みパスで同じ語彙表が生成され、フィルターも記録を作成した部分に関わらず同じ意味を持ちます。
ターンを維持し、ループを閉じる
モデルが応答した後、server.pyはユーザーのターンとアシスタントのターンの両方を含めてCreateEventを呼び出します。その新しいイベントは抽出戦略に与えられ、それが次回のために長期保存用のデータベースを充実させます。
memory.create_event(
    memoryId=MEMORY_ID,
    actorId=chat_id,
    sessionId=session_id,
    payload=[
        {'role': 'user', 'content': user_message},
        {'role': 'assistant', 'content': reply},
    ],
)  # feeds USER_PREFERENCE / SEMANTIC / SUMMARIZATION extraction; errors are logged, never fatal
サンプル文3:ターンを保持することで、抽出戦略が非同期に長期的な記憶を充実させることができる。
抽出は非同期のため、このセッションで言及された事実は通常、後のセッションで取得可能になります。その遅延に対応する設計です:短期のセッションイベントは現在の会話を、長期の記録はそれ以前のすべてをカバーします。
まとめ:個人別の水やり計画
完全なパイプラインがエンドツーエンドで機能する場所です。数回の会話を通じて、一つ一つの植物を平易な言葉でカタログ化します。各言及が一つのイベントとなります。抽出戦略によって、植物、その位置、日当たりの状況に関する情報がsprout/{chat_id}/long_termに抽出されます。今朝、ユーザーが「私の庭の他の植物を覚えているか?」という質問をしました。検索によって記録が引き出され、ランキングが行われ、システムプロンプトに入力されます。アシスタントは、メッセージ自体には現れなかったユーザーの位置、日当たりの状況、ベッドの構造、土壌の性質、植物の在庫について答えます。
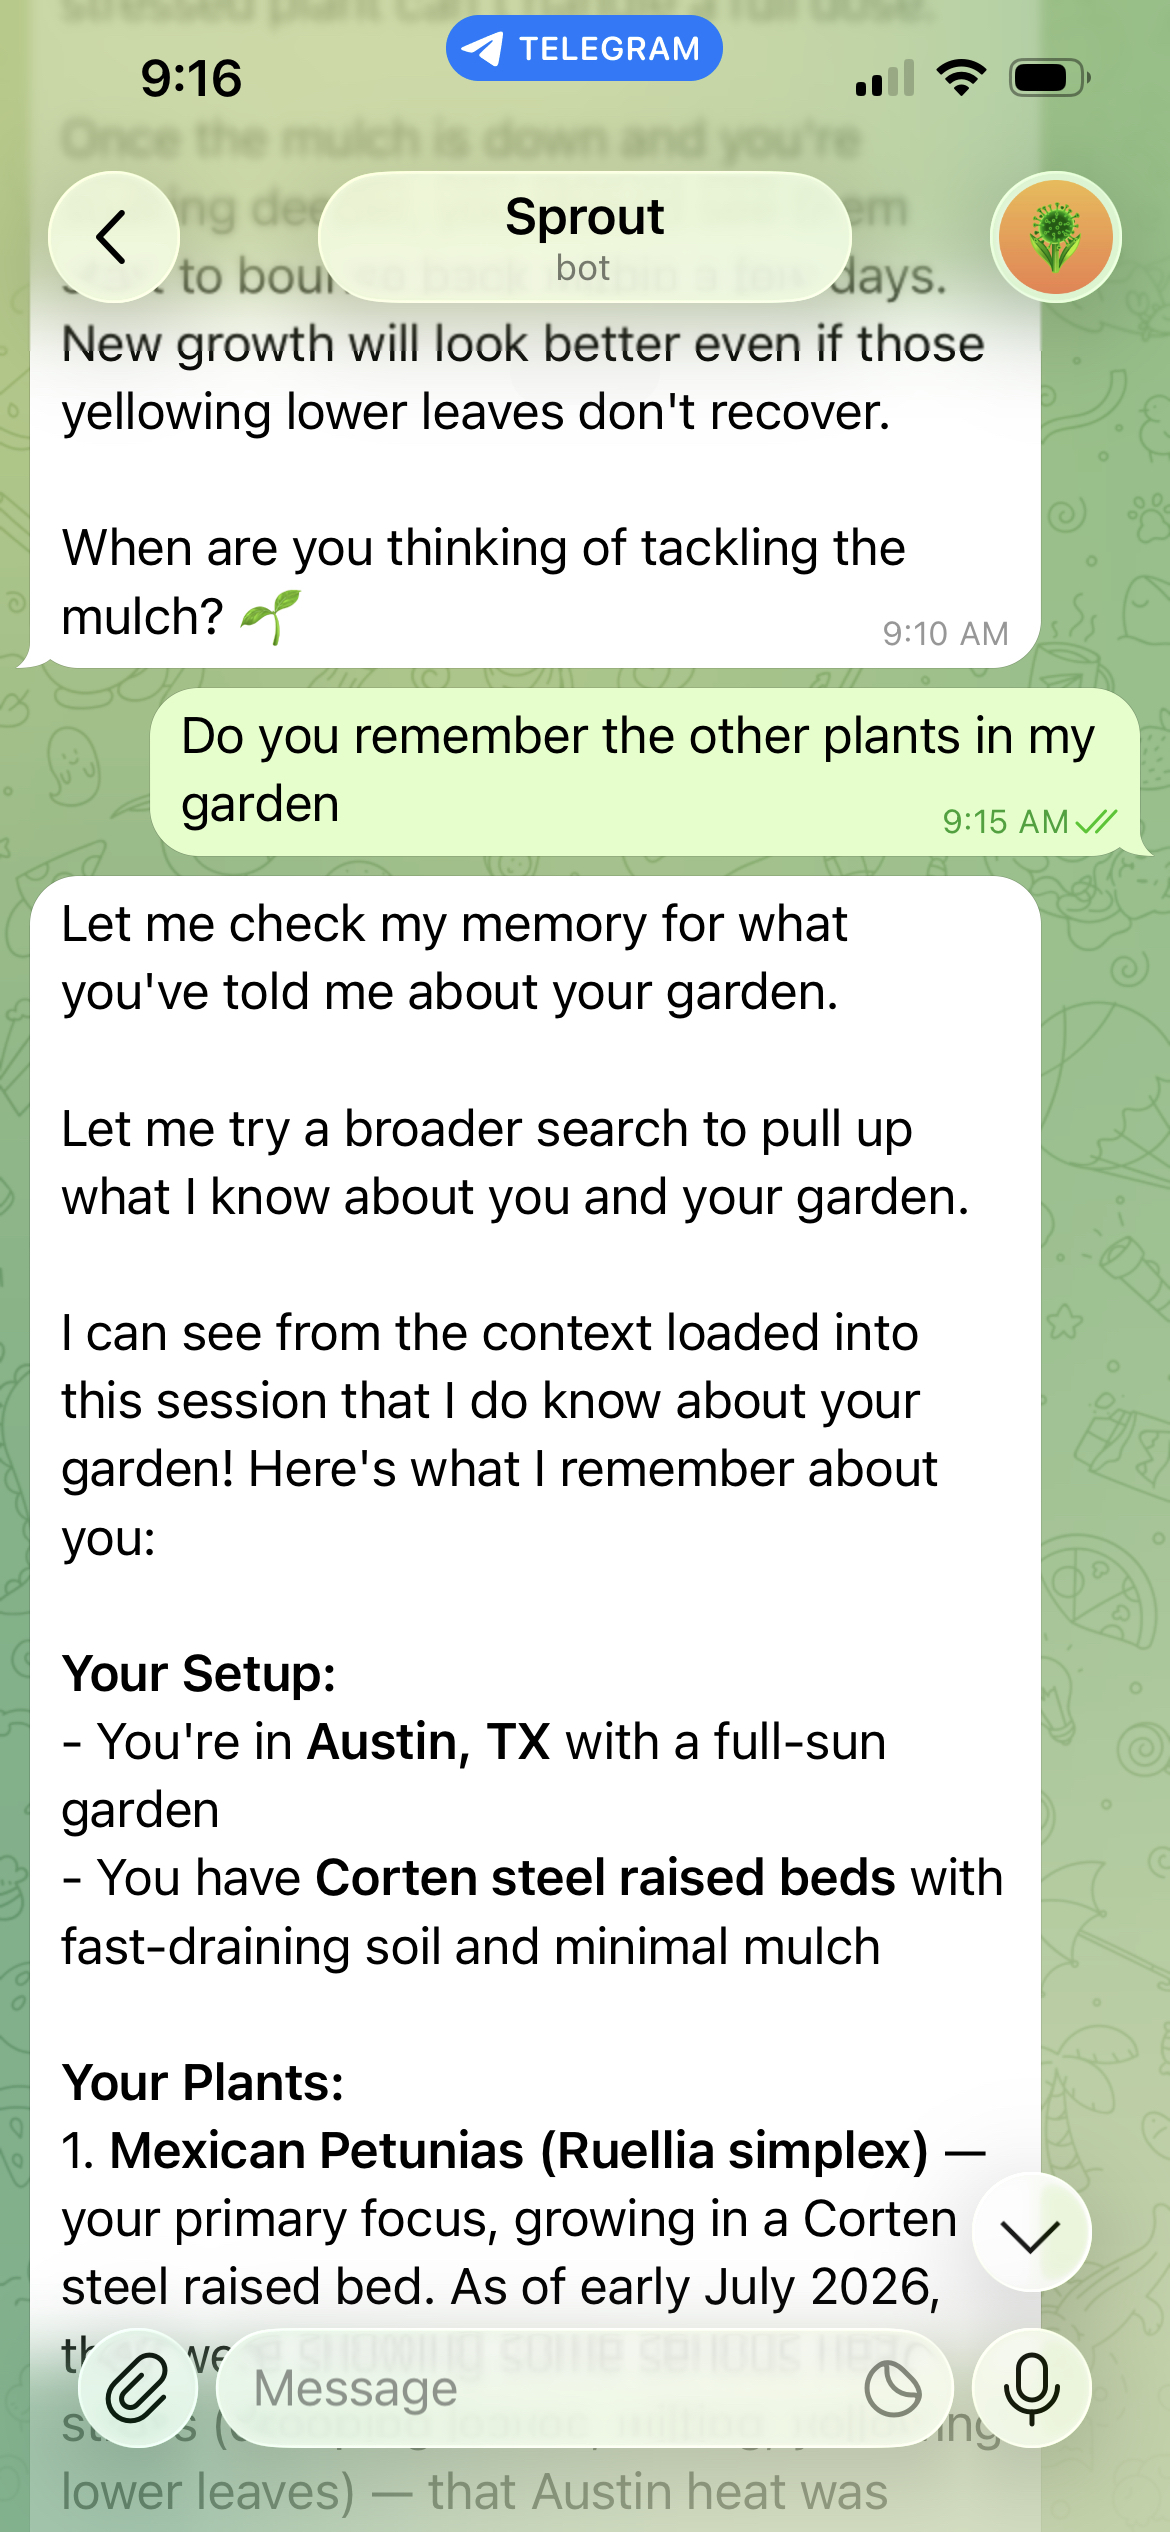
図2:スプラウトは、保存された植物の在庫と栽培条件を思い出すことで、庭園に関する質問に答えます
Amazon EventBridge → Cronのパス上でスケジューラーのスキルを使用することで、Sproutはその計画を能動的なリマインダーに変換することができ(“薬草はやめとく、土壌は昨日のうちにまだ湿っている”)し、雨が降ったり熱波が来たりするときには天気スキルを利用して調整する。
記憶と視覚は互いに結合する。ユーザーが枯れた植物の写真を送信すると、画像はClaude Sonnet 4.5に送られる。一方、システムのプロンプトには、記憶層が知っているすべての情報が残る。アシスタントは、ユーザーの保存された在庫にあるメキシコン・ペチワニを写真と照合し、匿名の植物写真を分析するのではなく、状況に応じた枯れのストレスを診断する。
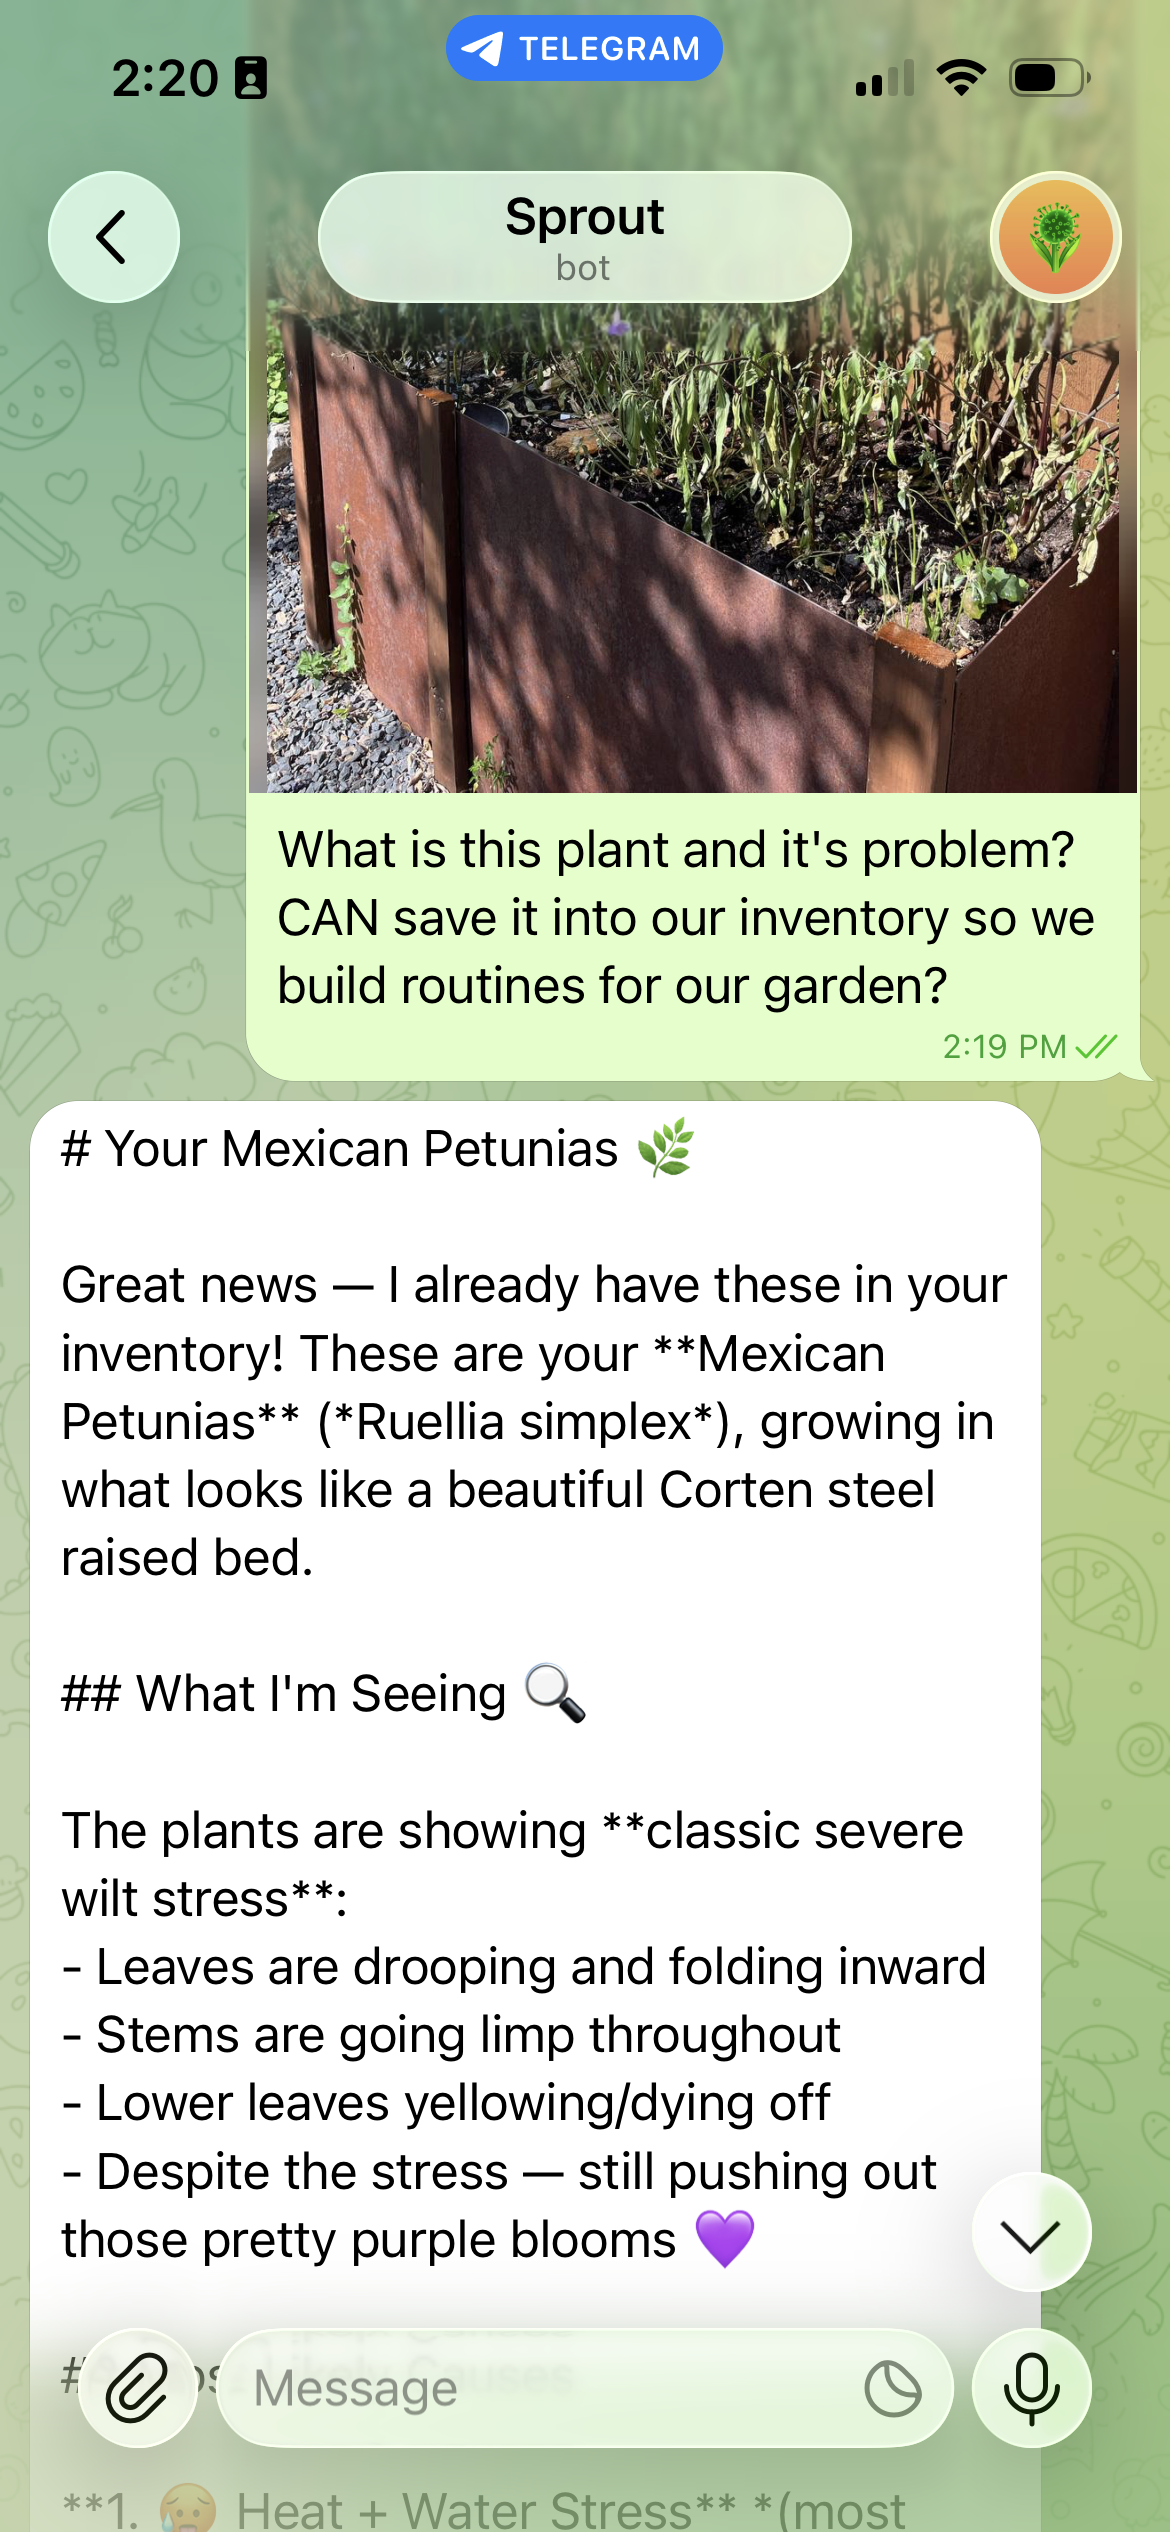
図3:視覚と記憶が協力している。写真は視覚モデルに属し、システムプロンプトはユーザが保持する庭園の文脈を担う
ビジョンモデルは完璧ではない。以前の、在庫情報の文脈がないやり取りで、同じ植物が朝顔と正確に特定された。朝顔は、同様のトラップ形の紫色の花を持つ種類である。ユーザー自身が保存した在庫情報をビジョンモデルに基づいて活用することで、妥当に聞こえる推測が正確な個人化された診断に変わった。これは、記憶が精度を高めるのであり、単にテンポを良くするわけではないことをよく示している。
プロンプトキャッシュによる推論コストの低減
各ターンにメモリを注入することでプロンプトのサイズが大きくなり、素朴な実装では各リクエストでそのトークンに費用がかかります。Amazon Bedrockのプロンプトキャッシングがこれを解決します。アシスタントはプロンプトを構造的に設計し、安定したプレフィックス、パーソナリティ、組み立てられたメモリブロックが最初に来て、不安定なユーザーメッセージが最後に来るようにします。Bedrockは処理されたプレフィックスをリクエスト間でキャッシュするため、会話内の繰り返しのターンでは変わらない部分の再計算が不要になります。 プロンプトキャッシングにより、サポートされているモデルではコストを最大90%削減し、レイテンシを最大85%削減することができます。
順序付けのルールは、どの設定よりも重要です。安定したコンテンツを最初に、不安定なコンテンツを最後に配置し、メモリブロックの内部順序が決定的であるようにしてください(これは前のアセンブリ関数によって促進されます)。そうすることで、プレフィックスがリクエスト間で正確に一致します。
AgentCoreとOpenClawを基にしたデザインガイドライン
スプラウトは1つのアシスタントですが、その背後にある決定は一般的なものです。このスタックを使って自分自身のアシスタントを構築する場合、以下のガイドラインがどの分野にも当てはまるものです。
- Wrapしろ、forkしない。 フレームワークを変更するのではなく、薄いHTTPラッパーを用いてAgentCoreコンテナ契約に自らのエージェントフレームワークを適応させる。この契約は小さく、ポート8080で
/pingと/invocationsがあり、ラッパーによりフレームワークのアップグレードプロセスを維持できる。 - 何も保存する前に、デザイン名前空間を設定してください。メモリ名前空間はあなたの隔離境界です。ユーザーIDを唯一の変数セグメントとし、チャットIDのような信頼できるチャネル固有のIDから選択してください。マルチテナントデザインでは、最終的に監査や削除要求が発生します。明確な名前空間スキームにより、これらはすべて簡単になります。
- 記憶を向上の手段と見なし、依存関係とは扱わない。すべての記憶操作は、うまくいかない場合でも優雅に失敗することを許すべきである。検索の失敗は、応答をブロックすることなく、記憶に関係ない回答を生成するべきである。ユーザーは、失敗による失敗よりも、忘れっぽい行動をはるかに簡単に許す。
- タスクによってルートモデルを分ける。 大量のテキストには高速でコスト効率の高いモデルを使用し、必要な場合にはより強力なマルチモーダルモデルを使用する。モデルIDは環境変数に保持することで、ルーティングの変更がコードではなく設定によるものになる。
- キャッシュの順序指定プロンプト。 安定したパーソナリティと記憶を最優先にし、不安定なユーザー入力は最後に、全体的に決定的な順序が保たれる。この構造的な習慣こそが、推論の効率化の大部分を生み出す。
- 抽出遅延の計画。長期的な記憶は非同期に抽出されるため、新しい事実を同じセッションで思い出せると約束するべきではない。短期のセッションイベントが現在の会話を、長期的な記録が以前のものを担当するようにしなさい。
- 初日から予算を設定しましょう。消費ベースのエージェントは、再試行ループや会話型ユーザーの介入がない限り安価です。AWS Budgetsのアラートは、月間制限の80%と100%で設定され、費用はかからず、予期せぬ問題を早期に発見します。
- スキルは小さく、一つの目的だけに使うようにする。スキルは、天気をチェックしたり、リマインダーを設定したりといった、ユーザーが一文で言える一つの機能だけを行うべきです。小さなスキルは独立してテスト可能であり、独立して交換可能であり、モデルが正しく選択するのも容易です。何でもできるスキルでは、モデルがどの行動を意味しているのか推測しなければなりません。
自分で育てる
同じ庭で植える2つの方法:
- シングルステップ起動スタック:CloudFormationテンプレートは公共のAmazon Elastic Container Registry(Amazon ECR)イメージを指しているため、Telegramボットトークンのみが配布されます。
- 自分で構築する:scripts/
deploy.shスクリプトはテンプレートを検証し、自分自身のARM64イメージをプライベートなAmazon ECRリポジトリにビルドしてプッシュします。スタックをデプロイし、Telegramウェブホックを登録することで、完全にカスタマイズ可能なビルドが実現されます。
2026年7月現在、個人での利用には月間約5〜9ドルがかかります(約2ドルがインフラ費、1〜3ドルがハイキュートテキスト、2ドルがソネットの作成費)。内蔵されたAWS予算機能により、設定した上限の80%や100%に達した際にアラートが表示されます。
完全なソースコードは、sample-agentcore-memory-openclaw GitHubリポジトリにあります。
クリーンアップ
実験が終了したら、継続的な料金を避けるために全てを削除してください。システム全体が一つのCloudFormationスタックであるため、クリーンアップはほとんど単一の削除だけです。
- CloudFormationスタックを削除します。これにより、AgentCore実行時エージェント、API Gateway、Lambda関数、Amazon EventBridgeスケジュール、および関連するAWS Identity and Access Management(IAM)ロールが削除されます。
- AgentCoreメモリストア(およびその名前空間)を削除し、ユーザーレコードが保持されないようにする。
- プライベートなECRリポジトリにプッシュした画像をすべて削除し、もはや必要でない場合はそのリポジトリ自体も削除してください。
- スタックの外でAWSバジェットアラートを作成した場合は、それを削除してください。
- Telegramのウェブホックを解除する(またはBotFatherを通じてボットを削除する)、そしてもう必要ない場合はBedrockモデルのアクセス権を取り消す。
結論
このソリューションの再利用可能な核心は、スキルシステムと管理されたメモリを備えたAmazon Bedrock AgentCore上のサーバーレスエージェントです。AgentCoreのメモリにより、カスタムベクトルストレージや抽出パイプラインを構築する必要がなくなり、エージェントが記憶し忘れる内容については完全な制御が可能になります。消費型コンピューティングとプロンプトキャッシングにより、月数ドルで本当に個人化されたアシスタントを実現でき、OpenClawスキルマニフェストにより、このパターンは様々な分野に移植可能です。 パーソナライズも複合的に作用します。ユーザーがより多く操作するほど、アシスタントはより有用になります。
さらに進むには、「水やりのリマインダー」のような単一ドメインから始め、記憶範囲を段階的に拡大する。エージェントが過去の特定の会話を参照できるように、エピソード記憶を探求する。または、リポジトリをフォークし、自分のパーソナリティとスキルを組み合わせて、必要なアシスタントを育てることもできる。
詳細については、AgentCoreドキュメントを参照してください。以下の関連記事では、構成要素についてより詳しく説明されています。
- Amazon Bedrock AgentCoreメモリ:コンテキスト認識型エージェントの構築
- より賢いAIエージェントの構築:AgentCore長期記憶の深掘り
- Amazon Bedrockでプロンプトキャッシングを効果的に利用する
- Amazon Bedrock AgentCore ランタイム上で、エージェントとツールを安全に起動し、スケールさせる