
先週、Qwen-Image 2.1に同梱されているプロンプトリワーカーの小さなバージョンが欲しかった。公式版は9Bモデルで、約20GBのメモリが必要であり、一つの段落を書く前に数千のトークンを考える。Hubでは、その同じ9Bモデルの圧縮コピーしか見つからなかった。そこで、私が欲しいものをMLインターンとして記述し、翌日にはCPUで動作する0.8Bバージョンが手に入った。このモデルは99.7%の確率で有効な出力を返し、教師データのトークンの約4分の1しか使わない。9Bモデルのラベル付け、8,797件の例文リクエストを含む全プロジェクトの計算には16米ドルがかかった。
次の数日間で、同じ方法でさらに5つのモデルを作成した。各モデルは、ML-internが有効になったHuggingChatのメッセージとして始まり、Hub上の公開モデルとして終わる。モデルカードには評価結果も記載されている。ML-internは作業を計画し、何も費用をかける前に予算を求め、本格的な作業に入る前に小規模なテストを行い、その後トレーニングを行い、評価し、Hugging Faceのハードウェア上で公開する。
MLインターにどのようにプロンプトを出すか
最初のメッセージが私の努力を費やす場所です。下に共有されているcitrusモデル用の最初のプロンプトは約450語でした。6回目のプロジェクトでは2,000語近くになりました。なぜなら、各プロジェクトで次のプロジェクトで必要とされることを学ぶことができたからです。全7つのプロンプトは、私が書いた通り、yvrjsharma/ml-intern-promptsに掲載されています。
プロンプトは一行でアイデアとその理由から始まります。次に、正確な要素が列挙されます:データセット、ベースモデル、トレーニングスクリプトです。既に確認したものは、「Verified facts, do not re-derive」というタイトルの項目にまとめられ、エージェントは私が知っていることを再発見するのではなく、予算をその作業に費やします。カメラアングルLoRAに関しては、どのトレーナーが透明画像機能をサポートしているか、またどのOpen GitHubの問題がフォールバックトレーナーを危険にするかが列挙されています。
プロンプトの2行が重要です。最初の行は、トレーニング前のベースラインを求めています。例えば、citrusプロンプトでは次のように述べられています:「トレーニング前に、同じ指標でベースモデルのゼロショットスコアも報告してください。そうすれば、改善が見られます。」これがないと、トレーニングされたモデルが得られるだけで、元のモデルより良いかどうかは分かりません。2番目の行は、チェック機能付きのスモークテストです。画像LoRAsの場合、50ステップのトレーニングを行った後、保存されたウェイトが実際に変化したかどうかを確認する必要があります。その後で完全な実行に支払います。
プロンプトの終わりに、期待される成果物とコストの制限を明記します。モデルカードに含めるべき内容を定義し、「総支出を12米ドルに抑え、それを超える前に私に尋ねてください」といった指示も記載します。MLインターナリストは各タスクを0ドルの予算で開始し、有料作業を行う前に許可を得る必要があるため、この支出制限は厳格に実施されます。予算を設定しない場合、エージェントはプロジェクトの規模に応じていくつかの選択肢を提案し、どちらを希望するかを尋ねます。
最初の試みでそれらすべてが必要というわけではありません。例えば、私には 確認済み事実 私のセクション 柑橘類 短い内容のMLインターンも、それよりも多くのモデルを生成した 精度を3倍にした の Qwen3.5-2B モデルです。わずか数日でMl-Internを使って作った6つのものをご紹介します。
1. あなたの分野を理解するモデル
一般的なビジョンモデルは、黄変した柑橘類の葉を記述することができます。しかし、それがアブラムシの問題なのかマグネシウム不足なのか、また植物を治療するためのバイオ学的および非バイオ学的手段が何であるかを判断することは非常に難しいです。Claudeを使用して、Project-AgML組織がホッブ上で管理する3つのソースから融合されたトレーニングデータセットを作成しました。その結果得られたcitrus-disease-vlm-instructは、21種類の異なる害虫、病気、栄養的欠陥、治療法を含む3,017枚のアノテーションされた画像からなるデータセットです。ML-internは、これらの例を用いてQwen3.5-2Bの微調整を行い、事前に基礎モデルを評価することにしました。
335枚のテスト写真において、ベースモデルは14.9%の場合に正解を発見した。A10G上で2つのエポックを経過した後、ファインチューニングされたモデルは52.8%の正解率を達成した。計算コストは約1.90米ドルであった。
チェックアウト:モデル · データセット · Citrus Doctorアプリ
2. キャラクターを描画するモデル
画像モデルは多くの文字を知っています。Hugging Faceブランドのアセットの平易なスタイルで描かれたHuggyは、その中の一つではありませんでした。私はML-Internに、FLUX.2 klein base 4Bを用いたLoRAを依頼しました。このLoRAは、Chunte/huggy_for_trainingデータセットから得られた84枚のキャプション付き絵を使ってトレーニングされました。
エージェントは100ステップごとにチェックポイントを保存し、それぞれの際に同じプロンプトセットを使用したため、選択が容易になった。200ステップ目で初めてHuggyが完全にオンモデルとなった。500ステップ以降は、HuggyのスタイルがHuggyとは関係のないプロンプトにも現れ始めた!訓練されたLoRAも4ステップで抽出されたkleinモデル上で機能する。計算コストは約7.60米ドルである。
チェックアウト: モデル · データセット · ハグギジェネレーターアプリ
3. 新しいトリックを実行するモデル
- カメラアングルLoRAsは、初期のQwen-Imageモデルに対する最も人気のあるコミュニティアドオンです。モデルに物体の画像を与え、左から45度の角度でそれを見るように求めることができます。Qwen-Image 2.1モデルの発表から数日後に確認したところ、まだ誰もこれを作成していないため、MLエンジニアに作成を依頼しました。
MLインターナルは、Google Scanned Objectsから1,030個のスキャンされた家庭用品を、各24の角度で、24,722枚の透明画像として生成しました。これは数セント程度のコストでCPUで実行されました。その後、461個のオブジェクトをトレーニング用に、40個をテスト用に、そして1,844組の「前後」比較ペアを23種類のカメラ設定に均等に分布させて使用しました。
A100を1台で90分間で2,000ステップのトレーニングが行われた(約3.75米ドル)。全プロジェクトには約半日と48件の作業が必要で、パッケージの欠落やパスが間違っているために失敗し、ML-Internによって再送信が必要となったものも含まれる。総計算コストは約16米ドルであった。
チェックアウト:モデル · データセット · Viewpoint Orbit App
- Doodle-in LoRAはまた素晴らしいアイデアです。マゼンタ色の落書きが描かれた写真をアップロードし、物体を名前付けた短いプロンプトを追加します。LoRAはその落書きをその物体に置き換え、元の光線や構図は変わらないようにします。
このデータセットは存在しなかったため、私のプロンプトではデータを作成する方法が説明されていました。Open Imagesにある実際の写真から始め、LaMa inpaintingモデルで1つのオブジェクトを除去し、そのオブジェクトがあった場所に塗りつぶしを描きます。残った写真が目標です。MLエンジニアはCPUサンドボックスでペア構築スクリプトを作成しテストした後、GPUジョブとして実行し、その過程で各ソース写真の著者とライセンスを記録しました。 6,042組の訓練ペアと160組のテストセットを作成し、そのうち40組は、訓練から完全に除外された23のオブジェクトクラスから得られたものである。
トレーニング前に、単独でおよびViggle turbo LoRAを使用してベースモデルを評価し、バッチ処理による編集の実行が同一の画像を生成することを確認した。これにより評価コストが低下した。トレーニングは1台のA100で1時間38分に2,000ステップを行い、約4USDであった。48組のテストペアに対する保存されたチェックポイントの比較により、500ステップが最適であることが判明した。
Viggle turbo LoRAと組み合わせて6ステップで使用した場合、LoRAは非常に良い性能を発揮しました。4.7秒の編集時間で、描かれた場所にある物体の67.5%が検出されました。見えない23種類の物体も、他の物体と同じように安定して検出されました(65.0%対64.2%)。このプロジェクトには1日以上59のジョブが必要でした。総計算コストは約24米ドルでした。
チェックアウト:モデル · データセット · Doodle-inアプリ
4. デバイスに合わせるモデル
- この投稿の冒頭にあるPocket Rewriterが最初のものです。MLインジェンタルは、推論プロバイダーを通じて小さな指示モデルを用いて8,797件の短い画像リクエストを生成しました。私のプロンプトで設定された組み合わせに従って、写真、ポスター、ロゴ、インフォグラフィックなどが含まれており、その約3分の1は引用符付きの正確なテキストを要求し、多くは英語以外の言語で表記されていました。その後、9Bの教師が1台のA100で2時間37分かけてすべてを書き換えました(約6.50米ドル)。品質をフィルタリングした後、1,840件の例がトレーニングデータセットとして選ばれました。
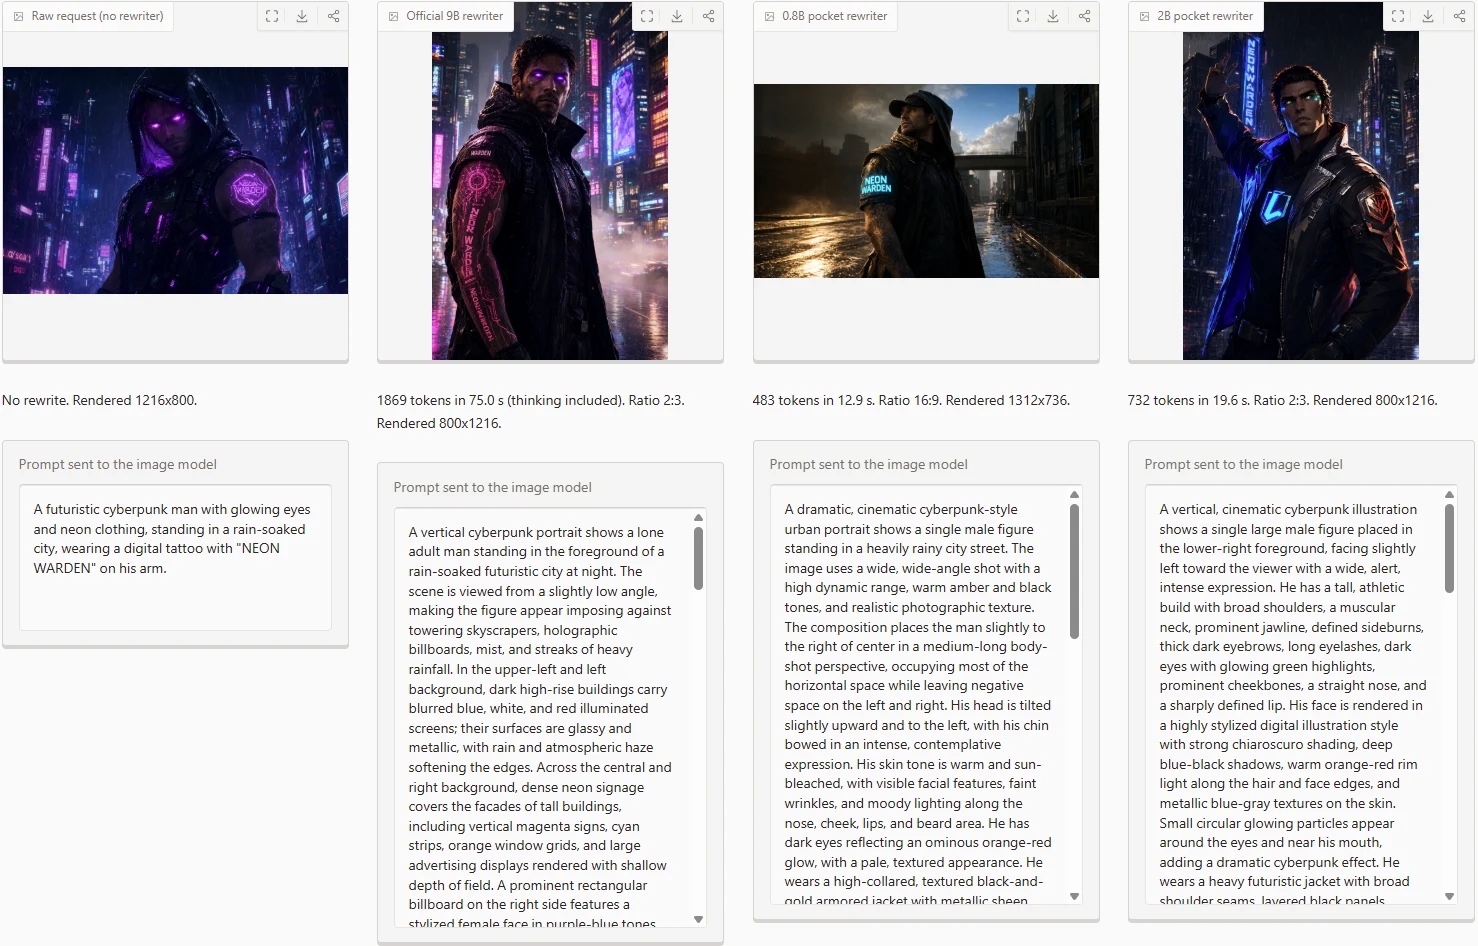
0.8B人と2B人の学生を訓練するのに、A10G上でそれぞれ12分と18分かかった(どちらも0.75USD)。0.8B人はCPUで実行できる812MBのGGUFファイルとしても提供される。プロジェクトには約11時間24ジョブがかかった。総計算コストは約16USD。
チェックアウト:Pocket rewriter 0.8B Student · 2B Student · Dataset · Pocket Studio App · Rewriter Arenaでの教師と学生を比較する
- Agate-Preview-002-4stepは第二です。LogolabsのAgate Preview 002は260Mパラメータのテキストから画像生成モデルで、ブラウザで使用するのに十分小さいですが、ガイダンスを付けた50ステップが必要で、これは1枚の画像につき100回のネットワーク通信になります。私はMLエンジニアに、わずか4回の通信で済むようにするよう依頼しました!
2回の実行が必要でした。最初の実行では155,000枚の学習画像をラテンタルにキャッシュし、ガイダンスをモデルに組み込みました。その後、ステップ数を16から8へ、さらに4へと段階的に削減し、すべてA100で行われました。4ステップの学生は、GenEvalとFIDで同じ4ステップで教師の実行を上回りました。その後、MLインターナルがブラウザ用にONNX形式にエクスポートしました。この実行には約13時間と22米ドルがかかりました。
MLインターンに依頼して、4ステップの学生をもう少し改善する第二回トレーニングを行った。その後、教師と共に16ステップで24,000組の画像ペアを生成し、約1時間かけてそのデータに対して4ステップの学生を微調整した。GenEvalは50ステップで教師の0.563に対して0.509から0.536に上昇したが、計算コストはわずか4ステップ(1/4の計算時間)だった。MLインターンはブラウザ版を再出力した。第二回の実行には約8時間かかった。両回の総計算コストは約37米ドルであった。
チェックアウト: アゲート4ステップモデル · データセット · ブラウザでラン・アゲートを開く · アゲート4ステップLIVE
何がかかったのか
| モデル | ベースモデル | 計算する |
|---|---|---|
| 柑橘類医師 | Qwen3.5-2B | USD 1.90 |
| ヒュギー・ローラ | FLUX.2 klein base 4B | USD 7.60 |
| ポケットリワイヤー(0.8Bおよび2B) | Qwen3.5-0.8Bおよび2B | USD 16.05 |
| 視点軌道LoRA | Qwen-Image 2.1 | 16ドル |
| ドゥオールイン・LoRA | Qwen-Image 2.1 | USD 24.30 |
| アゲート4ステップ(2回) | アゲートプレビュー 002 | USD 37 |
| 合計 | 約103米ドル |
これらは、各セッションに対して報告されたGPUおよびCPUの作業費用です。
自分のものにする
ML-internはHuggingChatにあります。ML-internモードを起動し、プロンプトを貼り付けます。スタートポイントが欲しい場合は、私の例プロンプトを無料でコピーできます。存在するであろうモデルや持っているデータセット、または説明できるものから始めましょう。少ない予算をかけ、ベースラインとスモークテストを求め、上限を上げる前に得られる結果を確認します。
それで作成したものがあれば、X上で共有し、@Gradioと@HuggingFaceをタグ付けしてください。他の人があなたのために作ることを考えないようなモデルを作ったものを見ることができれば幸いです。