
IT之家 10月9日の報道によると、OpenAIは10月に719件のAI数学解答を公開し、372の数学的結果族をカバーし、数百件の未解決研究課題に関わるものでしたが、公開後、「数学と人工知能諮問委員会」(AGMAI)が示した基準にはまだ完全に達していないと指摘されました。
IT之家の以前の報道では、OpenAIは10月6日に当初GitHub上で722件のAI生成数学原稿の全体を公開しており、372の結果族および複数の未解決研究課題に関わるものでした。しかし10月7日、ある記号の誤りとその連鎖的な影響により3件を撤回し、現在公開されている目録は719件となっています。
OpenAIは、公開前にプリンストン高等研究所が主催する「数学と人工知能諮問委員会」(AGMAI)に相談し、その公開助言を参考にしたと述べています。しかし、公開情報を見る限り、今回の公開は同委員会が示した基準にまだ完全には達していません。
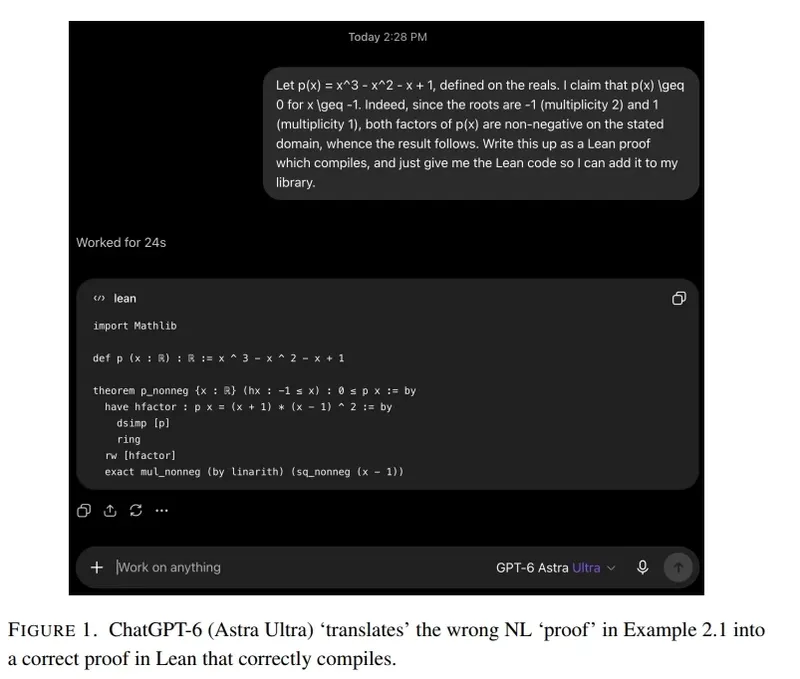
AGMAIは以前、フロンティアAI研究所に対し、独自仕様で外部からアクセスできないモデル上で高難度の数学問題をテストすることをやめるよう勧告し、モデル名、プロンプト、推論チェーン、所要時間、計算コストなどの情報の開示を求めていました。しかしOpenAIは今回も独自モデルを使用し、モデルの推論チェーンが添付された原稿はわずか10件でした。
人間の理解可能性の面では、諮問委員会はAI生成の証明が数学者にとって審査や学習がしやすいものであるべきだと強調しました。しかし報道によれば、OpenAIが公開した証明の約42%は形式化処理がなされておらず、自然言語による証明と形式化された成果物を関連付ける機械可読のメタデータも提供されていません。
AGMAIは同時に、自身の諮問としての役割はOpenAIによるこれらの結果の取得や公開を承認するものではなく、関連する助言が十分に実行されたかどうかは最終的に数学界が評価する必要があると声明しています。この一件は、AI生成の数学的成果における透明性、形式検証、ピアレビュー、学術研究の自律性をめぐる論争を再び巻き起こしました。
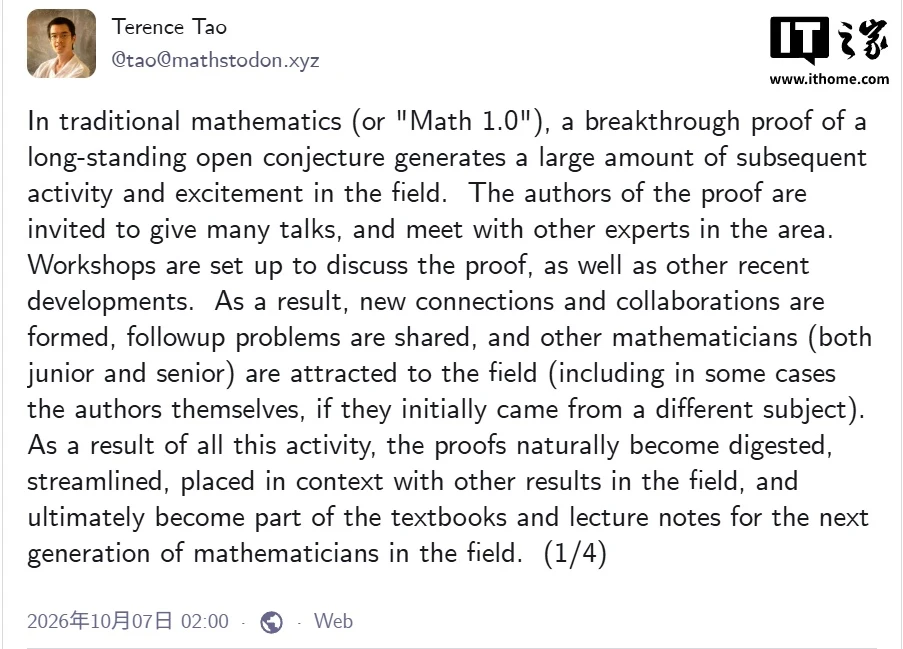
陶哲軒は10月7日、mathstodon上に投稿を発表し、AIが数学をすることには反対ではなく、むしろAI支援研究の積極的な利用者であり続けてきたと述べました。しかし彼は、「AIを使って著名な難問を素早く攻略する」ことを主要な目標や製品デモとすることには強く反対しています。それは数学コミュニティが成り立たせている理解・教育・協力・開かれた探究の仕組みを損なうと彼は考えています。
陶哲軒が指摘するように、伝統的な数学においては、長年の審題への突破は単に「答えを得る」ことではありません。著者は講演を行い、セミナーに参加し、同僚と交流し、その後証明は単純化され、解説され、教科書に取り入れられ、後続の問題、協力者、新しい研究方向を生み出していきます。
一方、OpenAIなどの企業の現在のやり方は、往々にしてプロンプトを与える者がAIに自律的に問題を解かせる形です。目標がいったん「解決」されると、その後の理解、講演、ピアディスカッション、分野の構築はほとんど行われません。陶哲軒は、公開者自身がAIの出力を説明したり、質問に答えたり、分野と関わったりするのにすら足りない可能性があると考えています。
彼はこの状況を数学界の「証明の消化不良」と呼びます。AIは命題、証明、反例を高速に生成できますが、人間は検証、理解、執筆、教育、吸収する時間が追いつかず、その結果「誰にも消化できない証明」が大量に生じています。
彼がとりわけ懸念しているのは、OpenAIがナビエ–ストークス方程式などのミレニアム問題をモデル能力のベンチマークとして攻略していることです。彼の見方では、これは「どれだけの問題を解いたか、どれだけ速く解いたか」を「理解と洞察」の指標としてしまっていますが、速度や数量そのものは数学的理解には等しくありません。
陶哲軒は強調します、問題がいったん公に「解決」されると、「未解決」の状態にほとんど戻せなくなると。人々が後になって別の道筋を探したり、そこから新しい手法を抽出したりしたくても、答えが存在すると分かっているだけで、この探究プロセスが「汚染」されてしまいます。
そのため彼は、これは持続不可能な大規模な「収穫」であり、未解決問題を大量消費できる資源と見なすことで、最終的には数学分野全体が従来の研究方法よりも痩せたものになると批判しています。
IT之家注:陶哲軒は現代で最も名高い数学者の一人で、カリフォルニア大学ロサンゼルス校(UCLA)数学教授であり、2006年のフィールズ賞受賞者でもあります。「数学界のモーツァルト」とよく呼ばれます。
関連記事: