
允中 凹非寺から
量子位 | 公式アカウントQbitAI
板を押し開けると、通路が閉じる。坂道を設置すると、高い壁を越えることができる。
一つ一つの行動が世界を変え、そして変わった世界が、次のインテリジェントの決定の出発点となる。
このような世界がコードによって構築され、拡散モデルによってリアルタイムで描かれるなら、AIには何度も探求できる「試練場」がある。自ら行動し、結果を観察し、仮説を検証し、その経験を次のラウンドに引き継ぐのである。
MirroSチームが最新に発表したAgentGartenです。これは実行可能なコード環境とリアルタイムの神経レンダラーを接続しています。コードが物理法則を定義し、モデルが視覚フィードバックを生成することで、30fpsを超えるスループットでスマートアイドルが継続的に世界と相互作用できます。
古典的なボードゲームの実験で、急速な変化が起こった。隠れる人は4ラウンド目にブロックを動かして隠れ場所を作る方法を習得し、探す人は10ラウンド目に坂道を利用して壁を越える方法を身につけた。一度の跳躍に失敗した後、探す人は自ら坂道を押して位置を調整し、再び試みる。
これらの戦略の進化を促すのは、アイドルの自ら書いた「実験マニュアル」である。
各ラウンドが終了すると、それらは試行を振り返り、発見を記録し、疑問を明記する。次のラウンドでは、これらの経験を持ってさらに探求を続ける。
コードが世界を動かし、リアルタイムレンダ링が世界を見えるようにし、継続的な演習が経験を積み重ねる。
AgentGartenは3つを閉環にし、より大きな問題を探求する:
この知能体は行動したり、試行錯誤をしたり、経験を積んだりできる世界を持っています。そんな中で知能はどのように進化し続けるのでしょうか?
全文ブログ:https://mirros.ai/blog/worlds-for-evolving-agents
技術レポート:https://mirros.ai/report/agent-garten.pdf
コード:https://github.com/MirroS-Lab/AgentGarten
プロジェクトホームページ:https://mirros-lab.github.io/agent-garten
インテリジェントアビトの、繰り返し練習できる世界
AIが実際の物理世界を本当に理解するためには、大量の動画を見せるだけでは不十分です。水泳を習うときにも映像だけでは不十分なのと同じで、スマートアイテムは自ら実践し、実際の結果を観察してから次のステップを決定しなければなりません。
物理的な因果関係の確実性を持つ環境が必要であり、押し開けられた箱はその場に留まらなければならず、塞がれた通路は通行できないものでなければならない。その後のすべての動きは、これらの物理的変化によって継続的に制約される。
現在の2つの主流技術パスにはそれぞれ限界がある:
伝統的なコード/ゲームエンジン環境、状態が正確でルールが明確であり、物理的な衝突もすべて明らかです。
しかし、問題点は画面にあります。プログラム式で構築されるシーンでは、粗雑な幾何学的な白模と繰り返されるテクスチャしかないことが多いです。数百、数千個のオープンシーンがリアルな光と影の質感を持つようにするには、美術モデリングとエンジニアリングに必要な投資は天文学的なものになります。
ビデオ生成を核とする世界モデル(各種ビデオ大規模モデルなど)は、驚くべき高精細画像を生成するだけでなく、動作に応じて後続のフレームも生成することができる。
しかし問題は、物理的な情報が神経ネットワークの記憶に完全に暗黙のまま隠されているため、照会可能で介入可能な明確な状態を提供することができない点です。コップの中にどれだけ水が残っているかを見たい、機械アームにネジをしっかり締めたい、あるいは厳格なタスクの規則を定めたいという場合、単なるビデオブラックボックスではどうしてもできません。
MirroSのアプローチは、両者がそれぞれの役割を果たすことで、物理的側面はコードに、光と影の側面は神経モデルに任せるというものです。
コードが世界を推進し、モデルは「どのように見えるか」を担当する
AgentGartenでは、標準のインタラクティブクローズループは次のように動作します:
スマートアイテムが動作指令を出す;コード環境は直ちに物理的な衝突と状態の更新を計算し、スマートアイテムの第一人称カメラ視点から、軽量な「幾何学的スケッチ」(つまり空間の深さや表面の法線)を生成する。
その後、ニューラーニングレンダラーがこの幾何学的スケッチを読み取り、以前の視覚記憶と組み合わせて、瞬時にリアリティのある次のフレームをレンダリングし、インテリジェントアインに渡す。
△図2|コード環境と神経レンダーラー間の閉環流れ。スマートアイテムが動作指令を発出し、コード世界が状態を更新して幾何学的条件を出力し、神経レンダーラーが次の視覚観測をリアルタイムで生成する。
この分業は二つの大きな質的飛躍をもたらした:
第一に、物理法則は常に「確定可能で制御可能」である。
シーンレイアウト、接触判定、そしてゲームの勝敗はすべてコードによって決定され、何らかの「幻想的な物理現象」は生じない。
第二に、新しい世界を築くことが非常に速くなった。
過去では100個のリアルなシミュレーション環境を構築するには、専門の美術チームによるモデリング、パーツの貼り付け、光の設定が必要で、コストは耐え難いほど高かった。しかしAgentGartenでは、単純な3D深度と法線プロファイルを出力できれば、非常に簡素なコードのシーンでもこのニューロンレンダリングエンジンを直接適用でき、瞬時にリアルな光と材質が得られる。 翼装飛行、ロボットアーム操作、キッチンでの料理、複数の車両のレース。下層は同じ視覚インターフェースを共有している――仮想環境の拡張コストが、初めて「美術作業型密集体」から「コードプログラム化拡張型」へと変わった。
△図3|複数のタスクを跨ぐ多様な物理世界。空間ナビゲーション、物体操作、カメラ操作のリバイバル、複数車両間の相互作用などが含まれる。左側はコードから出力された簡易な白模,右側はレンダーラウザがリアルタイムで生成するリアリティのある視覚である。
より重要なのは、このレンダーランターがストリーム処理方式であることです。動作が一歩進むごとに、画面が一段表示され、アイドルが結果を理解した後に次の決定を下します。このインタラクションは、現実世界のように連続して進行します。
かくれんぼの再訪:2500万局と4ラウンド
世界は整った。次に見るのはスマートアイテムだ。このような世界で何度も行動し、振り返ることで、それがより良くなるかどうか?
古典的な例としては、OpenAIが2019年に行った隠れんぼ実験があります。そこでは、障壁と坂道がある場所で隠れる人と探す人が対戦し、大規模な自己対戦を経て、次々と掩体を作る方法や坂道を利用して壁を越える方法を学んでいきました。
MirroSチームはAgentGartenでこの実験を再実施しました。一対一の設定で、隠れる者がまずシーンを作り、その後探索者が行動するというものです。
対戦ルールは明確で純粋だ:隠れる者が先にシーンを作りて入口を塞ぎ、その後探索者が入って探索する。スマートアイテムはPythonコードを書くことで移動と掴む動きを制御し、目の前に生成される画面に基づいて判断を行い、空間の座標や相手の位置については何も知らない。
両者は完全に空白の手帳から始め、それぞれが一つのスキルから成る戦略ライブラリを維持する。各ラウンドで10試合を行い、戦闘後には分析し、蓄積したデータをもとに次のラウンドでランダムに一部のスキルを適用する。
すぐに、それらの古典的なゲーム戦略が数ラウンドのうちに次々と現れる:ボールを壁で閉じる、坂を移動して橋を作る、壁を越えて失敗した後、坂を近づいて再試行する。
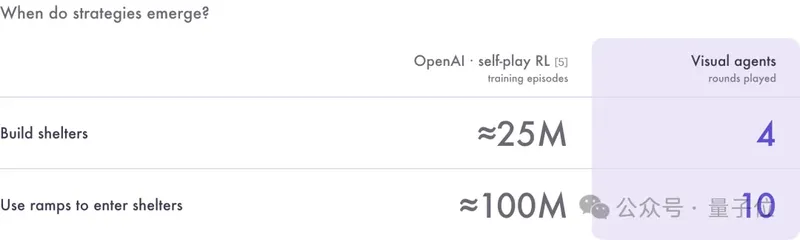
2019年の研究は、これらの典型的な行動が現れることで知られており、直感的な対比も提供されている(図4参照)。その研究では、AIはゼロから始まる強化学習に依存して隠れ場所の構築を身につけ、約2500万局を経験した。また、階段を利用して壁を越えることを学び、約1億局を経験した。
そしてAgentGartenでは、アグメントは第一人称視覚画面に直面し、ラウンド間で振り返りを行い文書マニュアルを修正する。隠れる者は第4ラウンドで掩体の使い方を学び、探索者は第10ラウンドで階段を利用して壁を乗り越える方法を習得した。
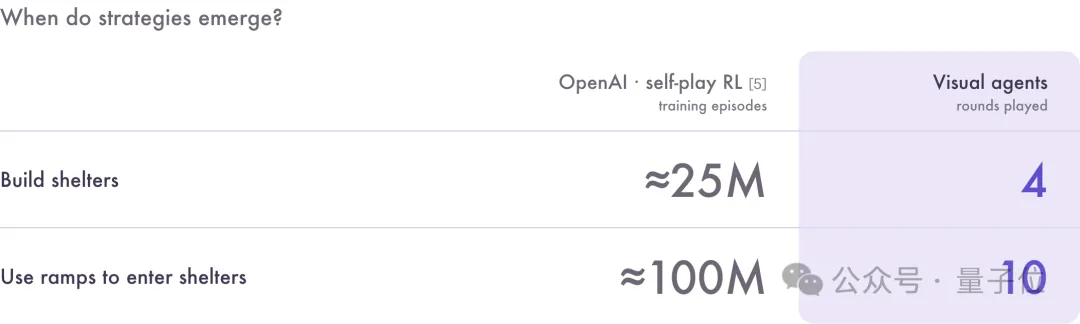
△図4|代表的な戦略が登場する前に経験される対局の規模の比較。自己対戦RLは特権的な物理状態において、0から数千万から数億回の対局を訓練する;MirroSアイドルは第一人称レンダリング画面に基づいて行動し、数ラウンドの内に反省マニュアルを通じて対応する戦略を迅速に習得する。
遊びながら覚え、経験を書き留める
ハイド・アンド・シークにおける迅速な進歩は、共通の演習プロセルに依存している。
MirroSの方法は:アームド自身が「自分でメモを取る」ことです。学んだすべての認知情報を、一冊一冊のマニュアルに書き記します。
演習は厳密な4つの段階的な段階に分けられている:
- 任務を受け取る:任務ファイルを手に入れ、行動の目標とルールの境界線を明確にするが、標準的な答えはない。
- ブラインドボックスの試行錯誤:厳格な歩数と時間制限の下で自ら行動する。カメラの映像のみで、神の座標も小さな地図もなく、ゴールに達しても得点は見えない。
- マニュアル作成:一ラウンド終了後、自己振り返りを行い、真面目に記録する:自分が何を試したか、どのような現象が見られたか、どの判断が疑問か、次回はどの新しい仮説を検証すべきか。
- 封印世代:マニュアルのアーカイブが凍結され、直接的に次のスマートアインターフェースに先入観として渡される。
スマートアイテムが書いたこれらの手引きを見ると、それらが非常に科学的な探求の色彩を帯びていることがわかる。モデルは「実際に見たこと」と「推測したこと」を厳格に区別し、後人が落とし穴を避けるためのガイドも特に明記している:
- 隠れ人間が得た実戦の真理はこうだ:「防御の核心は通路を塞ぐことであり、単に視線を遮るだけではない」と。後世の人々には、死角を利用して隙を減らし、わずかな動きで防壁の効果を確認するよう忠告している。
- 探索者は制御法則を導き出した:「物を運ぶ前に、まず引っ張ってみて。動かないと安全だと思わないこと」。近づいた後、微引きボタンを一按し、物体が部屋の目印に対して動くかどうかを見て、本当に掴んだかどうかを確認する。
- 橋を運転するドライバーの警告はさらに深く考えさせられるものです:「目標の円盤が車の死角に滑り込んだからといって、車が安全に到達したわけではない」。
試練に耐えた経験は後続者によって引き継がれ、失敗した教訓は新たな戦略の分岐を試みることにつながる。
同じループ、4つの世界に変えてもう一度実行する
隠れんかくは始まりに過ぎない。コードの世界は本質的にプログラム可能なソフトウェア環境であるため、同じ「探索—復習—蓄積」のサイクルをより複雑なシナリオにも簡単に適用することができる。
チームは、別の4つの全く異なる世界で、それぞれ4回の演習を実施した:
- 小犬の面倒を見る:スマートアイテムは60秒以内に手を伸ばして撫でたり、適切にボールを投げたりすることで小犬の好感度を維持する必要がある。得点は最初のラウンドの13点から第4ラウンドの19点に上がる。
- 狭橋会車:2台の車が運転者の第一視点で協議し、狭い単行車道で可能な限り短い時間で両端を交換する。2台の車が通過する総時間は71秒から41秒に大幅に短縮された。
- 協力して羊を追い込む:2匹の羊飼い犬が視覚的な連携で、4匹の羊を囲いに入れ、5秒間維持する。第1ラウンドでは3匹しか囲いに入れられなかったが、後の3ラウンドでは「一匹も漏れない」ように安定して全員を囲いに入れた。
- 採石場積み込み機:重機は石を押し出し、材料を運び、倉庫に入れる必要がある。第1ラウンドでは石をかろうじて押し出すだけだったが、第4ラウンドでは360秒の時間内に31秒早く全工程をスムーズに完了した。
これらの幅が非常に大きいタスクは、一つのことを示している:この経験の蓄積された閉環は、全く異なる世界でも同じように機能する。
画面が動きに追いつく方法:単一カード30フレームはどのように実現されたのか
アームドが仮想世界で「見ながら行動する」ようになるためには、ニューラクタリングエンジンは生成型ビデオを生み出す上での三つの大きな課題を克服しなければならない:突発的な動きに追従すること、長いインタラクションを安定して処理すること、そして十分に速く動くこと。
MirroSチームは基礎的な全モダリティモデルから出発し、Adversarial Forcing訓練方法を提案しました。さらに推論最適化と組み合わせることで、この視覚チャンネルを完全に構築しました:
1、全文のオフライン生成から、ストリーム方式のブロックごとのレンダ링まで
以前のビデオモデルでは、一括で全体のビデオを生成するのが常でしたが、AgentGartenではストリーム式で部分ごとに生成されるようになりました。アグメントが動作を行うと、モデルは即座に対応する短い映像を生成し、結果が確認された後で次のステップの決定をします。
2、長距離相互作用なしフリーダイブ(正確な再生)
連続して生成が長くなるほど、微小な誤差が蓄積されて見た目の偏差になりやすくなります。多くのモデルはメモリを節約するために歴史的計算図を切り捨て、グラディエントが歴史的記憶に戻らない状態になります。もし第二回目に全シーケンスを一括して再計算すると、下層の実行順序のわずかな違いが数パーセントの誤差を引き起こします。
チームは正確な再現メカニズムを設計した:第一回目はグレディングのない前方展開を行い、第二回目は完全に一致したブロックごとのリズムでグレディングを伴って再実行し、推演軌道を正確に再現し、長いシーケンスのインタラクションのタイミング一貫性を維持した。
3、実際の動画対抗を導入:画像の劣化やノイズを避ける
モデル自体が生成したサンプルを使ってスコアディストリビューを行うだけでは、長時間の推演で歪みやグリッド状のアーチファクトが生じやすい。
チームは訓練中に実際のビデオ判別器を導入し、対抗信号を構築した。実際の物理的な画質を基準として、画面の質感を制限すると同時に、生成結果がコードで指定された幾何学的輪郭に厳密に合致するようにした。
4、30+ fpsのリアルタイムインタラクションを維持する
チームは手書きでTriton統合演算器を作成し、グラフィックメモリの往復を排除し、従来の全画面コンパイルによる数分間の冷启动待ちを避けた。CUDA Graphと組み合わせることでCPUスケジューリングのコストを削減し、10ミリ秒未満の遅延の超軽量デコーデターに置き換えることで、最終的に480p解像度、30 fps以上のトランスポート安定性を維持し、闭环インタラクションを実現した。
持続的に進化する知能体のために、経験できる世界を準備する
実行可能なコードにより、訓練される世界は無限にプログラム化されることができる。学習によって得られるレンダーランザーにより、これらの世界には可感知のリアルな物理フィードバックが与えられる。蓄積された実験マニュアルにより、一つ一つの試行が次の探索のステップとなる。
これら3つを組み合わせることで、スマートアイテムは真に探索し、試行錯誤し、進化する空間を持つようになる。
これこそが、MirroSがPhysical RSI(物理世界の再帰的自己改善)を探求する核心理念です。
言語モデルのスケーリングは盛んに進行しているが、物理世界におけるスケーリングの実現はまだ始まったばかりである。
真の汎用具身インテリジェンスは、物理世界の実際の相互作用の中で継続的に成長する必要がある:
すべての未知を、次の進化の出発点にしましょう。
全文ブログ:https://mirros.ai/blog/worlds-for-evolving-agents
*本文は量子位の許可を得て掲載されたもので、意見は著者にのみ属する。