
田晏林 凹非寺より
量子位 | 公式アカウント QbitAI
なんと、世界アクションモデル(WAM)レースで、中国チームがいきなり世界首位に躍り出たのか!?
さらに、GPT-6-Astra、Physical Intelligenceのπ0.5、NVIDIA GR00T-N1.7など、世界中のトップ級のボディモデル(具身モデル)も、今回ことごとく後ろに置き去りにされた。
動いたのは中国のロボット企業——清华唯一の株式を保有する直系エンボディッドAI企業、星動紀元。
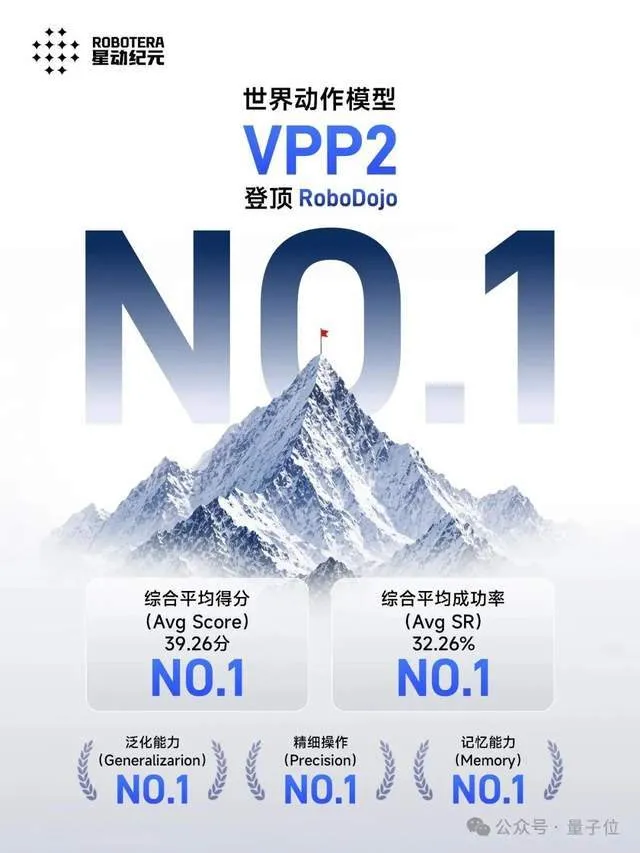
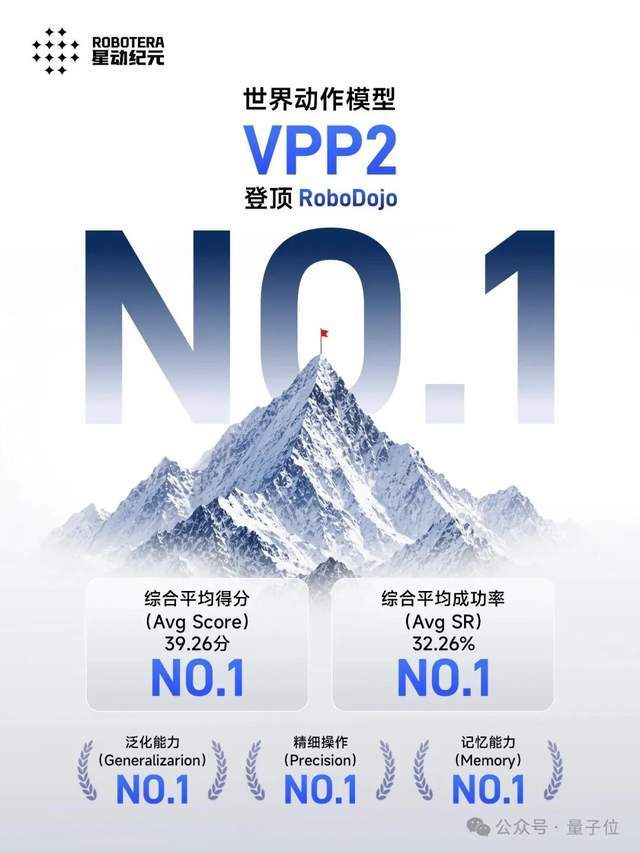
近日、星動紀元自社開発の世界動作モデルVPP2,一挙に頂点に立ったRoboDojoシミュレーションランキング。
総合平均成功率は32.26%、総合平均得点は39.26点で、2つの指標がいずれも第1位となりました。
問題は、この試合が実際にそう簡単ではないということだ。
RoboDojoは名乗る身体性知能(AI)分野における「エベレスト」、香港大学MMLabが主導し、世界の約20の頂尖学術機関が共同で構築したものである。
このベンチマークは、ロボットが苦手とするところを集中的に出題する:環境が変わっても仕事ができるのか?物がずれて置かれていても正確につかめるのか?タスクの途中で、それまでに何が起きたかを覚えていられるのか?
つまり、熟練度を稼いでごまかそうとするのは、そう簡単にはいかない。
結果はどうなったのか?
星動紀元VPP2は総合首位を獲得しただけでなく、汎化能力、精密操作、記憶能力3つの次元でも、首位を獲得しました。
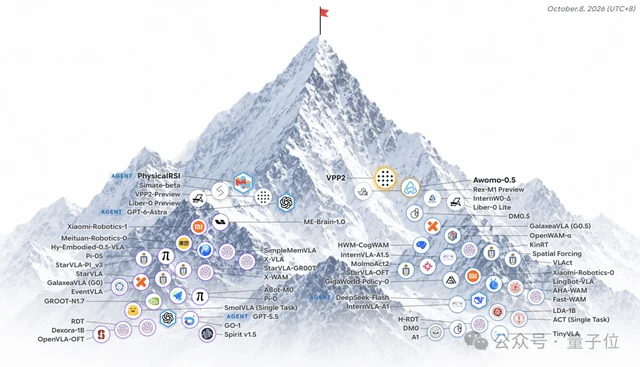
今回のVPP2は追加のデータは加えていない、またAgent RSIなどの強化手段を使っていない,「標準データセット」のみでは、多くの高手たちを巻き込んで下へ落としてしまった。
これは、VPP2モデル自体が十分に強力であり、性能向上は事前学習によるものであり、ベースモデルが十分に汎化しているため、外付けの強化戦略に頼らず、データを増やして「スコアを稼ぐ」ことに依存していないことを意味します。
いや、お前、こんなに強力なモデルは一体どうやって訓練したんだ???
我々は技術路線を掘り下げてみたが、言ってみれば、VPP2今回のブレークスルーは、確かに大したものがある。
それは世界動作モデルの長年の難題、つまり予測が間違えば動作も間違うという問題を狙い撃ちにした。
VPP2が提示した解決策は、まずビデオ予測能力を十分に強化まで鍛え上げ、その後にロボットを未知の環境で本当に動かせるようにするというものだ。
予測から行動まで、2種類の汎化能力を同時に向上させる。
現在公開されている複数のテスト結果を見ると、VPP2はすでに世界動作モデルWAMという分野で最も競争力のある選手の1つとなっている。
世界動作モデルWAM、新たなチャンピオンが誕生
具身知能(エンボディドAI)業界には、なかなか気まずい現象がある。
ロボットのデモはますます華やかになり、モデルのリーダーボードのスコアもどんどん上がっているが、いざ「どのロボットがより賢く、より仕事ができるのか」と問われると、
なかなか答えにくい。
例えばロボットにカップをつかませる場合。訓練時に見たことのあるテーブルの上では、百発百中かもしれない。しかしカップを変えたり、位置をずらしたりすると、たちまち自信を失ってしまう。
ましてや複数のステップを連続して実行する必要があるタスクなどはなおさらである。
だからこそ、RoboDojoというこの評価システムが注目に値するのだ。
その目標は、具身知能のために統一的で再現可能な評価基準を確立することであり、シミュレーションテストは42項目の双腕操作タスクを含み汎化、精密操作、長距離タスク、記憶、オープン語彙の命令理解という5つの次元をカバーする。
はっきり言えば、ロボットをコンフォートゾーンの外へ引きずり出すということだ。
従来のロボットモデルは慣れたタスクではほぼ満点に近い成績を収められることがあるが、環境、物体の位置、タスクの組み合わせが変化すると、成功率が明らかに低下する可能性がある。
RoboDojoはこうした複雑な状況を専ら評価対象とし、ロボットが変化に直面したときにどれだけの汎化能力を持つかを見るものだ。
そしてVPP2が今回提出した成績表は、かなり輝かしいものだ。
平均成功率32.26%、平均スコア39.26点と、いずれの指標でも首位に立った。
比較として、RoboDojoシミュレーションベンチマークのポストトレーニング評価では、GPT-6-Astraの平均成功率は22.48%、平均スコアは28.97点だった。
一方、VPP2はそれぞれ9.78ポイントと10.29点の差でリードしている。
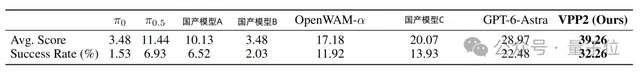
論文のスクリーンショット、ベースラインモデルのデータは公式リーダーボードより取得
ここで2つの指標にはそれぞれの狙いがある。成功率はロボットがタスクを完遂できるかを見るものであり、平均スコアはタスクがどの段階まで進んだかを測るもので、すべてを完遂できなくても段階的なパフォーマンスを反映できる。
いずれの指標も5大能力次元のテスト結果を総合したものだ。
言い換えれば、VPP2はタスクを完遂する割合が高いだけでなく、完了できなかったタスクに対しても、より強い段階的な遂行能力を示したということだ。
しかも、このリードは総合成績にとどまらない。
5つの能力次元に分解して見ると、VPP2は汎化、精密操作、記憶の3つの次元でも第1位を獲得した。
この3つの能力は、ロボットが現実世界に入る際の難関に対応している。環境が変わっても作業できるか、操作を正確にできるか、そして連続してタスクを実行する際に前のステップを覚えていられるか、である。
総合成績でリードし、重要な能力でも戦える。
ただし、RoboDojoがどれだけ難しくても、試験会場はあくまで「シミュレーション環境」だ。いざ物理世界になると、物体の摩擦、変形、位置のズレが、また一気に不確定要素を生む。
VPP2がシミュレーションで示した汎化能力は、実機でも成立するのだろうか?
星動紀元(Robot Era)も実験を行った。
今回は、チームはVPP2を実際のALOHA双腕ロボットに直接デプロイし、把持、配置、積み重ね、折りたたみ、注ぐなどの10類のゼロショット操作タスクをテストした。
つまり、これらのテストタスクに対して追加のファインチューニングを行うことなく、ロボットがいきなり取り組まなければならない。
その結果、VPP2は再びリードする成績を収めた。平均成功率は58.5%で、π0.5の40%を上回った。
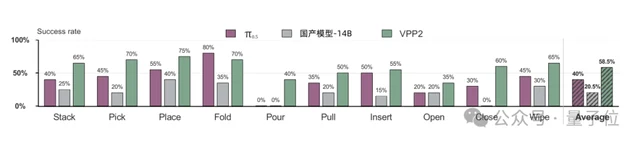
10類のタスクのうち、VPP2は9類で最高成績を獲得した。
これは面白くなってきた。
ランキング1位が証明するのは、標準評価体系における能力である。一方、実機でのゼロショット操作は、こうした能力が現実の物理環境へ転移できるかをさらに試すものだ。
2つの成績表を並べてみると、VPP2の技術的優位性はさらに掘り下げる価値がある。
というのも、VPP2は世界動作モデル(WAM)路線。
を採用しているからだ。この種のモデルの基本的な発想は、動画予測によって物理世界が次にどう変化するかを理解し、その予測をロボットの動作へと変換するというものである。
しかし、この路線には長年ある問題が存在していた。動画予測がきれいにできても、ロボットが実際に仕事をこなせるわけではないのだ。
今回のVPP2は、まさにこの問題に狙いを定めた。
予測の汎化から行動の汎化へ、VPP2はどうやって実現したのか?
VPP2のブレークスルーを理解するには、まず簡単なタスクを見てみよう。ロボットに机の上のコップを箱に入れさせるというものだ。
人間にとっては、手を伸ばして掴み、持ち上げ、入れるという動作は、ほとんど考える必要もない。
ただしロボットはカップの位置、ロボットアームの運動軌跡、グリッパーをいつ閉じるかを判断しなければならず、さらに操作の全過程で物理世界に何が起こるかを予測する必要もある。どの一歩ででもズレが生じれば、失敗につながりかねない。
既存の世界動作モデル(WAM)は、まさにこの点で問題を起こしやすい。
一方で、一般的な動画モデルは画面の生成が得意ですが、画面がもっともらしく見えることと、現実の物理法則に従うことは別の話です。
たとえば左側のコップをつかむよう指示したのに、モデルが右側のものをつかむと予測してしまう。動画はそのまま生成できても、ロボットが実行する際には大きく的外れな動きをしてしまう。
一方で、動作の学習を動画モデルに直接組み込むことは、元の汎化能力を損なう可能性もある。
その結果、動作は覚えたものの、ロボットは環境が変わると同じことができなくなってしまう。
VPP2は非常に直接的な判断を提起した。動画予測の質が、動作の上限を決める。
この考え方に基づき、星動紀元は動画予測と動作学習を段階的に分けて訓練することを選択した。重点は「動画と動作を一鍋で煮込む」ことではなく、両者を「デカップリング」、再び「並べ替え」。
星動紀元はこのために一式を設計した3段階トレーニング戦略:
- 第一阶段,イベントレベルの動画による継続事前学習を行い、モデルが完全な操作プロセスを予測できるようにする。
- 第二段階として、固定時間長の動画ポストトレーニングと蒸留を行い、予測能力がロボットのリアルタイム実行の速度に追いつくようにする。
- 第三段階は動作エキスパートの訓練であり、動画予測を具体的な動作に変換すると同時に、既存の汎化能力をできる限り保つ。
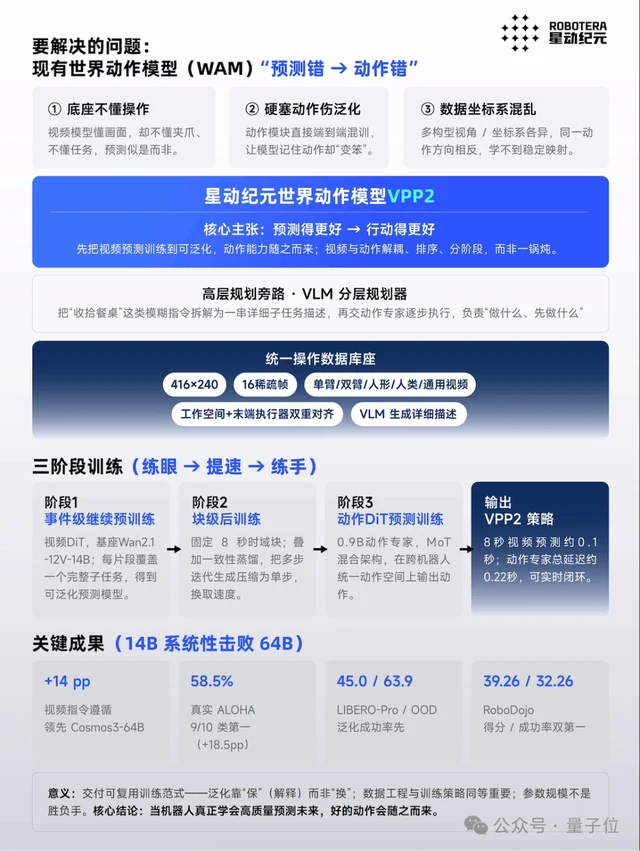
三つの段階が層をなして進み、最終的に目指すのは二つの核心的ブレークスルーである:予測が汎化し、行動も汎化すること。
最初のブレークスルー:動画予測に汎化能力を持たせる
VPP2がまず解決すべきなのは、ロボットが未知のタスクにおける物理的変化を正確に予測できるかどうかである。
星動紀元は、阿里(アリババ)がオープンソース化したWan2.1-I2V-14Bをベースに、ロボット操作、人間の活動、汎用動画など多様なデータを統合し、異なるロボットのボディや操作方式をカバーしている。
ただし、本当に興味深いのはそのデータ処理である。
チームは動画を単に一括してモデルに投入するのではなく、まず操作過程を意味的に完結したセグメントに分割し、詳細な記述を付与した。
たとえば、モデルに「カップを箱に入れる」と伝えるだけでは不十分で、どちらのロボットアームか、どのカップか、どの箱か、そして操作過程全体を明確にする必要がある。
なぜなら、同じ曖昧な命令が無数の動作軌跡に対応しうるからだ。
モデルが操作対象すら把握できていなければ、未来を正確に予測するのは難しい。
VPP2はタスクをより細かく記述し、言語命令と物理的操作の間に安定した対応関係を形成させた。
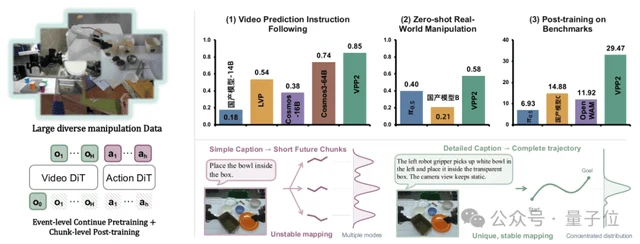
さらに重要な一歩が、イベントレベルの動画予測訓練である。
従来の短時間予測は次の数フレームで何が起こるかに注目するが、VPP2はモデルに一連の完全な操作の開始から終了までの変化を直接学習させる。
ロボットアームがカップに近づき、カップをつかみ、箱に入れるまで、モデルが理解すべきは一つの事柄全体がどのように起こるかである。
これによって、新しい物体、位置、さらには操作タスクに対しても、合理的な物理的変化を予測できる機会がより増える。
ロボット操作動画の指示追従テストでは、14BパラメータのVPP2は90%の成功率を達成し、64BパラメータのCosmos3モデルは78%だった。
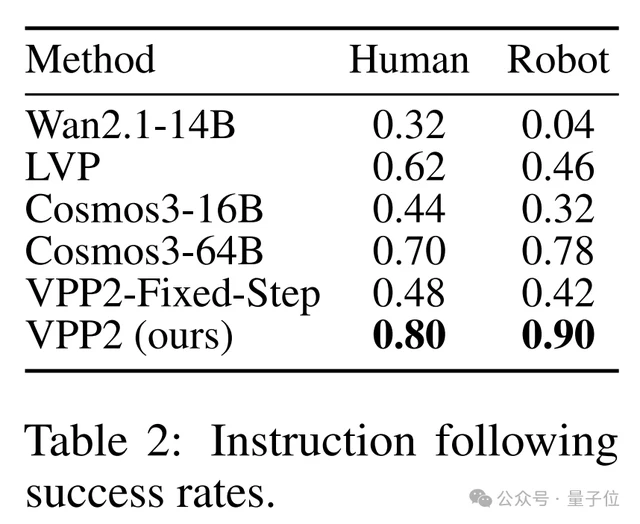
14Bが64Bに勝ったのだ。
これは、物理操作の予測において、パラメータ規模が勝敗を決める唯一の要因ではなく、操作プロセスを本当に理解できるかどうかも同様に重要であることを示している。
ただし、どれだけ正確に予測できても、ロボットが動けなければ意味がない。
第2のブレークスルー:予測の汎化を行動の汎化に変える
ここには2つのハードルがある。1つは速度であり、もう1つは動作を学びながら、動画モデルが元々持っていた汎化能力をいかに保つかである。
最初のハードルは理解しやすい。ロボットに作業をさせる際、各動作の前に数秒かけて動画を生成していたのでは、どれほど強力な予測能力もあまり役に立たない。
星動紀元はまず予測モデルの高速化を選んだ。
チームはイベントレベルの予測モデルを固定8秒の動画断片予測にさらに調整し、一貫性蒸留によって多段階の計算を単一ステップの生成へと圧縮した。
最終的に、未来8秒の視覚的変化を予測する計算時間は約0.12秒となった。
二つ目のハードルは、少し厄介だ。
せっかく動画モデルに未知のタスクを予測できるようにしたのに、動作訓練を加えると、モデルはかえって慣れた操作しか実行できなくなった。
動作能力は育ったのに、汎化能力は失われた?VPP2がやろうとしているのは、この二つのハードルを同時に乗り越えることだ。
VPP2は0.9Bパラメータの拡散Transformer(Action DiT)を導入し、MoTアーキテクチャを採用して、予測された未来の状態に基づいてロボットの動作を生成する方法を学習する。
ただし星動紀元は、動画予測モデル(Video DiT)と動作エキスパートを一緒にゼロから訓練することはしなかった。
動作訓練の初期段階では、動画モデルの基礎パラメータを凍結し、LoRAを通じてのみ適応を行うことで、動作訓練が既存の予測汎化能力を壊すことを極力避けた。
これは、まずロボットに物理世界がどう変化するかを理解させ、その後、その「理解」を「動作」に変換する方法を訓練するのに相当する。
二つの能力は段階的に育ち、かつ相互に協力し合う。
最終的に、動画予測には約0.12秒、動作エキスパートには約0.1秒かかり、動作断片生成全体の遅延は約0.22秒となる。
もちろん、アーキテクチャがどれほど美しくても、最終的な効果次第だ。
先に述べたALOHA実物ロボットによるゼロショットテストは、VPP2が予測能力を未知のタスクの操作へと転化する可能性をすでに示している。
さらに二つの汎化テストが、この道筋をさらに検証した。
LIBERO-Proは物体の位置やタスク要件が変化した後の操作能力を検証するもので、VPP2は45.0%の全体成功率を達成し、その他のベースラインモデルの最高は11.0%だった。
LIBERO-OODは組み合わせ汎化を検証するもので、慣れ親しんだ物体、レイアウト、タスク目標を再組み合わせし、これまで見たことのない新タスクを作り出す。
VPP2の全体成功率は63.9%に達した。
これらの結果を並べて見ると、VPP2の技術的発想が明確になる。
まず多ソースデータ、詳細なタスク記述、イベントレベルの予測訓練を通じて、モデルが物理的変化をより正確に予測できるようにする。
次に蒸留による高速化と段階的動作学習を通じて、この予測能力を実際の操作へと転化しつつ、元の汎化能力を可能な限り保持する。
具身知能の性能上限は、規模をひたすら積み上げるしかない段階には明らかにまだ達していない。
VPP2が改めて示しているのは、データパイプラインの最適化や訓練パラダイムの調整といった一見平凡なエンジニアリング手法でも、依然として顕著なモデル性能の向上をもたらす可能性があるということだ。
GPTからWAMへ、物理AIが新たなパラダイムを形成しつつある
予測が汎化し、行動も汎化する――これが、世界動作モデルWAMとしてのVPP2で最も注目すべき核心的なブレークスルーである。
しかし実際のタスクは往々にしてもっと複雑だ。ロボットはやり方を知っているだけでなく、何を先に、何を後にするかを判断しなければならない。
そのためには、より高次の認知能力と計画能力が関与する必要がある。
星動紀元(Xingdong Jiyuan)はここで一つの考え方を提示した:GPTが考え、VPP2が実行する。
前者は理解・推論・計画を担い、複雑なタスクを明確なステップに分解する。後者は物理世界がどう変化するかを予測し、計画を具体的な動作へと変換する。
この考え方は、VPP2の論文においてすでに予備的な実験的裏付けが得られている。
チームが実際に採用したのはVLMによる高レベルプランナーで、これが意味理解・記憶・タスク分解を担い、明確化されたサブタスクをVPP2に実行させる。
結果は極めて明快だった。RoboDojoで選定された長距離タスクのテストにおいて、VLMによるサブタスク計画を導入した後、平均成功率は27.6%から向上した。57.6%。
つまり、ロボットが複雑なタスクを完了するには、強力な動作能力だけでは不十分だ。高レベルの計画と低レベルの実行が連携できるかどうかも、タスクの達成度に影響する。
この流れに沿って先を見ると、GPT+VPP2は、新たな物理AI技術パラダイム「汎用認知+汎用物理実行」を形成する可能性を秘めている。
GPTなどの汎用モデルは意図の理解・推論・計画を担当し、VPP2のようなWAMは物理的変化の予測と動作の生成を担い、さらに実行からのフィードバックを通じて継続的に調整する。
認知、計画、予測から、実行、フィードバックまで、一式そろった物理AIのループが次第に明確になってきている。
そしてこれにより、WAMの価値にはさらに大きな想像の余地が生まれる。
モデルの能力はロボット本体を通じて物理世界と相互作用することで発揮され、実際の使用は失敗を露呈させフィードバックを生み、モデルとハードウェアのさらなる改良を推し進める。
星動紀元は脳、本体、そしてハンド(灵巧手)を同時に手がけており、「深いフルスタック」という戦略はこの論理の中で説明できる。同社が握ろうとしているのは、訓練の工程だけでなく、能力の実装とフィードバックの還流という工程も含まれている。
u1s1、どんなに技術ルートが美しくても、最終的には現実世界で働かなければならない。
星動紀元はこの面で、すでに中国郵政、順丰(SFエクスプレス)などの企業と協力し、全国5つの省市、10以上の物流センターで常態的に運営している。
物流シーンでは、貨物のサイズ、配置場所、作業フローが変化する可能性がある。同じ一連の操作でも、倉庫が変わればロボットは再び適応し直さなければならないかもしれない。
これはまた、ロボットの汎化能力に対してより高い要求を課すものでもある。
モデルが学んだ能力を見知らぬタスクに転移できるかどうかは、将来のシーン横断的な展開の効率とコストに直結する。
もちろん、既存の物流事業で商業化が進展していることは、VPP2がすでに規模化展開を実現したことを意味しない。モデルがより多くの実際のシーンで長期にわたり安定的に動作できるかどうかは、さらなる検証が必要だ。
しかし、VPP2の今回の成果は、注目に値するシグナルをすでに放っている。
世界動作モデルをめぐる競争は、未来の予測から、さらにその予測を汎用的な行動へと転換する段階へと進みつつある。
振り返ってRoboDojoの頂点達成を見ると、注目すべきはもはや1位という事実だけではなくなっている。
シミュレーションから実機へ、予測の汎化から行動の汎化へ、VPP2の一連の実験結果が示しているのは:動画予測と動作学習の段階的訓練は、確かにロボットの見知らぬタスクにおける操作能力を向上させ得るということだ。
そしてGPTなどの汎用認知モデルとWAMのさらなる結合に伴い、物理AIもより完全な能力体系を形成することが期待される。
結局のところ、具身知能(エンボディッドAI)の次の勝負どころは、ロボットが学んだ能力をより多くの見知らぬシーンに持ち込めるかどうかなのだ。
正確に予測するだけでなく、実際にやり遂げること。それこそが、世界動作モデルが真に物理世界へ向かう鍵である。
PS:VPP2はすでにオープンソース化されており、興味のある方はぜひ試してみて、論文の結果を再現してみてください。
もし本当に何か驚きの結果が出たら、ぜひ戻ってきて私たちとシェアしてくださいね〜
1. オープンソースコード
:https://github.com/roboterax/video-prediction-policy-2
2. プロジェクトホームページ:
https://robert-gyj.github.io/video-prediction-policy-2