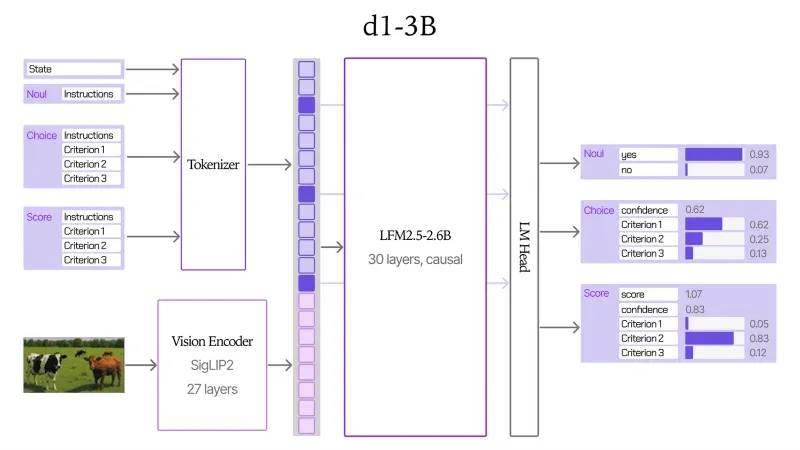
IT之家 10月9日の報道によると、Liquid AIは10月7日にブログを公開し、d1シリーズの2つのオープンウェイト決定モデルを発表した。d1-3Bは31.2億パラメータを使用してテキストと画像の判断が可能であり、d1-omni-600Mは5.87億パラメータを使用してテキスト、画像、音声の入力が可能である。
IT之家がボウェンの発言を引用して述べているところによると、Jevモデルが9月に大ヒットした後、OpenAIなどの企業も同様の意思決定モデルを相次いで公開している。そしてLiquid AIはこの戦場に新たに加わったメンバーであり、今回公開されたd1-3Bとd1-omni-600MはHugging Faceで公開されており、ユーザーはそれらをダウンロードし、微調整してデプロイすることができる。
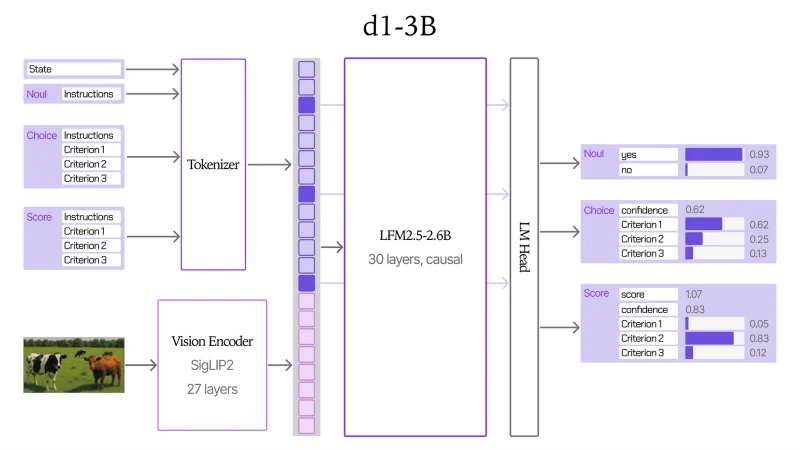
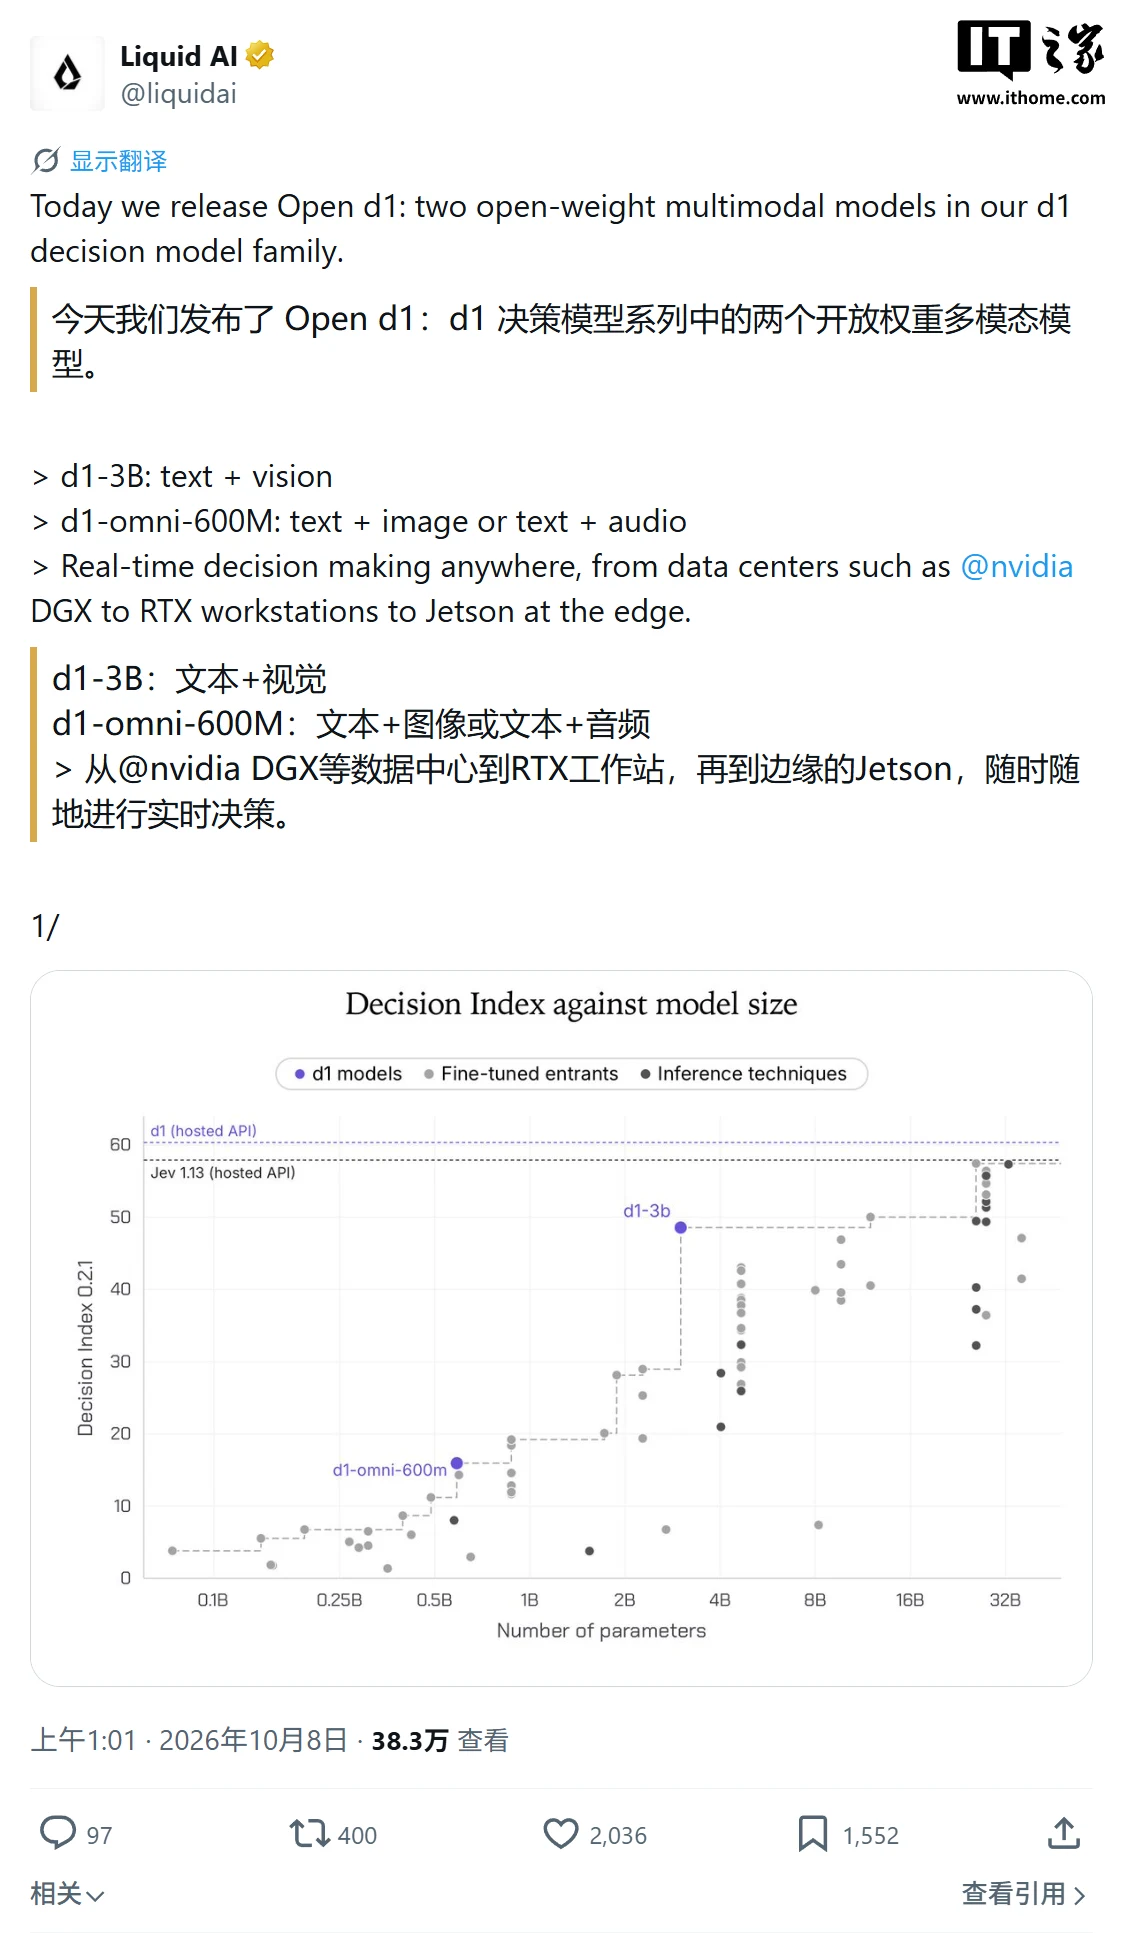
d1-3Bは31.2億個のパラメータを持ち、視覚言語モデルLFM2.5-VL-3Bを基に訓練されており、テキストと画像の入力をサポートします。このモデルはDecision Index v0.2.1の公開テストセットで48.57点を獲得し、Liquid AIはこれが10B以下のすべてのモデルよりも優れていると述べています。
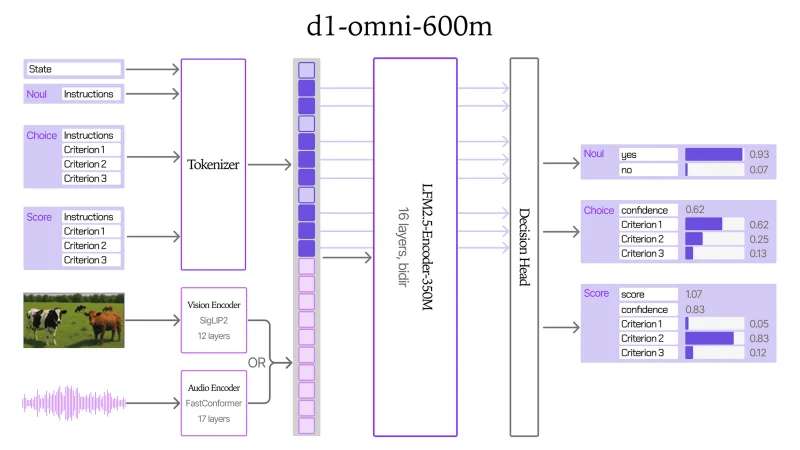
d1-omni-600Mは5.87億個のパラメータを持ち、双方向エンコーダLFM2.5-Encoder-350Mを基に訓練されました。このモデルはテキストと画像、またはテキストと音声の組み合わせ入力をサポートし、Liquid AIの最初の多モーダル決定モデルチェックポイントに属します。
推論速度に関しては、d1-3Bは NVIDIA RTX 4090上で単一の問題に対する回答に8ミリ秒、384ピクセルの画像を処理するには102ミリ秒かかります。Jetson AGX Thor上では1つの質問に16ミリ秒、Jetson Orin Nanoでは50ミリ秒かかります。
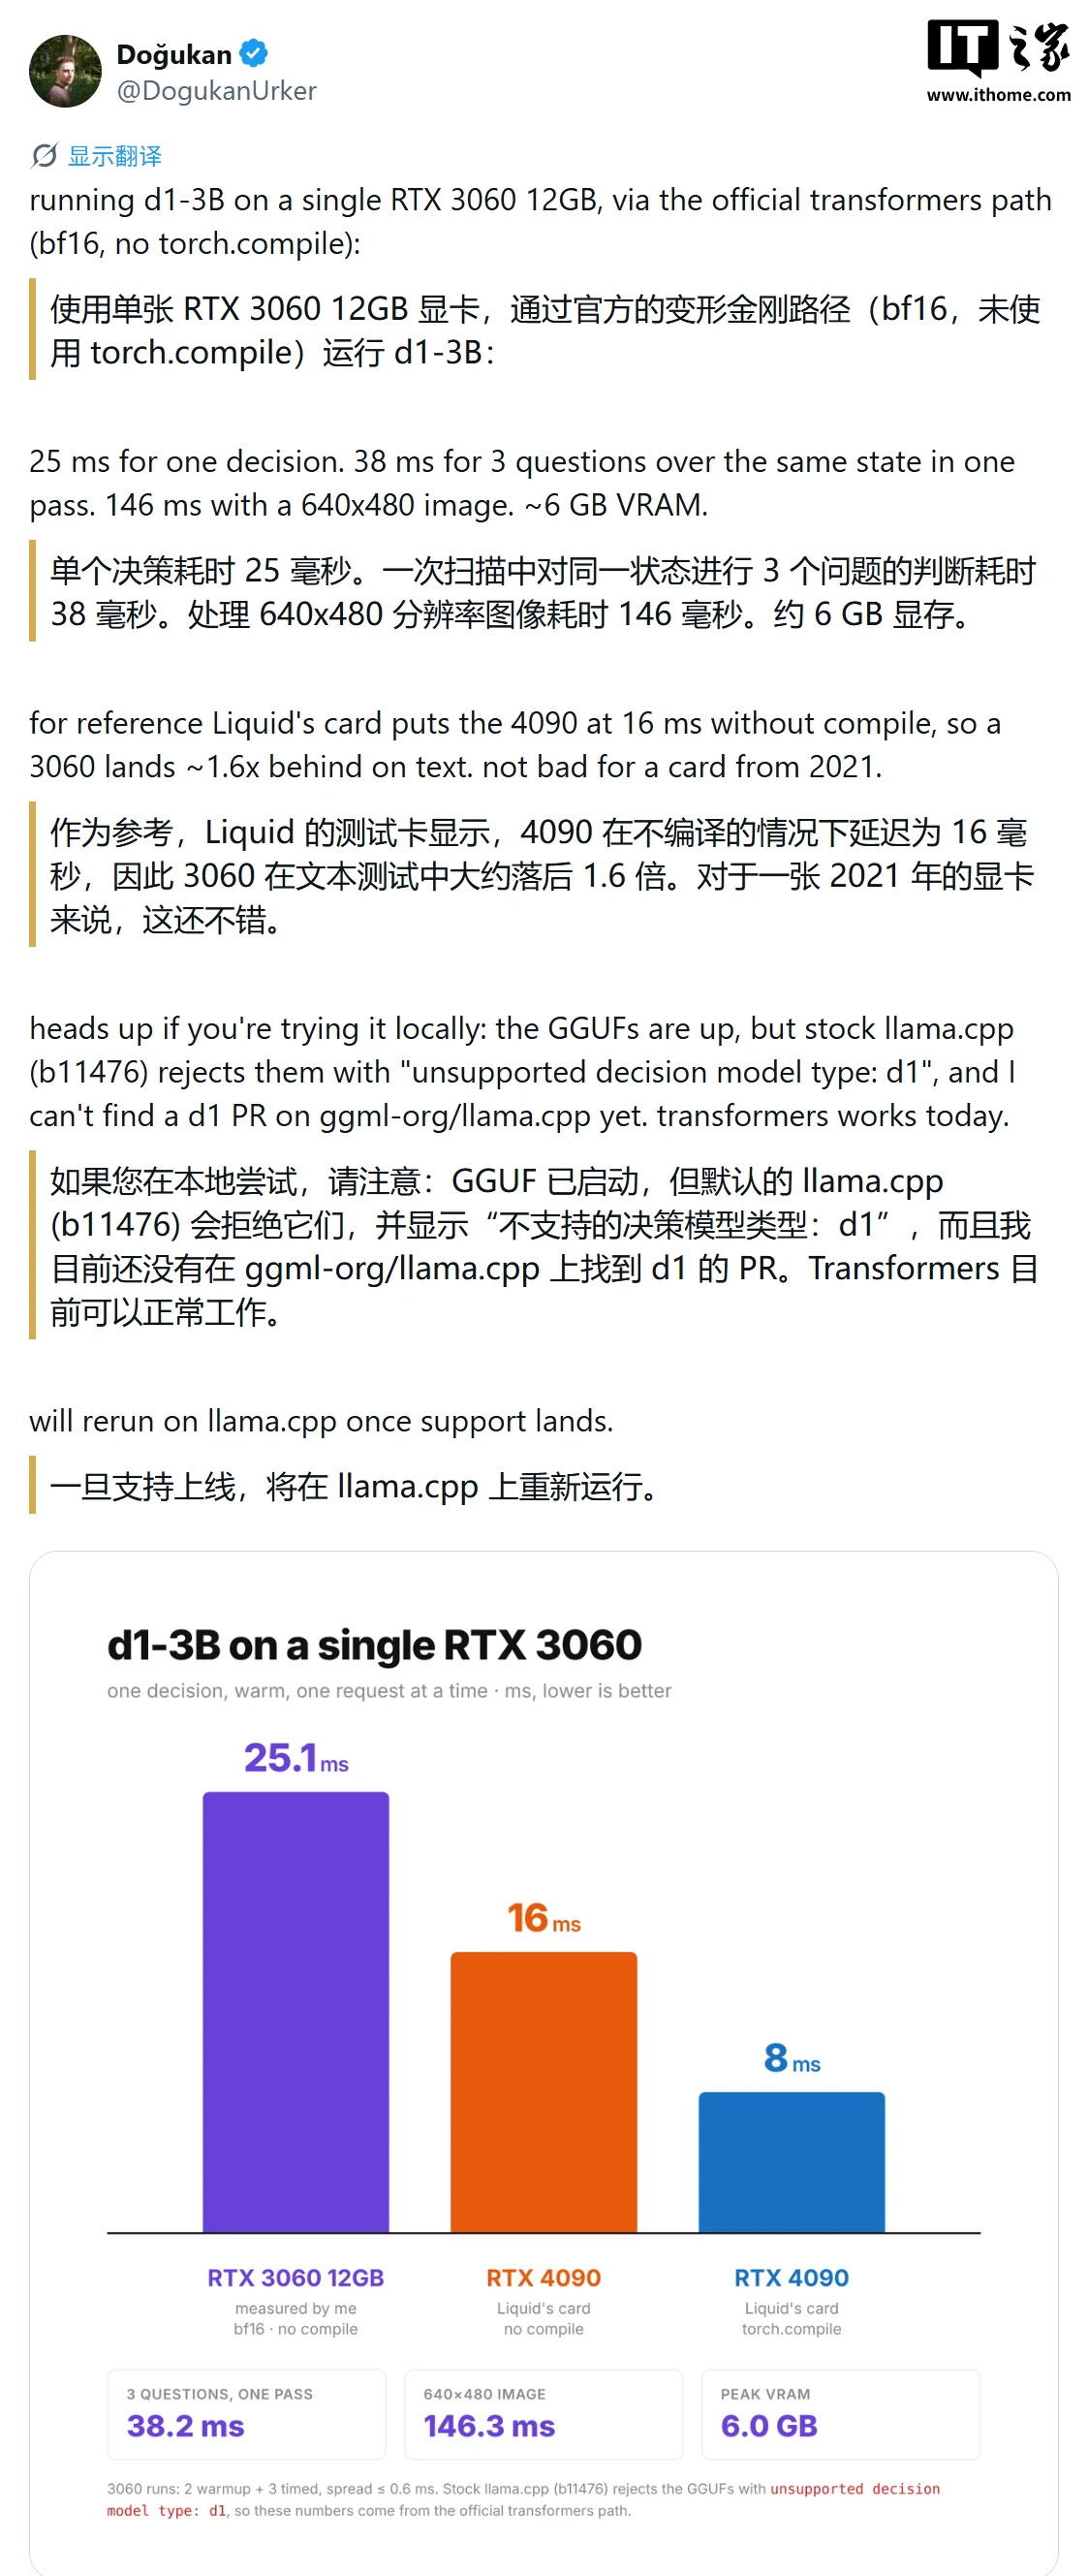
ユーザーテストによると、d1-3Bは12GBのグラフィックメモリを備えたGeForce RTX 3060で、1回の判断に25ミリ秒かかり、640×480ピクセルの画像を処理するのに146ミリ秒かかり、ピーク時のグラフィックメモリ使用量は約6GBです。また、別のユーザーは、このモデルがRTX 3090で1回の判断に8ミリ秒かかると報告しています。