
聞楽 凹非寺より
量子位 | 公衆号 QbitAI
DeepSeekの神と鬼の二面性が、バイトSeedチームに捕捉された。
同じ問題で何も変更せず、前に無意味な文字をいくつか付け足しただけで、モデルが突然解けなくなる???
しかも、たまにおかしくなるという話ではない。
Seedの研究者たちが発見したのは、DeepSeek-V4のパフォーマンスが情報の入力位置に応じて、4 Tokenごとに周期的に変化する。
ということ。どういうことか?ある事をモデルが覚えていられるかどうかが、その事が入力のどこに位置しているかで決まる??
前にTokenを2つ増やすと答えが誤りから正解に変わることもあれば、さらに2つ増やすとまた元に戻ることもある。
なるほど、モデルも解答に立ち位置を気にし始めたというわけだ。
128Kの長いコンテキスト検索テストにおいて、研究者たちは、同じ情報でも位置を変えるだけで、DeepSeek-V4シリーズのモデルの検索精度が最大40.2ポイント差が開く。
ことを発見した。さらにチームは、この問題がDeepSeek-V4が採用している長コンテキスト最適化技術に関係していることを突き止めた——
チャンクKV Cache圧縮。
である。この技術は本来、モデルが長文を処理する際のメモリを節約し効率を高めるためのものだった。
ところが圧縮した結果、モデルが神になったり鬼になったりする羽目になった(doge)。
Tokenが2つ増えただけで、DeepSeekが突然正解した
バイトSeedの研究者たちは最初、DeepSeek自身のコードを使って実験を行った。
テスト対象はDeepSeek-V4-Flash-Base。
。研究者たちはDeepSeek-V4の公式推論コードからFP8量子化関数の一部を切り取り、モデルに最後のTokenを補完させた。
このタスクの正解は8になるはずだ。このコードはFP8関連の型変換を行う必要があるからだ。
ところが、モデルは時々、32を補うべきだと判断してしまう。
何が起きているのかを突き止めるため、研究者たちはコードの前に純粋に装飾的なdocstringを付け足し、そこに繰り返しの等号を置いた。
そして、等号の数を調整し始めた。
コード自体は変更せず、補完する位置も変更せず、正解はもちろん変わらない……唯一の変化は、前に実際の意味を持たないこれらのTokenが増えたことだけだ。
その結果、DeepSeekの答えは右往左往し始めた。
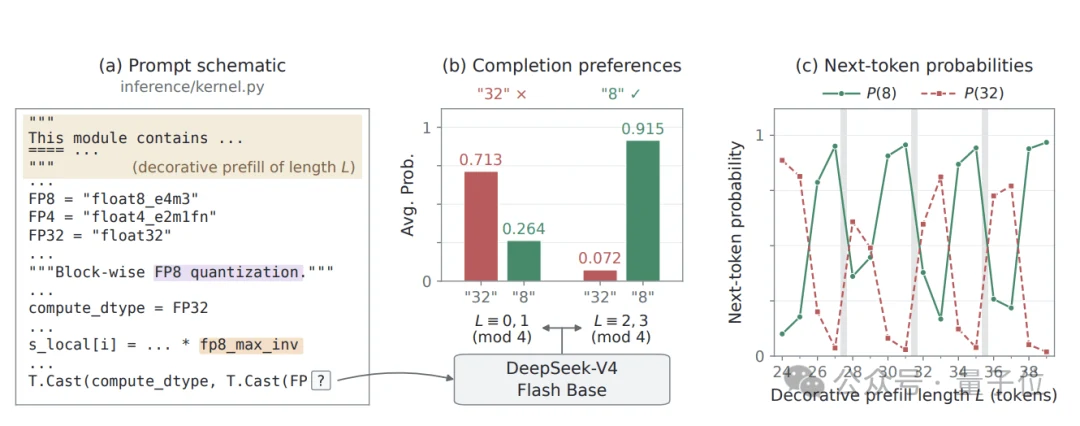
パディング長がある位置に落ちると、モデルは誤った32と答える傾向が強くなった。
1、2 Token前へずらすと、今度は正しい8に答える傾向が出てきた。
さらに動かし続けると、誤った答えがまた現れる——
この一連の過程は4トークンを周期として繰り返される。
より具体的に言うと、論文でテストされた16種類のパディング長のうち、長さを4で割った余りが0または1の場合、モデルは誤った答え32を好み、余りが2または3の場合には正しい答え8を好む傾向がある。
研究チームはまた、モデルが2つの候補解答に割り当てた確率も集計した。
ある一連の位置において、誤った答え32の平均確率は71.3%に達し、正解の8はわずか26.4%でした。
別の組み合わせの場所に切り替えると、状況はまったく逆になります:
正解8の平均確率は91.5%まで上昇し、誤答32は7.2%まで低下した。
つまり、前の方にある無関係な文字の長さの変化だけで、モデルが同じ問題に対して全く異なる判断を下しうるのです。
これは少し評価が難しいところです。
プログラマーがコードをデバッグする際、通常はまずロジック、変数、依存関係を確認します。
今にして思えば、前にもうひとつ等号を打ちすぎていないか、ついでに確認しておいたほうがよいかもしれない。
ただし、コード補完の単一の事例だけでは、この問題がどれほど一般的かを示すには十分ではない。
そこでSeedチームはテストをさらに拡大していった。
彼らは大規模モデルの長文コンテキスト能力における非常に古典的なタスクに目を向けた。大海で針を探す。
研究者たちは128Kトークンにも及ぶ長大なコンテキストを構築し、その中に約1.6万件のキーと値のペア。
たとえばK1はV1に対応し、K2はV2に対応する……
その後、モデルにその中から指定されたKeyに対応するValueを見つけさせます。
テスト中、キーと値の対応関係は不変で、問題も不変であり、コンテキスト全体の長さも一致したまま保たれます。
研究チームは特に調整を行った圧縮ウィンドウ境界に対するターゲット情報の位置。
その結果、DeepSeek-V4シリーズの正解率カーブには、非常に明確な周期的な起伏が現れていることが分かった。
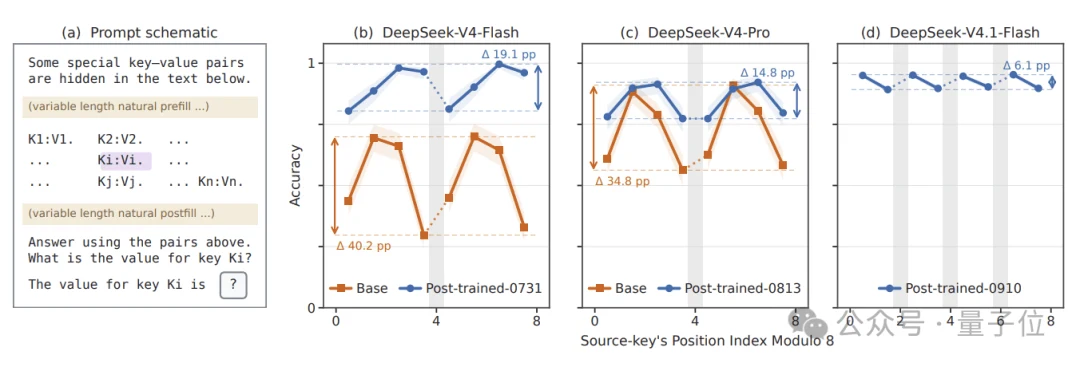
このうちDeepSeek-V4-Flash-Baseでは、異なる位置間の最大正解率差が40.2ポイントに達した
DeepSeek-V4-Pro-Baseも34.8ポイントに達した。
経過事後トレーニングその後、状況は改善した。
DeepSeek-V4-Flash-0731との差は19.1ポイントまで縮小し、DeepSeek-V4-Pro-0813とは14.8ポイントまで縮小した。
さらに更新されたDeepSeek-V4.1-Flash-0910では、差は6.1ポイントまで縮まった。
ただし、周期的な差異は依然として存在している。
このような差異はどこから来るのでしょうか。
さらに細かく見ると、DeepSeek-V4の変動周期は4トークンですが、DeepSeek-V4.1では2トークンになっています。
研究者らが発見したところによると、このちょうど両世代のモデルがそれぞれ採用しているKV Cache圧縮ステップに対応している。
なるほど、問題解答のパフォーマンスの変動周期まで、低層の圧縮設定と一致しているじゃないか。
問題はKV Cache圧縮にあるのか?
それでは、KV Cache圧縮について話そう。
大規模モデルが長いコンテキストを処理する際には、後続の注意計算で使うために、大量の過去トークンに対応するKeyとValueの情報を保存しておく必要がある。
コンテキストが長くなるほど、このキャッシュが占めるメモリと計算コストは大きくなる。
特に数十万、上百(Token換算で数十万から百万以上という意味)にも及ぶトークンの長いタスクでは、KV Cacheが推論効率のボトルネックになりやすい。
そこでDeepSeek-V4はチャンクKV Cache圧縮。
アプローチは、連続するトークンを一つ一つのウィンドウに分割し、ウィンドウ内の情報をより少ないキャッシュエントリへと圧縮するというものです。
これにより、モデルは過去の各トークンについて同じ規模のキャッシュを保持する必要がなくなります。
メモリを節約できるだけでなく、長いコンテキストの注意計算のコストも削減できます。
しかしSeedチームは、DeepSeekに神と鬼の二面性が現れる原因が、このチャンク分割のプロセスの中に隠されている可能性があることを発見した。
仮に4つのTokenごとに1つの圧縮ステップを構成するとします。
では、同じ情報がウィンドウ内の第1、第2、第3または第4の位置に現れると、圧縮時の条件が異なる可能性があります。
この論文は、圧縮ウィンドウの境界に対するこのような相対的な位置を、次のように呼んでいる。位相(フェーズ)。
研究チームは発見した、モデルは異なる位相の情報に対して、検索能力に体系的な差異が存在する。
彼らはこの現象を次のように命名したPhase Sensitivity、位相感度。
たとえば、同じ資料をモデルに渡す場合を考えてみます。
1つ目のレイアウトは、重要な数字がちょうどモデルが保持しやすい位置に落ちている場合。
2番目のレイアウトでは、前にいくつか文字が追加されただけで、重要な数字の圧縮ウィンドウに対する相対的な位置が変わっています。
資料は同じ資料でも、その後モデルが数字を見つけ出せるかどうかには、大きな差が生じる可能性があります。
さらに、この種の問題は「情報がちょうど2つのウィンドウの間で切れてしまった」と単純に片付けることもできません。
研究者らが発見したところによると、KeyとValueが同じ圧縮ウィンドウ内に収まっている場合でも、位置が異なると検索精度が大きく異なることがあるという。
これは、問題がモデルが情報を圧縮キャッシュにどのように書き込むか、そしてその後キャッシュからどのように読み出すかにも関係していることを示している。
さらに確認するため、Seedチームは自らゼロから一連のモデルを訓練した。
彼らはQwen3-0.6Bアーキテクチャを基盤として、複数のKV Cache圧縮方式を構築し、ブロック圧縮を行わないフルアテンションモデルを対照として設定した。
焦点は圧縮メカニズムだけを変えることで、周期的な変動がそれに伴って現れるかどうかを確認する。
その結果、すべてのテストを受けたブロック圧縮モデルにおいて、圧縮ステップに対応した周期的な変動が現れた。。
逆に、フルアテンションベースラインモデルには同等の周期性は現れなかった。
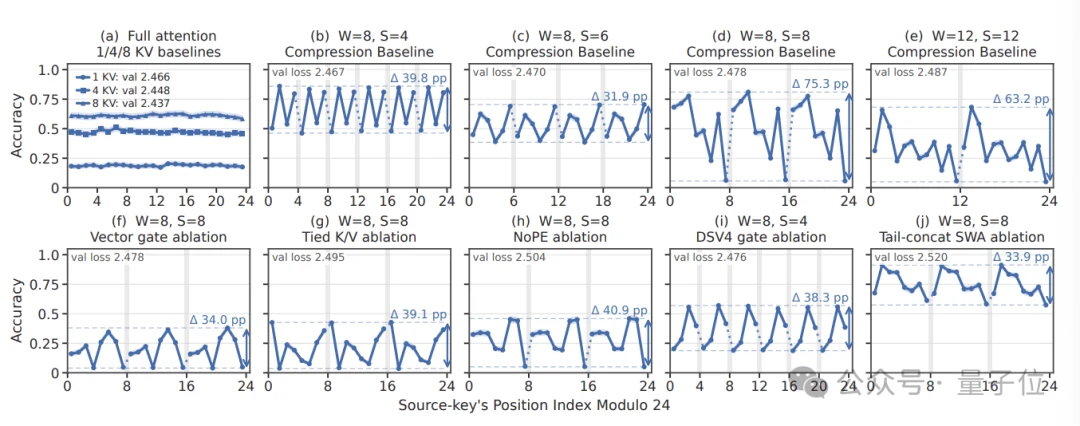
研究チームはさらに窓サイズと圧縮ステップをそれぞれ変更したところ、周期が主に圧縮ステップの変化に従うことを発見した。
ストライドを4にすると、性能は約4トークン周期で上下します。
ステップ幅が6になると、周期もそれに伴い約6トークンになります。
ステップ幅が8の場合も同様である。
……
さらに、RoPE位置エンコーディングを使わない場合や、学習可能な圧重みを単純平均に置き換えた場合でも、この現象は依然として存在する。
言い換えれば、この問題は特定の位置エンコーディングや特定の特殊なモジュールが単独で引き起こしたものではない。
ブロック圧縮という設計そのものが、周期的な検索の弱点をもたらしている可能性がある。
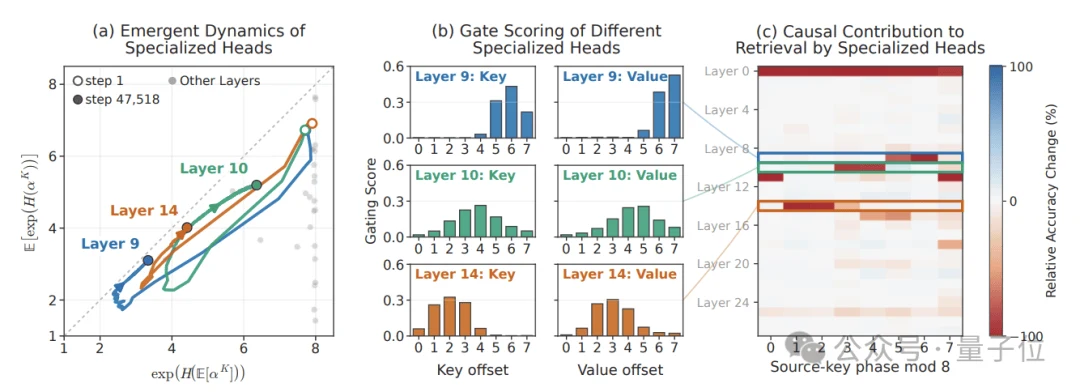
Seedチームはさらにアテンションヘッドへの介入を行い、異なるコンポーネントを除去した後に、モデルの各フェーズにおける検索能力がどう変化するかを観察した。
その結果、異なるアテンションヘッドが異なるフェーズに与える貢献は一様ではないことが分かった。
あるヘッドは特定の位置の情報の処理を得意とし、別のヘッドは他の位置においてより大きな役割を果たす。
研究チームはこれをPhase Specialization(位相特化)と呼んでいる。
つまり、モデル内部では一種の分業が形成されているようだ。異なる注意機構のコンポーネントが、圧縮ウィンドウ内の異なる位置に対して選好を持つようになったのである。
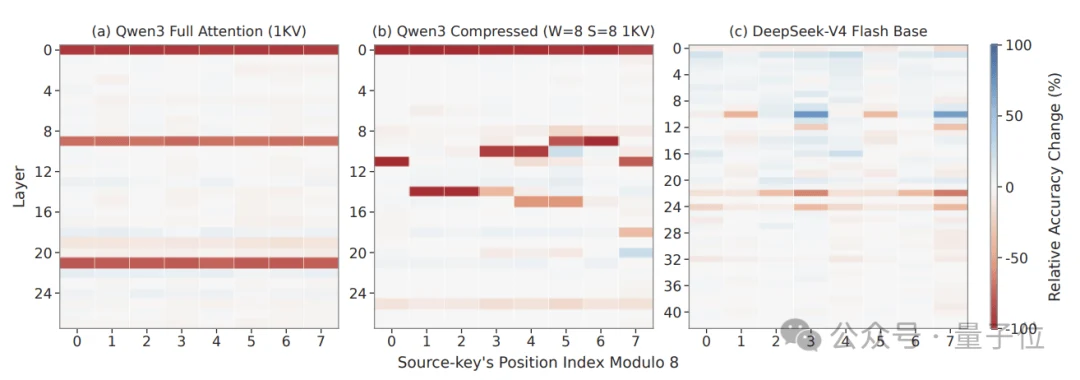
この分業はモデルの情報検索を助ける一方で、特定の位置が比較的弱い部分になる可能性もある。
論文ではさらに、簡略化した理論モデルを用いて訓練過程を分析し、勾配流が圧縮モジュールに安定した位置選好を形成させる可能性があることを発見した。
これにより、この周期性が単なるランダムなノイズではない理由も説明できる。これは、モデルが情報の圧縮方法を学習する過程で自然に形成された結果なのだ。
ただし、この種の問題は通常のBenchmarkからは直接は見えないことがある。常规的な評価では、大量のテスト結果を一つの平均スコアに集約するのが通例だからだ。
モデルがある位置では高い性能を示し、別の位置では明らかに劣ったと仮定しても、最終的に算出される平均成績は依然として良好に見える可能性がある。
そこでSeedチームは、ブロック化KV Cache圧縮を採用したモデルを評価する際には、全体の検索精度を見るだけでは不十分で、同じ情報を異なる圧縮位相に置いてそれぞれ測定する必要があると提案している。
とはいえ、このような位置による性能の偏りが存在するとしても、長文脈推論におけるメモリと計算コストを考えれば、圧縮には依然として非常に現実的な価値がある。
ただし、キャッシュを節約した結果、モデルは異なる位置の情報をこれまでのように平等に扱わなくなる可能性がある。
もちろん、今回の実験結果を見る限り、ポストトレーニングとアーキテクチャの反復改良によって、この差は確かに大幅に縮小できる。
論文URL:https://arxiv.org/pdf/2609.36322