
ジャイからのメッセージ 凹非寺
量子位 | 公式アカウントQbitAI
0.2秒。
これは、ロボットが電子レンジのドアを閉めようとしているとき、突然人間の手が割り込んできて、急停する瞬間のことです。
もっと面白いものがあります。
ケーキの皿の中に金属のペットボトルが混ざっている状態で、電子レンジに持っていくとき、機械アームはまずそのペットボトルを取り出して横に置き、皿の中が安全になったことを確認した後で、それを炉内に入れます。
正直に言うと、これらのデモを見たとき、私は少し呆然とした。
身体を持つことに長く関心している人なら、多くのロボットがかっこいいように見えるが、ほとんどの場合は「問題を解決できない」状態になる。光の条件が変わったり、何かを蹴られたり、あるいは指示に何らかの意図が含まれたりすると、ロボットはすぐに混乱する。
しかし、動画のようにハンドルライトでロボットの目を乱暴に照らしても、それは無視するだけです。。。
しかし、先ほどのその映像は、事前に録画した動作の再生でも、偶然正解した統計的相関性でもない。
連続する突発的な異常に直面して、システムは物理世界の因果法則への理解に基づき、この一連の動作をリアルタイムで推論した。
このロボットを動かすシステムのコード名はCRIS-0です。
その背後には、カリフォルニア大学サンディエゴ校(UCSD)の准教授であり、CMU因果学派の学者である黄碧薇が設立した因果インテリジェンス企業がある。
Aether AI。
3ヶ月前、量子位はこの会社が選んだ因果インテリジェンスの道筋について報じていました。当時、多くの人が因果AIはまだ数学式や思考実験にとどまっていると考えていました。
現在、Aether AIは公式のデモを公開しています。
「まずい」機械への別れ:ロボット学会が因果関係を理解する
ロボットアームの実用化ケースにおいて、エンジニアが悩む最も大きな問題は、標準的なプロセスではなく、至る所に存在する予期せぬ事象である。
伝統的なロボットは、突発的な乱れに直面すると、機械的に古い座標を繰り返すことで衝突が起こるか、あるいは全工程でエラーが発生して動作が停止する。一方、端到端のブラックボックスモデルでは、数十ステップに及ぶ長期的なタスクの中で、蓄積誤差が生じやすく、一歩でも間違えれば全体が崩壊する。
CRIS-0が示す破局解法は、「因果」である——
ロボットに「何を見たか」から、「なぜ起こるのか、何が変わると結果が変わるのか」へと進ませる。
まず成績表を見てみましょう。
外部の突発干渉が発生するコーヒー準備テストにおいて、ロボットがコーヒーマシンを掴む際に人為的な動きや光の変化に遭遇した。CRIS-0は平均2秒以内で因果変数の変化を認識し、リアルタイムで再計画を行い、10回のランダムな干渉の中で9回の有効な回復を実現した。
また、盲目的に全プロセスをやり直すわけではありません。
コーヒーマシーが押し出されると、システムが追跡するのは「ハンドル相対位置」という重要な因果変数です。この変数の状態に変化が見られた場合、システムは近接や把握の動作段階のみを修正します。元の位置に戻って再起動する必要はありません。
抗干渉は基本技術に過ぎず、長距離自主任務においては因果駆動の利点がより明確に現れる。
「リビングでの物探しと整理」という、数十歩に及ぶ連続的なタスクにおいて、システムは長距離の目標を原子化された、検証可能な因果段階に分解し、一歩進むたびに前処理と後処理条件のチェックを行う。
より興味深いのは、CRIS-0が示す常識的な推論と物理的認識能力です:
デスクを片付けるとき、散らばった普通の本はコーヒーテーブルの上に整えられますが、個人情報に関わる請求書は引き出しに入れられます。
見た目が似ている2つの飲料缶に直面したとき、まず掴んで揺らして缶の重さと内部の液体の状態を感じ取り、空の缶であることを確認した後でゴミ箱に投げ込み、飲み干されていない飲料は元の場所にしっかりと戻す。
最後に、不明確な要求に直面した際に、因果はプロンプトの汎用性を大幅に向上させることができ、それによって個別化された理解能力をもたらす。
Personal Pick and Placeテストにおいて、「朝のランニング後に飲む飲料を一本持ってきて」といった20件の推測を必要とする曖昧な指示に対して、システムは18回の正確な掴みと置きの成績を収めた。
それはキーワードを記憶して運を試すのではなく、時間、ユーザーの状態、環境の文脈を組み合わせて、「運動後にエネルギーを補給し、高糖食品を避ける」という隠された因果変数を抽出し、自動的に対応する操作を適用する。
これらのDemoの背後には、一体どのような技術構成があるのか?
CRIS-0の分解:ブラックボックスを因果エンジンに改造する
この質問に答える前に、もう一つの問題を明確にする必要があるかもしれません——
なぜ以前のロボットはいつも「鈍い」と感じられたのか?
物理世界と純粋なデジタル世界は全く異なります。コンピュータでコードを書いたりチャットしたりして、間違いがあったら撤回することもできますが、現実世界では摩擦力、重力、衝突、光の変化など、様々な突発事象が毎秒起こっています。
伝統的なエンドツーエンドモデル、例えばVLAプログラムのように、学習が速いものの、長いプロセスを伴うタスクに対しては致命的な弱点があります。それは誤差の蓄積です。
第1ステップは少し偏差が小さく、第2ステップでは偏差が大きくなり、第10ステップになると、全体の動作が完全に変形してしまう可能性があります。さらに悪いことに、単一のブラックボックスモデルは干渉が起こったとき、何が起こったのかわからず、やむを得ず元の計画通りに押し続けるか、直接クラッシュして停止するしかありません。
また、別の一般的なエージェントアプローチでは、手順を分解するものの、その思考ロジックは基本的に純粋なテキストや多モーダル大模型の確率推論に留まっています。
環境が変わるたびに、まず画面をテキストに変換しなければならない。モデルがゆっくりと「次に何をすべきか」を考えている間に、あなたが推理を終えた頃には、手がもうドアに挟まれてしまっているかもしれない。。。
CRIS-0が示すこの抗干渉性と連続性は、実際にはどのように実現されているのか?
Aether AIは新しい論理システムを開発しました:
因果原生的エージェントアーキテクチャ。
3つの次元から理解することができる——
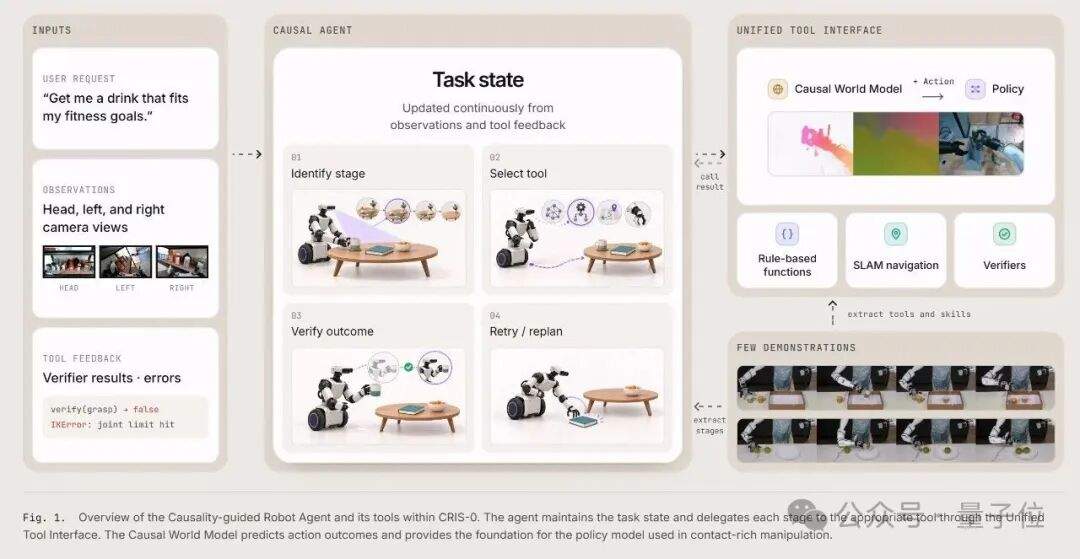
1. タスク即状態:物理的因果変数の抽出
これが私が最も重要だと思う第一原理です。
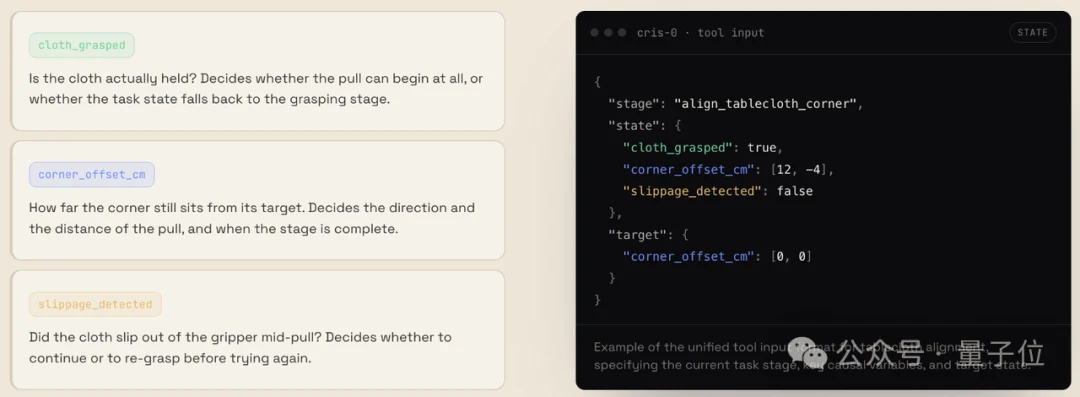
CRIS-0のシステムには、非常に基本的な変更があり、それは「統一状態と因果変数」というものです。
以前のロボットは世界を、密集した画像ピクセルで見ていました。しかしCRIS-0にとっては、世界の表面がどのような形をしているかではなく、タスクがどの段階にあるかが重要です。タスク自体が因果状態の進捗バーなのです。
特に身近な例として、ロボットがテーブルクロスを広げるというものです。
それは、テーブルクロスの各ピクセルの座標を愚かに計算するのではなく、いくつかの重要な因果変数をリアルタイムで追跡する。例えば、テーブルクロスがクランプ爪に本当に掴まれているか、角点が目標位置から何センチ離れているか、引っ張る際に滑りが起きていないかなどである。
一度捕獲が滑り落ちた場合、システムは「捕獲」という因果変数が満足されないことを即座に認識し、タスクの状態は直接再捕獲の段階に戻る。全体的な動作をやり直すことも、無造作に空気を引き延ばすこともしない。
公式に公表されたコーヒー製造妨害テストにおいて、コーヒーマシンが繰り返し位置を変え、光の強度が変わるという厳しい状況に対して、システムは平均2秒以内に重要な変数の変化を認識し、再計画を実行することができた。10回の外部干渉の中で9回にわたって正常な状態への回復が達成された。
これが因果変数の力です。予期せぬ事態が起きたとき、どのステップで間違いがあったか、どのステップに戻るべきかを明確に把握します。
2. 統一ツールインターフェース:単一の戦略パッケージによる全てを扱うことを拒否する
そのシステムは具体的にActionをどのように実行するのか?
答えは:Tool Callで、異なるツールがそれぞれの役割を果たします。
その構造において、全体のスケジュールを担当するPlannerが存在し、機能完備のツールキットを管理しており、Unified Tool Interfaceを通じて様々なモジュールを統合している。
ルールベースの機能:視覚位置決めと逆運動学を組み合わせて、広範囲な空間移動と予定位置決めを効率的に処理する。
スキル戦略モデル(Policy models):倒水、精密な掴みなどの難易度の高い接触型操作を得意とする。
ナビゲーションモジュール(SLAM):全体の経路指示を担当する;
検証者(Verifiers):各段階ノードで物理的な検査を実行する;
因果世界モデル(CausalWM):動作がもたらす物理的結果を推測する役割を担う。
その中で最も核心的な武器というのは、この因果世界モデルである。
多くの友人が世界モデルについて話すとき、最初に思い浮かぶのは、未来数秒間のリアルな動画を生成することです。しかし、CRIS-0内のCausalWMは、アクションが環境に与える影響により重点を置いています。
その論理は、まず現在の状態を見てから、候補となる動作がどの因果変数に変化をもたらすかを予測し、最後に将来の状態を導き出すというものです。
言い換えれば、ロボットは手を伸ばす前に、頭の中でシミュレーションをしています。例えば、このようにすると、手が曲がるか?カップが倒れるか?
「リハーサル」のステップが一つ追加されることになり、システムは世界モデル上で「動作Bを実行した場合、物理的因果変数はどのように変化するか」を推測します。目標が達成できることを確認した後、Action Headを呼び出し、最下層の制御を出力します。
3. 構造化ループと生のセキュリティ内蔵
そして、これらすべてが、ループの中で絶えず繰り返される。
複雑なタスクに直面した時、Plannerは大きな目標を小さな部分に分解し、まずルール関数を呼び出してクランプを目標の近くに迅速に移動させ、次に戦略モデルを呼び出して精密な接触と掴みを実行する。元々一つのモデルで全体を完遂するのが難しい複雑な問題も、確実性が非常に高いいくつかの小さなステップに分けられる。
具体的には、このような動的な進化するタスクグラフです:状態認識 → ツール選択 → 実行 → 検証 → 調整。
一歩を完了するたびに、検証器は直ちに物理的条件が満たされているかをチェックします。満たされていない場合、システムには明確な三段階の復元メカニズムがあり、この段階で直接再試行できるかどうかを判断します。できない場合は新たなパスを計画し、それでもダメなら人間の介入が必要であることを示します。
一度何らかの予期せぬ調整が成功した場合、その成功の回復パスはタスク図に記録され、沈殿してしまいます。次に同様の状況に遭遇すると、より習熟するようになります。
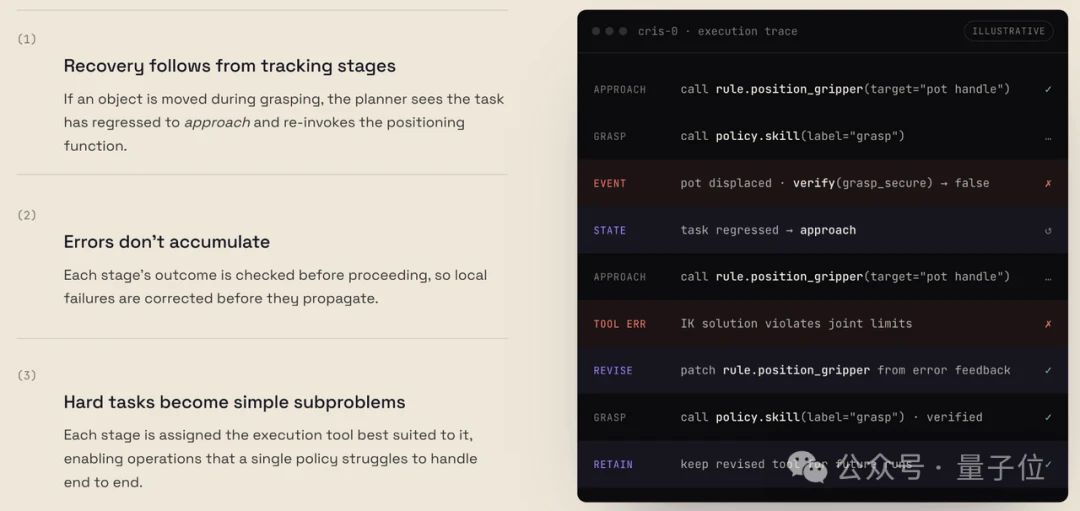
これが、そのリビングルームの長期整理作業において、数十段や百段ものステップを連続して実行しながらもクラッシュしない理由を説明している。
それは一歩進むたびに因果状態を確認するためで、間違いは発生した瞬間にその場で解消されるため、雪だるま式に全体が崩壊するという機会は全くない。
同様に、これが0.2秒の安全な急制動を実現できる理由でもあります。
CRIS-0では、安全判断は各因果ステージに直接組み込まれている。
閉店の段階で、突然現れる人員はユーザーの安全条件を破壊する危険な要因であり、システムは状態レベルで即座に捕捉し、最優先のブロックを実行し、0.2秒で停止する。
しかし、現在の課題が人間に水を渡すことである場合、差し出される手が相互作用の目的変数となり、システムは混乱することはない。
実際に、CRIS-0が示すこのシステムレベルの能力は、何もかもが突然生まれたものではなく、しっかりした研究基盤があるからこそ成し遂げられている。
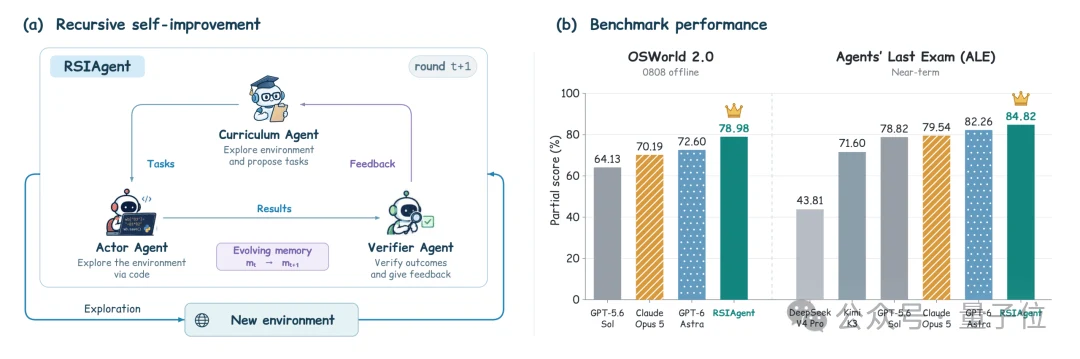
エージェント能力評価において、以前Aether AIの因果インテリジェントアークフレームワークRSIAgentはOSWorld 2.0上で78.98%のPartial Scoreを獲得しました。モデルパラメータを更新せずに、オープンソースモデルのエージェント能力を向上させ、GPT-6 Astraなどのクローズドソースモデルを超える結果となりました。
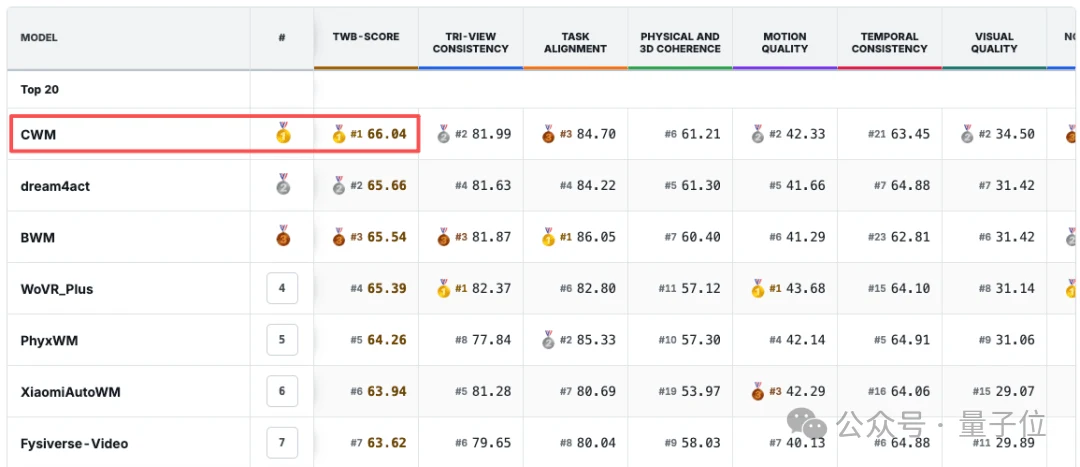
その第一版因果世界モデルCausalWMも、ロボット世界モデル基準のTriWorldBenchでリーダーボードのトップ1を獲得しました。
そして、これら二層は、今回のデモの主要な貢献者です。
また、2つのプロセスも継続的に推進されている――モジュール化神経アーキテクチャ:各モジュールは異なる因果メカニズムに対応し、組み合わせや交換が可能である;Causation Transformer:統計的依存関係ではなく因果関係を学習する。
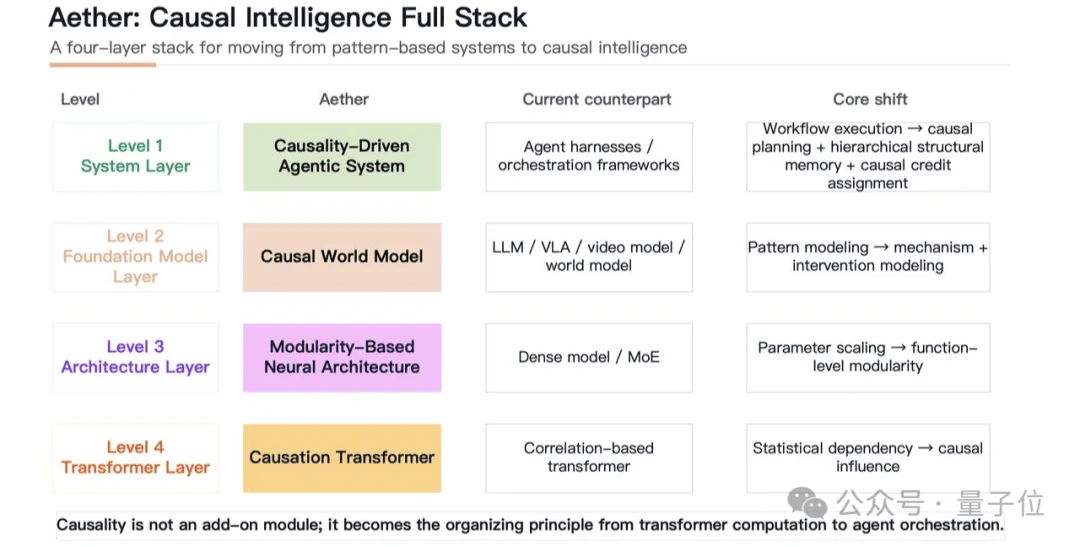
物理世界は暗記だけでは信じない
ここまで話したが、実際には具体的なロボットデモから離れて、もっと深いところを見てみることができる。
なぜ今、皆が因果知能についてますます頻繁に話すようになったのか?
率直に言って、過去の大規模言語モデルのブレイクは、大きな部分で実際には運が良かったものです。言語自体は、人間によって高度に記号化され、高度に抽象化されたモダリティです。多くの論理や法則は、もともと人間がテキストの表面にまとめているものです。直接、確率関連性の統計的フィッティングによって奇跡を起こすだけです。
しかし、物理的な世界はこの方法では通用しない。
摩擦力は、十万篇の論文を読んだからといって変わることはない。重力も、確率統計によって突然消え去るわけではない。複雑で動的な現実世界において、表面的な相関性に頼った単純なフィッティングでは、いずれスケーリング法則の限界にぶつかることになる。
物理データが著しく不足している状況で、複雑な物理環境に対応できる真のシステムを作り出すためには、モデルは人間の科学者と同じように、わずかなデータから根本的な因果メカニズムを抽出し、行動が世界にどのような変化をもたらすかを理解する能力を持つ必要がある。
「因果」の第一性原理構造で構成されたこの圧縮形式こそが、具身原生のスケーリング法則なのかもしれない。
もちろん、この道は非常に難しいです。因果の発見や因果表現学習に対する数学および統計理論の要求は非常に高く、世界的に実際に深い理論的蓄積と工学実装の能力を兼ね備えたチームはほとんどありません。
エーテルAIが参入したのは、大きくはその独特の学術的背景に関係しているのでしょう。
黄碧薇はこの分野で十数年間にわたり深く研究してきました。CMUの因果学派の創始者であるClark GlymourやPeter Spirtes、第二世代の学者であるBernhard SchölkopfおよびKun Zhangから学び、因果発見学派の核心的な後継者の一人です。
三代因果学派の理論の流れは、最終的に今日のAether AIの基礎技術の支柱となっている。
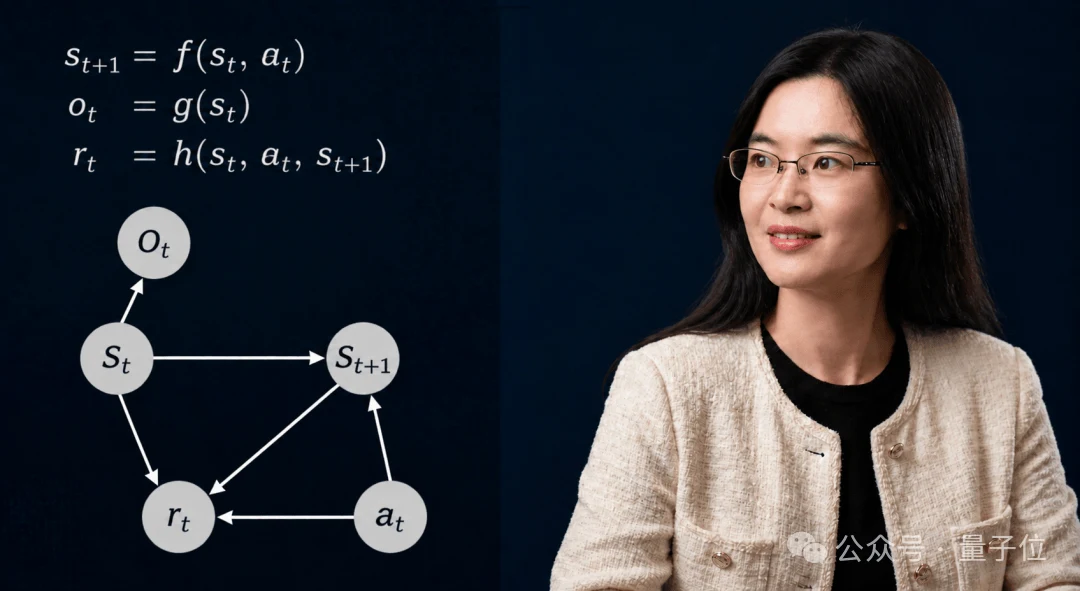
カーネギー・メロン大学とマプリオット研究所の理論的蓄積から、現在のCRIS-0が実際の機械手で具現化されたことまで、因果知能はついに物理世界へ向かう重要な一歩を踏み出した。
システムが因果変数を抽出し、世界の動力学をモデル化し、行動前に結果を推測する能力を持つようになったとき、その活用範囲は単に電子レンジをつけたりコーヒーを注いだりすることだけではない。
もっと遠くを見ること、複雑な動的システムのトレンド予測から、材料や生命科学などの分野での科学的発見に至るまで、この論理を活用できるかもしれない。
大時代よ、友達たち。
私たちは、AIが単なる数字のチャットボックスから脱却し、真実で複雑で未知に満ちた物理世界においてしっかりと立ち位置を確保することを心待ちにしています。
そして因果、おそらくそれが最も重要な鍵なのだ。
— 完 —
量子位 QbitAI · 頭条号契約
フォローしてください。最先端の技術動向を第一に知ることができます