
デモ用のAIエージェントを構築することと、 4,000万人の開発者 向けにエージェントを運用することは、異なるエンジニアリングの課題です。Postmanは、 Agent Modeの構築に取り組みました。これは、 APIテスト, ドキュメンテーション、ディスカバリー、実装にわたってAIネイティブな方法で作業するためのものです。チームは、モデルの品質とプロンプト設計が最も難しい問題になると想定していました。しかし、より深い課題は、長年のインターフェース主導の前提、広範なサーフェスエリア、そして専門的な概念を持つ成熟した製品にエージェントを統合することから生まれました。
本記事では、成熟した製品をAIエージェントにとって理解しやすいものにする過程で生まれたアーキテクチャパターンについて、PostmanとAWSが説明します。これらのパターンには、ツールの乱造の制御、スキーマベースの読み取りの公開、そして能力ではなくコンテキストを主要なボトルネックとして扱うことが含まれます。
さらに、 Agent Mode が Amazon Bedrock をどのように使用して、モデルの柔軟性、地理的にスコープを限定したクロスリージョン推論、モデル依存のゼロデータ保持、そしてマルチティアのプロンプトキャッシングを実現しているかを説明します。これらの教訓は、本番環境のエージェントをプロトタイプから先へ進めるのに役立ちます。
PostmanがAgent Modeを構築した理由
Agent Mode は、テスト、ドキュメンテーション、ディスカバリー、実装にわたってAIネイティブな方法で製品を操作するためのPostmanのポータルです。Postmanは11年にわたって進化を続け、開発者やユーザーはサイドバーの展開、タブの確認、リクエストのオープンなど、インターフェースを通じて情報を見つけることを学んできました。その認識をエージェント向けに再設計する過程で、製品のAPI、ユーザーエクスペリエンス、そして製品知識の分布における構造的な前提が明らかになりました。エージェントは画面を操作するのではなく、データに基づいて推論します。図1は、Agent Modeがアプリケーションに直接作用する仕組みを示しています。
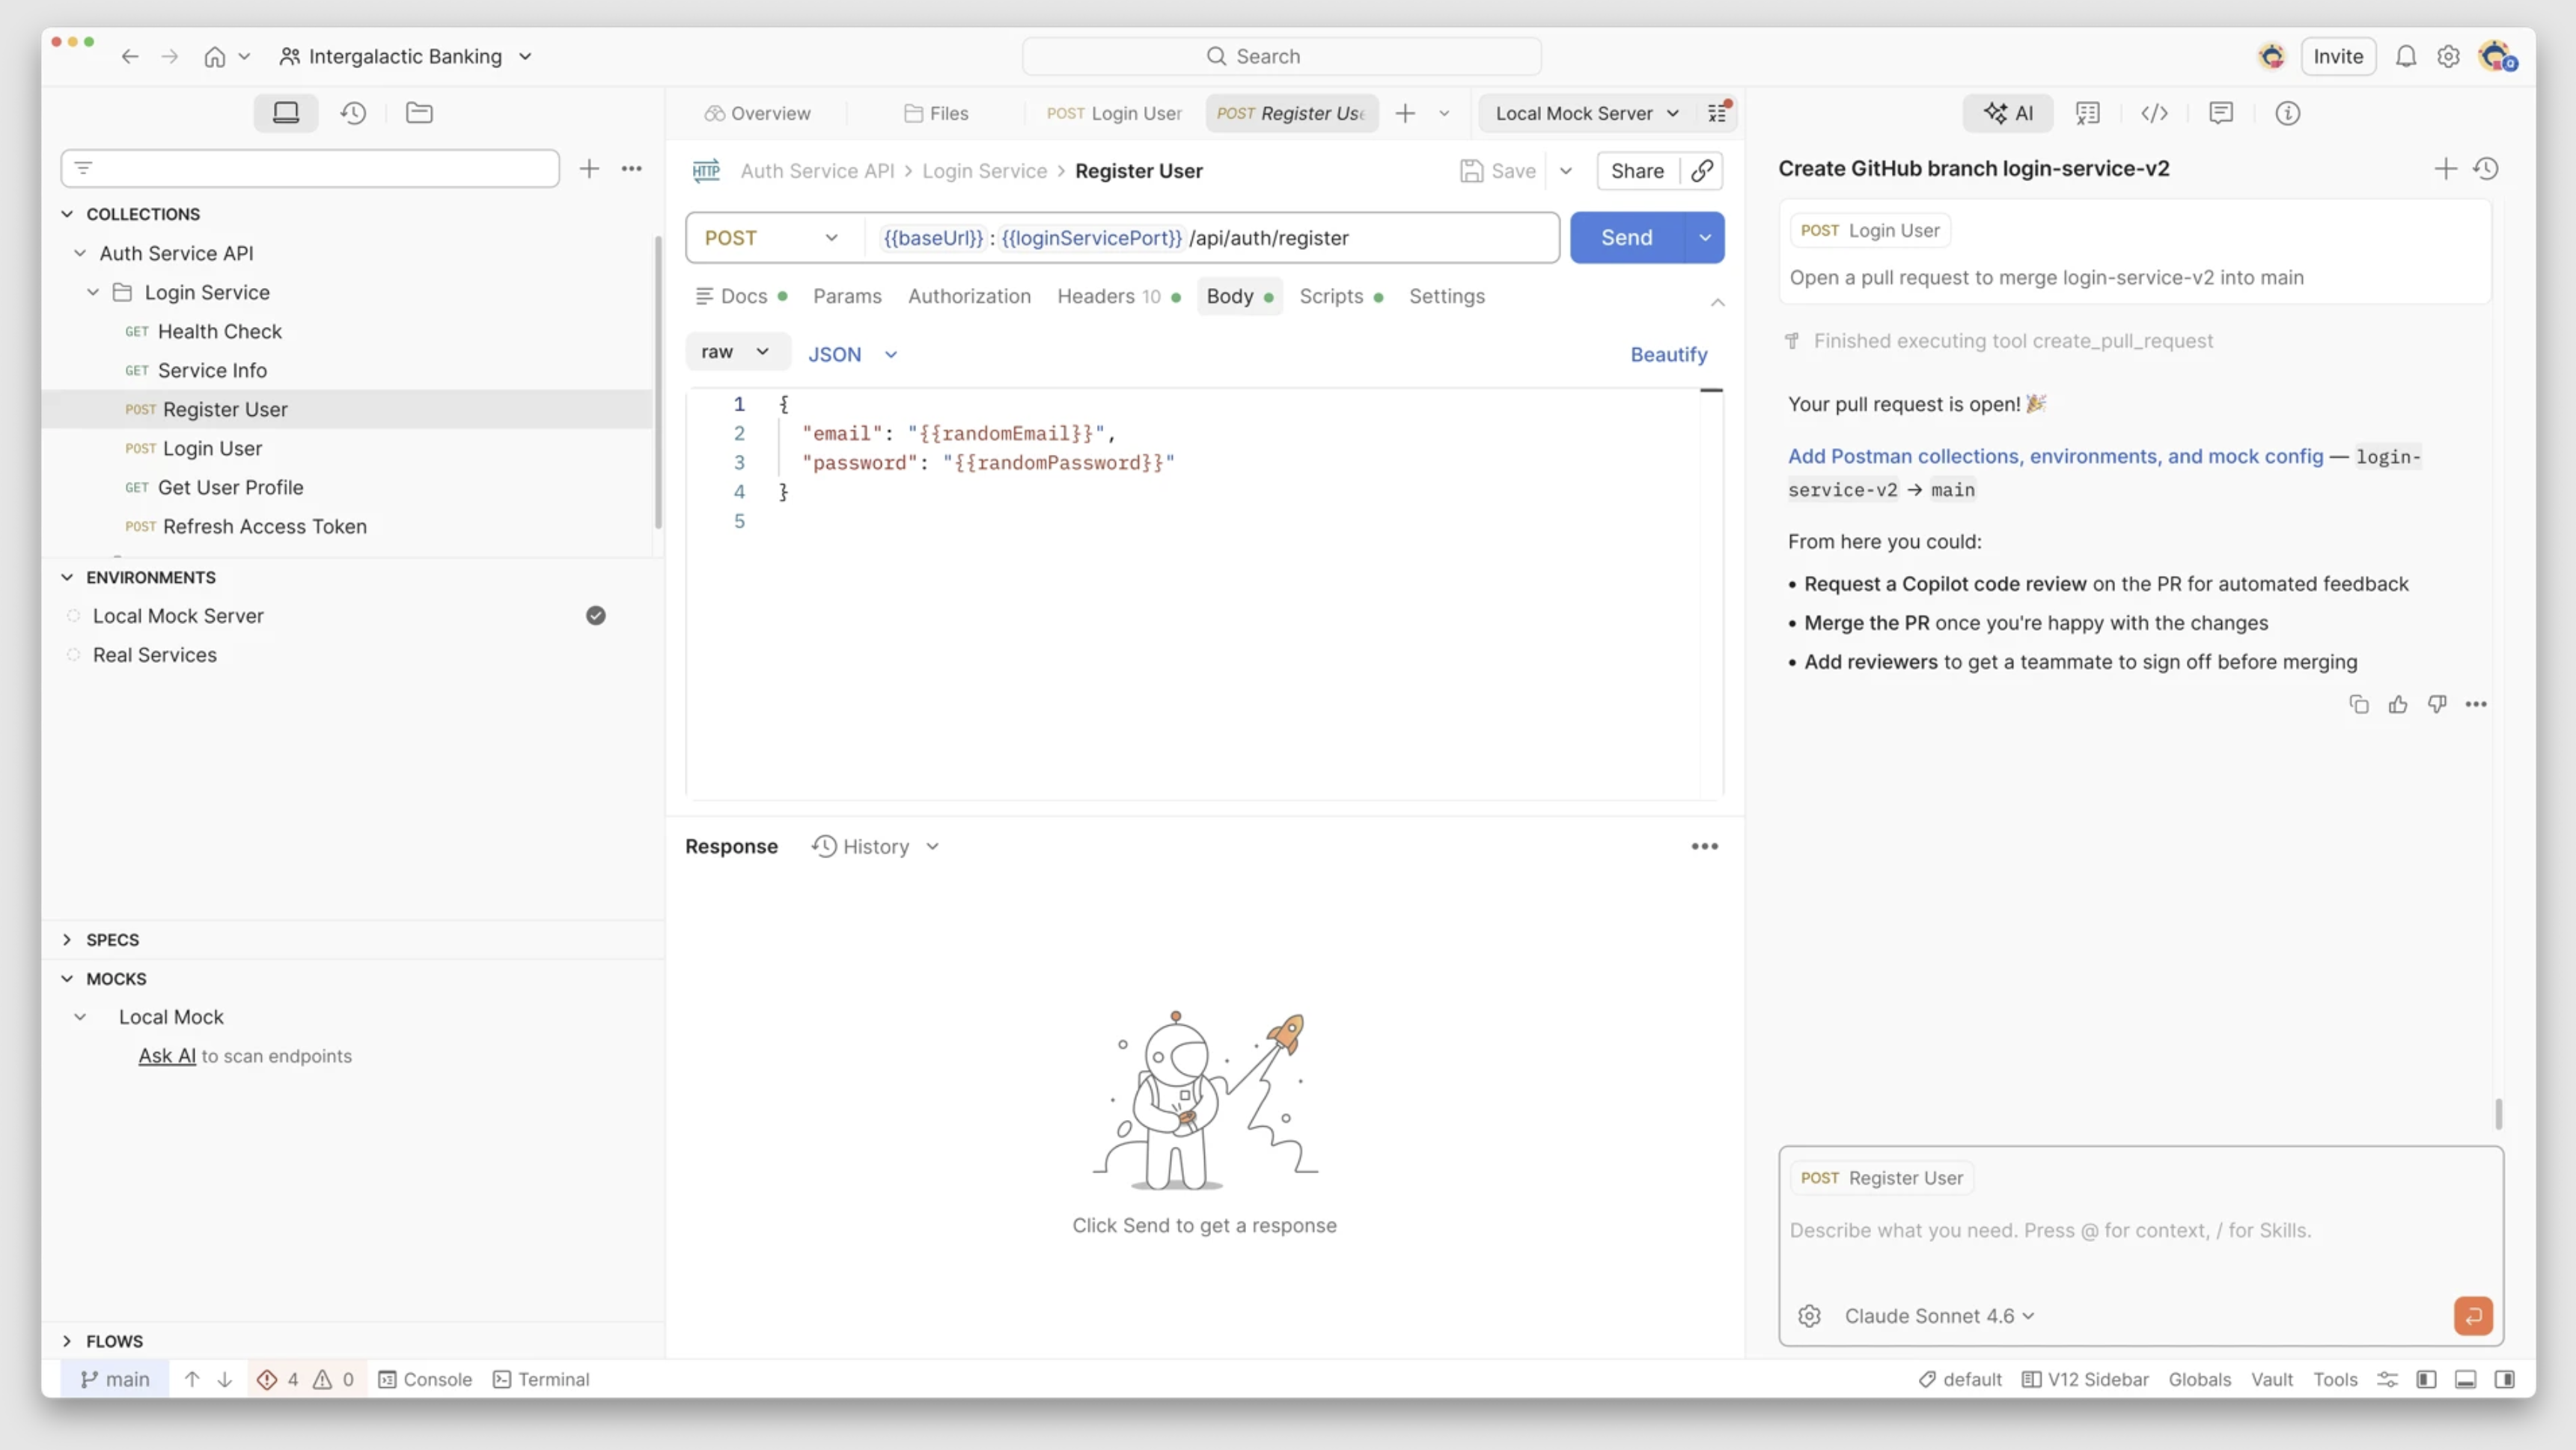
図1: Agent ModeはPostmanアプリケーションに直接作用します。この例では、ユーザーがインターフェースを操作しなくても、プルリクエストを開き、次のステップを提案します
Agent Mode は Amazon Bedrock上で動作し、エージェントの背後にある基盤モデルへのマネージドアクセスを提供します。Postmanのグローバルな開発者コミュニティを支えることは、鋭いトラフィックの急増を伴う、変動的でレイテンシーに敏感な需要を生み出します。Amazon Bedrockにより、Postmanはモデル選択の柔軟性を保ちながら、スループット、地理的な処理、コストを管理しつつ、独自のモデルサービングインフラを運用することなくこの本番ワークロードをスケールできます。図2は本番アーキテクチャの概要を示しており、以降のセクションでその各構成要素を詳しく見ていきます。
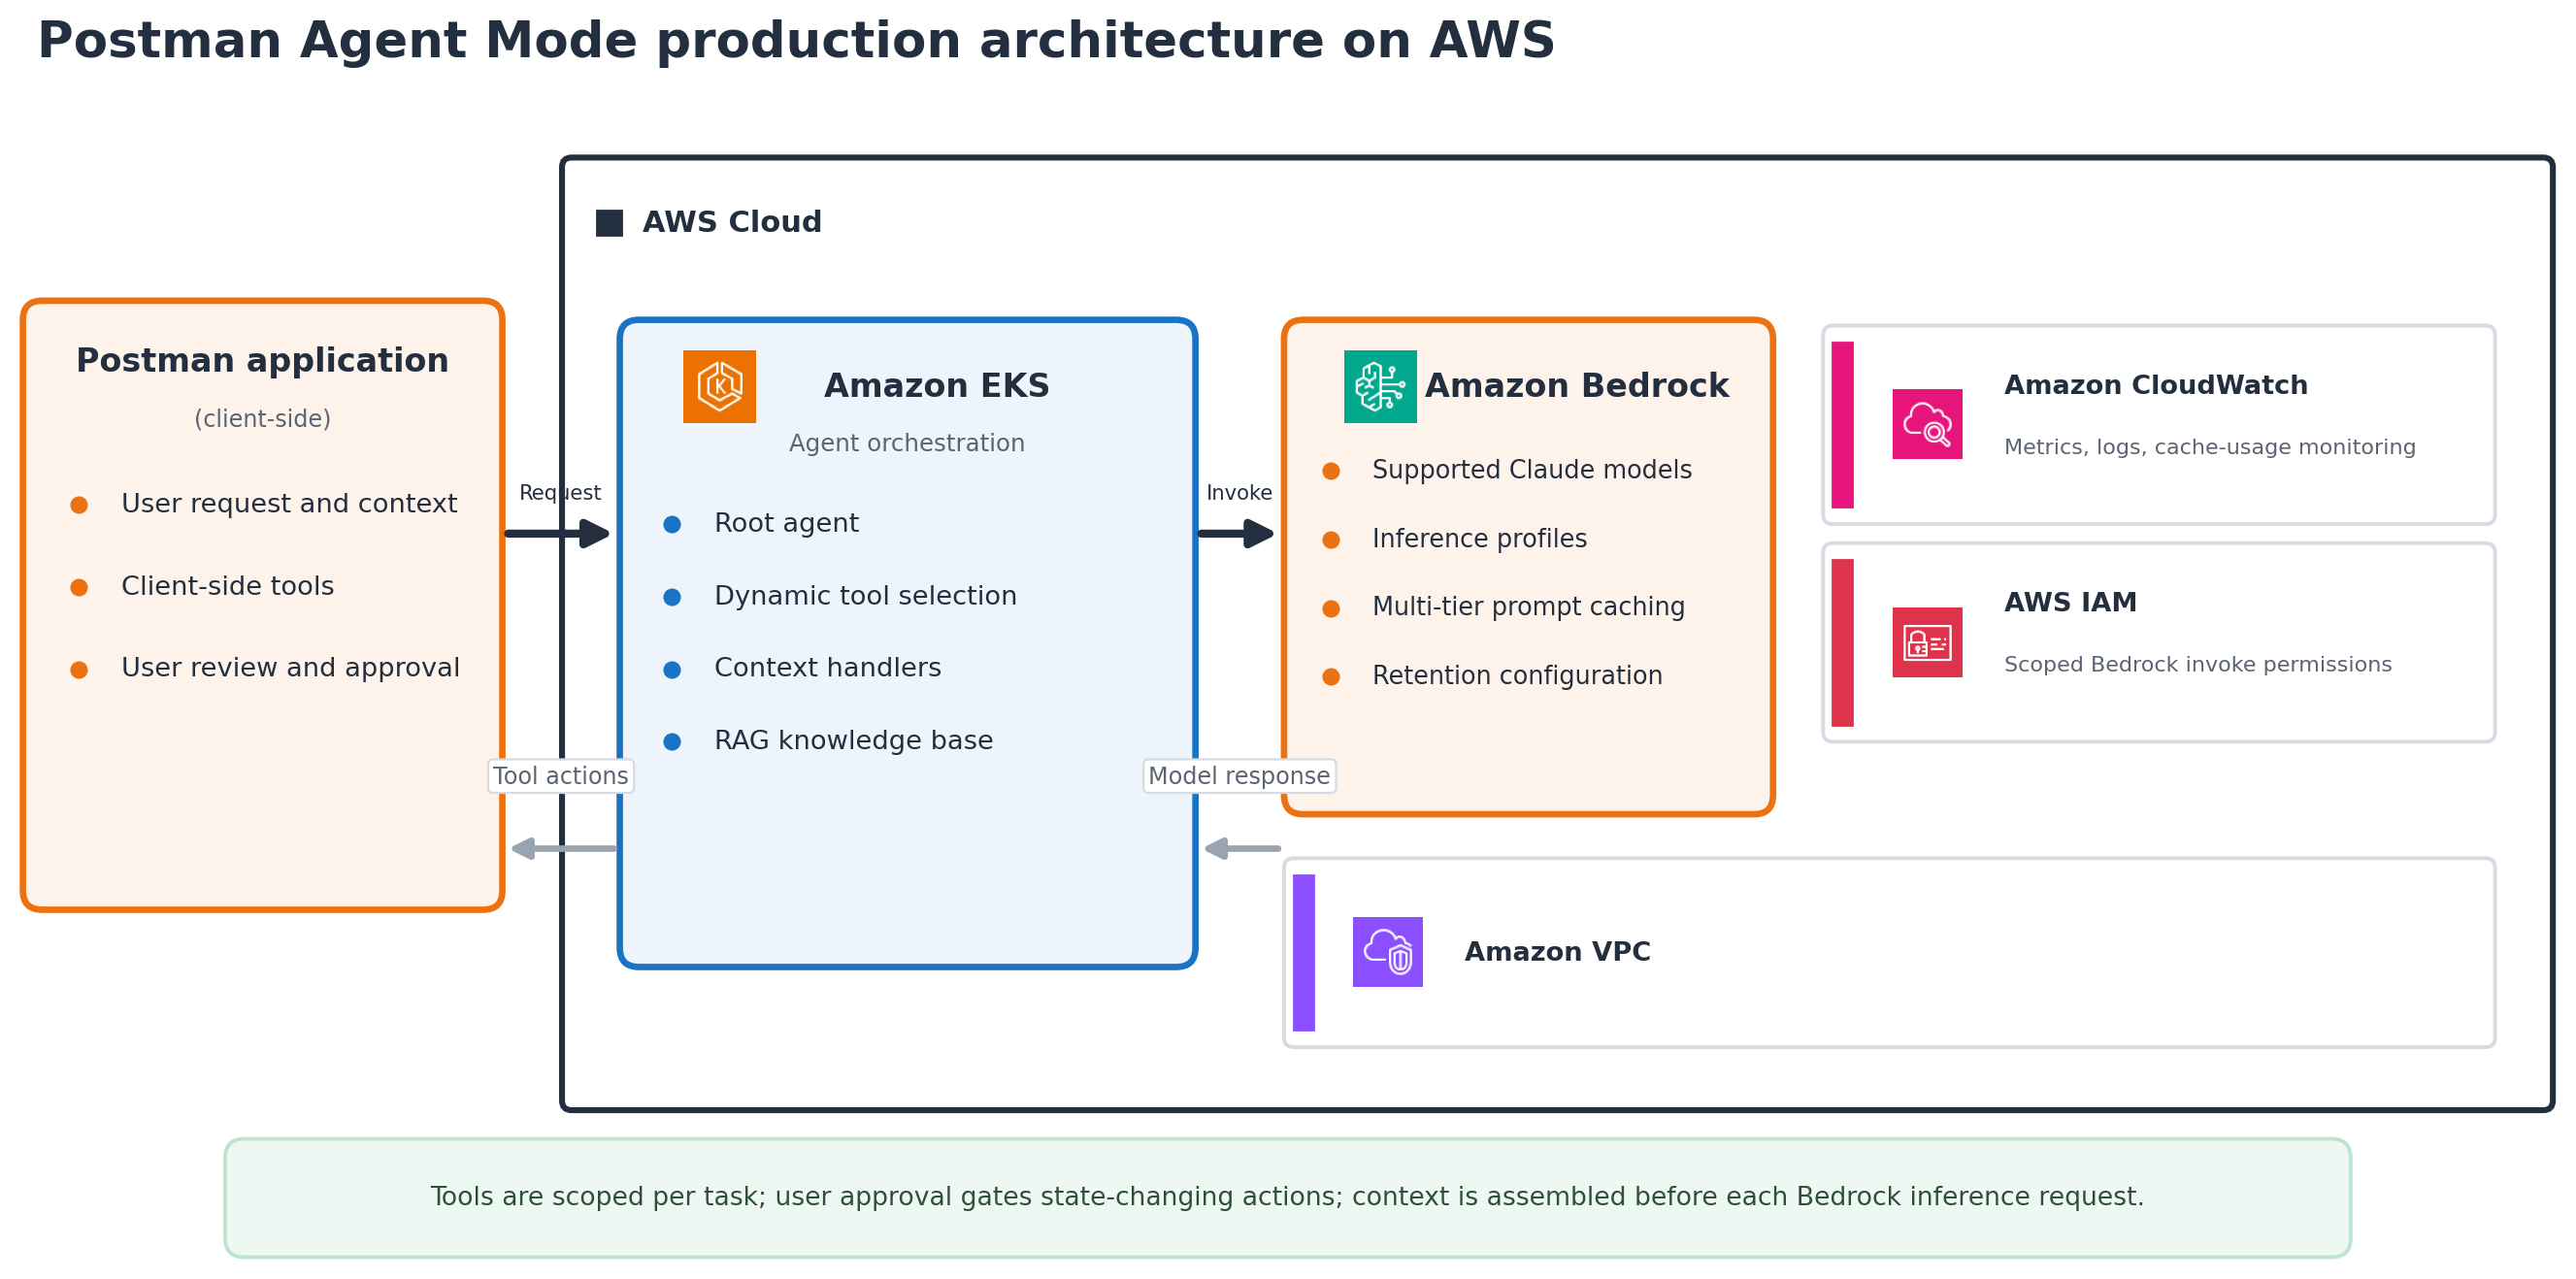
図2: Postman Agent Modeは、クライアントサイドツール、エージェントオーケストレーション、目的別に構築されたコンテキスト、そしてAmazon Bedrockのモデル推論を組み合わせています。ツールは各タスクにスコープされ、アプリケーションの状態を変更するアクションにはユーザーの承認が含まれます
人間による監視は本番設計の一部です。Agent Modeは、アプリケーションの状態を変更するアクションの前にユーザーの承認を必要とします。Postmanはまた、利用可能なツールをタスクにスコープし、目的別に構築されたコンテキストを選択し、モデル依存のデータ保持設定を適用します。これらの制御により、意図しないアクションや不必要なデータ露出を削減できますが、本番テストとモニタリングは引き続き必要です。責任あるAIの制御として、Postmanは Amazon Bedrock Guardrails を使用して、個人を特定できる情報(PII)が基盤の大規模言語モデル(LLM)に到達する前にマスキングします。エンタープライズ管理者は、Agent Modeのガードレール設定でこれを有効にできます。
ツールの乱造への対応
Agent Modeでは、ツールがエージェントがPostman内でどのように行動するかを定義します。初期の段階で、チームは高度にアトミックなツール、すなわちリクエストのオープン、1つのフィールドの更新、特定のメタデータの取得といった小さく精密なアクションを指向しました。このアプローチは初期のイテレーションでは正確性と制御を支えましたが、いくつかの問題も明らかになりました。
多くの実際のワークフローは、長いツール呼び出しのシーケンスを必要とします。各ステップが高速であっても、次のアクションを開始する前にすべてのアクションがモデルに戻る必要があったため、全体的なエクスペリエンスは遅く感じられました。ユーザーは、心の中では1つの操作としてグループ化していたアクションを、エージェントが一歩一歩実行するのを見ていました。
Postmanのテストでは、表示されるツールセットが約40ツールを超えると、ツール選択のエラーが増加しました。エージェントは存在しないツールを呼び出したり、スキーマが有効であるにもかかわらず誤った引数を渡したり、意味的には合理的に見えるが文脈的には間違っているツールを選択したりしました。より大型または新しいモデルではこの挙動は減少しましたが、解消はされませんでした。
ツールセットのサイズが一定の規模を超えると、ツールをさらに公開することでエージェントの効果が低下しえます。現在のアーキテクチャは、必要性と文脈に基づいてツールを選択し、個々の実行スレッドを分離します。モデルには現在のタスクに関連するツールのみが見えます。図3はこの動的選択プロセスを示しています。
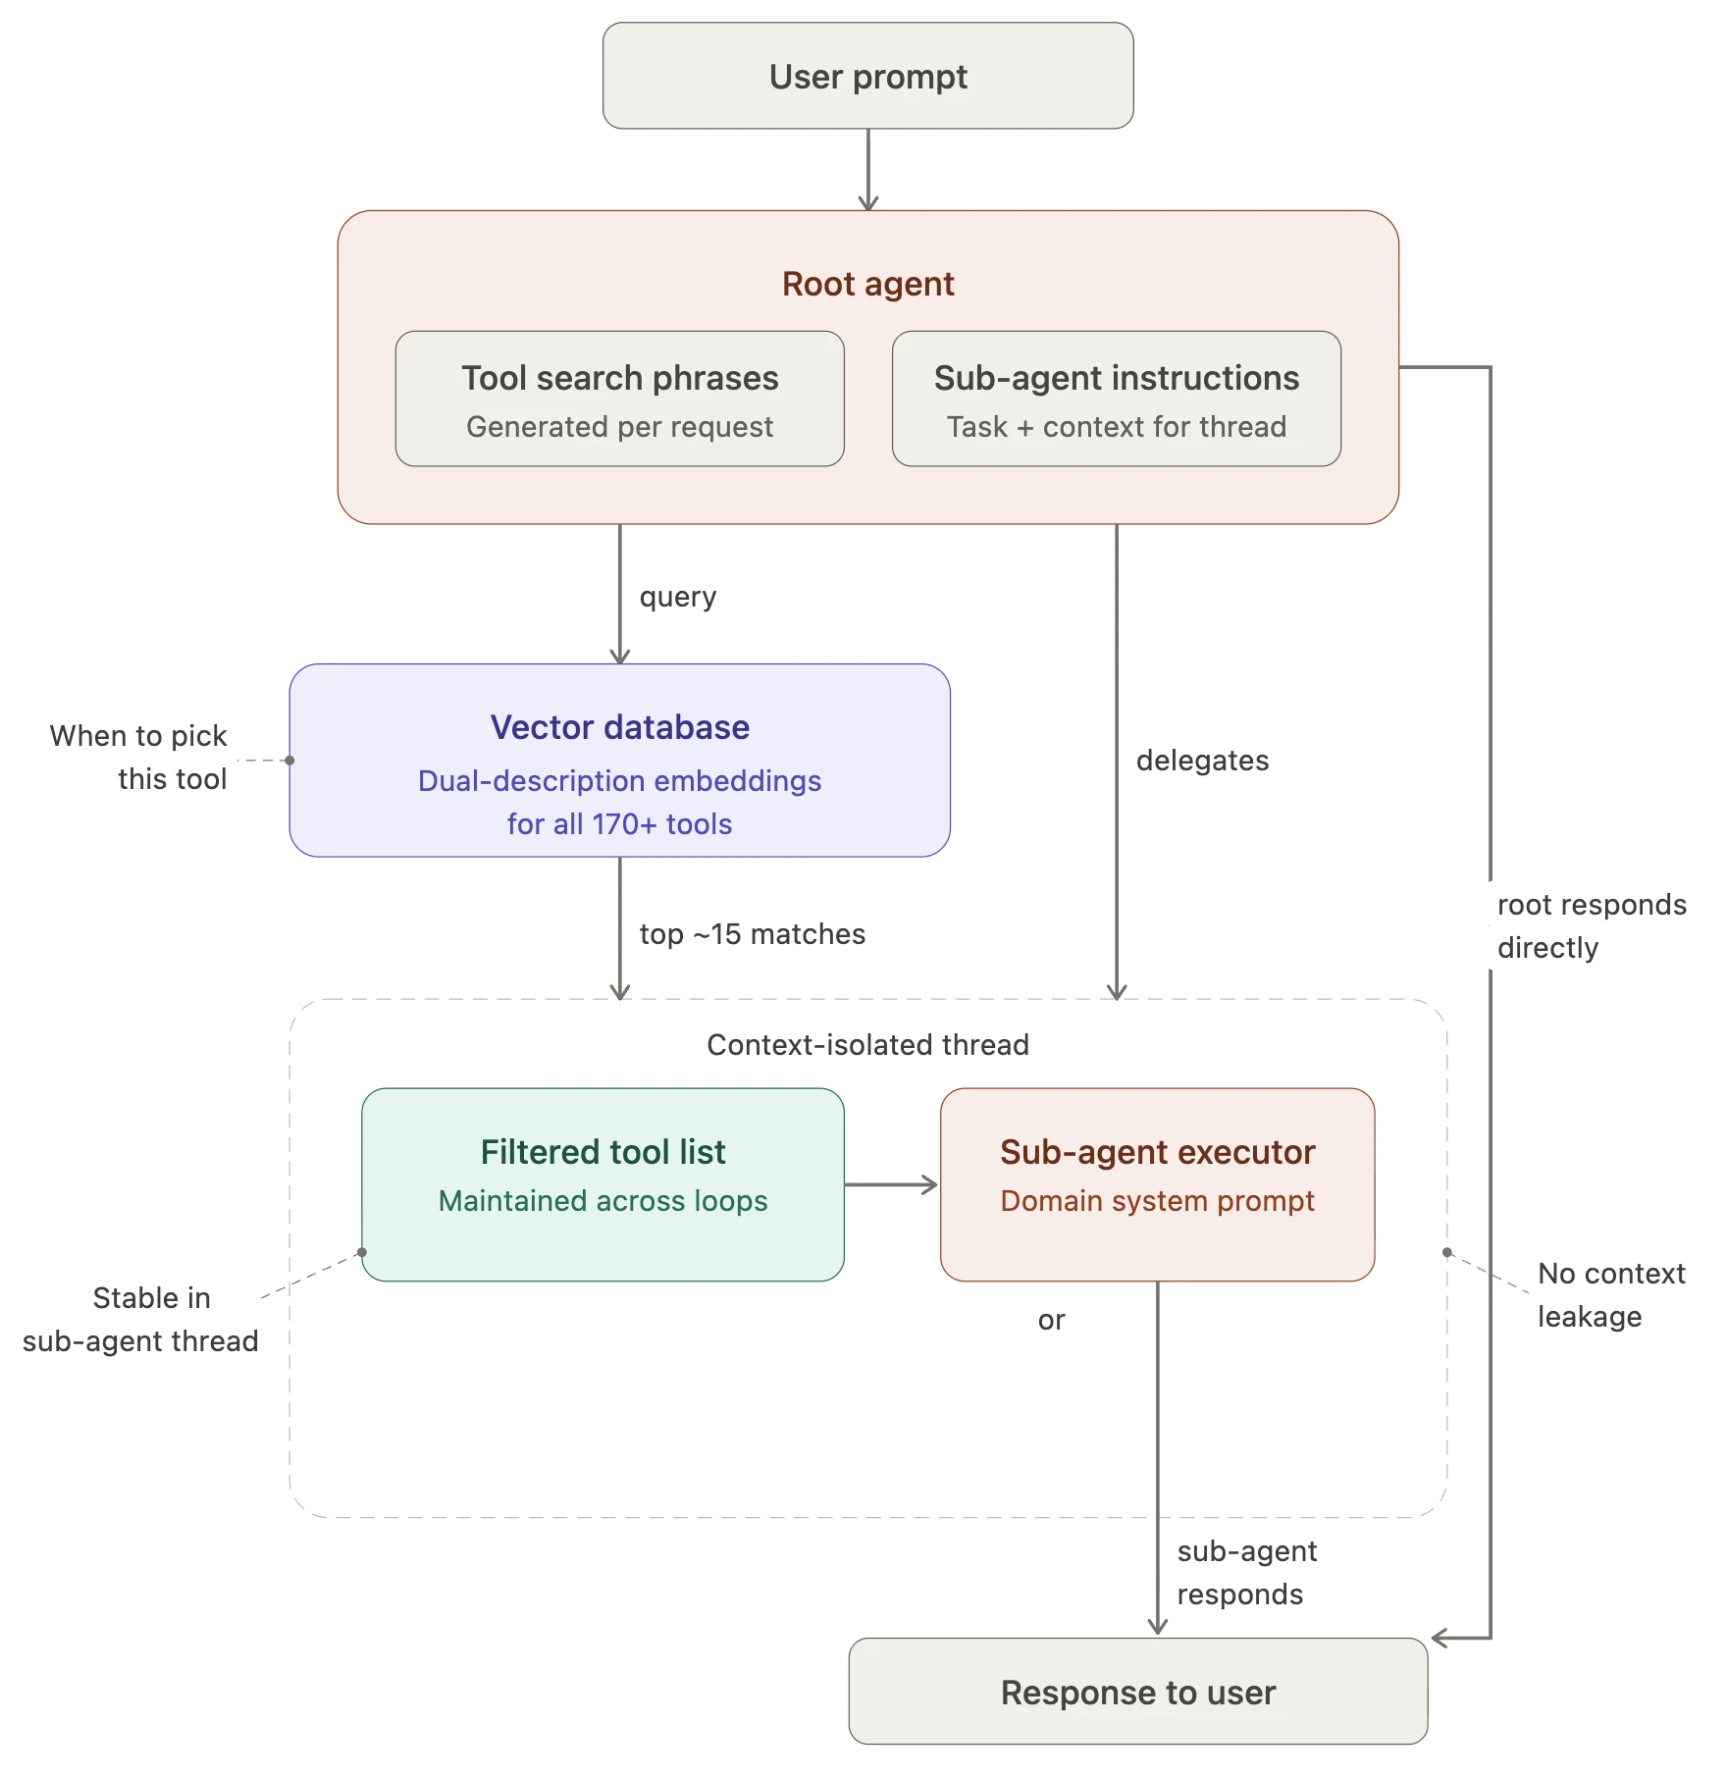
図3: ルートエージェントがツール埋め込みのベクターデータベースに問い合わせ、170以上のツールをリクエストに関連する約15ツールに絞り込みます。その後、それらのツールをコンテキスト分離されたサブエージェントに渡すため、モデルにはタスクに必要なツールのみが見えます
より微妙な問題は、多くのクライアントAPIがインターフェースの状態に暗黙的に結合していたことでした。リクエストを変更するツールは特定の要素が開いていることを必要とし、他のツールは副作用として新しいタブを開きました。エージェントはリクエストを読むためにリクエストタブを開く必要があり、データについて推論する代わりにインターフェース操作を模倣していました。Postmanはツールをタブから積極的に切り離しており、その ネイティブGit 機能はこのアプローチを広く活用しています。例えば、 Agent Mode は現在、開いたタブなしでバックグラウンドでリクエストを送信できますが、ユーザーの承認は引き続き必要です。
ビルダーへの要点: ツールカタログをコンテキストバジェットの一部として扱いましょう。タスクごとにモデルに公開するツールを動的にスコープし、「エージェントができること」を「UIがたまたま開いていること」から切り離しましょう。
スキーマベースの読み取りの公開
API Catalogなどの製品について、Postmanは複数の狭いビューを単一のクエリツールに統合しました。これらの製品は、多くのサービスにわたるサービスの稼働時間、テスト結果、エンドポイントの応答時間といった構造化データを公開しています。
基盤となるClickHouseテーブルのスキーマが与えられれば、エージェントはJOINやWHERE句を含む複雑なクエリを生成できます。これにより、分析の質問に答えるために必要な個別のツールの数が大幅に削減されます:
SELECT toString(service_id) AS service_id,
    countMerge(total_events_state) AS total_requests,
    countMerge(error_events_state) AS total_errors,
    round(countMerge(error_events_state) * 100.0
        / countMerge(total_events_state), 4) AS error_rate_pct,
    avgMerge(avg_latency_state) AS avg_latency_ms,
    quantileMerge(0.95)(p95_latency_state) AS p95_latency_ms
FROM http_events_summary_1d
WHERE service_id IN ('...list of service IDs')
    AND bucket_1d >= today() - 7
GROUP BY service_id
HAVING p95_latency_ms < 100
    AND total_requests > 0
ORDER BY error_rate_pct DESC;
このアプローチにより、エンジニアリングの仕事は 質問ごとにツールを作ること から データを一度うまくモデリングすることへと移行します。その後、エージェントはチームが個別のツールとして列挙できる範囲をはるかに超えた多様なクエリを生成できます。
ビルダーへの要点: well-structuredなデータがある場所では、単一用途の読み取りツールを乱造する代わりに、クエリエンジンへのスキーマ対応の読み取りアクセスをエージェントに与えましょう。ツール数をデータモデリングと引き換えにすることで、より優れたスケーリング曲線が得られます。
本当のボトルネックはコンテキストだった
Postmanは当初、 ツール の欠如が最大の障害になると想定していました。実際には、 コンテキスト の欠如または不完全さが、機能の欠失よりも多くの失敗を引き起こしました。
コンテキストとは、ユーザーがPostmanのどこにいるか、どのエンティティがアクティブか、どの状態がすでに確立されているかについてのエージェントの理解です。そのコンテキストが誤っていたり存在しなかったりすると、正しいツールでさえ効果を発揮できませんでした。図4は、エージェントに供給される2種類のコンテキストを区別しています。
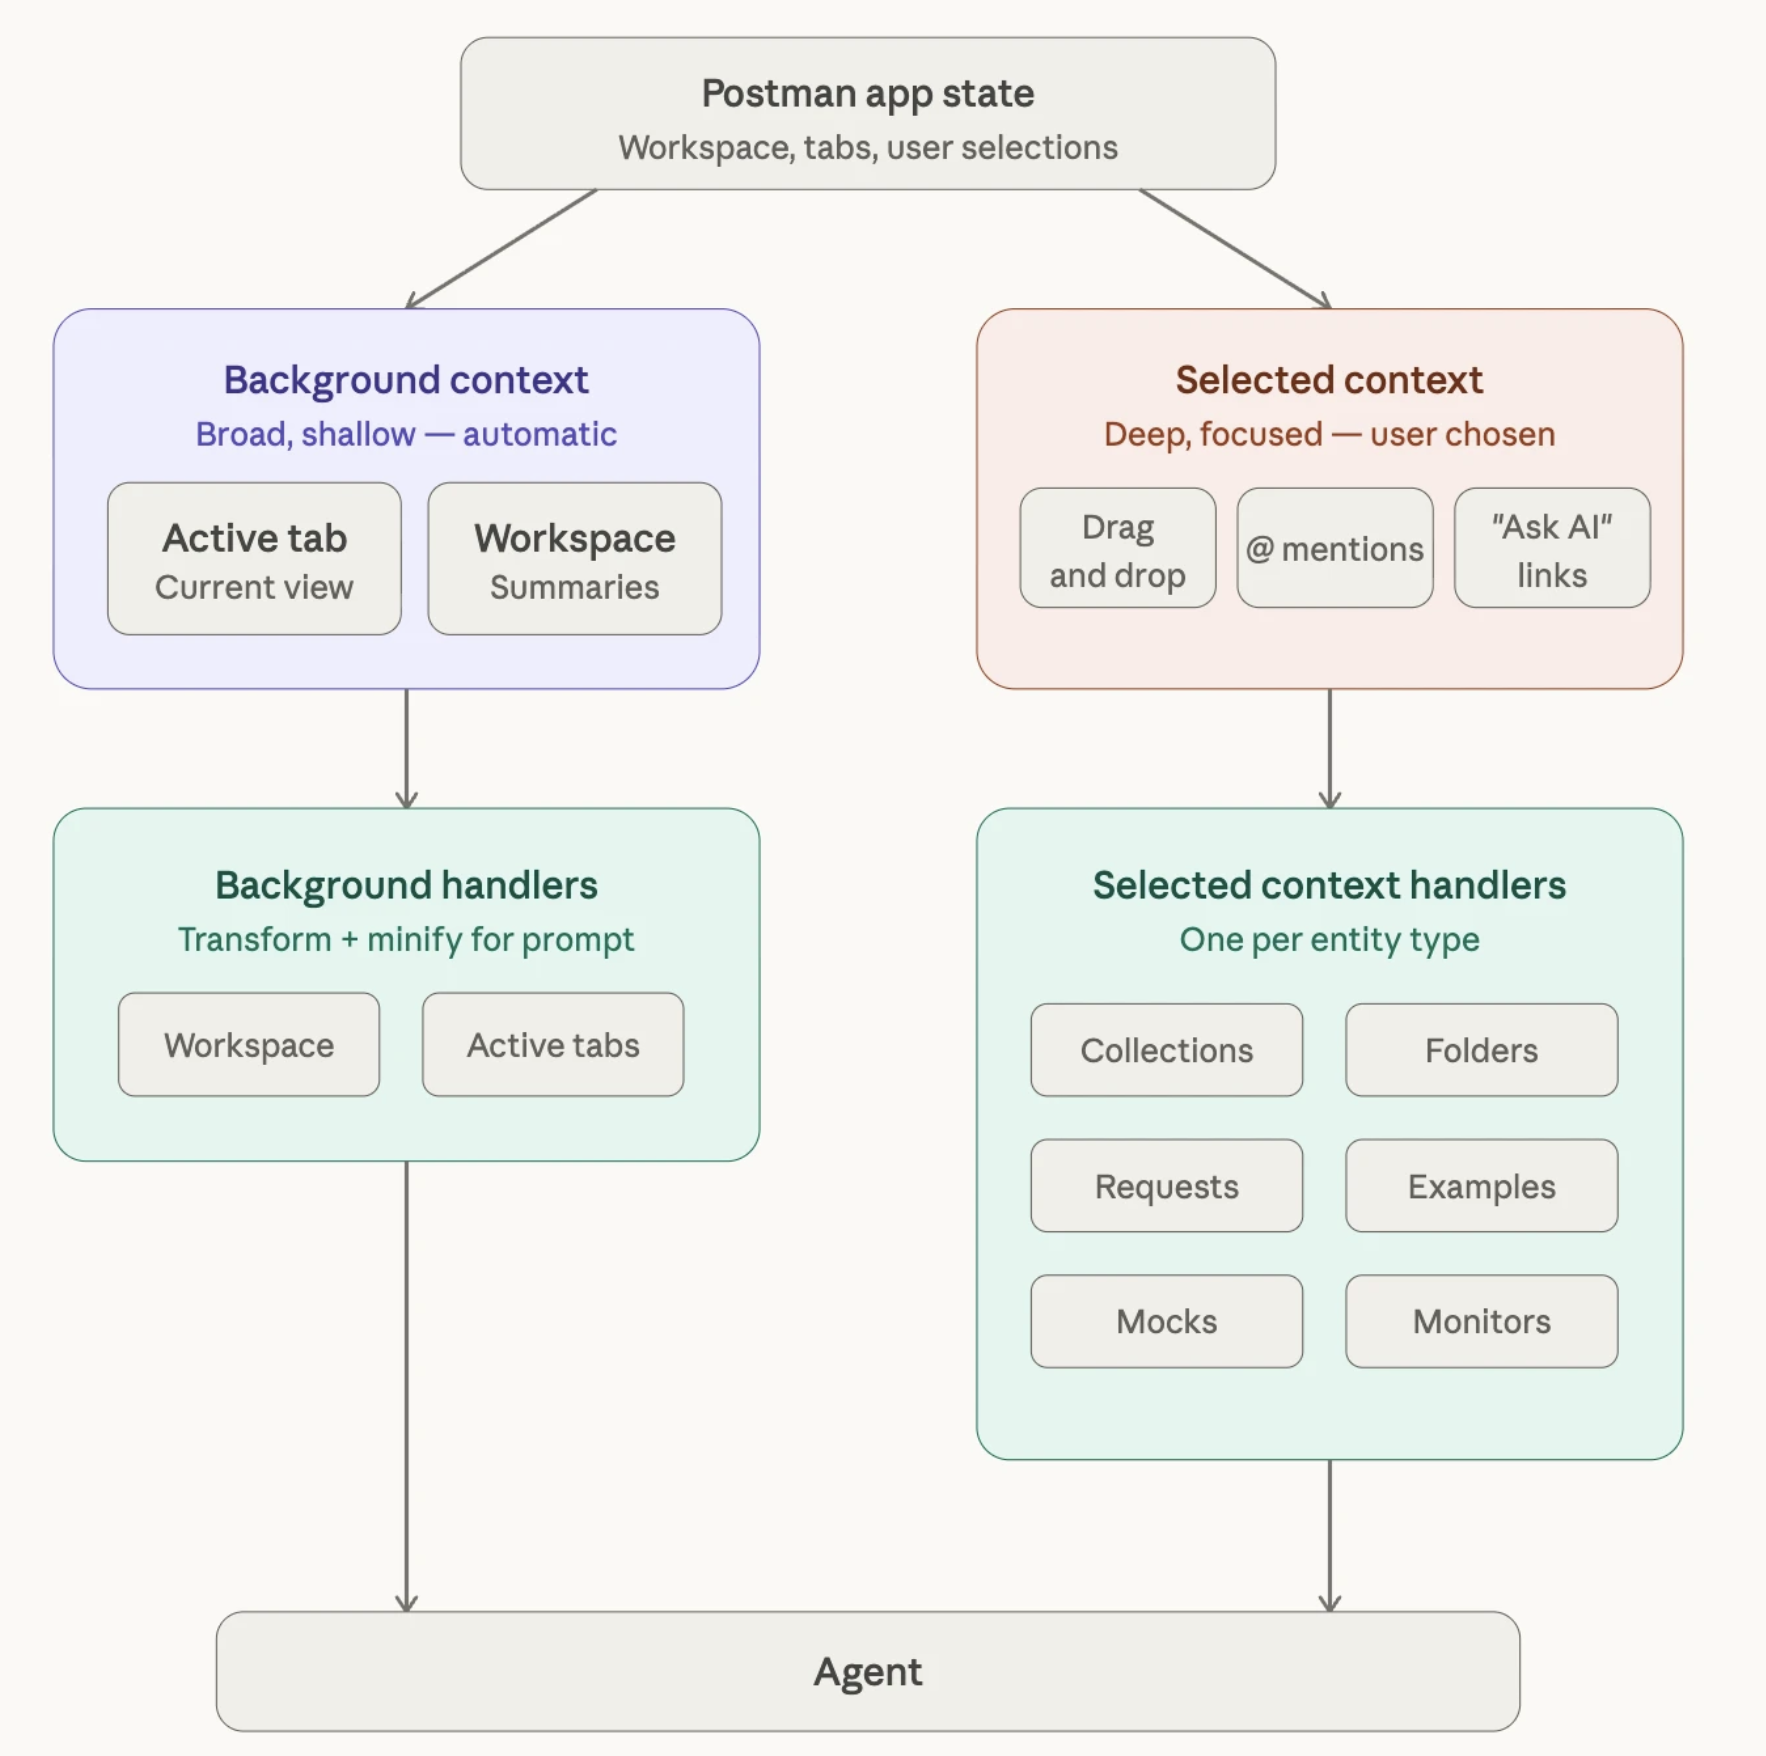
図4: 2種類のコンテキストがエージェントに供給されます。広く浅いバックグラウンドコンテキストは自動的に収集され、プロンプト用に最小化されます。深く焦点を絞った選択コンテキストはユーザーが選択し、エンティティタイプごとに専用のハンドラーを経由してルーティングされます。各ハンドラーはエンティティを、エージェントが必要とする情報へと蒸留します
課題は構造的なものでした。11年以上にわたり、開発者とユーザーはインターフェースを通じて情報を見つけることを学んできました。エージェントのためにその認識を作り直すには、各ワークフローにとって何が重要で何がノイズかを判断するための複数回の反復が必要でした。既存のインターフェースデータモデルをシリアライズしても有用なコンテキストは得られませんでした。なぜなら、それらのオブジェクトは推論のためではなく、レンダリングとデータ転送のために形作られていたからです。そのためPostmanは、各エンティティをエージェントが知る必要のある内容へと蒸留する専用のコンテキストハンドラーを構築しました。
より多くのオブジェクトがハンドラーを持つようになると、次の問題は切り詰めでした。多くのフィールドには、リクエストの説明、OpenAPI仕様、リクエストペイロードなど、自由記述のユーザー生成データが含まれています。このデータはコンテキストウィンドウを圧迫しえます。大規模な運用ではコンテキストバジェットを慎重に管理することが不可欠であり、これは、各ハンドラーがカスタムの切り詰め・展開ロジックを必要としない、チームが検討しているファイルシステムベースのアプローチにも対応します。
ビルダーへの要点: レンダリング用のデータモデルをモデルに与えないこと。目的に合わせた形のコンテキストハンドラーを構築し、コンテキストウィンドウを希少で積極的に管理されるバジェットとして扱いましょう。ノイズは、モデルが上限に達するはるか前からシグナルを追い出します。
すべてを組み合わせる
Agent Modeの進化に伴い、システムがそれぞれ異なる問題を解決する3つの独立したコンポーネントを集約する必要があることが明確になりました。
- クライアントサイドツールはPostmanアプリケーション内に存在し、リクエストのオープン、設定の変更、コレクションの実行、認証の検査など、エージェントが実行できる最終的なアクションを表します。Agent Modeは、Web検索やエージェントループの管理などの機能のためにサーバーサイドツールも使用しますが、ほとんどのツールはPostmanアプリケーションに対して動作します。
- 汎用エージェント指示はシステムレベルの動作を定義します。これには、Agent Modeがどの程度積極的であるべきか、不確実性をどのように伝えるか、そしてどのベースラインの製品知識を持つかが含まれます。
- ナレッジベースは、検索拡張生成(RAG)アプローチを使用します。Postmanは、複数のリクエストプロトコル、モックサーバー、モニター、ドキュメンテーション、API Network、ワークスペースガバナンス、変数、ヘルパー、コード生成、リクエスト設定、コレクション実行を含む大規模な製品群を有しています。
これらすべてを静的なプロンプトに組み込むのは実現不可能であり、しかもその大半は特定のクエリには無関係です。初期のシードとして、チームはPostmanのLearning Centerを利用して、機能ごとの簡潔な記事を生成しました。実行時には、Agent Modeが受け取ったクエリと利用可能なコンテキストに基づいてナレッジ記事を選択します。たとえば、ユーザーがモックサーバーを選択すると、Agent Modeは関連する記事を自動的に注入します。これにより、エージェントはデフォルトでは軽量に保たれつつ、必要なときには深い情報を提供できます。ナレッジベースはアプリケーションとともに進化するため、チームは新機能とともにAgent Modeのドキュメントを出荷できます。
Amazon Bedrock でのエージェントモードの実行
前述の3つのコンポーネントは、すべて同じランタイムアクション、すなわち基盤モデル(FM)への推論呼び出しに帰着します。Postmanの規模では、トラフィックはバースト的で、開発者主導のものです。ルーティング、キャッシング、および地理的処理の制御により、Postmanはトラフィックの急増に対応し、推論コストを管理し、ワークロード固有の処理要件に対応することができます。Amazon Bedrockは、ここで最も重要となる4つの機能を提供します。
Claudeファミリーにおけるモデルの柔軟性
Agent Modeは1つのモデルに限定されません。 Amazon Bedrock モデル推論 API、Postmanはサポート対象のAnthropic Claudeモデルにアクセスでき、各ワークロードを適切なモデルにルーティングできます。高速なモデルは大量かつレイテンシに敏感なやり取りを処理し、より大きなモデルはコストよりも品質が重要な複雑な推論を担当します。サポート対象のClaudeモデル間の移行は、主に設定の変更であり、新たな統合作業ではありません。この柔軟性は、前述のツールの乱立とコンテキストの課題に直接対応するものです。Postmanのテストでは、より新しく大きなモデルによってツールのハルシネーションが減少し、Postmanは統合を再構築することなくサポート対象のモデルを導入できます。参照: Amazon Bedrock の AWS リージョン別サポートモデル.
高スループットのためのリージョン間推論
開発者トラフィックは急激に変動するため、単一のAWSリージョンでピーク需要に対応できるようプロビジョニングするのはコストが高くなりがちです。Agent Modeは Amazon Bedrock クロスリージョン推論 インフランスプロファイルで定義されたリージョン間でリクエストを自動的にルーティングします。実行時に、アプリケーションは選択されたインフランスプロファイルの ID または Amazon Resource Name (ARN) を、Converse または InvokeModel の modelId として渡します。プロファイル、適用される AWS Identity and Access Management (IAM) およびサービスコントロールポリシー、そしてクォータは、Bedrock が選択する可能性のあるすべてのリージョンを許可する必要があります。
- 地理的推論プロファイル 定義された地理的範囲(米国や欧州連合など)内のサポート対象リージョン間でのみリクエストをルーティングします。このオプションは、スループットの向上と設定された地理的処理境界を組み合わせたものです。
- グローバル推論プロファイルは、サポートされている世界中の転送先リージョン間でリクエストをルーティングし、トラフィックの急増時に追加のスループットを提供できます。これらは、ワークロードが地理的に制約された処理境界を必要としない場合にのみ適しています。
Postman はワークロードごとに推論プロファイルを選択できます。最大限の利用可能なスループットを得るにはグローバルプロファイルを、処理がプロファイルで定義された地理的範囲内に留まる必要がある場合は地理的プロファイルを使用します。この選択は、Bedrock の各推論リクエストで使用される modelId に明示的に反映されます。
# Schematic Converse request
response = bedrock_runtime.converse(
    modelId="<geographic-inference-profile-id-or-arn>",
    messages=messages,
    system=system_blocks,
)
データレジデンシーとエンタープライズ管理機能
エンタープライズ顧客にとって、許可された処理地理域はスループットと同じくらい重要な場合があります。地理的推論プロファイルは、選択された地理域内でプロファイルが対応する宛先リージョンにBedrockのルーティングを制限します。これは、Postman自身のAWS環境内で推論が実行されることを意味するものではありません。Amazon Bedrockは、そのプロファイルに適格なAWSリージョンでリクエストを処理し、データは転送中および保存中に暗号化されます。AWSは、Bedrockではプロンプトと完了データをAWSモデルのトレーニングに使用したり、第三者に配布したりしないと明示しています。Postmanは、対応するAgent Modeモデルに対して、data_retention_modeをnoneに設定したゼロデータ保持を構成しています。利用可否と動作はモデルに依存するため、各本番モデルは最新の状況と照らして確認する必要があります。 Amazon Bedrock データ保護および保持に関するドキュメント.
コストを抑えるためのプロンプトキャッシュ
本番環境のエージェントは、毎ターンごとに大量の安定したコンテキストを再送信します。これには、システム指示、汎用的なエージェントの動作、主要なツールセット、選択されたナレッジ、会話コンテキストが含まれます。リクエストのたびに変更されていないプレフィックスを再処理することは、避けられるはずのレイテンシとコストの増加をもたらします。
Agent Modeは Amazon Bedrock プロンプトキャッシュ 安定したプロンプトプレフィックスを再利用するためのものです。システムプロンプト、エージェントの指示、コアのツール定義を含むほぼ不変のコア部分には、1時間のキャッシュチェックポイントを使用します。より変動の多いコンテキストには、キャッシュヒット時に更新される5分のチェックポイントを使用します。Bedrockでは、存続期間の短いチェックポイントよりも前に、存続期間の長いチェックポイントを配置する必要があります。アイドル状態のコンテキストは失効するため、短い方はインタラクティブなセッションに適しており、一方1時間のチェックポイントは、その高いキャッシュ書き込み価格を多数の読み取りにわたって償却できます。キャッシュのメリットとサポートされるTTLは、選択したモデルによって異なります。チームはcacheReadInputTokensおよびcacheWriteInputTokensの使用状況フィールドで動作を確認し、自社のワークロードにおける最初のトークンまでの時間を測定できます。
# Schematic cache checkpoints in Converse content blocks
{"cachePoint": {"type": "default", "ttl": "1h"}}  # stable core
{"cachePoint": {"type": "default", "ttl": "5m"}}  # variable layer
開発者への要点: 推論を単なるモデル選択の判断としてではなく、ルーティングとキャッシングの問題として扱いましょう。ワークロードごとにClaudeモデルを選択し、適切なクロスリージョン推論プロファイルを選び、各層が変化する頻度に合わせたTTLで安定したプロンプトプレフィックスをキャッシュしてください。
本番環境でエージェントをスケールさせるためのベストプラクティス
Postmanの経験から凝縮された、Amazon Bedrockで開発するビルダー向けの知見です:
- トークンと同じくらい慎重に予算を管理しましょう。 タスクごとに公開するツールを動的に選択します。Postmanのテストでは、表示されるツールセットが大きくなるほどツール選択のエラーが増加しました。
- ツールを増やすよりも、スキーマを理解した読み取りを優先してください。 データを適切にモデル化し、エージェントにクエリさせましょう。
- エージェントのアクションをインターフェースの状態から切り離してください。 ツールが開いているタブを必要とする場合、エージェントはデータを直接推論するのではなく、インターフェースを操作していることになります。
- 意図的に、技術者の文脈を。」 専用に設計されたコンテキストハンドラーは、レンダリングモデルを逐次シリアライズする手法を常に上回ります。
- コンテキストウィンドウを希少なリソースとして管理する。 切り詰めと展開の戦略は、後付けではなく第一級の設計課題です。
- 機能と共にドキュメントを出荷する。 RAGナレッジベースが有用であり続けるのは、プロダクトと足並みを揃えて進化する場合に限られます。
- Bedrock上でのルーティングとキャッシュ。 ワークロードごとに適切なClaudeモデルを選定し、スループットと地理的要件に応じてクロスリージョン推論を選択し、安定したプロンプトのプレフィックスには階層型キャッシュを適用してください。
結論
Agent Mode の構築にあたり、Postman は大規模言語モデルの能力と成熟した製品の構造との間のギャップ—インターフェースの前提、密結合したクライアント、膨大なツールカタログ、そしてドキュメントとチームに分散した知識—に向き合う必要がありました。動的なツール選択、スキーマベースの読み取り、そして意図的なコンテキストエンジニアリングは、次のスケールにおいて繰り返し使えるパターンとして浮かび上がりました。 Postmanの開発者コミュニティ. Amazon Bedrock マネージドモデルアクセスを提供し、 クロスリージョン推論、モデル依存 保持管理設定、および プロンプトキャッシング 本番アーキテクチャをサポートする。
初めてエージェントを構築する場合でも、既存のエージェントをスケールさせる場合でも、これらのパターンは、チームがエージェントの統合やスケーリングにおけるよくある課題を回避するのに役立ちます。
詳細については、以下をご覧ください。 Amazon Bedrock ドキュメント、以下の指針を含む リージョン横断推論, プロンプトキャッシング、および データ保護と保持。関連する実装ガイダンスについては、次をお読みください: Amazon Bedrock でプロンプトキャッシュを効果的に活用する および Amazon Bedrock、スループット向上のためのグローバルクロスリージョン推論を発表 AWS Machine Learning Blogで公開されています。製品の詳細については、以下をご覧ください。 Postman Agent Mode ドキュメント.
Postmanの本番実装は独自のものであり、公開サンプルリポジトリとして提供されていません。