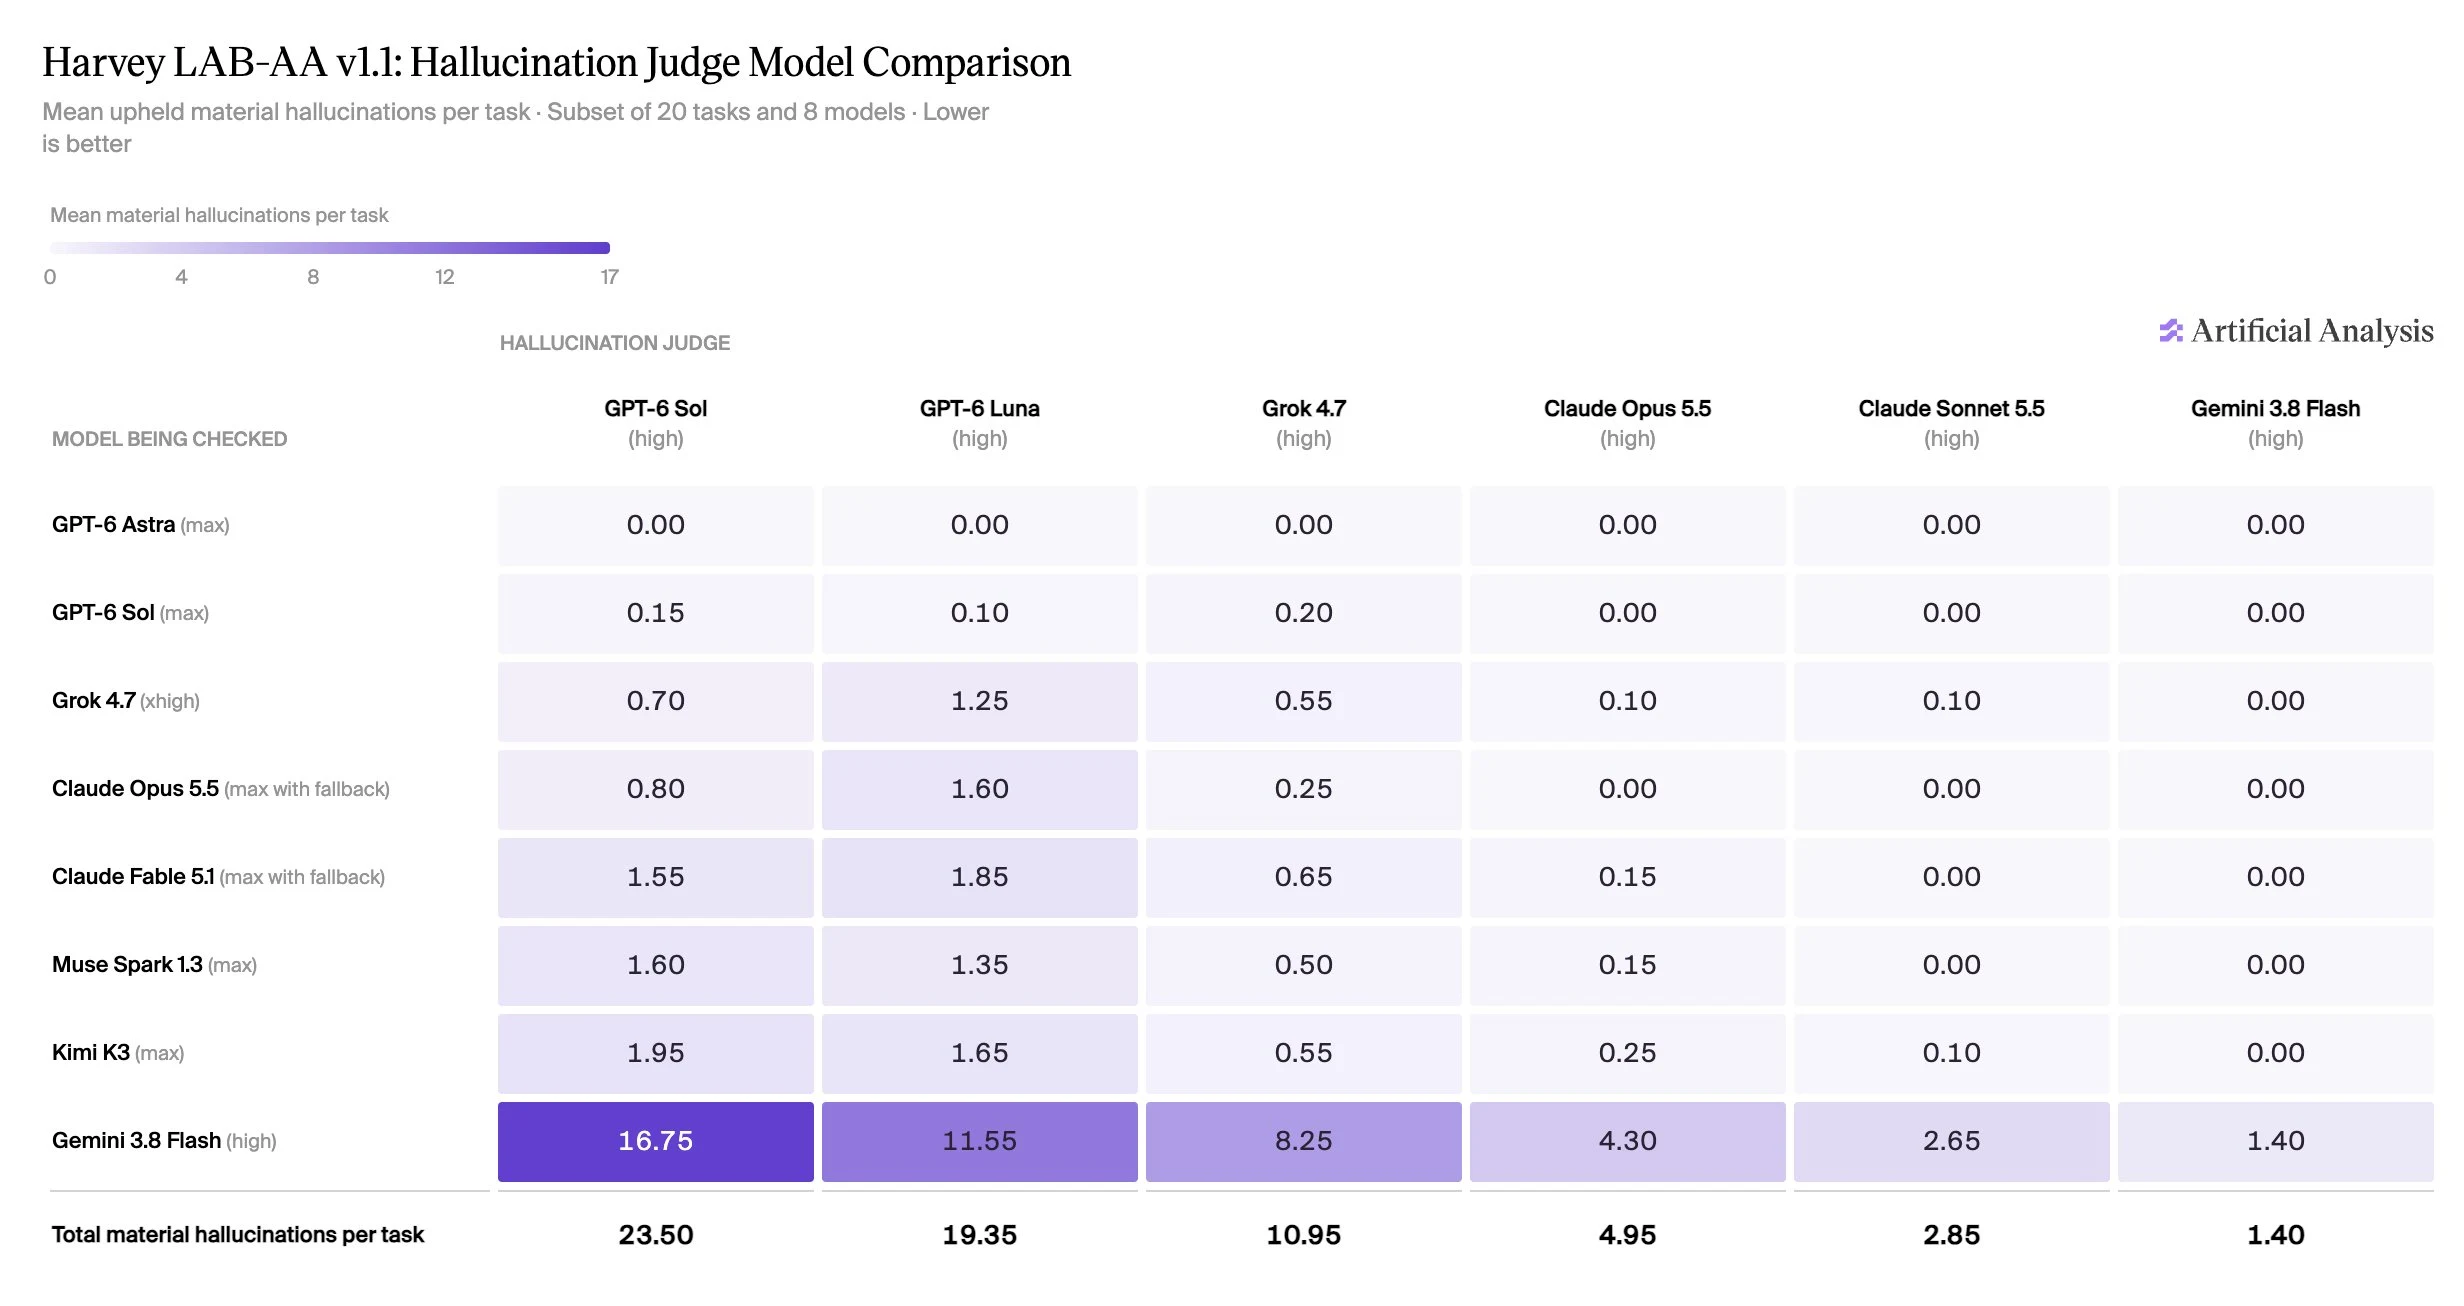
私たちは、20のタスクと8つのモデルの固定サブセットから得られた同一の成果物について、6つのハルシネーションチェッカーを比較しました。2段階チェックは GPT-6 Sol (high)、GPT-6 Luna (high)、Grok 4.7 (high)、Claude Opus 5.5 (high)、Claude Sonnet 5.5 (high)、Gemini 3.8 Flash (high) を使って実行し、本番運用には GPT-6 Sol (high) を選定しました。
この20タスクのサブセット全体で、GPT-6 SolとGPT-6 Lunaは概してより多くの重大なハルシネーションを特定した一方、Claude Sonnet 5.5とGemini 3.8 Flashははるかに少数しか特定しなかった。Claude Opus 5.5はすべてのモデル行において、Grok 4.7とClaude Sonnet 5.5の中間に位置した。合計で、Opusは99件の重大なハルシネーションを支持したのに対し、Grokは219件、Sonnetは57件、GPT-6 Solは470件であった。GPT-6 Solは、ソース文書に含まれない一般的な法律知識を除外するという、このチェックの誤り検出に関する保守的なアプローチにもかかわらず、より多くの重大なハルシネーションを特定した。
6人のチェッカー全員がGPT-6 Astraの出力に実質的なハルシネーションを見出さなかった一方、GPT-6 Solはタスクごとに0から0.20の範囲でした。両者は、すべてのチェッカーの下で実質的ハルシネーションが最も少ないモデル群に含まれていました。この比較はチェッカーの挙動の違いを示すものであり、カウントだけでは精度を証明したり自己選好を排除したりすることはできません。