
vLLMがVera Rubin NVL72に対応しました!
NVIDIA Vera Rubinは、エージェント型推論向けに構築された次世代プラットフォームです。Inferact、NVIDIA、Red Hat、vLLMコミュニティは、発表以来、Vera Rubin NVL72上でのvLLMの稼働に取り組んでおり、本日、vLLMはデイリーコンテナビルドとともにVera Rubin NVL72上で動作し、DeepSeek、Moonshot AI、Z.ai、MiniMaxのモデルをサポートしています。
この投稿は現時点での進捗を早期に共有するものであり、これまでの作業のハイライトをいくつか紹介します:
- Vera Rubin NVL72ハードウェア: GB200 NVL72の5倍のNVFP4 FLOPS、約2.4倍のHBM帯域幅、1.7倍の双方向NVLink帯域幅を備え、softmax用の指数演算は2〜4倍高速です。
- Day-0 サポート: RubinはBlackwellのアーキテクチャファミリーをベースにしているため、vLLMのBlackwellカーネルはRubinと互換性があります。このおかげで、vLLMはすでにDeepSeek、Kimi、GLM、MiniMaxなどの多様なモデルをRubin上でサポートしています。
- Rubinチューニング済みカーネル: FlashInfer 0.7.0 により、vLLM は Rubin 向けにチューニングされた attention、GEMM、MoE カーネルを利用できるようになります。また、MiniMax Sparse Attention(MSA)のプリフィル(prefill)カーネルも Rubin 向けにチューニングしました。
- ローカリティ対応 MoE: Rubin の拡張された HBM 帯域幅を最大限に活用するため、CUDA 13.4 のローカリティドメインを利用して MoE の重みを分割します。これにより、SM は自分に最も近いメモリからのみ重みを読み取ることができます。
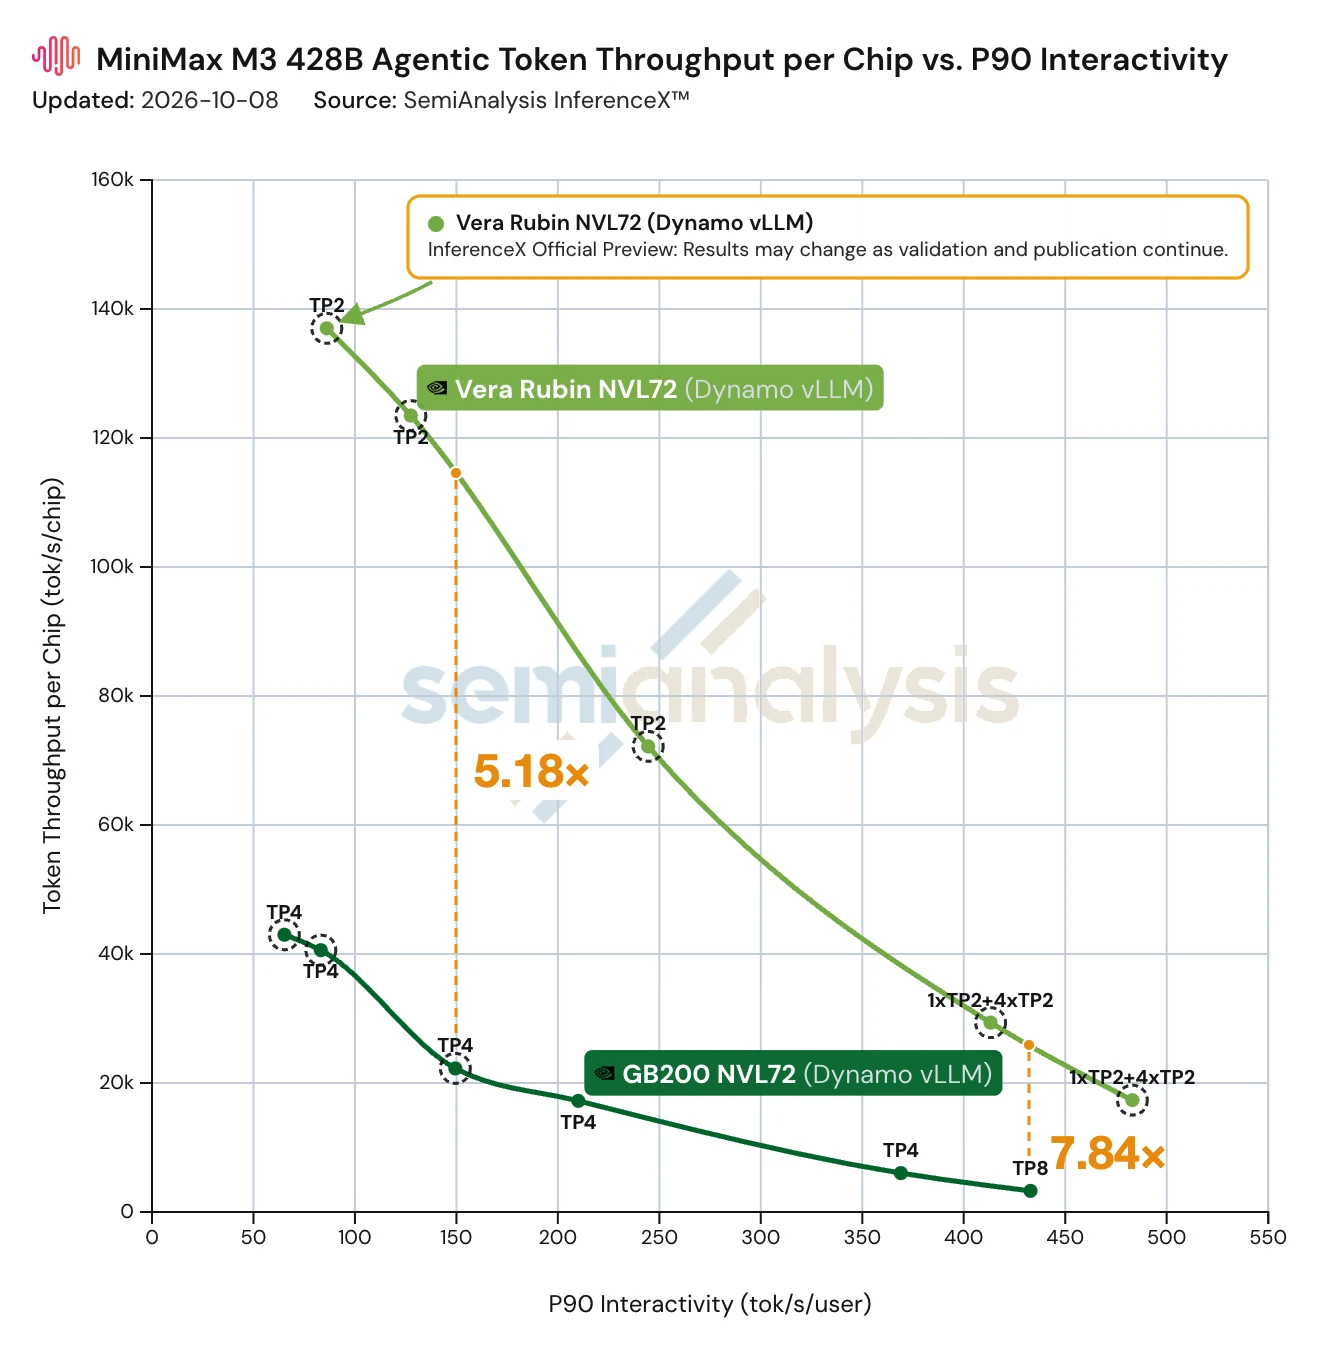
- 初期パフォーマンス: 初期の結果はすでに、vLLMによる impressive な向上を示しています: GB200 NVL72と比較して、GPUあたりのスループット7.8倍 AgentX上で、同等のインタラクティビティかつ最大で GB300 NVL72と比較して3.7倍高いVLMスループット MLPerfにおいて。これはまだ始まりにすぎず、最適化が続けられることでさらなるパフォーマンス向上が期待されます。
Rubinが推論のために変えるもの
クリックして展開図1。NVIDIA Vera Rubin NVL72とGB200 NVL72のGPUあたりの比較。各指標にカーソルを合わせるとGPUの該当部分がハイライトされ、「Show table」ですべての値が一覧表示されます。出典:NVIDIA Vera Rubin NVL72 および GB200 NVL72 spec ページ、および NVIDIA Rubin 開発者ブログ。
Vera Rubinプラットフォーム
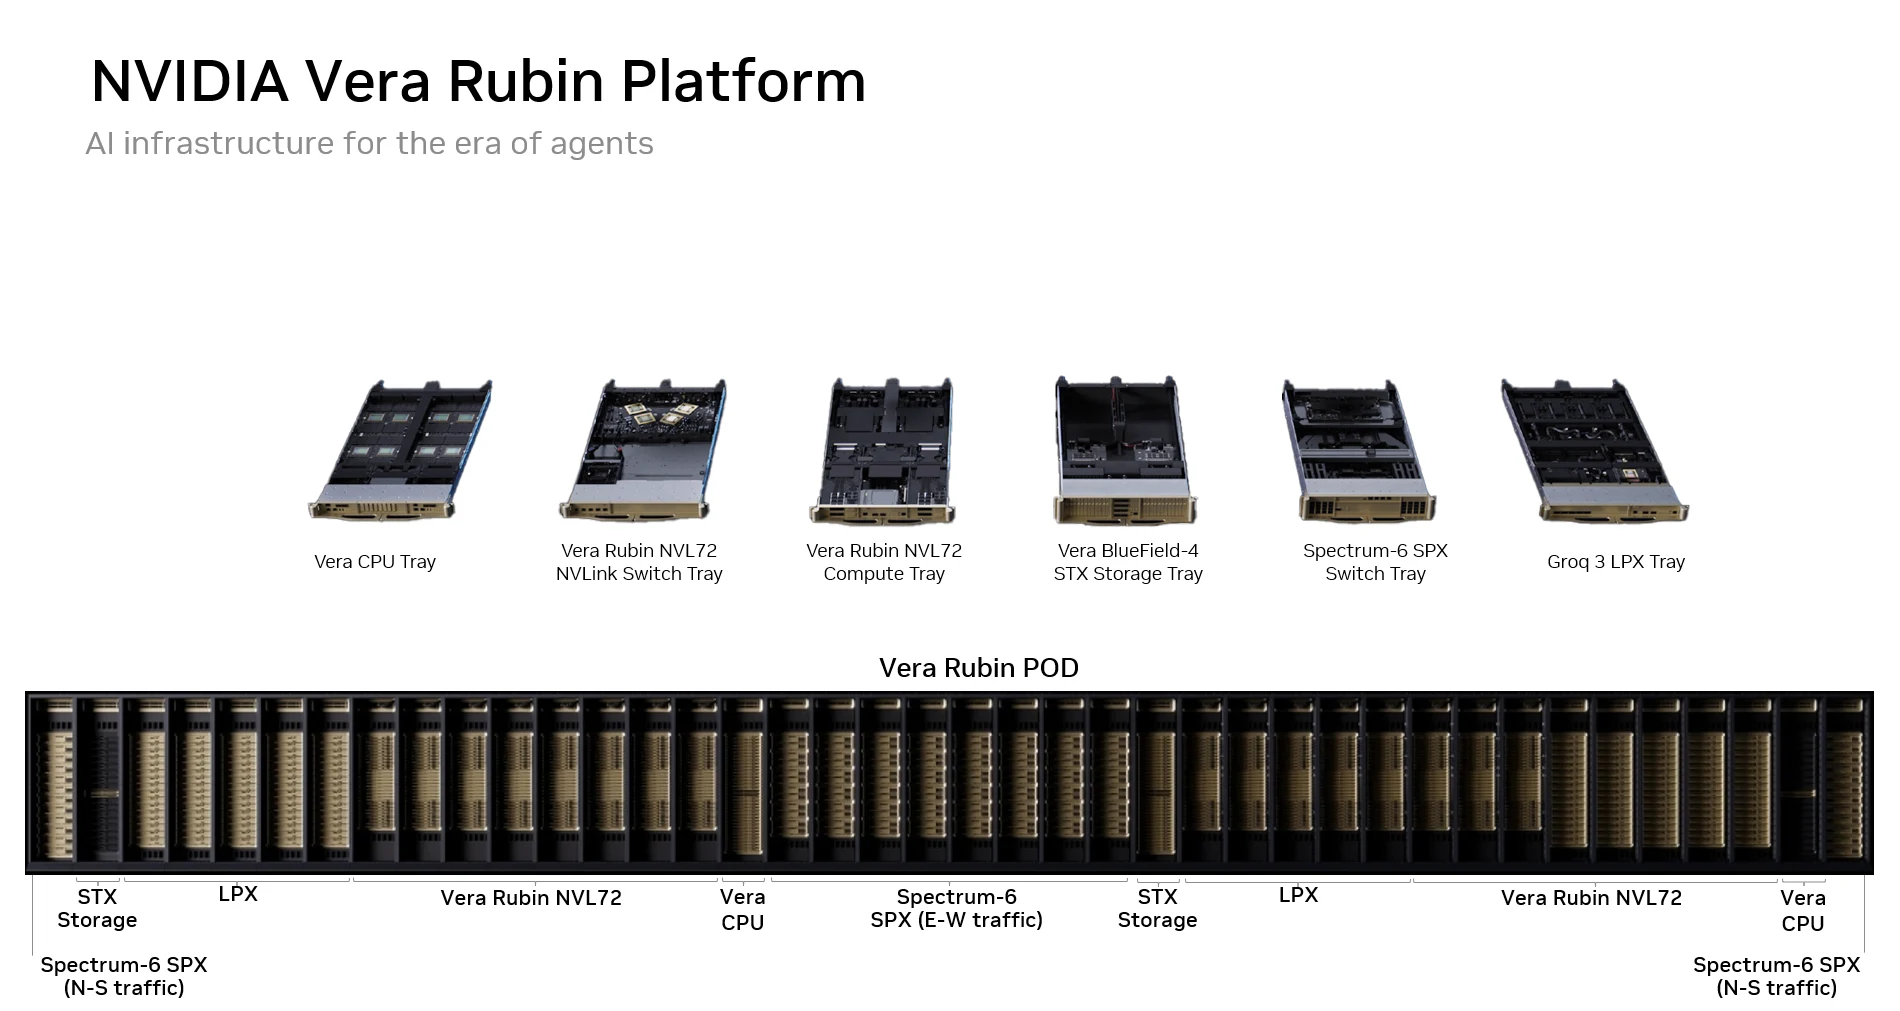
Vera Rubinプラットフォームは、ラック構成要素の極限的な共同設計により優れたパフォーマンスを提供します。エージェント型AIワークロード向けに、Vera Rubin NVL72、Vera CPUラック、Groq 3 LPX、Spectrum-6 SPX、BlueField-4 STX Storageという5つの新しくそれぞれ異なる目的別ラックスケールシステムを備えています。
単一の Vera Rubin NVL72 は、GB200 NVL72 と比較して 5 倍の NVFP4 推論 FLOPS と 2.4 倍のメモリ帯域幅を提供します。スケールアップネットワーク側では、第 6 世代 NVLink が Blackwell に対して最大 1.7 倍の帯域幅を実現し、本番環境のエージェント型サービングシナリオにおいて大幅に優れたユーザー体験をもたらします。
Softmax。 注目すべきは、Rubin は LLM のアテンションにおける中核演算である softmax のパフォーマンスも向上させたことです。Rubin は指数演算のスループットを向上させ、NVIDIA GB200 と比較して FP32 で 2 倍、BF16/FP16 で 4 倍のスループットを実現し、高速化された行列演算に softmax が追従できるようにします。
メモリ。 Rubin の HBM は HBM3e から HBM4 にアップグレードされ、GB200 NVL72 と比較して最大 2.4 倍の高い帯域幅を実現しています。より強力な計算能力と組み合わせることで、Rubin GPU は GEMM、MoE (Mixture of Experts)、アテンションといった主要な LLM 推論演算を高速化し、はるかに高い全体スループットと低いデコードレイテンシを実現します(詳細は後述).
ネットワーキング。 Rubin プラットフォームでは、GPU 間ネットワーキングも大幅に改善されています。第 6 世代 NVLink は前世代と比較して 1.7 倍の高いネットワーク帯域幅を実現します。これによりコレクティブ(AllReduce や All2all など)やその他の通信操作が高速化され、大規模 LLM 推論(prefill/decode 分離、ワイドなエキスパート並列など)の速度とスケーラビリティが向上します。
vLLM の Rubin サポート状況
vLLM コミュニティは、Rubin が公式に発表された直後から対応作業を進めてきました。vLLM コミュニティの重要な一員である NVIDIA、Inferact、Red Hat のエンジニアたちが協力して貢献し、すべてのユーザーが任意のモデルを Rubin プラットフォームに容易にデプロイできるようにしました。
このセクションでは、ローカリティドメインの活用といった vLLM の進行中の Rubin 固有のサポートと、Rubin ハードウェア上でのすぐに使える利便性の向上について紹介します。
ローカリティドメインのサポート
Ampere以降、NVIDIA GPUは非一様なグローバルメモリアクセスを備えています。 ローカリティドメイン機能 はNVIDIA CUDA 13.4で提供され、計算とデータを同じローカリティドメイン内に配置することで、アプリケーションが非一様なグローバルメモリアクセスを最大限に活用できるようにします。SMは、他のドメインのHBMよりも高い帯域幅と低いレイテンシで、自分のローカリティドメイン内のグローバルメモリにアクセスできます。 Green Contexts とCUDAストリームを使えば、各ローカリティドメインで1つずつカーネルを起動でき、各カーネルがローカルメモリにアクセスできるようになります。この機能は主にMoE decodeのようなメモリバウンドなワークロードを高速化します。ローカリティドメインは現在も活発に設計・開発中です。このセクションでは、MoE decodeを例に詳しく見ていきます。
Click to expand図3. 2つのローカリティドメインにおけるMoEフォワードでのSplit-N。重みWはN/2で列方向に分割され、各ドメインのSMは自分のHBM内にあるWの半分だけを読み取るため、各ドメインはローカルメモリ帯域幅を使用します。入力Xと出力Cは両方のドメインにまたがります。Pause、Prev/Next、またはステップチップを使って各ステップを進めてください。
MoE decodeはHBMからの重み読み出しがボトルネックとなるため、目的はローカリティドメイン間のメモリスループットの最適化です。Rubinの新しいローカリティドメイン機能の第一歩として、図3に示すように、FC1とFC2の両方でsplit-N戦略を使用します。重みを列方向にシャーディングし、各シャードを各ローカリティドメインのグローバルメモリに配置し、各ドメインのSMをローカルシャードに制限します。これによりほとんどのドメイン間メモリアクセスが排除され、カーネル性能の向上と消費電力の削減につながります。decode時のアクティベーションメモリは比較的小さいため、2つのメモリドメイン間でローカライズせずに保持してもオーバーヘッドは最小限で済みます。
SMを常に等しいドメインに分割できるとは限りません。デフォルトでは、ローカリティドメインの作成時に等しいパーティションを作ろうとする際、それらのSMは含まれません。両方のパーティションに同数のSMを持たせるには、ドメイン作成時に cudaDevSmResourceGroupBackfill (バックフィルモード)を有効にする必要があります(詳細は公式のローカリティドメインドキュメントを参照してください)。今回の性能調査では、デフォルトモード(両ドメイン合計で200個のSMのみ使用)とバックフィルモード(全212個のSMを使用)の両方を対象としました。
図4は、異なる並列戦略におけるローカリティドメインのオン/オフでの暫定的なMoEレイヤーフォワード時間(FC1 + FC2)を比較したものです。例としてMiniMax M3 MoEのシェイプを使用しています。ローカリティドメインを有効にすると、小トークンのフォワード設定で平均1.2倍の高速化を安定して得られます。この傾向は他のTPやEPのサービング戦略でもほぼ同じです。212個のSMのうち200個のみを使用するデフォルトモードでも、ローカリティドメインを有効にすることで同様の利得が得られます。主な理由は、小トークンのdecodeではフォワードパスが重みのロードに支配されており、ローカリティドメインがより高いHBMスループットを可能にするためです。これらの初期結果は出発点に過ぎず、Rubin上でのローカライズの性能メリットを最大化するには、さらなるチューニングと最適化の余地があります。
Click to expand図4. Rubin上のMiniMax M3 MoEレイヤーのランクあたりの暫定的なFC1 + FC2レイテンシ、非ローカライズ vs ローカライズ(小さいほど良い)、各ペアの上に高速化率(非ローカライズ ÷ ローカライズのレイテンシ)を表示。タブで並列戦略(TP2、TP4、EP2、EP4)を切り替え、トグルでバックフィルモード(全212個のSM)とデフォルトモード(212個中200個のSM)を切り替えます。バランスドルーティング。通信時間は含まれません。
Day-0での使いやすさ
使いやすさは常にvLLMの最優先事項です。本日の時点で、ユーザーはvLLMのDocker Hubから、CUDA 13.4とPyTorch 2.15でビルドされたnightlyイメージを取得して使用できます。具体的には vllm/vllm-openai:cu134-nightlyがRubinハードウェア向けに利用可能です。
Blackwellソフトウェアスタックとの互換性。 RubinはBlackwellのアーキテクチャファミリーをベースに、拡張された tcgen05 テンソルコア命令を備えています。Rubinは新しいGPUコンパイルターゲット(sm107)ですが、Blackwellファミリーターゲット(sm100f)向けにビルドされたカーネルも実行できます。実際、vLLMのBlackwellカーネル、特にattentionやMoEのようなGEMMが重いカーネルは、変更なしでRubin上で既に実行できます。
日次コンテナビルド。 Rubin向けの日次コンテナビルドは既に利用可能(#55953)で、これはCUDA 13.4上のRubinビルドパスのための #53443 と #54640 CUDA 13.4上のRubinビルドパスのためであり、および #56545 と #59288 によって実現されています。
モデルカバレッジ。 これらの部品が揃ったことで、vLLMはRubin上でDeepSeek、Kimi、GLM、MiniMaxを含む多様なモデルを提供できるようになりました。
Rubin向けにチューニングされたカーネル
Rubin固有のハードウェア機能や特徴を活用するカーネルが徐々にリリースされ、FlashInferやvLLMのMSAフォークなどのカーネルライブラリにアップストリームされています(vllm-project/MSA)、ハミング(vllm-project/humming`)` など。本日の時点で、vLLM は Rubin のパフォーマンスを最大化するための重要なカーネルをいくつか統合済みです。具体的には、dense NVFP4 または MXFP4 GEMM、NVFP4 MoE、FP8 attention、FP8 MSA prefill など多数が含まれます。
パフォーマンス
我々は、Vera Rubin NVL72 GPU上で動作するvLLMのパフォーマンスを、2つの代表的なベンチマーク、すなわちSemiAnalysis AgentX(詳細は本 前の記事)、および MLPerf Inference v6.1.
AgentXでは、Vera Rubin NVL72上でMiniMax M3を稼働させるvLLMが、同等のインタラクティビティ条件下でNVIDIA GB200あたり最大7.84倍のスループットを達成し、150 TPSの制約下では5.18倍高いスループットを実現しました。これは同プラットフォームの推論能力のごく初期の見取り図にすぎません。より多くのVera Rubin NVL72ノードへのアクセスが進めば、テスト範囲を広げ、最適化を加速させ、その作業の進展に伴いさらなる性能向上が期待されます。
MLPerf Inference v6.1ラウンドは、NVIDIA Vera Rubin NVL72プラットフォームへのvLLMの導入(ブリングアップ)にとって初めてのテストの場となりました。Vision Language Model(VLM)ベンチマークでは、バックエンド推論エンジンとしてvLLM、フロントエンドルーターとしてDynamoを使用してQwen3-VL-235B-A22Bモデルをデプロイすることで、Vera Rubin NVL72は最大で 3.7倍 オフライン、サーバー、インタラクティブの各シナリオにおいてGB300 NVL72を上回るスループットを実現しました。公開されたMLPerf Inference v6.1の結果の詳細は NVIDIAのブログ記事.
次のステップ
「ローマは一日にして成らず」であり、Vera Rubin NVL72 GPU上のユーザビリティとパフォーマンスの磨き込みは、エキサイティングな継続的な旅になるでしょう。今後は、コミュニティとして協力しながら、Rubin GPU向けに以下を含む(ただしこれに限定されない)多くの新機能を有効にすることを計画しています。
- sm107 FlashInfer MegaMoE を FlashInfer を通じて vLLM に統合します。
- MoEレイヤーに対してローカリティドメインを完全に有効化します。
- PDLとLamport Syncを通じて、異なるレイヤーやカーネル間の重複する機会をより多く発見し、活用しましょう。
- レイテンシが重要なユースケース向けにメガカーネルを探ってみましょう。
- Rubin 上で Kimi K3 向けに KDA および MLA カーネルを最適化する。
- DeepSeek-V4.1-Flash 向けに Rubin CSA カーネルと HCA カーネルを統合します。
- Rubin MSAデコードカーネルを仕上げて統合します。
- FlashInferを通じて、CFT counted-write MoE all-to-allカーネルをvLLMに統合します。
謝辞
この取り組みは、Inferact、NVIDIA、Red Hat、およびより広範なvLLMコミュニティの協力によるものです。特に感謝を申し上げたい方々は以下の通りです:
- NVIDIAに対しては、Vera Rubin NVL72の早期アクセスと開発全体を通じた緊密な協力があった。
- InferactとNVIDIAに対しては、Rubinコラボレーションを主導し、パフォーマンスチューニングを推進し、MSAカーネルを統合し、ロケリティ対応MoEのパフォーマンスを分析していただいたことに感謝します。
- RubinのDockerデイリービルドの設定と有効化について、NVIDIAとRed Hatに感謝します。
- プロセス全体を通して継続的なサポートと貢献をしてくださったvLLMコミュニティの皆さん。
付録: Vera Rubin NVL72 上での vLLM の実行
Rubin のカーネル設定を表示するvLLMはすでにRubin向けに高度に最適化されたカーネルをいくつか統合しています。このセクションでは、Rubin GPU上で最大のパフォーマンスを引き出すためにそれらを有効化するための対応する設定について説明します。
- CuTe-DSL dense NVFP4 または MXFP4 GEMM。NVFP4/MXFP4 モデルチェックポイントではデフォルトで有効ですが、設定することもできます
--linear-backend flashinfer_cutedslNVFP4 用または--linear-backend flashinfer_cutlassMXFP4が有効になっていることを確認するためのものです。 - CuTe-DSL NVFP4 MoE。以下から有効化できます。
--moe-backend flashinfer_cutedsl. - 「バッチ化」 expert フォーマットにおける NVFP4 W4A4 MoE 向けの CuTe-DSL masked grouped GEMM。これは以下のようなデプロイメントに適用できます。
--enable-expert-parallel --data-parallel-size N --all2all-backend deepep_low_latency|nixl_epどこN>1。この場合、--moe-backend auto|flashinfer_cutedslどちらもこのカーネルに解決されることになります。 - 静的な per-tensor FP8 W8A8 線形層向けの CuTe-DSL FP8 BMM です。デフォルトで有効になっており、FlashInfer オートチューナーがこれを利用できる場合があります。
- Trtllm-gen FP8 attention。有効にするには、FP8 KVキャッシュを以下から設定する必要があります。
--kv-cache-dtype fp8または FP8 KVキャッシュを指定するチェックポイント、さらに設定--attention-backend FLASHINFER|FLASHINFER_MLA。DeepSeek方式のMLAプリフィルについても、以下を追加してください-ac.mla_prefill_backend=TRTLLM_RAGGED -ac.use_prefill_query_quantization=true. - CuTe-DSL FP8 MSA prefill。有効にするには、次による FP8 KV cache が必要です。
--kv-cache-dtype fp8またはFP8 KVキャッシュを指定するチェックポイントであり、また設定--attention-config.minimax_m3_msa_decode_backend=cutlass.