
一水 発信元:凹非寺
量子位 | 公式アカウント QbitAI
ゲームをプレイしながら、自分をレベルアップさせる?
すごいな、華為はこの回でAIに「遊びながら強くなる」を学ばせたのか?!
最新の研究で、華為ノア方舟ラボラトリーとUCLなどのチームが、Memento 3という名前のAIスマートアイドルシステムを発表した——
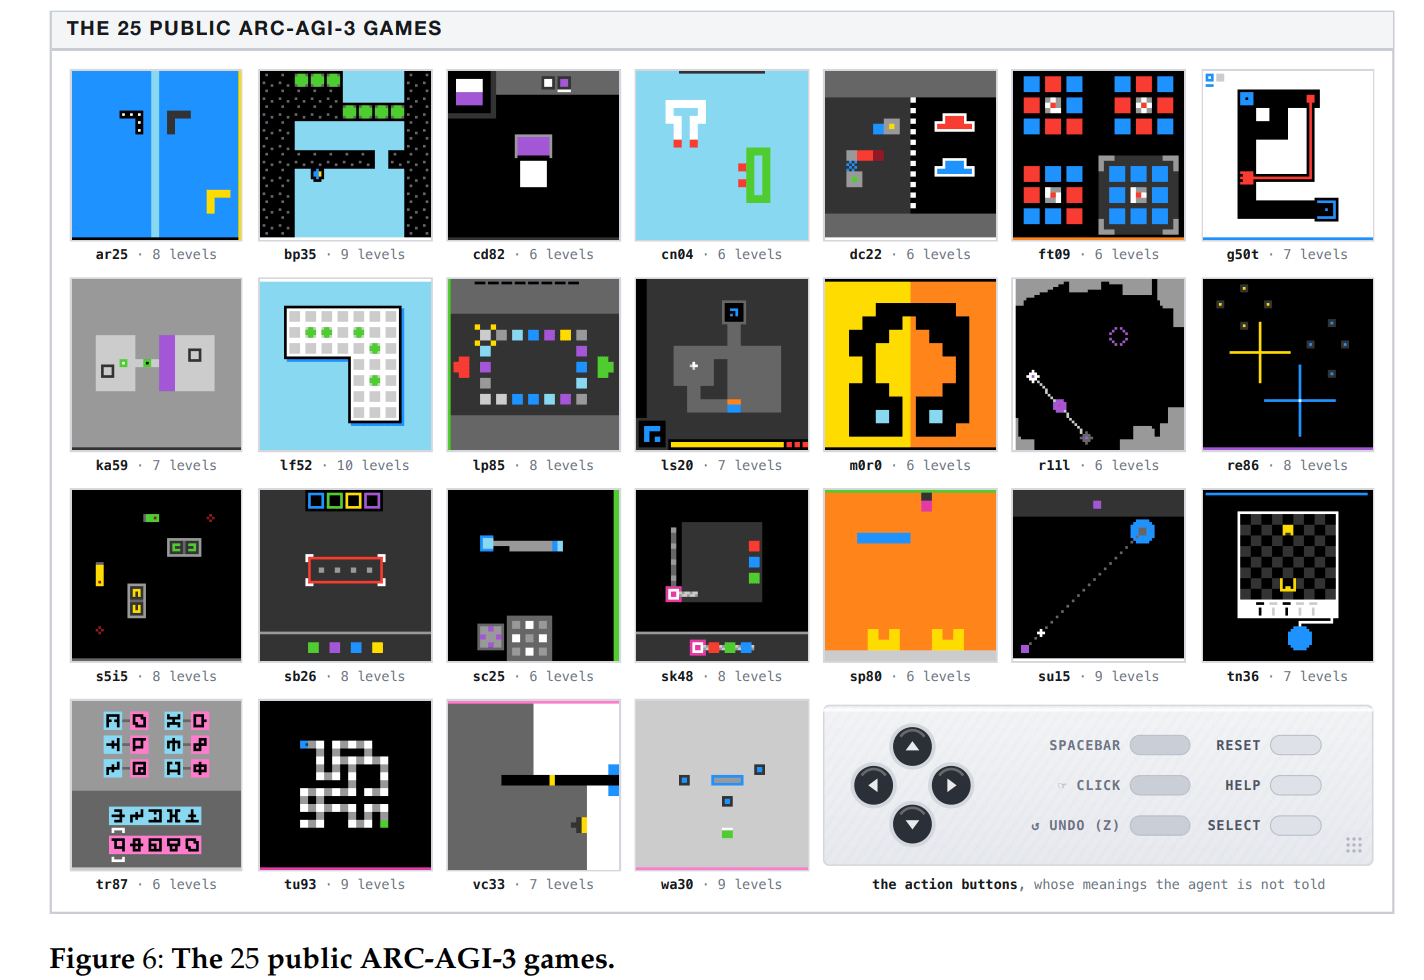
ARC-AGI-3公開集にある25種類のゲーム、183のステージをすべてクリアした。
まだ無思慮な試行錯誤だけでやり切ったわけではない。
人間が同じセットのステージをクリアするには、17135回の操作が必要です。
そして、Memento 3は7518回しか使われていない。人間より約56%の操作が少なく、最終的に100点満点のRHAE成績を獲得した(相対的人間行動効率、相対的な人間の行動効率)。
さらに奇妙なことに、このシステムはClaude Opus 5をベースモデルとしており、モデルの重みを全く更新せず、ゲーム向けに微調整も行われていない。
彼は自分で遊びながら、ルールを考え、コードを書く。間違えたら反省して修正する。
その後、満点でクリアしました。
比較すると、Claude Opus 5はARC Prizeの公式標準テストフレームワークの下で、平均RHAEは約40.7点にしかなっていない。
同じ型枠で、スマートアンドシステムを導入したところ、成績が59.3点も急上昇しました。
まだ終わっていない。
この方法はパズルゲームをプレイするだけでなく、研究チームはそれをAtariのクラシックゲームであるPongに使わせました。
結果として、AIは自ら制御戦略を見つけ出し、その後、大規模モデルに推論を依頼することなく、3試合連続で対戦相手を21:0に追い込んだ。
いいえ、大モデルは後続の操作には参加しないのに、ゲームがこんなにも上手くできるなんて?!
重要な点は、この研究のタイトルに隠されている:
モデルベースの再帰的自己改善、世界モデルに基づく再帰的自己向上。
華為AIは25種類のゲームを直接クリアし、操作回数は人間よりも56%少ない
まず、これら25種類のゲームがどのようなものかについて話しましょう。
それらはARC Prizeが発表したARC-AGI-3から来ています。AI評価に注目する人なら、ARCシリーズには馴染みがあるはずです。
しかし、この世代には非常に明確な変化があります:
もはや問題を出して解くという手順ではなく、今回はAIを見知らぬゲーム世界に投げ込むことになった。
ルールは、AIが自分で推測する必要がある;目標は、AIが自分で見つける必要がある;操作がどのような効果をもたらすかは、AIが自分で試す必要がある。
AI:全部私のせいなんだよね~
この25種類の公開ゲームには、合計で183のステージが含まれており、画面はほとんどがシンプルなピクセル、ブロック、色、グラフィックで構成されている。
一見すると、まるで数十年前の小さなゲーム集のようです。
しかし、この質素な画風に惑わされることはない。
AIにとって、操作する方法は最も難しいことではない。最も面倒なのは、この世界がどのように機能しているのか全く分からないことだ。
特別な床に足を踏み入れると何が起こるのか?ドアが開かない、色が合わないのか、それとも形が合わないのか?
さらに面倒なのは、後半のステージで新しいルールが現れ、以前に得た経験をすべて覆すことです。
AIの話はやめとくが、人間のプレイヤーでも困難を感じるだろう。
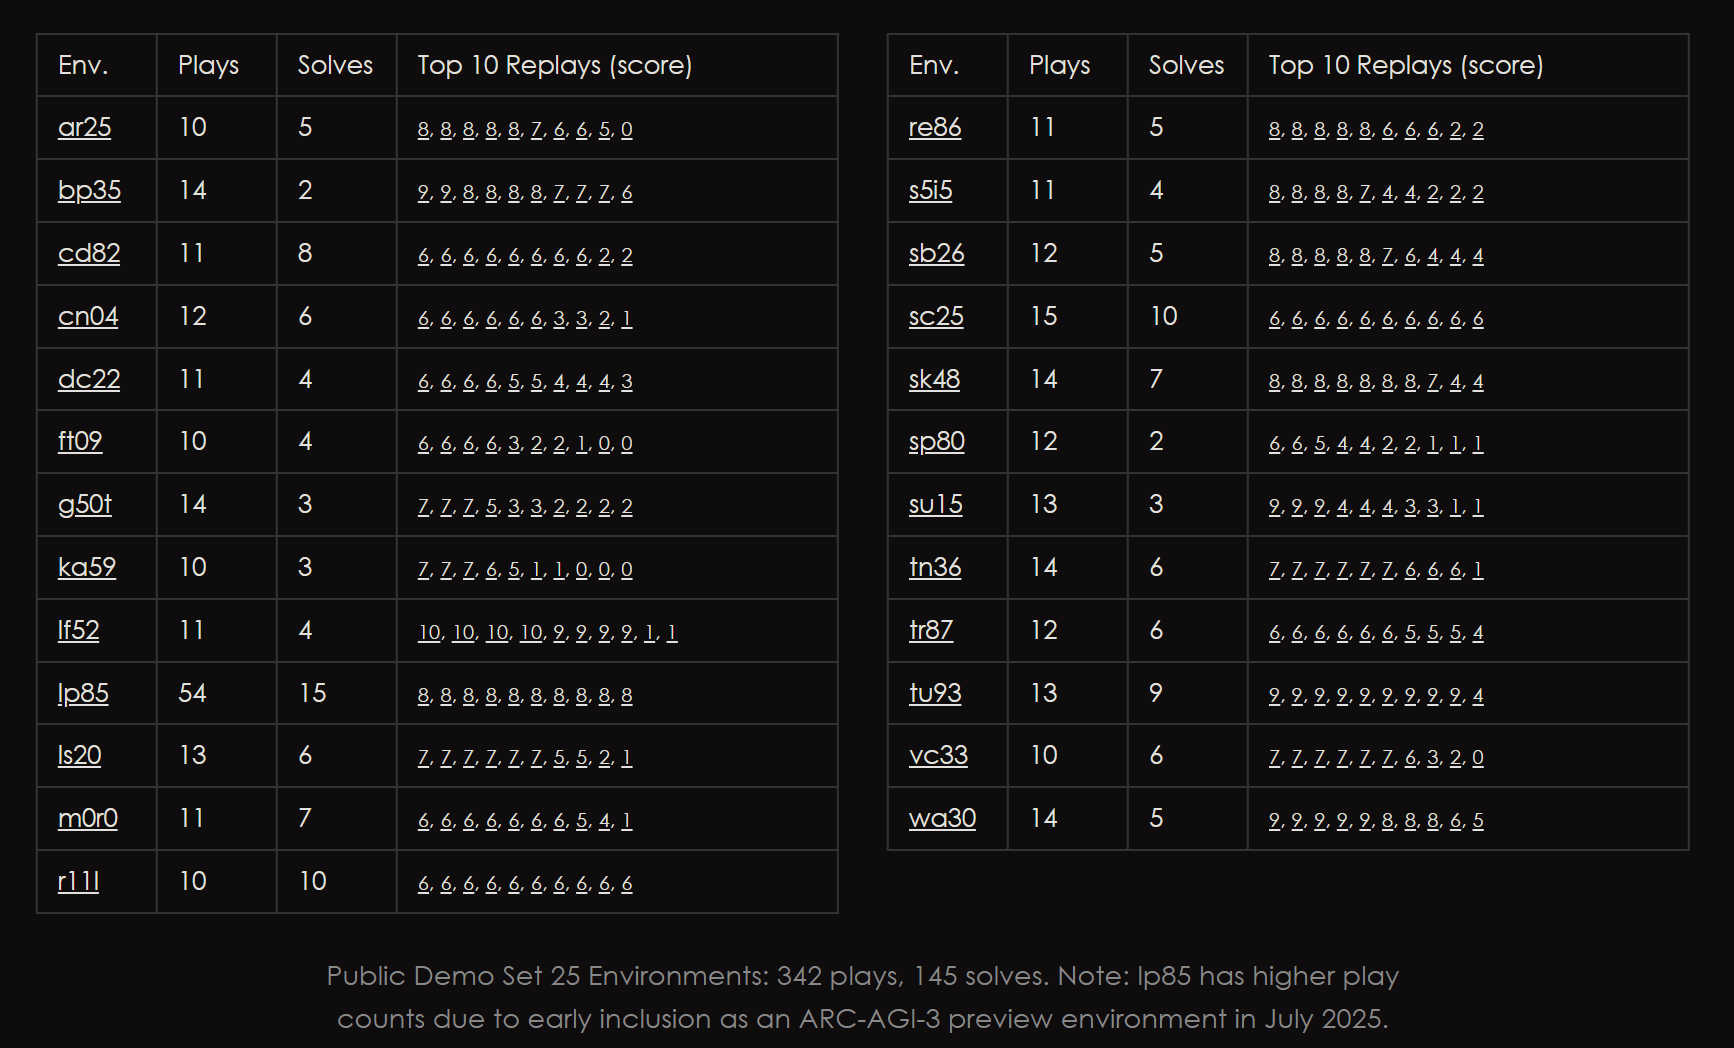
ARC Prizeのテストデータによると、形態変化虫の動きや色の変化を操作するパズルゲームr11lでは、10人の参加者が全員クリアした。一方、記号解読能力を試すパズルゲームtr87では、12人が挑戦したが、6人だけが成功した。
華為AI以前、各種研究チームは既にかなり激しい競争があった:
プリンストン大学が発表したContinual Harnessは、わずか3本のゲームで20.5点を獲得した。
NVIDIAの研究者が参加したDreamTeamは少し良い結果で、6種類をクリアし、得点は38.1であった。
さらに上層では、独立研究者のデイビッド・コートリスが開発したOPINE-Worldと、NVIDIAチームのNOOAがそれぞれ78.4点と85.1点を獲得した。
最も優れているのは、独立開発者セルゲイ・ロディオノフのbaseline1で、25種類のゲームをすべてクリアし、99点を獲得しました。満点までは1点しか足りません。
しかし、ハウェのチームは今回、最後の1点も直接補えた。
Memento 3は、100点の成績で全25種類のゲームと183のステージをクリアし、総操作回数を7518回に抑えました。これはbaseline1の8347回よりも829回少ない数です。
ゲートを通過しただけでなく、さらに少ないステップで通過しました。
どうやって成し遂げたのですか??
大規模モデルのトレーニングは不要で、AIは自分自身に攻略を書かせることで「敵を倒してレベルアップ」する
論文を調べたところ、Memento 3の核心的な手法はCode as Model(コード即ちモデル)と呼ばれている。
聞くと少し抽象的ですが、実際にはAIにゲームをプレイする過程で、自分自身のために二つのものを用意させるということです。
絶えず更新されるゲーム攻略本と、ゲームの実行をシミュレートするコードセット。
- 規則書:Markdown文書で、AIがゲーム内で見つけた規則を記録したものです。例えば、どの操作がどの効果を引き起こすか、どうすればクリアできるか、またはまだ理解できない規則などです。
- 実行可能な世界モデル:AIは自身がまとめたルールを、実行可能なPythonコードとして直接書き出す。これは、簡略化されたゲームシミュレーターを自ら作ったようなものである。
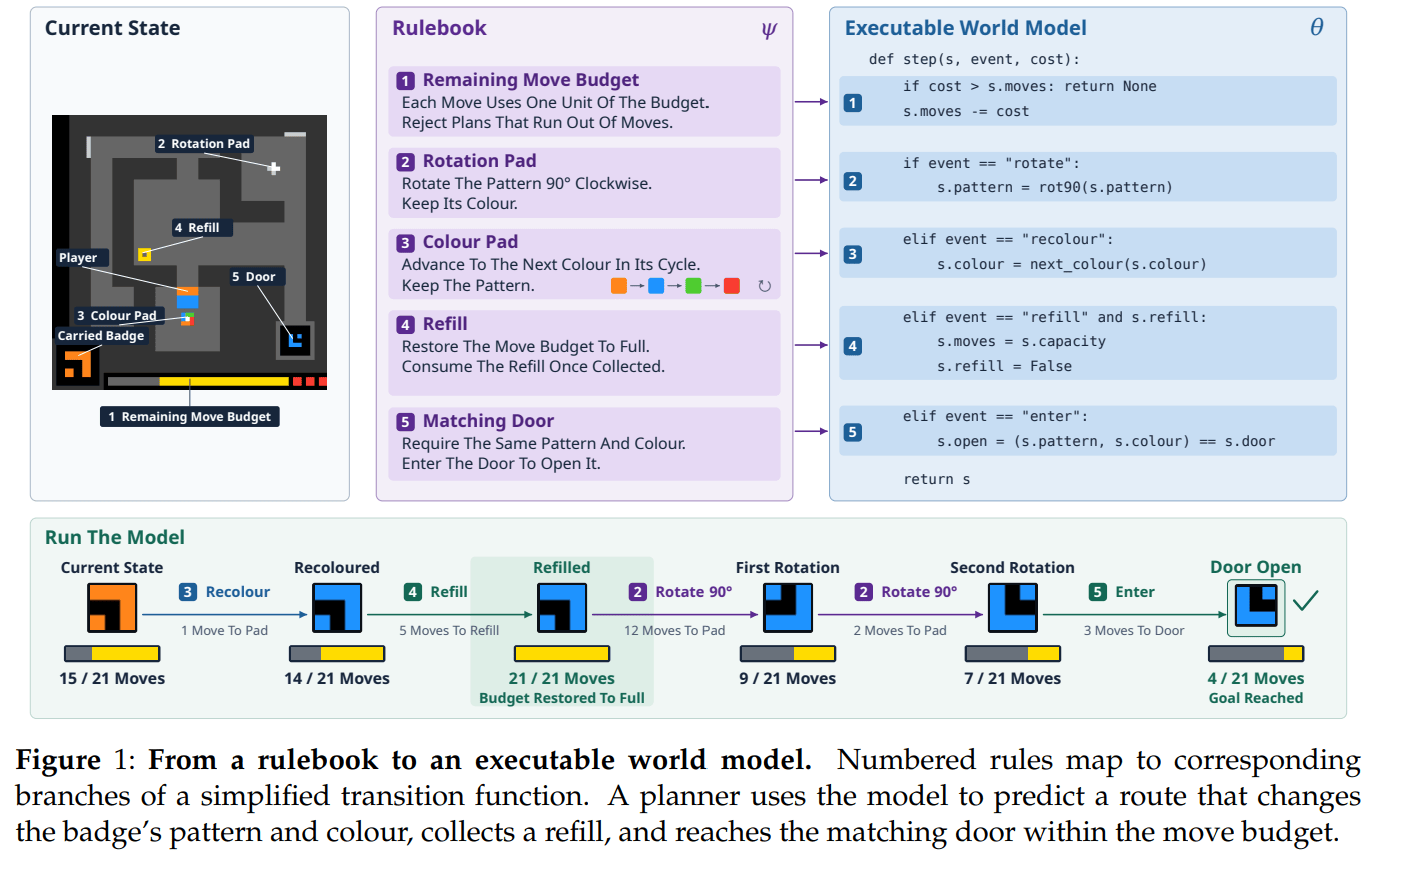
これら二つがあれば、AIは自分で作ったシミュレーター内で様々なルートを試すことができ、次にどう進むかを決定できる。
しかし問題が生じる。もし最初に理解するルールが間違っているとしたらどうなるのか?
急がないで、Memento 3は自分で攻略を作るだけでなく、間違いを見つけたら自らやり直すこともできる。
論文には一例が示されている。
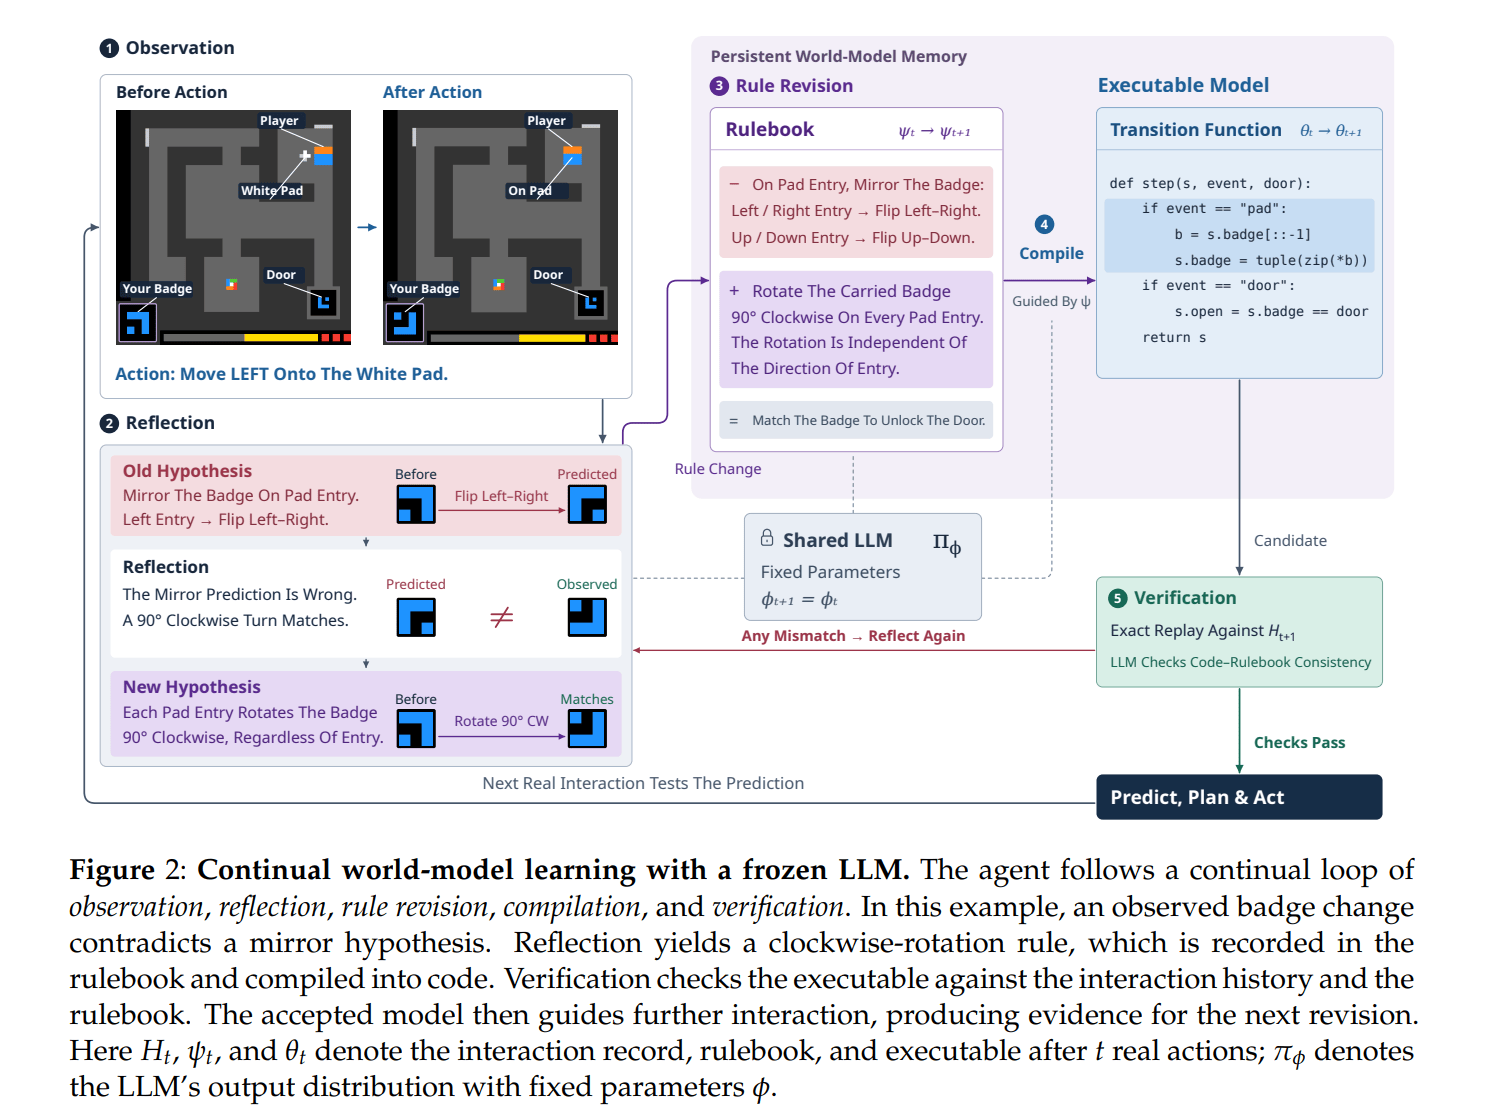
AIは謎解きゲームで特別な床に出会う。最初は、その床を踏むと、キャラクターが持っている模様が進入方向に応じて鏡像反転するのだと思った。
結果として実際に試してみると、パターンは反転するのではなく、時計回りに90度回転していることがわかりました。また、入る方向とは無関係です。
そこでAIは規則マニュアルを修正し、対応するPythonコードも更新された。
しかし、修正した後も検査が必要です。
システムは以前の操作を再シミュレートし、64×64のゲーム画面を一つ一つ比較することで、コードが実際の結果を正確に再現できるかを確認します。
合わないなら、続けて修正しなさい。
そうして、AIは探索しながら誤りを修正し、ルールはより正確になっていく。
また、以前に学んだ経験は、後のステージでも活かせる。
例えば、記号解読ゲームのtr87のように、AIは最初に記号の向きが意味に影響するかどうかを区別できなかったが、後に異なる方向の記号が同じ文字を表している可能性があることがわかった。
新しいステージが登場するにつれて、プローリングの位置に関する以前の理解が覆される。
全ゲームを通じて、同じルールマニュアルが11回のバージョンに変更されました。
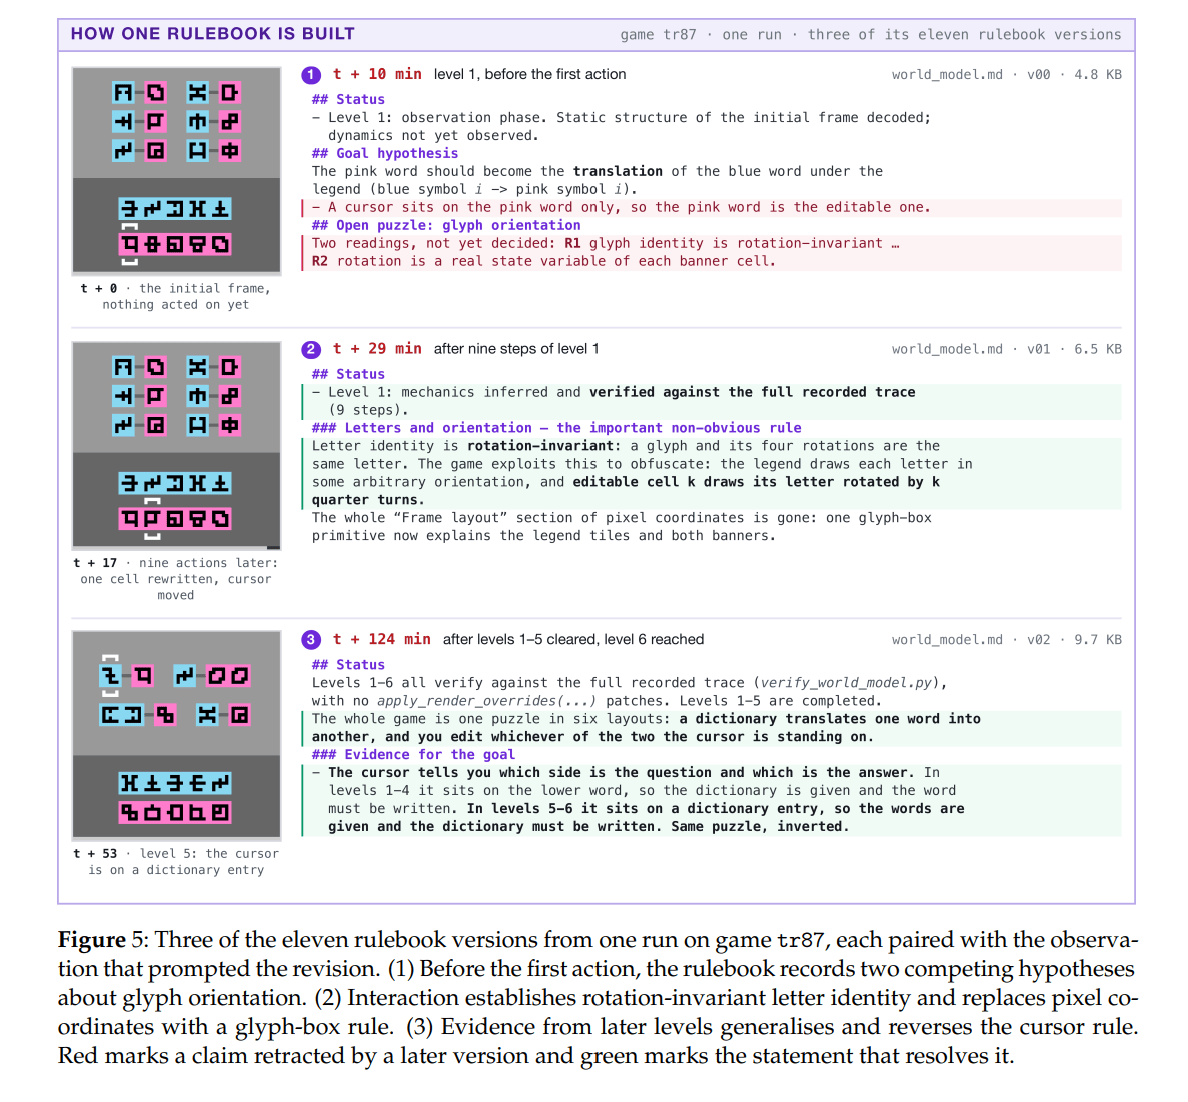
バックトラックを容易にするために、研究チームはGitのバージョン管理も導入した。
毎回ルールやコードを変更する際には記録が残り、間違いがあった場所を見つけた場合、歴史的バージョンを確認でき、必要な時には直接元の状態に戻すこともできる。
いい奴だな、ゲームをプレイするときにコード倉庫のメンテナンスまでやってくれる。
これは、研究チームが言うところの再帰的自己改善(RSI)です。
大規模モデルのパラメータは変更しなくても、AIは経験を積み重ね、ルールやコードを修正することで、どんどん使いこなすようになる。
また、この方法には実際にデータが裏付けられている。
研究チームは3種類のゲームで対照実験を行った:
ルールマニュアルを保持する際、AIは合計で617回の操作を使用した。ルールマニュアルを削除し、コードワールドモデルのみを保持すると、677回の操作が必要になる。
このガイドを手に入れると、操作回数が約9%減少し、スマートアイドルの実行回数も約18%減少します。
しかし、研究チームはこれだけでは満足していません。
世界モデルを一つ使えばAIが遠回りをするのを減らすことができるのに、二つ使うのはどうなるのでしょうか?
そこで、彼らはAIに二つの世界モデルを同時に維持させ、ゲーム操作記録を共有させる一方で、それぞれ異なる規則の仮定を推測させた。
結果として、ゲームwa30では単一世界モデルでは899回の操作が必要でしたが、二世界モデルに変更すると597回に直接減少しました。
操作回数も約34%減少しました。
もちろん、この向上は現在wa30でのみ確認されており、他のゲームに直接適用することはできません。
しかし少なくともこれらの実験において、Memento 3は一つのことを証明しました:
大規模モデルを再学習する必要はありません。AIは世界に対する理解を継続的に修正することで、使えば使うほど強くなっていきます。
ゲームが21:0になったら、AIはもう大規模モデルを呼び出す必要もない
その方法は謎解きゲームでのみ使えますか?
研究チームは、さらに難易度を上げることにし、Memento 3を直接、クラシックな街機ゲームであるAtari Pongに挑むことにした。
以前のパズルゲームとは異なり、今回のボールは絶えず動き、反発する。AIはゲームのルールを理解するだけでなく、リアルタイムでボールの動きを判断し、サーバーでボールを受け取るように制御する必要がある。
結果、この試験で本当に新しいものが見つかりました。
最初は、AIもボールの反発の法則を知らず、打つたびに模索するしかなかった。
彼は最初、ボールペアを4つの区域に分けることができると考えていました。小さなボールが異なる位置で打たれると、対応する方向に跳ね返るのです。
結果が打ち合わさって、突然水平に跳ね返ることがあった。
え?これは前にまとめたルールと合わないよ。
そこでAIは再び衝突位置を分析し、反発式公式を修正した。また新たな軌道の偏差に遭遇すると、さらに調整を続け、実際の状況により適合する運動の法則を徐々に導き出した。
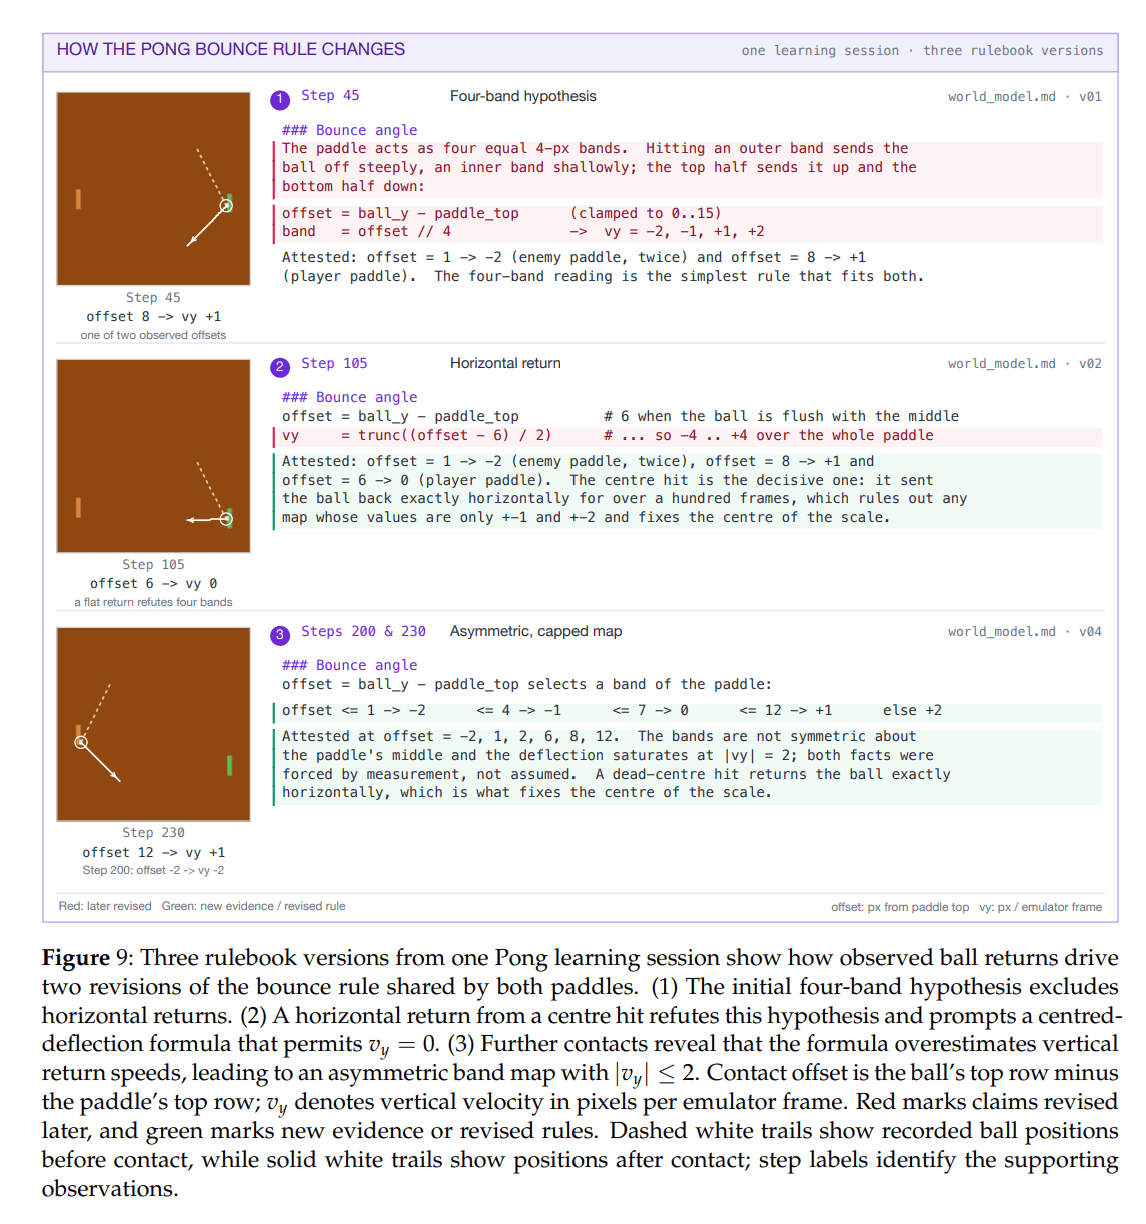
制御戦略が成熟した後、研究チームはこのプログラムを独立して実行させた。
Claude Opus 5を呼び出すことも、ルールを更新することもなくなりました。
結果として、3つの異なる開始方針で、全て21:0で勝利した。
いいや、前はどうプレーすればいいか迷っていて、後ろで相手を一発で止めてしまったのか???
また、注意してください。この時点では、大規模モデルは直接参加する必要はありません。
それは、初期段階でのルールの模索や打ち方のまとめ、その他の戦略を学んだ後は、直接コードに実行させるだけの役割です。
比較すると、世界モデルを使わず、大規模モデルに目の前の画像に基づいて次の操作を決定させるだけの場合、最終得点は-19で、ランダムに無作為に操作する-20.7と大差ありません。
この比較によって、差が明らかになった。
大規模モデルに一歩一歩をやり直させるよりも、まずどのようにプレイするかを学ばせ、その後で打法をプログラムに任せる方が良い。
また、効率もかなり高いです。
論文のデータによると、Memento 3は9500フレームのゲーム画面をほぼ全て使って、この制御戦略を習得したという。
対照的に、一部の伝統的な強化学習方法では、数十万から数億枚のフレームの訓練データが必要になることがある。
もちろん、これはMemento 3にコストがないという意味ではありません。
結局のところ、その背後にはExtra-High推論強度を有するClaude Opus 5が使用されており、探索、コード生成、検証のプロセスには多くのTokenと計算能力が必要です。
また、現在の実験は比較的明確なルールを持つゲーム環境を対象としています。もしより複雑で変化に富んだ現実世界に置き換えた場合、この方法が依然として有効かどうかは、まだ検証が必要です。
しかし、この研究は注目すべき方向を示しています:
再帰的自己改善(RSI)は、モデルの下層の重みを変更する必要はありません。検証可能で実行可能でリロール可能な外部世界モデルを構築することにより、パラメータの一般的な大規模モデルを凍結することもでき、異なる分野で自己反復的に迅速に進化することができます。
論文のURL: