
マルチターンのエージェント型ワークロードでは、エージェントが推論を行い、ツールを呼び出し、以前の結果を取り込むにつれて、蓄積されたコンテキストが増えていきます。新しいターンが追加されるたびに、クライアントはシステム指示、以前のプロンプト、ツールの結果、モデルの応答を含む会話履歴を再送するため、増大し続けるコンテキストが繰り返し処理されます。In プリフィル・デコード(P-D)分離、各リクエストは専門化されたノードに分割されます。プリフィルノードがプロンプトを処理してKVキャッシュを構築し、その後デコードノードがそれらのKVブロックを取得して応答を生成します。
しかし、従来の分散型サービングでは KV キャッシュを一方向に、すなわちプリフィルノードからデコードノードへ転送するだけでした。この一方向の流れは、マルチターンのワークロードに対して 2 つの非効率を生み出します。第一に、応答を生成した後、デコードノードはプロンプトと新しく生成されたトークンの両方の KV キャッシュエントリを保持します。次のターンを処理する際、プリフィルノードはそれらのエントリを取得できないため、前回の応答トークンに対する KV 射影を再計算しなければなりません。第二に、セッション状態をデコードノードだけが保持し、プリフィルノードは保持しないため、プリフィルノード上のアクティブなセッションのキャッシュが退避される確率が高まります。キャッシュが完全にミスした場合、プリフィルノードはシステム指示、過去のユーザーリクエスト、ツールの結果、モデルが生成した応答を含む会話履歴全体の KV 射影を再計算する必要があります。会話が長くなるにつれ、この冗長な処理はアクセラレータの処理能力をより多く消費し、最初のトークンまでの時間(TTFT)を増大させます。
会話型アシスタントやエージェント型アプリケーションを構築するお客様の場合、やり取りの履歴が長くなると、プレフィル計算の繰り返しによってレイテンシーが増大し、アクセラレータのキャパシティを消費する可能性があります。本記事では、その方法を紹介します 双方向KVキャッシュ転送 プリフェイルノードとデコードノードが以前に計算されたコンテキストをターン間で再利用できるようにし、アクセラレータの利用率を向上させ、会話が長くなっても応答性の高いTTFTを維持するのに役立ちます。
AWS Elastic Fabric Adapterで接続されたAmazon EC2 P5enインスタンスを用いた1P1D構成でのマルチターンベンチマークにおいて、我々は(AWS EFA, AWSのサーバー間で利用される低レイテンシRDMAネットワーク)において、双方向KV転送によりTTFTがQwen3-32Bで最大1.6倍、zai-org/GLM-5-FP8で最大3.3倍短縮されました(詳細は パフォーマンスデータ セクション)。結果はワークロードと構成に依存します。
私たちは当初、EFAで接続されたAWS Trainiumインスタンスクラスタ上でこの機能を構築・検証し、アクセラレータに依存しない機能としてvLLMに寄稿しました。ここで示す結果は、EFAを備えたAmazon EC2 P5en GPUクラスタによるものであり、その利点がGPUにも同様にもたらされることを示しています。本記事では、双方向転送アーキテクチャ、ルーターのメタデータフロー、KVブロックの保持と再計算の制御、パフォーマンス結果、そしてベンチマークの再現方法について解説します。
双方向KV転送
双方向KV転送は、会話の後続ターンにおいてデコードノードが以前計算済みのKVをプレフィルノードに返すことを可能にするメカニズムであり、プレフィルノード上での共有コンテキストの再計算を回避します。これは設定可能なKV再計算しきい値によって制御されます。これにより、前述の両方の計算冗長性シナリオが軽減されますが、これを実現するには、KVがそれを生成したターンを超えて存続し、KVキャッシュ対応ルーターによって調整されながら逆方向に転送されることが必要です。
双方向転送のための NIXL KV コネクタの機能強化
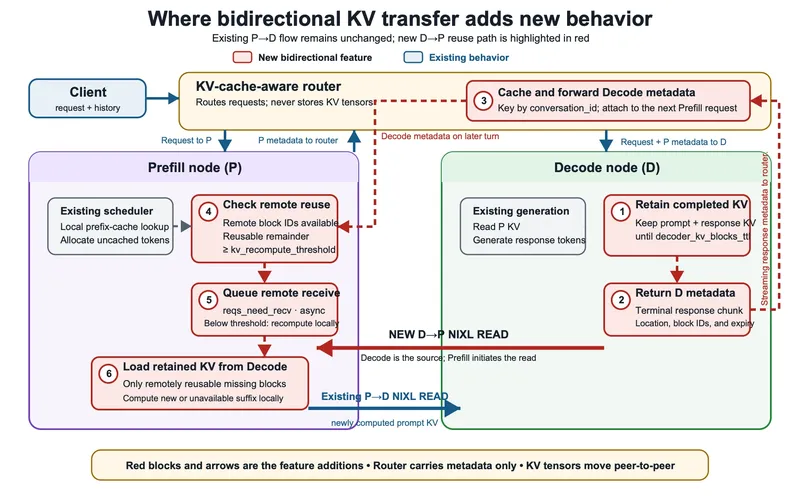
NVIDIA Inference Xfer Library(NIXL)を拡張しました KVコネクタ prefillノードがリモートKVブロックを消費できるようにすることは、decodeノードがすでにprefillノードが提供するKVブロックを消費しているのと同様の仕組みです。これは簡単な変更ではありません。なぜなら、2つのノードタイプはアーキテクチャ的に異なるからです。prefillノードは新しいプロンプトトークンに対するKV表現を計算し、完全なプロンプトKVブロックを提供できます。decodeノードには完全なKV表現を生成する能力(または効率)がなく、以前にキャッシュされたKVブロックしか提供できません。その結果、prefillノードとdecodeノードは、リモートおよびローカルのKVブロックのメタデータを計算するための各自の役割とロジックを依然として担っています。しかし、実際のKV転送メカニズム(NIXL READ)は、両者の間で共通です。 P->D および D->P 方面。
以下の図は、まず既存のフローを青で示しています。ルーターがリクエストをプリフィルノードに送信し、プリフィルノードがプロンプトのKVを計算してブロックメタデータを返し、ルーターがリクエストとメタデータをデコードノードに転送して標準のP→D NIXL READを行います。番号付きの赤いパスは、双方向KV転送の追加を示しています。(1) デコードノードが生成後に適格なKVブロックを保持し、(2) そのメタデータをストリーミングレスポンスで返し、(3) ルーターがそのメタデータを次のプリフィルリクエスト用にキャッシュします。その後、プリフィルノードは (4) ローカルキャッシュの一致を適用した後にリモートで再利用可能なKVをチェックし、(5) 再利用可能なトークン数がしきい値に達すると非同期受信をキューに入れ、(6) 残りのサフィックスを計算する前にD→P NIXL READを実行します。
KVキャッシュ対応ルーター
vLLM はコネクタ側で双方向の KV 転送をサポートしており、会話のターン間での KV 再利用を調整するには KV キャッシュ対応のルーターが必要です。vLLM GitHub には プロキシの例 本記事で説明したフローを実装したもので、ご自身の環境に合わせて調整することができます。
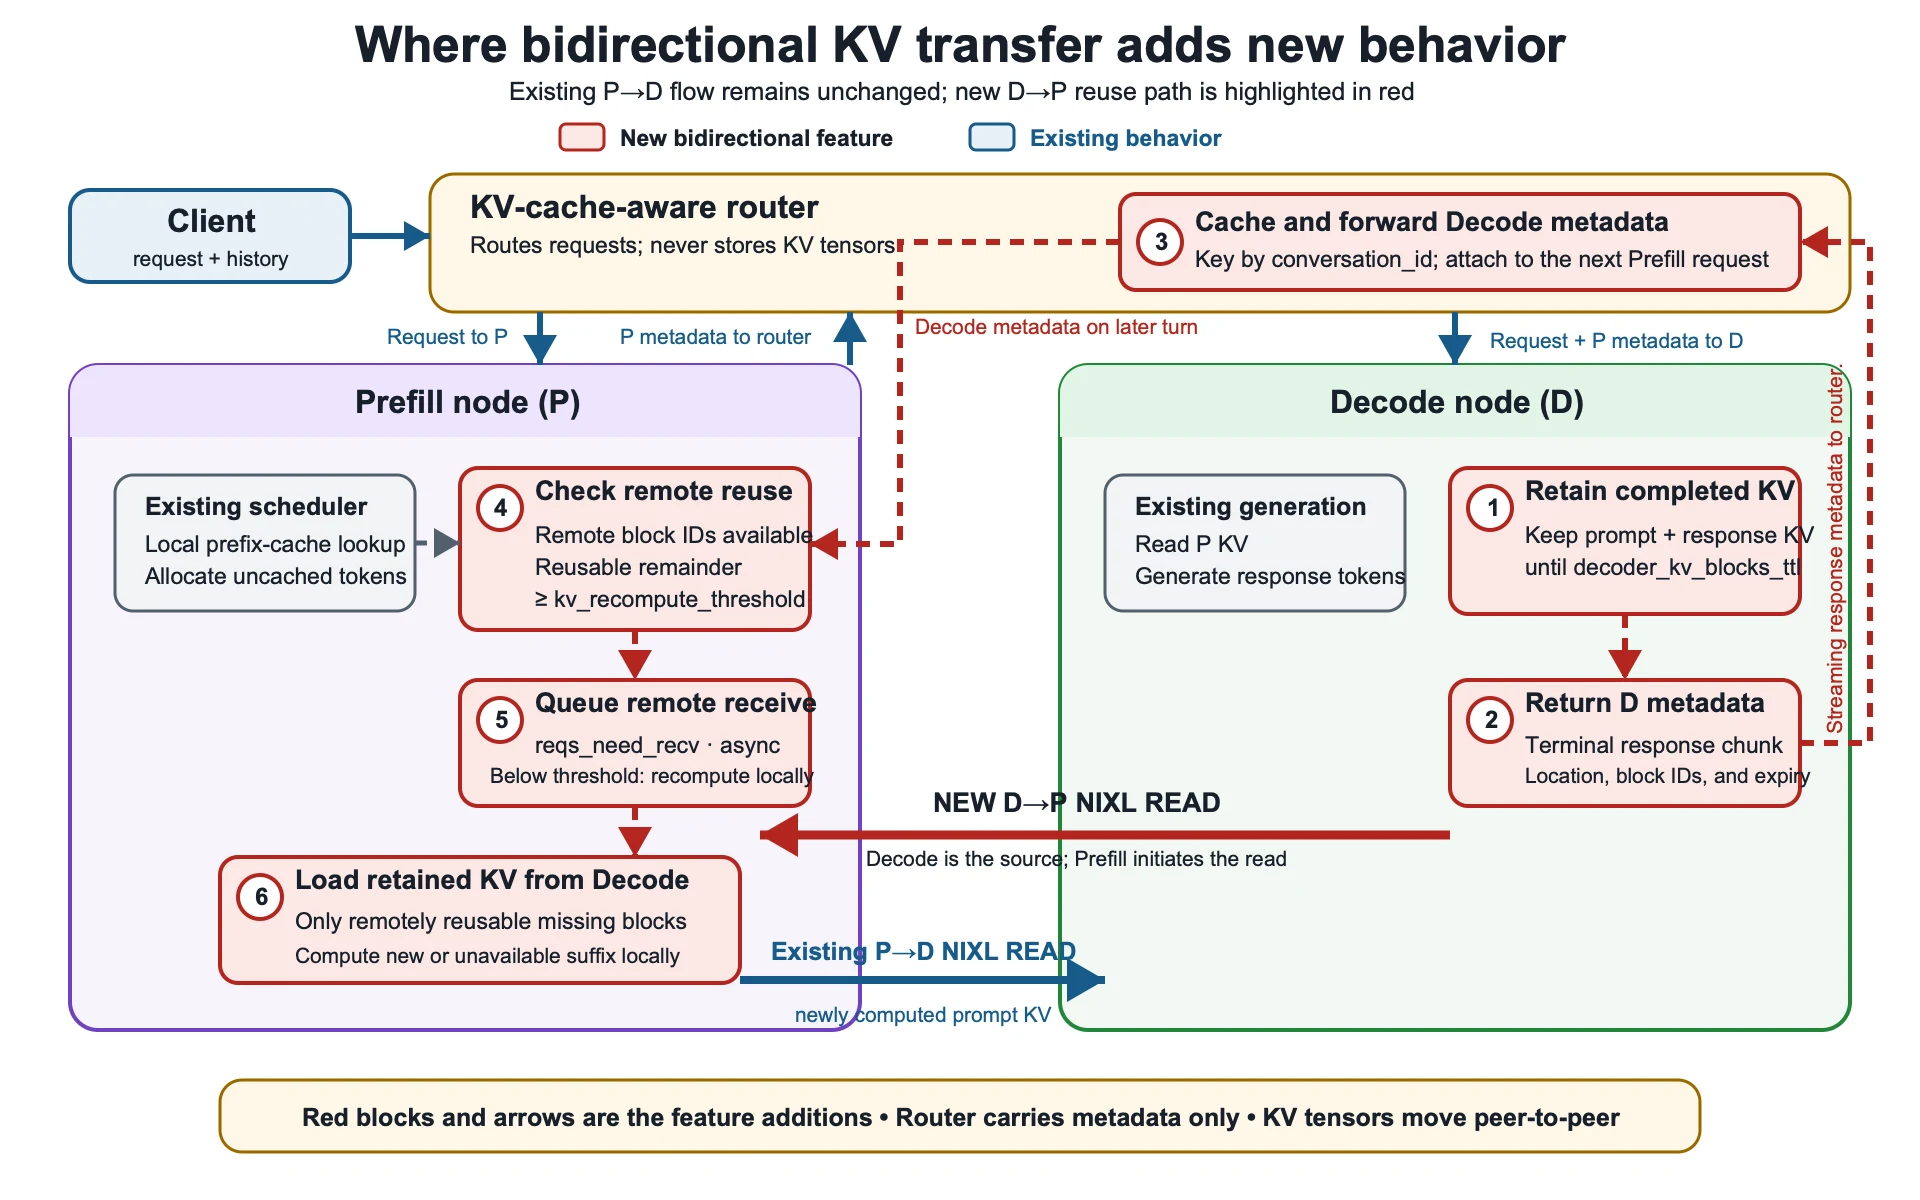
KV-cache対応ルーターは、クライアント、プレフィルノード、デコードノードの間に位置する軽量でステートフルなコントロールプレーンコンポーネントです。クライアントが提供した内容からのインメモリマッピングを維持します。 conversation_id to decodeの kv_transfer_params。ルーターはKVテンソルではなくブロック位置のメタデータのみを保存し、そのメタデータはデコードノードに別途問い合わせるのではなく、レスポンスストリームから取得します。
次の図は、ルーターが会話ターン全体でどのように KV メタデータを管理するかを示しています。最初のターンではキャッシュ参照がミスとなり、リクエストは標準の P→D フローに従います。その後、ルーターはレスポンスストリームからデコードのメタデータを保存します。以降のターンでは、ルーターはそのメタデータを次のものを使って取得します。 conversation_idを付け、prefill が decode の KV を再利用できるようにし、生成後にはメタデータを次のターン向けに更新します。
ブロック保持TTL
通常、デコードインスタンスは生成が終了するとすぐにリクエストのブロックを解放します。双方向モードでは、設定可能な寿命の間それらを保持します(decoder_kv_blocks_ttl, デフォルトは 480 秒)で、その場所と有効期限を公開します。これにより、会話の KV(プロンプトのプレフィックスと生成された応答の両方)が次のターン用に利用可能な状態に保たれます。TTL の期限が切れる前に到着したターンについては、prefill ノードが KV を再利用し、それより後に到着したものは通常の prefill にフォールバックします。この TTL は固定されて更新されないため、KV の再利用とアクセラレータメモリの使用量のバランスを取るために、ターン間の想定時間に合わせて調整してください。自然な次の改善策は、ハートビートで更新されるリースを decode 側にも拡張することです。そうすれば、固定タイマーの終了時ではなく、会話がアイドル状態になった時点で decode インスタンスがブロックを直ちに解放できるようになります。
KV 再計算しきい値
KV再利用は常にローカルでの再計算より速いわけではありません。短い再利用可能なプレフィックスの場合、相互接続と協調のオーバーヘッドがトークンを再計算するのに必要な時間を上回ることがあります。The kv_recompute_threshold この設定(デフォルトは64トークン)がこの判断を制御します。Prefillノードは計算対象のトークン数がしきい値未満の場合は再計算を行い、しきい値以上の場合はdecodeノードからKVを取得します。デプロイメントでは、モデルの計算時間、KVサイズ、相互接続の性能に基づいてこの値を調整できます。
パフォーマンスデータ
評価では、EFAで接続されたAmazon EC2 P5enインスタンスを用いた1P1D構成において、Qwen3-32BおよびGLM-5-FP8モデルを使用しました。プリフィルノードがローカルキャッシュを退避済みである場合や、ルーターが会話のKVブロックを持たない別のプリフィルノードを選択した場合のシナリオをエミュレートするため、プリフィルノード上でプレフィックスキャッシュを以下のように無効化しました --no-enable-prefix-caching.
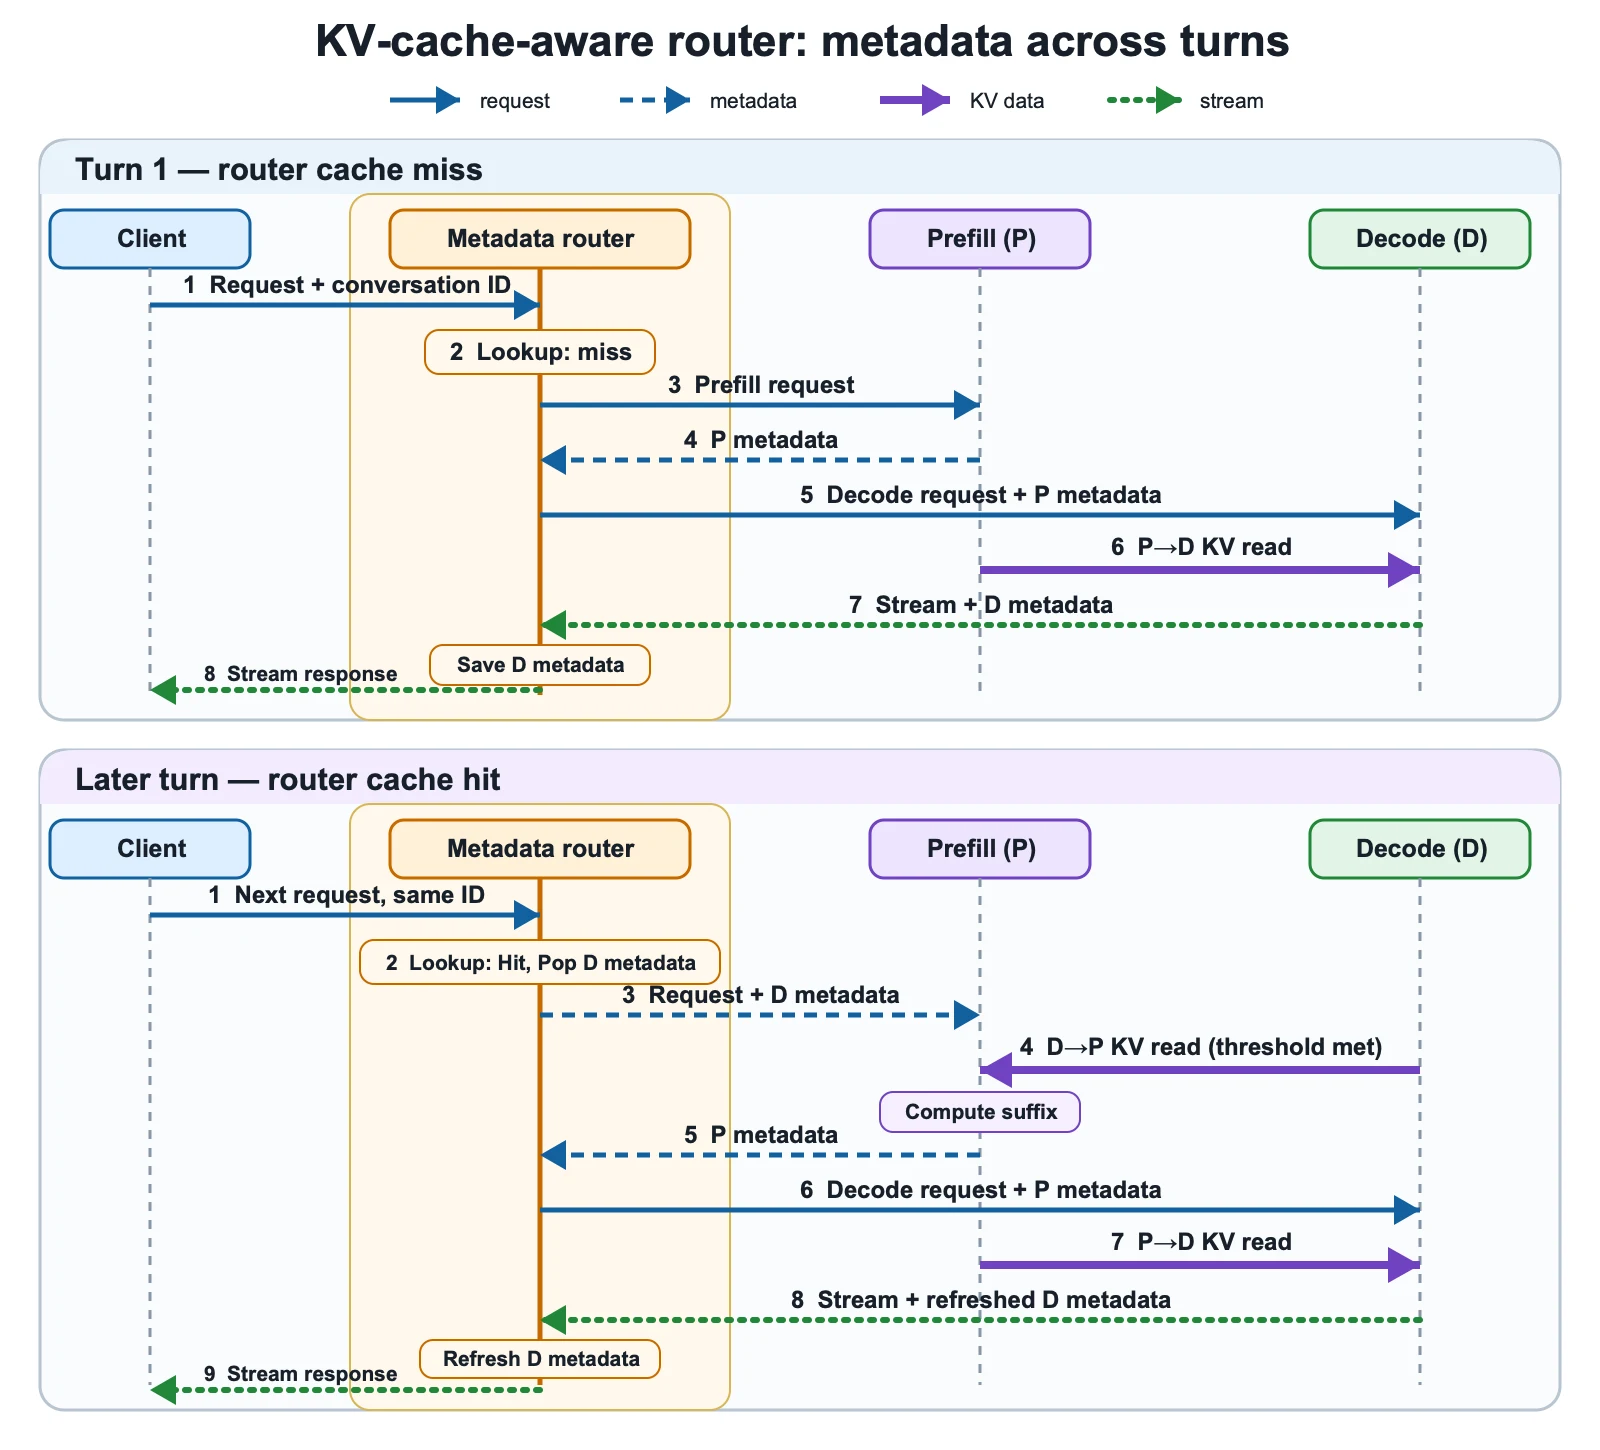
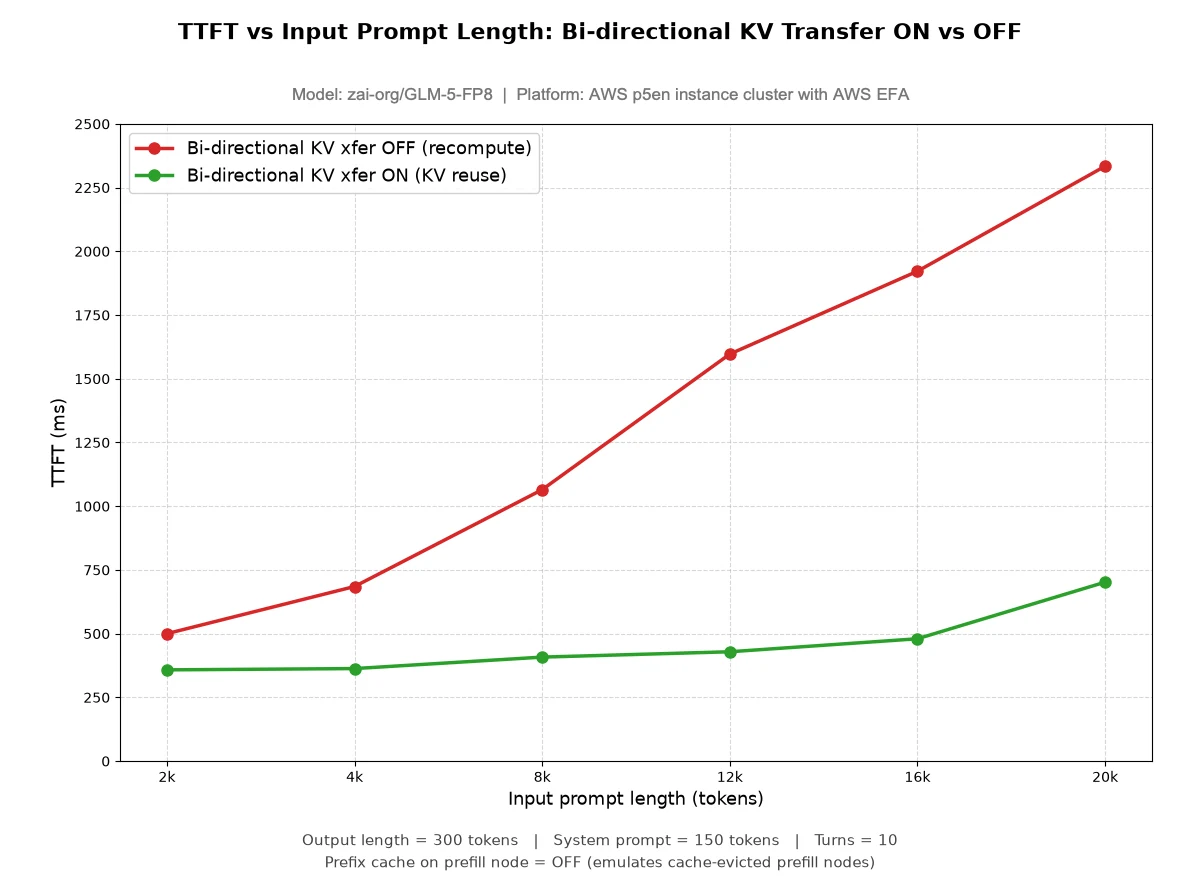
両モデルを通じて、双方向KV転送を有効にするとマルチターン会話におけるプリフィル計算が削減され、その利得は通常プロンプト長が長くなるほど大きくなります。この機能がOFFの場合、プリフィルインスタンスは毎ターン成長したコンテキスト全体を再計算するため、TTFTは急激に上昇します。Qwen3-32Bでは2kで158 msから24kで778 msまで上昇し、GLM-5-FP8では2kで500 msから20kで2,334 msまで上昇します。ONの場合は、デコードインスタンスが保持しているKVが再計算ではなく再利用されるため、TTFTははるかに平坦に保たれます。Qwen3-32Bでは同じ範囲で122 msから460 msしか上昇せず(最長プロンプトで約1.6倍の削減)、GLM-5-FP8では358 msから702 msに上昇し、長いプロンプトでは再計算経路を最大3.3倍下回ります。プリフィル時間の内訳がその理由を説明しています。
双方向転送は小さなKV転送時間を追加します(Qwen3-32Bでは約30ms〜130ms、GLM-5-FP8では約29ms〜110ms)。しかし、それによって省かれるプリフィル計算は、そのKV転送時間をはるかに上回ります。その結果、転送ON時のプリフィル全体の時間(Qwen3-32B:128ms〜414ms、GLM-5-FP8:316ms〜541ms)は、再計算のみの経路(Qwen3-32B:153ms〜744ms、GLM-5-FP8:500ms〜2,331ms)を大きく下回ったままとなります。より大規模なGLM-5-FP8モデルでは絶対的にも相対的にも差が大きくなります。これは、トークンあたりの再計算時間が大きいため、モデルとコンテキストが拡大するほどKV再利用の効果がさらに高まるからです。
Qwen3-32B
以下のチャートは、Qwen3-32Bについて双方向KV転送をONにした場合とOFFにした場合を比較し、プロンプト長に対するTTFTをプロットしたものです。
次のチャートは、同じ実行におけるプリフィル時間を再計算とKV転送の各コンポーネントに分解したものです。
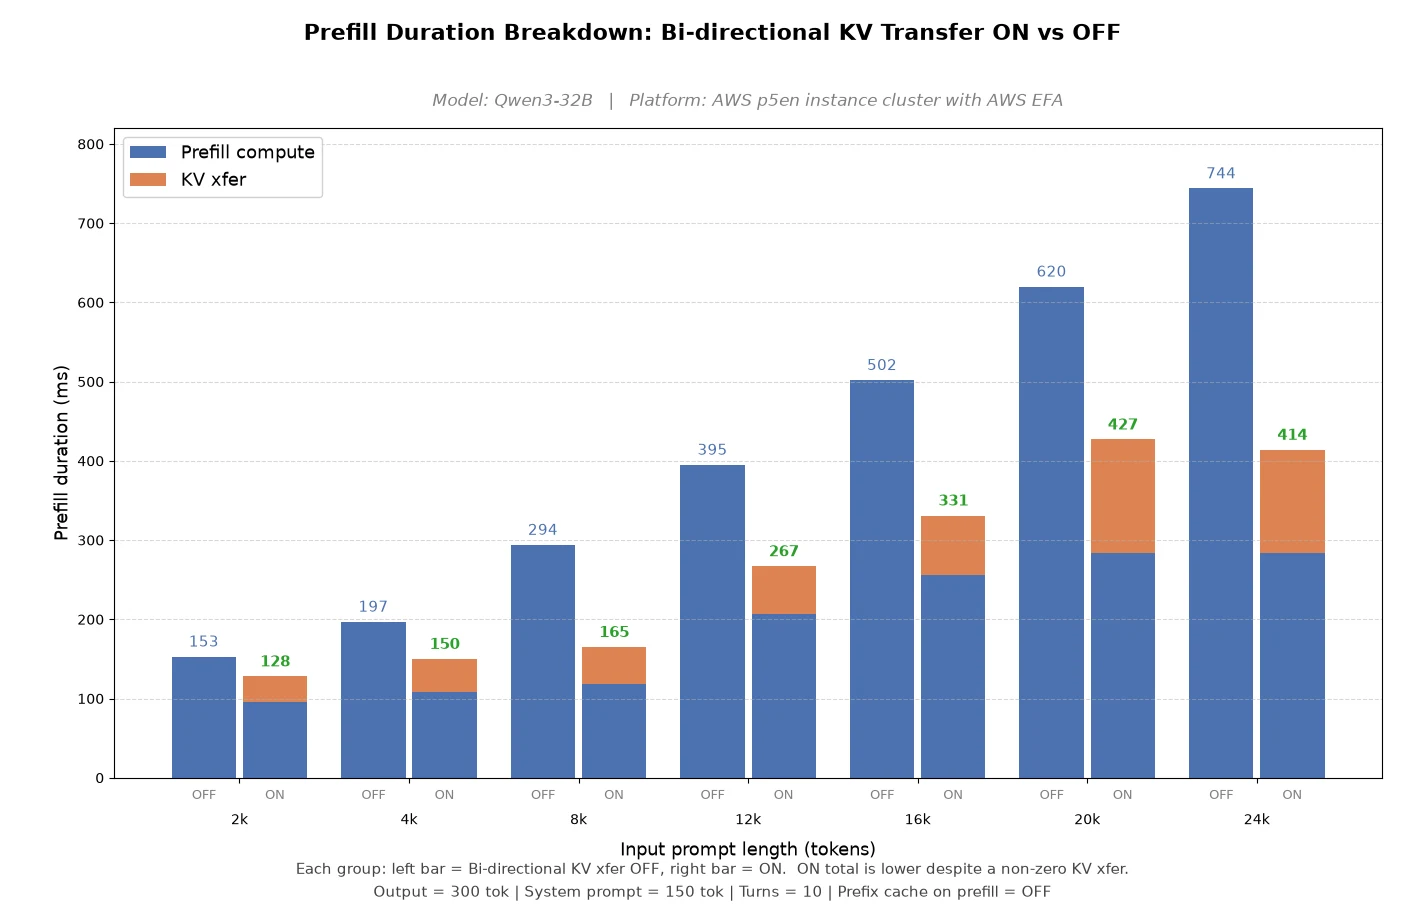
図を総合すると、機能を ON にした場合は TTFT がほぼ横ばいで推移する一方、OFF の経路ではコンテキストが大きくなるにつれて急激に上昇している。これは、小さな KV 転送時間が、それによって排除される再計算のコストに比べてはるかに小さいためである。
zai-org/GLM-5-FP8
同じ2つの見解がGLM-5-FP8にも当てはまります。1つ目のグラフは、機能をONにした場合とOFFにした場合のTTFTをプロンプト長に対してプロットしたものです。
2番目の指標は、プリフィル時間を再計算とKV転送の各要素に分解したものです。
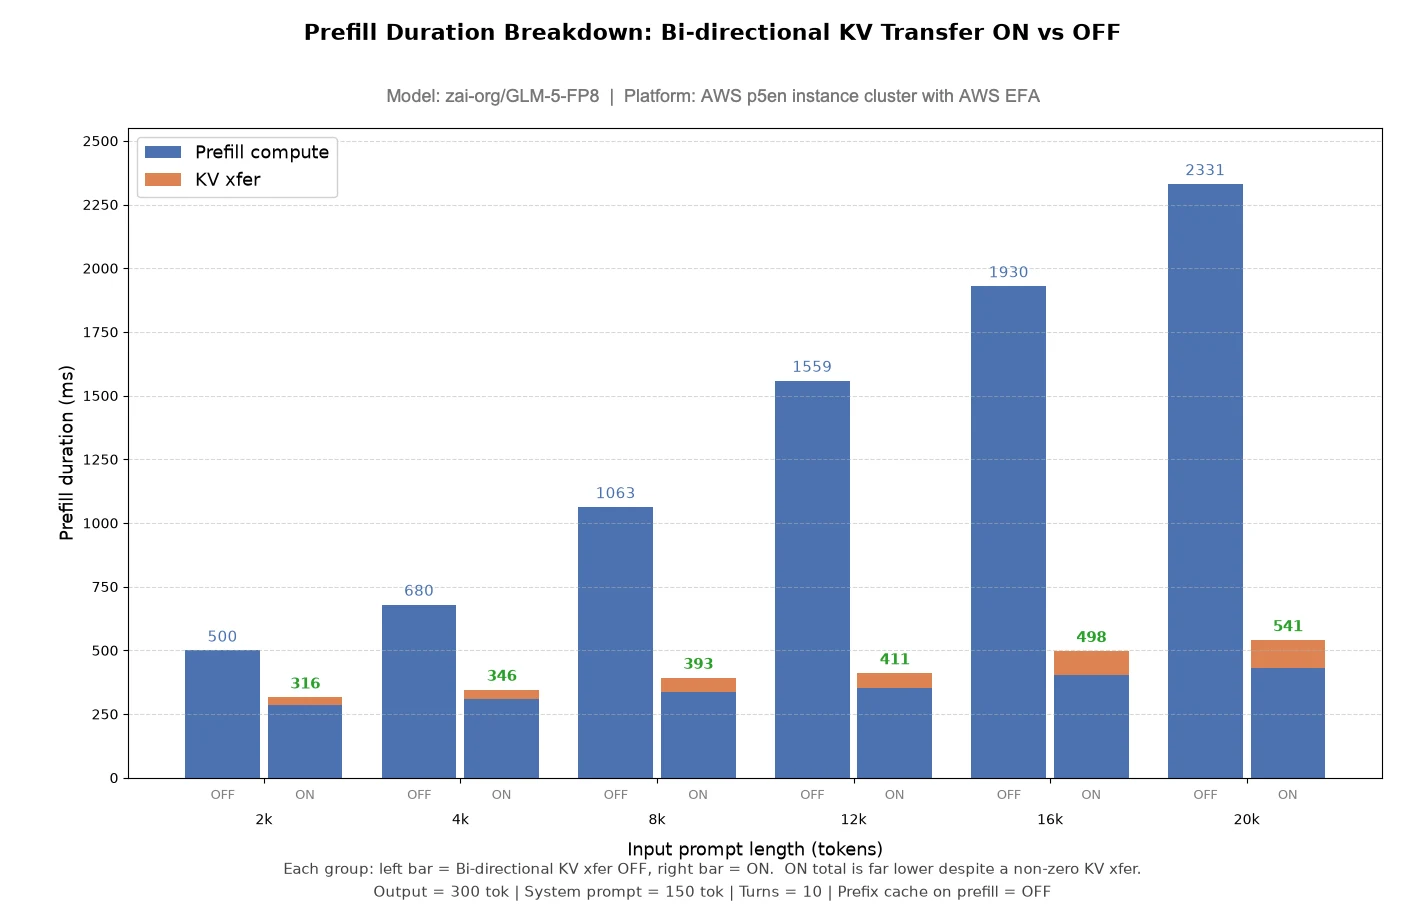
GLM-5-FP8はQwen3-32Bに比べてはるかに大きな差を示し、長いプロンプトではTTFTが最大約3.3倍低下します。これは、トークンあたりの再計算時間が長いため、コンテキスト長が伸びるほどKV再利用の効果がさらに大きくなるためです。
ベンチマークの実行方法
1P1Dベンチマーク構成(1つのprefillノードと1つのdecodeノード)を、EFA搭載のAmazon EC2 P5enインスタンスで再現するには、以下の 当社の結果の再現について 以下のガイド。このガイドでは、環境のセットアップ、vLLM プリフィルサーバーとデコードサーバーの起動、ベンチマークの実行、結果の収集について説明します。この機能は他のサポート対象の構成でも実行できますが、パフォーマンス結果はハードウェア、モデル、ワークロード、およびネットワーク構成によって異なります。
結論
この記事では、エージェントの会話履歴が長くなるにつれて、双方向のKVキャッシュ転送によってTTFTを削減できる方法を示しました。P-D分離デプロイメントでは、この機能によりプリフェルノードがデコードノードがターンをまたいで保持しているKVブロックを再利用でき、繰り返し計算を削減します。設定可能なブロック保持と再計算のしきい値により、再利用が行われるタイミングが決まります。EFAで接続されたAmazon EC2 P5enインスタンスを使用した1P1Dデプロイメントで、テストした最長のプロンプト長において、Qwen3-32Bで1.6倍、zai-org/GLM-5-FP8で3.3倍のTTFT削減が観測されました。結果はワークロードとデプロイ構成に依存します。お使いの環境でこれを実装するには、vLLM v0.21.0以降を NixlConnector, 有効にする bidirectional_kv_xfer prefillサーバーとdecodeサーバーの両方で、KV-cache対応のルーターを使用し、以下に従ってください 繁殖ガイド.
関連リソース
謝辞
この機能の維持にご協力いただいた Nicolò Lucchesi 氏(Mistral)、Mark McLoughlin 氏(Red Hat)、および vLLM コミュニティに感謝いたします。
付録:結果の再現方法
トポロジーは、2つのAWS p5enインスタンス(prefillは :8100, デコードする際に :8200) を EFA 有効化した状態で用意し、さらに 3 つ目の小規模なノードでプロキシとベンチマーククライアントを :8000.
この記事には3つのスクリプトが付属しています: serve_pd_multiturn.sh 機能をオンまたはオフにしてどちらのレッグでも起動し、 run_multiturn_sweep.sh プロンプト長のスイープを実行し、 cleanup.sh デプロイメントを解体します。
テスト環境
両方のGPUノードは同一に構成されました:
| インスタンスタイプ | p5en.48xlarge (8x NVIDIA H200)、1つはprefill用、もう1つはdecode用 |
| リージョン / AZ | ap-south-1 (ムンバイ)、 ap-south-1b (AZ ID aps1-az3)、両ノードとも同じAZ内 |
| プレースメント | クラスタ配置グループなし。両方のインスタンスを、対象を指定したOn-Demand Capacity Reservation、デフォルトテナンシーに起動 |
| AMI | Ubuntu 24.04 x86_64 用の公開 AWS ParallelCluster 3.14.2 イメージ、 aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae で ap-south-1; AMI ID はリージョンごとに異なります)。カーネルを同梱しており 6.14.0-1018-aws、NVIDIA ドライバー 570 および CUDA 12.8 が必要なため、ドライバー、CUDA toolkit、EFA インストーラーを以下のバージョンにアップグレードしてください。 |
| OS / カーネル | Ubuntu 24.04.4 LTS、 6.14.0-1018-aws |
| NVIDIAドライバー / CUDA | ドライバー 580.126.16 (CUDA 13.0 ドライバー API); CUDA toolkit 13.0 |
| EFA インターフェース | インスタンスあたり16、ネットワークカードごとに1つ(カード0~15、すべてのインターフェースタイプ efa`)、各200 Gb/s、合計3.2 Tb/s。8つのインターフェースが各NUMAノード上にあり、各GPUはそのうち2つとPCIeスイッチを共有します。` |
| EFAソフトウェア | EFAインストーラー 1.50.0, EFA カーネルモジュール 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
NIXLによるEFAデバイスの選択。 LIBFABRICバックエンドは、16個のEFAデバイスすべてをレールとしてオープンし、 efa provider。その後、各GPUのKVキャッシュを、そのGPUのPCIeスイッチを共有する2つのレールにのみ登録するため、すべての転送がPCIeローカルに収まります。NIXLやlibfabricのデバイス上書きは設定されていません。これはデフォルトの選択です。自身のノードで確認するには、次のようにサーバーを起動します。 NIXL_LOG_LEVEL=DEBUG 登録行を確認してください:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. ノードをプロビジョニングする
GPU ノードの両方に EFA ユーザースペーススタックをインストールし、プロバイダーが存在することを確認します。インストーラーには 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa -t FI_EP_RDM            # verify the EFA provider is present on both GPU nodes
2. 両方のGPUノードにvLLMとNIXLをインストールする
python3 -m venv ~/venv-pd && source ~/venv-pd/bin/activate
pip install --upgrade pip && pip install vllm==0.29.0 nixl==1.4.1
vLLM PRを適用 #40186 両ノードで一度実行します。これによりアタッチされます kv_transfer_params に ストリーミング マルチターンプロキシがターンを関連付けるために必要な応答であり、プロキシは常にデコードノードに対して以下を照会します。 stream=Trueそのため、このパッチがないとデコードノードはブロックのメタデータを決して返さず、毎ターンがキャッシュミスとして扱われます。
SITE=$(python -c 'import site; print(site.getsitepackages()[0])')
curl -sL https://github.com/vllm-project/vllm/pull/40186.diff -o /tmp/40186.diff
patch -p1 -d "$SITE" --fuzz=3 < /tmp/40186.diff
3. モデルをダウンロードする
export HF_HOME=/fsx/huggingface        # a large shared volume
hf download Qwen/Qwen3-32B
4. P/Dペアを起動する
実行 serve_pd_multiturn.sh GPUノードごとに1回。 BIDIR は A/B の2つの区間で唯一変化する要素であり、両方のノードで一致している必要があります。
# on the prefill node
P_IP=<P_IP> D_IP=<D_IP> ROLE=prefill BIDIR=false ./serve_pd_multiturn.sh
# on the decode node
P_IP=<P_IP> D_IP=<D_IP> ROLE=decode  BIDIR=false ./serve_pd_multiturn.sh
プリフィル側では次のように展開されます:
export FI_PROVIDER=efa
export VLLM_NIXL_SIDE_CHANNEL_HOST=<P_IP> VLLM_NIXL_SIDE_CHANNEL_PORT=5600
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 \
  --no-enable-prefix-caching --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"],
    "kv_recompute_threshold":64,"decoder_kv_blocks_ttl":480,
    "bidirectional_kv_xfer":false}}'
--no-enable-prefix-caching はプリフィルノードにのみ設定します。これがベンチマークがエミュレートするキャッシュエビクションのシナリオです。デコードノードではプリフィックスキャッシュを有効のままにしておいてください。両方の /health エンドポイントが 200 を返すようにする。
5. マルチターンプロキシを起動する
python3 -m venv ~/venv-proxy && source ~/venv-proxy/bin/activate
pip install fastapi uvicorn httpx pandas numpy aiohttp transformers tqdm
sudo dnf install -y jq || sudo apt-get install -y jq
git clone --depth 1 --branch v0.29.0 https://github.com/vllm-project/vllm.git ~/vllm_src
export VLLM_SRC=~/vllm_src

python3 $VLLM_SRC/examples/disaggregated/disaggregated_serving/disagg_proxy_multiturn.py \
  --port 8000 --prefiller-host <P_IP> --prefiller-ports 8100 \
  --decoder-hosts <D_IP> --decoder-ports 8200 \
  2>&1 | tee ~/proxy_$(date +%Y%m%d_%H%M%S).log
プロキシが受け取るのはURLではなくホストとポートです。再利用はクライアントが送信することによって行われます。 conversation_id、そのためここでは有効化するフラグはありません。
6. OFF側の区間を実行し、その後にON側の区間を実行する
VLLM_SRC=~/vllm_src LEG=off ./run_multiturn_sweep.shONを切る手順では、両方のサーバーとプロキシを停止し、手順 4 を以下のように再実行します。 BIDIR=true 各ノードでプロキシを再起動し(その会話キャッシュはプロセス内にあります)、その後次を実行してください:
VLLM_SRC=~/vllm_src LEG=on ./run_multiturn_sweep.shGLM-5-FP8 についても同じ手順を両方の脚で繰り返します。 MODEL=zai-org/GLM-5-FP8 SERVED_NAME=GLM.
7. 数値を収集する
ソースごとに 1 つ、合計 3 つの量:
- TTFT(初回トークンまでの時間)、これはベンチマークが書き出したリクエストごとの統計JSONに由来し、
--stats-json-output。各レコードにはttft_msに加えてinput_num_tokensおよびconversation_id。これがTTFTチャートのy軸です。 - プリフィル所要時間。プロキシログより取得。このログは各リクエストのプリフィル区間を次のように報告しています。
Prefill done in <N>ms。これはプリフィル所要時間の内訳における各バーの合計の高さです。 - KV transfer time and volume, from the prefill node's log, which reports
KV Transfer metrics:平均とP90の転送時間、1転送あたりのバイト数、およびスループットの行。これは各ONバーのKV-xferコンポーネントです。
NIXLのテレメトリは転送を開始した側によって記録されるため、D->P の読み戻しは prefill ノードのログに、通常の P->D のプルは decode ノードのログに現れます。
各数量をプロンプト長ごとに平均し、プロットします。TTFTをプロンプト長に対して2本の線(ONとOFF)で示し、プリフィル所要時間はプロンプト長ごとにペアの積み上げ棒グラフで示し、ON側の棒はプリフィル計算とKV転送に分割します。この2つの見方の違いがポイントです。棒グラフが明らかにする転送コストを、TTFTの線が節約という形に変換して示すのです。
トラブルシューティング
- プロキシは常にログを記録します
cache MISS「ONランで」 — 不明--send-conversation-id`、PR #40186 が両方のノードに適用されていない、または`BIDIR=falsedecode ノードに残され、その場合は何も返しませんkv_transfer_paramsまったくありません。 Declining expired remote readプリフィルノード上で — 次のターンが到着する前にデコードノードのブロックが失効してしまいました。decoder_kv_blocks_ttl(デフォルト 480 s)を引き上げ、プロキシのキャッシュ TTL をそれ以下に保ってください。fi_info -p efaが空でソケットにフォールバックされる — EFA プロバイダーが欠落しています。再インストールしてください。aws-efa-installerそのうえで、インスタンスが EFA 対応インターフェース付きで起動されていることを確認してください。なければ NIXL は初期化に失敗するか、あるいは黙って TCP 経由で動作し、転送数値が無意味なものになります。
クリーンアップ
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
続いてインスタンスを終了し、実行中のものが残っていないことを確認してください。