IT之家 AI

9年前のナンバーワン・エヂワード・Tesla V100でベテランが再挑戦:4GPUクラスターによるAI推論で2台のDGX Sparkを上回る

IT之家 10月13日の報道によると、YouTubeチャンネル「Jun Yamog」は昨日(10月12日)に動画を公開し、4台のTesla V100をNVLinkベースプレート上に搭載したテストを行った。Qwen3.8-Flash-Nextベンチマークにおいて、長いプロンプト処理速度はM5 Ultraより230%、2台のDGX Sparkより40%も速かった。IT之家が公開情報を調査したところ、Tesla…

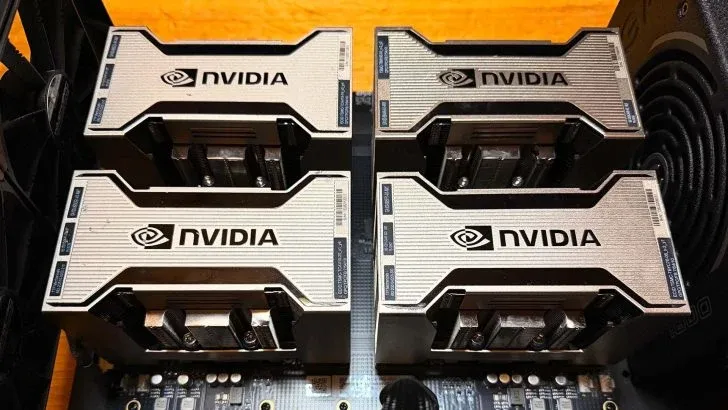
Four NVIDIA graphics cards are installed in a computer setup with visible branding and heatsinks.
画像の出典 · IT之家 AI

IT之家 10月13日の報道によると、YouTubeチャンネル「Jun Yamog」は昨日(10月12日)に動画を公開し、4台のTesla V100をNVLinkベースプレート上に設置するテストを行った。Qwen3.8-Flash-Nextベンチマークにおいて、長いプロンプトの処理速度はM5 Ultraより230%、2台のDGX Sparkより40%速い。

IT之家の公開情報によると、Tesla V100はニューラブが2017年に発表したデータセンター用GPUで、Voltaアーキテクチャを基盤としており、AIのトレーニングや推論に広く使用されています。32GB版にはHBM2メモリが搭載され、900GB/sのメモリ帯域幅により、大規模なパラメータやデータの迅速な読み込みをサポートします。

NVLinkはNVIDIAのGPU高速接続技術であり、複数のGPU間でデータを直接伝送するために使用されます。PCIe通信と比べて、NVLinkは接続のボトルネックを低減でき、多GPUサーバーやAI計算クラスターに広く利用されています。
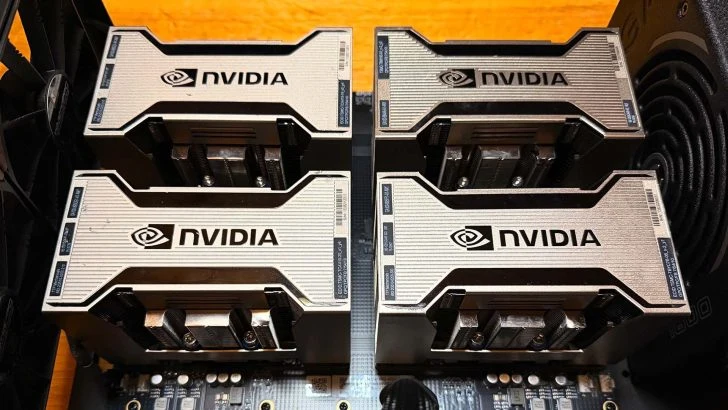
Four NVIDIA graphics cards are installed in a computer setup with visible branding and heatsinks.

このNVLinkカードプレートは300GB/sの帯域幅を提供し、6本のNVLink 2.0接続を備えています。4個の独立したGPUを収容するために、テスト者はNVIDIA A100ヒートシンクを改造し、各V100が約300Wの消費電力を発散可能にし、PCIe x8インターフェースを通じてカードプレートに接続しました。

その配信者は、4ビット量化されたQwen3.8-Flash-Nextモデルを使用してテストを行い、比較対象には128GB LPDDR5X統一メモリを搭載した2台のDGX Sparkや、M5 Ultraチップを搭載したMac Studioデバイスが含まれる。
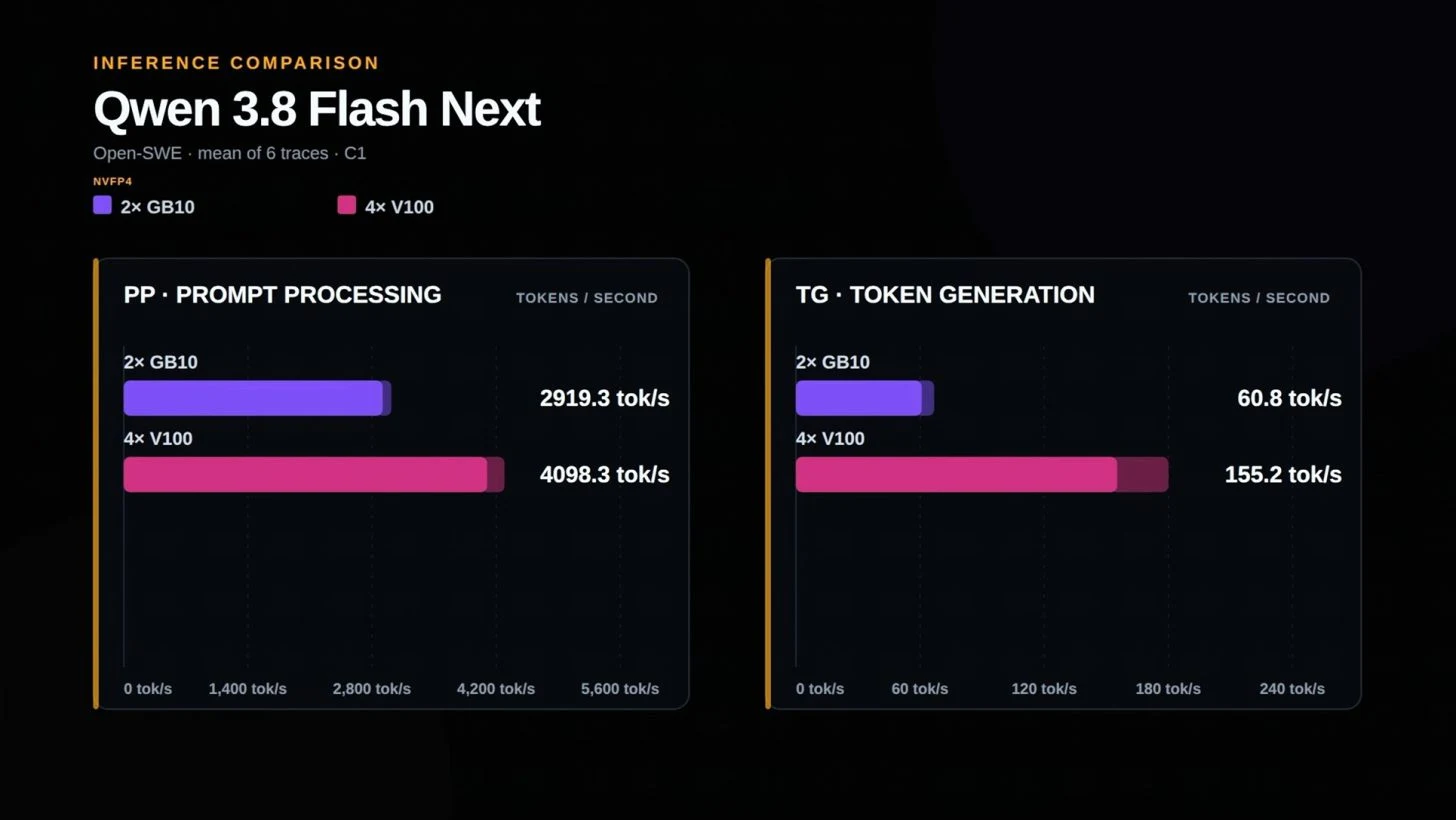
A comparison chart titled 'Qwen 3.8 Flash Next' shows that the 4x V100 configuration outperforms the 2x GB10 in both 'Prompt Processing' with 4098.3 tok/s and 'Token Generation' with 155.2 tok/s.

長いヒント処理テストにおいて、4個のV100はDGX Sparkクラスタより40%速く、M5 Ultraより230%速かった。テスターは、Apple Siliconとの大きな差異が、ソフトウェアの最適化が不十分によるものかもしれないと指摘した。
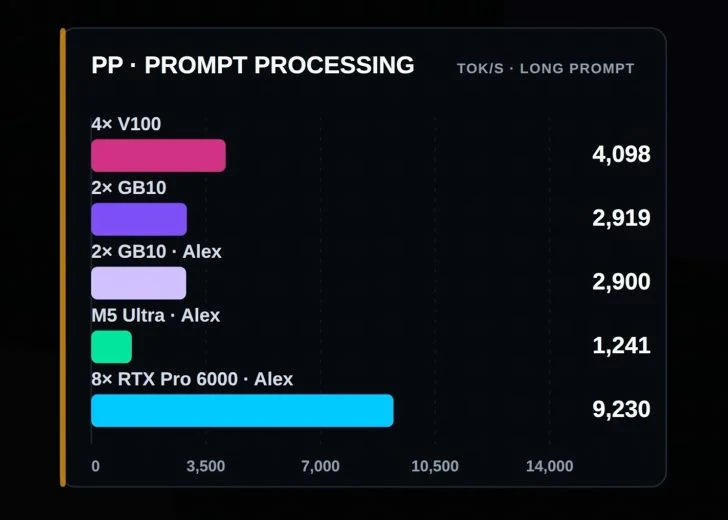
A bar chart titled 'PP - Prompt Processing' shows the 8x RTX Pro 6000 achieving the highest score of 9,230 TOK/S with 'Long Prompt', significantly outperforming other configurations.

短いヒント処理テストにおいて、V100クラスターはDGX Sparkより40%の速度優位性を持ち、M5 Ultraより163%速い。この結果は、旧式データセンターダウンキューブレッドが特定の推論負荷において依然として高いスループット能力を持っていることを示している。
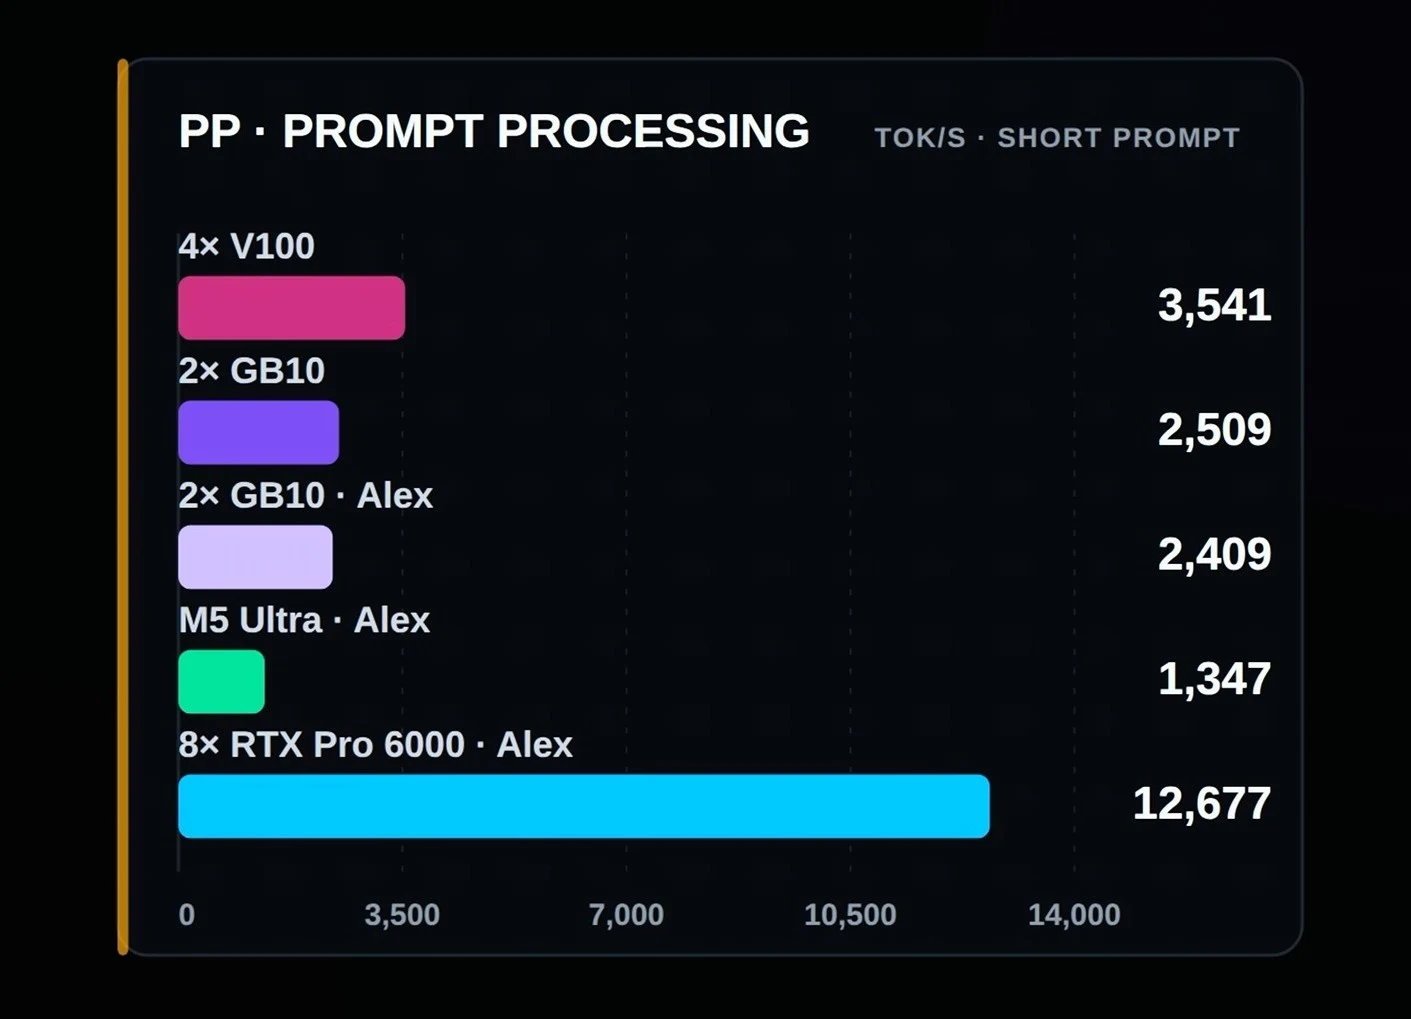
A bar chart titled 'PP · PROMPT PROCESSING' shows '8× RTX Pro 6000 · Alex' leading with a score of 12,677, outperforming other configurations like '4× V100' and '2× GB10'.

短いプロンプトのToken生成テストでは、4台のV100が100.6 tok/sを記録し、2台のDGX Sparkより121%速い。M5 Ultraのスコアは44.5 tok/sであった。
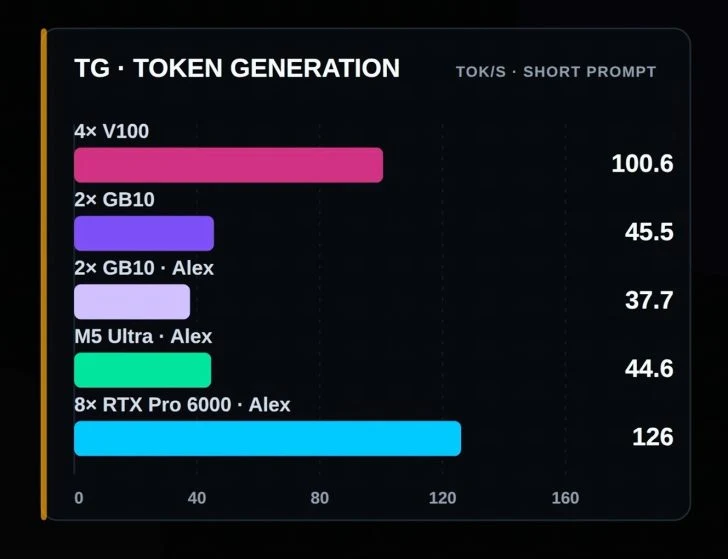
A bar chart titled 'TG · Token Generation' shows '8× RTX Pro 6000 · Alex' achieving the highest score of 126 TOK/s for short prompts.

原文の出典

IT之家 AI

内容について

原文の公開と権利は出典元に帰属します。

機械翻訳 · 原文をご参照ください