
重要なポイント
- 長時間稼働するエージェントの構築には絶え間ないコンテキスト管理が必要であり、その判断をフロンティア LLM で行うのは遅く高コストです。ScaleDown の制約付きデコーディングモデル(CDM)を使えば、これらをより速く、より安く行えます。
langchain-scaledownエージェント内で ScaleDown モデルを簡単に利用でき、要約、ツール結果の圧縮、抽出のためのミドルウェアが同梱されています。- ScaleDown は LangSmith LLM Gateway でサポートされるようになり、その呼び出しはトレースされ、支出額およびレート制限の対象にカウントされます。
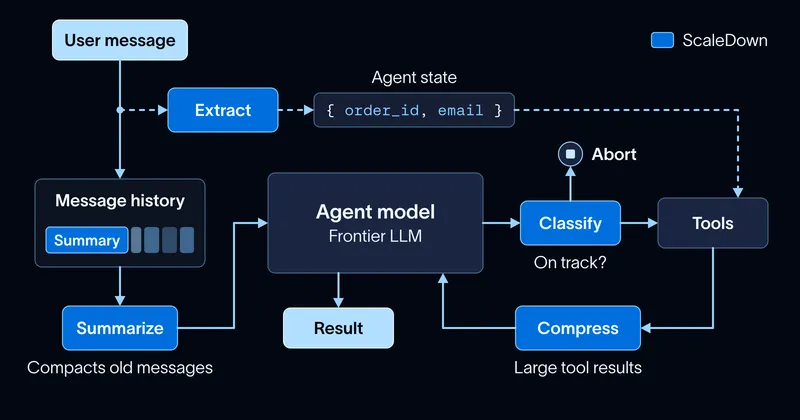
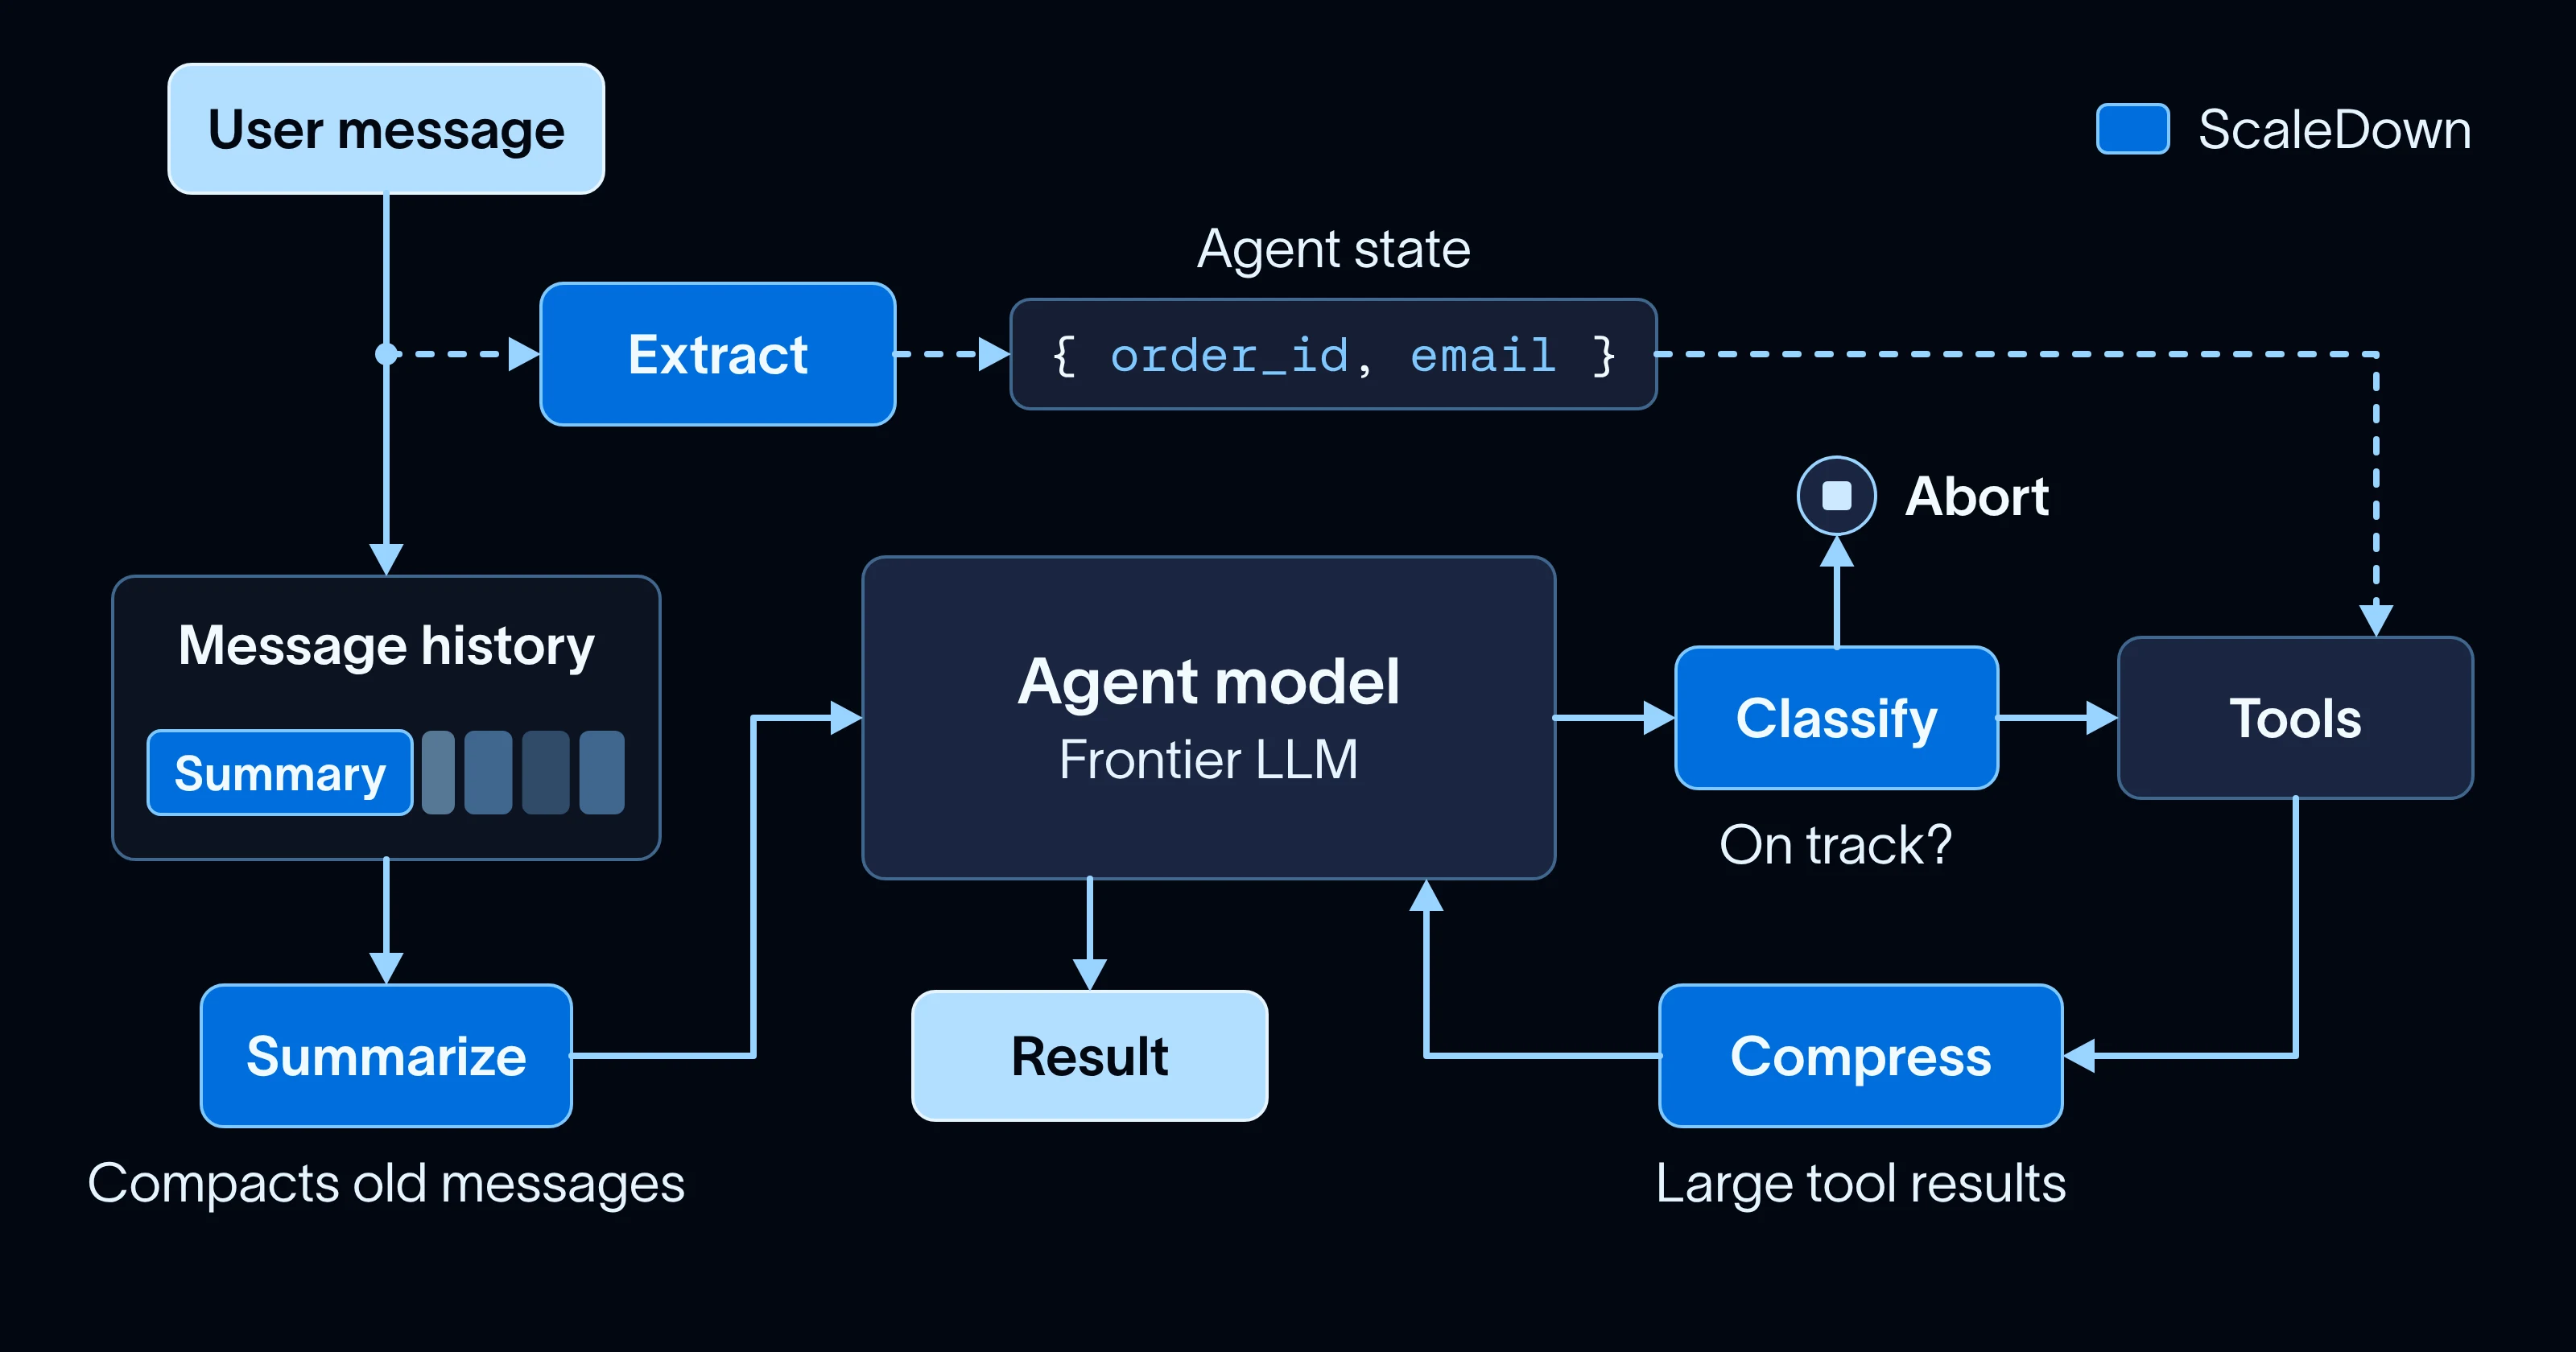
長時間稼働するエージェントの構築は、要するにコンテキスト管理の技術です。どの情報を、いつコンテキストウィンドウに入れるかを決めることです。つまり、古い履歴の要約、大きなツール結果の圧縮、長い入力からの適切なデータの抽出を行います。これらの各ステップは判断です。従来、私たちはそれらを LLM で行ってきましたが、長時間稼働するエージェントが必要とする量では遅く高コストでした。
これらの判断をより速く、より安くするために、私たちは現在 langchain-scaledown 統合と、 LangSmith LLM Gateway でのサポート を通じて、 ScaleDownの制約付きデコーディングモデル(CDM)を提供しています。汎用 LLM が任意の文字列をトークンごとに書き出すのに対し、CDM は 1 つのタスクに向けて訓練されており、そのタスクで許容される回答、たとえばリスト内のラベルや入力のスパンのみを返します。そのため、はるかに小型で高速かつ安価になります。ScaleDown によれば、これらの限定的なタスクにおいて、そのモデルはフロンティアモデルより 200 倍速く、467 倍安価です。
この統合には、 LangChain および Deep Agents 向けの 3 つの ミドルウェアが同梱されています。1 つは古い履歴を要約し、1 つは大きなツール結果を圧縮し、もう 1 つは会話から構造化データを抽出します。この記事では、ScaleDown のモデルとは何か、そしてそれらを使ってエージェントのコンテキストを scale down する方法について説明します。
ScaleDown はどのようなモデルを提供していますか?
ScaleDown には 4 つのモデルがあり、それぞれが単一のタスクに向けて訓練されているため、汎用 LLM よりはるかに効率的です:
- Summarize は長文の短い要約を書き出します。
- Compress はコンテキストのブロックを、質問に関連する部分に切り詰めます。
- Extract はテキストから指定したフィールドを、それぞれ信頼度スコアとソース内の位置付きで取り出します。
- Classify 定義したラベルに対してテキストを評価し、それぞれの確率を返します。分類が行われた理由を自然言語で返すかどうかは、あなたが決められます。
すべてのモデルは最大で 1Mトークン の入力を受け付けるため、完全な契約書、長いポリシーページ、または1時間分のエージェント履歴も、チャンク分割なしで1回の呼び出しに収まります。また、これらは マルチモーダルでもあります。Extract、Summarize、Classifyは、非構造化テキストに加えて画像やスキャンしたPDFを直接受け付けるため、スクリーンショットやスキャンした請求書も入力として機能します。
GPT-5.5、GPT-5.4 Mini、GPT-5.4 Nanoの平均と比較して 公開データセット、GPT-5.5、GPT-5.4 Mini、およびGPT-5.4 Nanoの平均値と比較して、次の上で測定された ScaleDown独自のベンチマークによると、Summarizeは41倍安価で2.7倍高速、Compressは138倍安価で1.8倍高速であり、どちらも精度でより高いスコアを記録しています。
Jevのような 決定モデルを使ったことがあれば、ScaleDown Classifyは馴染みのあるものに感じられるでしょう。どちらも確率付きの型付き回答を返します。Jevは テキストのみ、質問あたり最大32Kトークン の状態を扱えます。Classifyは最大1Mトークン、画像を含めて扱え、さらに 各決定に1文の理由を追加 します。エージェントがラベルに基づいてチケットをルーティングしたり実行を停止したりする際、その理由が「なぜ」を教えてくれるため、エージェントのデバッグが容易になります。
メッセージ履歴の 要約
長時間実行されるエージェントには要約が必要です。履歴がやがてコンテキストウィンドウを超えてしまうからです。1時間作業してきたコーディングエージェントの履歴には、数十件のファイル読み取りやツール出力が含まれており、そのほとんどは逐語的にはもう必要ありません。履歴が満杯になるたびに別のフロンティアモデルの呼び出しで要約すると、コストとレイテンシが毎回発生します。
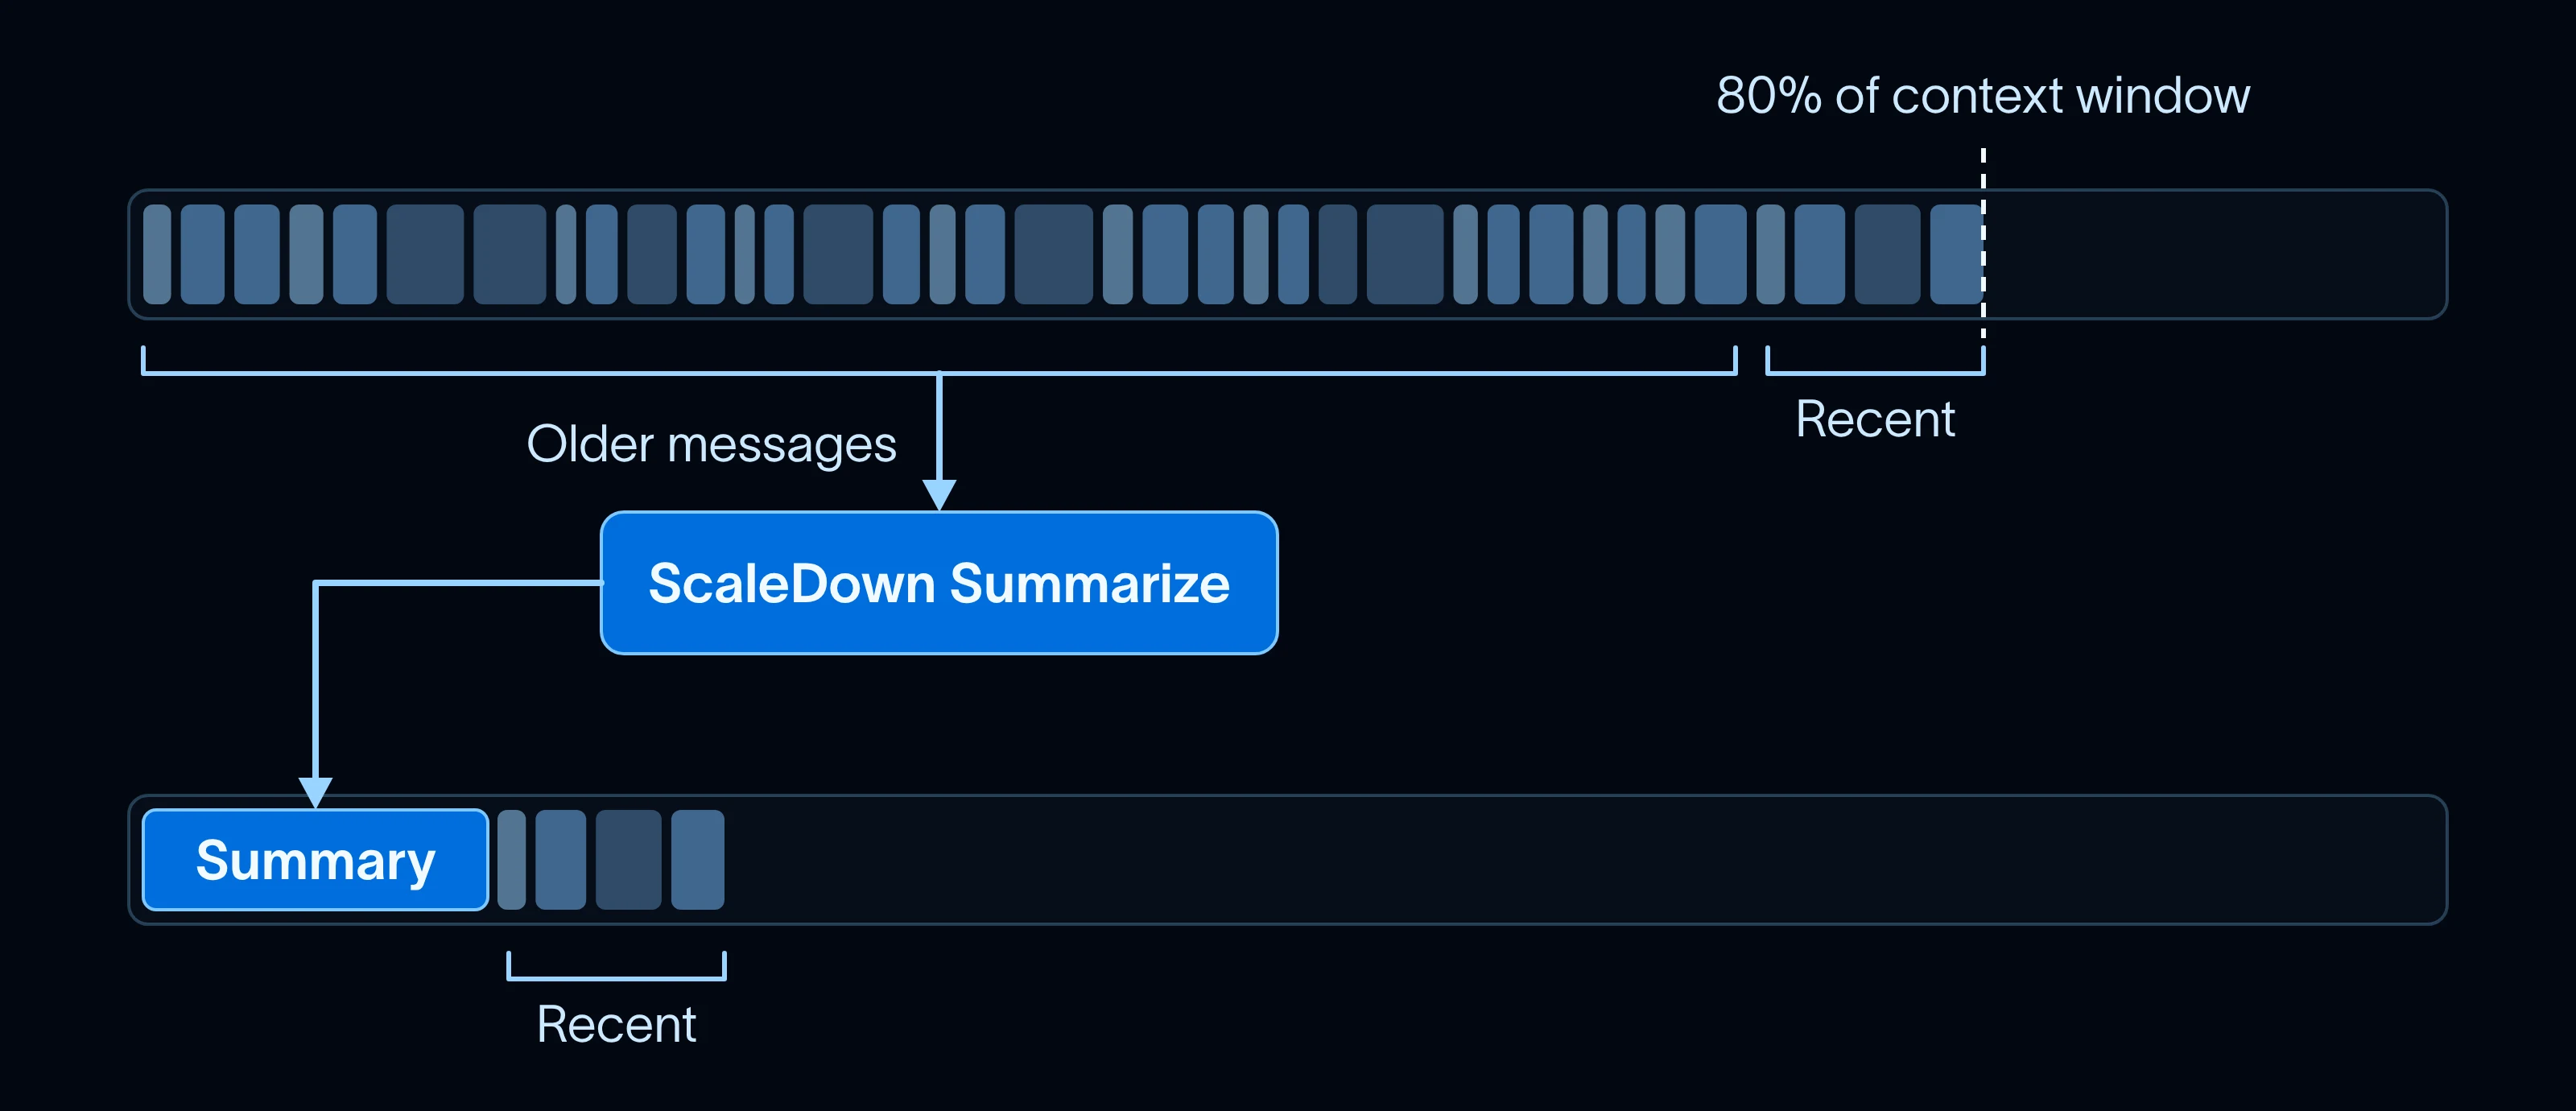
ScaledownSummarizationMiddleware は、Deep Agents に組み込みの 要約ミドルウェアを置き換えます。同じ trigger と keep オプションを受け取り、いつ要約するか、どの最近のメッセージを残すかを決定し、ScaleDown が要約を書き出します。
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownSummarizationMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-sol",
    tools=[run_tests],
    middleware=[
        ScaledownSummarizationMiddleware(
            "openai:gpt-6-sol",  # the agent’s model, used for its context window
            trigger=("fraction", 0.8),
            keep=("fraction", 0.1),
        ),
    ],
)
エージェントは、計画やコードの記述には独自のモデルを使い続けます。要約だけが ScaleDown に移り、デフォルトでは LangChain の要約プロンプトと同じセクション(intent、summary、artifacts、next steps)を返します。ScaleDown の呼び出しが失敗した場合、ミドルウェアは履歴をそのままにし、エージェントは実行を続けます。同じミドルウェアは LangChain の create_agent.
圧縮 ツール結果
長時間実行されるエージェントは多くのツールを呼び出し、大きな結果はすべて実行の残りの間コンテキストに残り続けます。取得した Web ページは、エージェントが必要とするのがそのうちの 1 段落だけでも、数万文字に及ぶことがあります。その後のすべてのステップでこれらのトークンのコストを再度払うことになり、 コンテキスト が満たされるにつれて、エージェントはタスクに集中し続けるのが苦手になります。
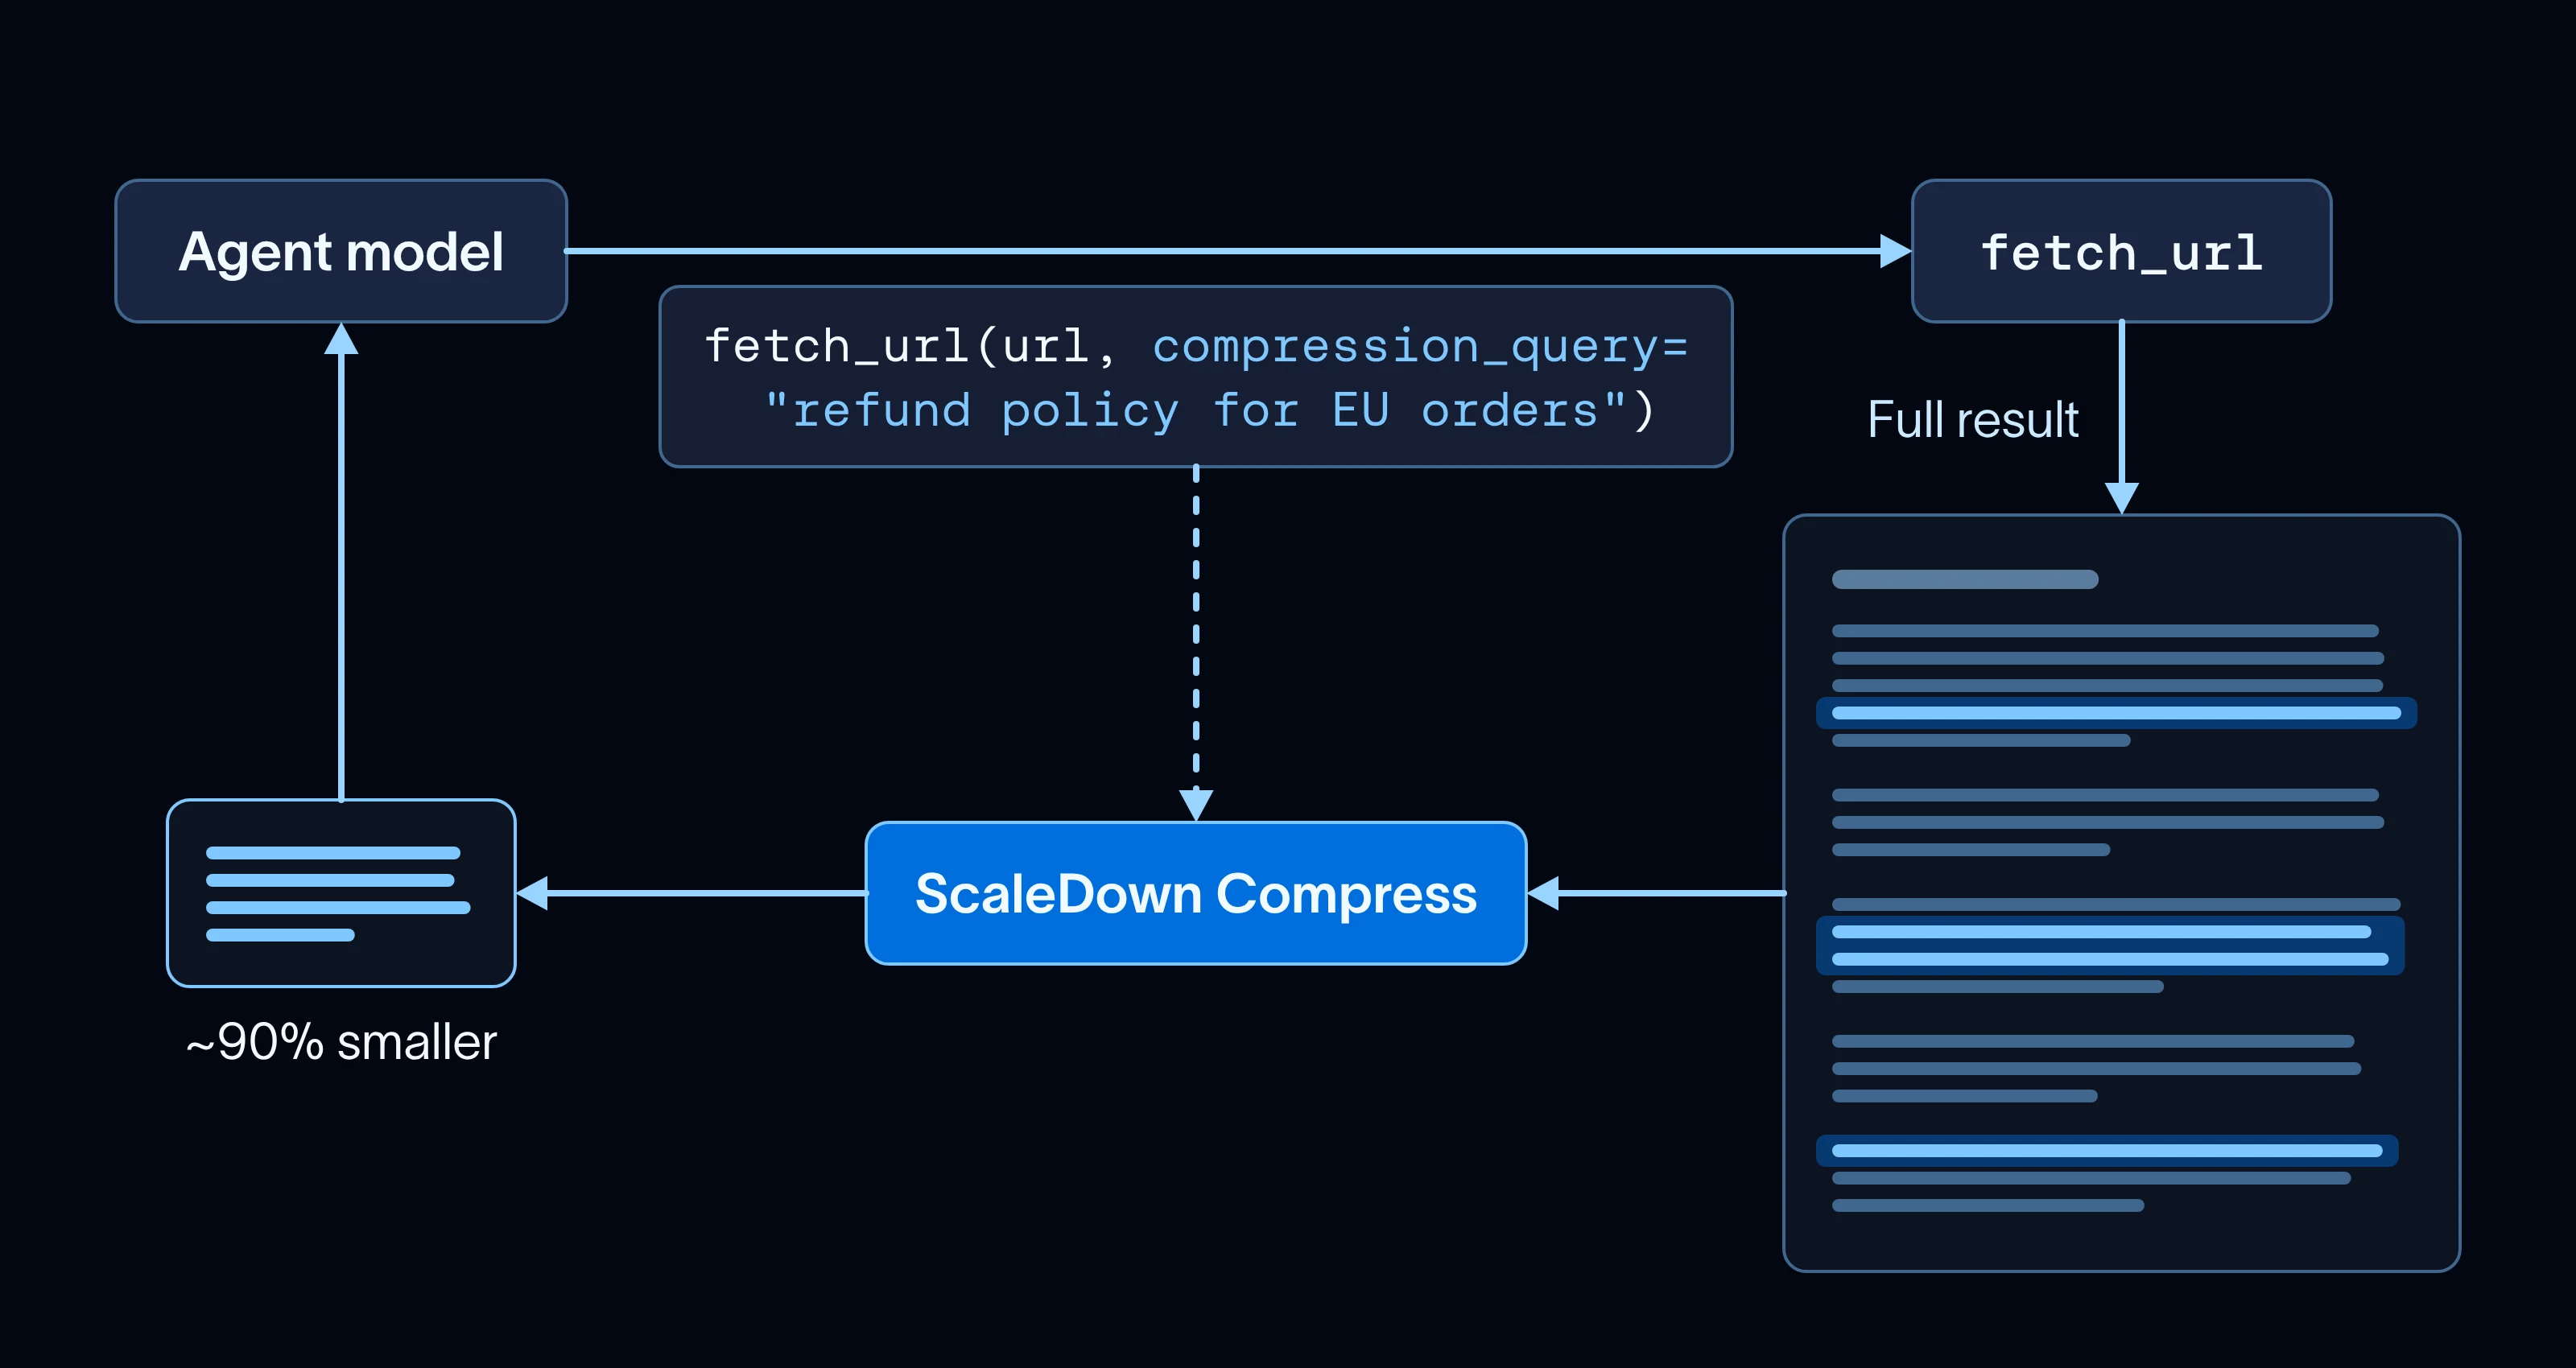
ScaledownToolCompressionMiddleware は、ツールにオプションの compression_query パラメータを追加します。モデルが結果の一部だけを必要とする場合、ツール呼び出しで compression_query を記入します。たとえば "refund policy for EU orders"のようにです。ミドルウェアはツールが実行される前にそれを取り除き、その後 ScaleDown がモデルが見る前に出力を関連する部分に圧縮します。
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownToolCompressionMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-luna",
    tools=[search_docs, fetch_url],
    middleware=[ScaledownToolCompressionMiddleware(tools=["fetch_url"])],
)
ツール自体は変更されないため、 MCP ツールを含む任意のツールで機能します。 このトレースでは、ScaleDown はモデルが見る前に長いドキュメントページを約 90% 削減しました。圧縮された結果は次のような注記で始まるため、ページ全体が必要な場合は compression_query なしでツールを再度呼び出すことができます:
[Compressed by ScaleDown for "refund policy for EU orders":
 18,402 -> 3,110 chars.
 Call this tool again without `compression_query` for the full output.]
構造化データの 抽出
エージェントは、読んだ内容から ID、日付、次のツール呼び出しに必要なフィールドなどの特定の値を絶えず取り出しています。その抽出はエージェントループの内部にあるため、毎ターンにレイテンシを加えないだけの速さが要求され、さらにツールがその値をそのまま使えるほど正確でなければなりません。
たとえば、サポートエージェントがチケットを起票する前に、注文番号、エラーメッセージ、顧客のメールアドレスが必要です。メインのモデルがこれらをツールの引数として記入することもできますが、エラーコードを言い換えたり、正確にコピーする代わりにメールアドレスを打ち間違えたりする可能性があります。
ScaledownExtractionMiddleware は、このステップを ScaleDown に委ねます。各フィールドを平易な言葉で記述すると、Extract がテキストから値をコピーします。フィールドはラベルの集合にすることもでき、その場合 ScaleDown は Classify で回答するため、チケットを問題の種類によって振り分けることができます。実行の最初のモデル呼び出しの前に、ミドルウェアはユーザーのメッセージを Extract に送り、フィールドをエージェント状態の scaledown_extractionの下に保存します。そこはツールから読み取れる場所です:
from deepagents import create_deep_agent
from langchain.tools import ToolRuntime, tool
from langchain_scaledown import ScaledownExtractionMiddleware

ticket = ScaledownExtractionMiddleware(
    entities={
        "order_id": "Order number the customer mentions",
        "error_message": "Exact error message or code the customer saw",
        "customer_email": "Customer's email address",
        "issue_type": {
            "labels": [
                {"name": "billing", "rubric": "Is this about a charge, refund, or payment?"},
                {"name": "technical", "rubric": "Is this about a bug or something not working?"},
                {"name": "account", "rubric": "Is this about login, password, or account settings?"},
            ]
        },
    },
    context_chars=0,  # skip evidence snippets to keep state small
)


@tool
def file_ticket(runtime: ToolRuntime) -> str:
    """File a support ticket with the details gathered so far."""
    fields = runtime.state.get("scaledown_extraction", {}).get("fields", {})
    return crm.create_ticket(**fields)  # your ticketing system


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[file_ticket], middleware=[ticket])
Extract はユーザーのメッセージのみを読み、エージェントの返信は決して読まないため、すべての値は顧客が実際に述べたものです。With a checkpointerでは毎ターン抽出が再実行されるため、顧客が詳細を追記するにつれてレコードが埋まっていきます。例えば 「注文A-1042はERR_PAYMENT_DECLINEDで失敗しました。すでに別のカードを試しました。」という場合、フィールドは次のように返されます:
{
    "order_id": "A-1042",
    "error_message": "ERR_PAYMENT_DECLINED",
    "customer_email": None,  # not mentioned yet
    "issue_type": "billing",
}
分類 ドリフト
エージェントは現在の状態、たとえばタスクが完了したかどうか、最後のツール呼び出しが成功したかどうかに基づいて次のステップを決定します。この状態の分類は毎ターン行われるため、安価かつ高速である必要があります。
長時間実行されるエージェントで検出すべき状態のひとつがドリフト、つまり同じ失敗するツール呼び出しをループしたり、非生産的なサイクルにはまり込んだりすることです。これに対応する組み込みミドルウェアはありませんが、独自の カスタムミドルウェアから任意の ScaleDown モデルを呼び出すことができます。以下は、すべてのモデル呼び出しの後に実行され、履歴を ScaleDown Classify に送り、軌道から外れたときに実行を停止するサーキットブレーカーです:
import os

import requests
from deepagents import create_deep_agent
from langchain.agents.middleware import after_model
from langchain_core.messages import AIMessage, get_buffer_string

LABELS = [
    {"name": "progressing", "rubric": "Is the agent making new progress on the user's task?"},
    {"name": "looping", "rubric": "Is the agent repeating the same steps without new results?"},
    {"name": "drifting", "rubric": "Is the agent working on something the user did not ask for?"},
]


@after_model(can_jump_to=["end"])
def circuit_breaker(state, runtime):
    result = requests.post(
        "https://api.scaledown.xyz/classify",
        headers={"x-api-key": os.environ["SCALEDOWN_API_KEY"]},
        json={"text": get_buffer_string(state["messages"]), "labels": LABELS},
    ).json()

    label = result["top_label"]
    if label != "progressing" and result["scores"][label] > 0.8:
        return {"jump_to": "end", "messages": [AIMessage(f"Stopped: {result['reasoning']}")]}
    return None


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[run_tests], middleware=[circuit_breaker])
Classify は各ラベルの確率を返すので、ブレーカーを作動させる前にどの程度の信頼度を要求するかを選択できます。1 行の理由が最終メッセージに表示されるため、実行がなぜ停止したのかを確認できます。より穏やかなバージョンでは、最初の作動で実行を終了せず、その理由を会話に追加して針路変更を促し、エージェントが再びドリフトした場合にのみ停止します。
これら 4 つのセクションは ScaleDown のモデルが適合するいくつかの場所を示したものであり、リストは網羅的ではありません。長いツール結果に対して extract / summarize を実行したり、ランタイムのモデルルーティングに分類を使ったりと、組み合わせは自由です。さまざまな種類のデータに対して CDMs モデルを活用する他の方法については、 ScaleDown Cookbooks をご覧ください。
LangSmith LLM Gateway における ScaleDown
The LangSmith LLM Gateway 1 つの LangSmith API キーで複数プロバイダーのモデルを呼び出せるようにし、すべての呼び出しをトレースし、あなたの 支出する および レート制限。ScaleDownは現在、そのうちの1つです 直接モデルアクセスプロバイダー、その /scaledown パス。
管理者があなたのScaleDownキーをワークスペースの プロバイダーのシークレット として SCALEDOWN_API_KEY 一度実行します。そして「point」 langchain-scaledown ゲートウェイでLangSmithキーを使用して認証します:
export SCALEDOWN_BASE_URL="https://gateway.smith.langchain.com/scaledown"
export SCALEDOWN_API_KEY="$LANGSMITH_API_KEY"
その後、各ScaleDown呼び出しは以下のように表示されます: LangSmith トレース 「また、他のモデル呼び出しと同じ上限にカウントされます。」
ScaleDownを使用しないほうがよい場合
コードの執筆、返信の下書き、計画の立案など、オープンエンドな生成には汎用LLMを使いましょう。これは私たちの「デフォルトは安価、例外のみフロンティア」というアプローチに沿ったものです。 Jevの投稿: 難しい部分には大規模な汎用LLMを使い、その周りの大量処理のステップには特殊化されたモデルを使う。
ScaleDown は非常に高速かつ低コストで、毎ターン実行できるため、エージェントはメインループを遅くしたりフロンティアモデルの価格を支払ったりすることなく、コンテキスト管理が依存する構造化された判断を行えます。長時間実行されるエージェントでは、こうした判断はほぼ毎ターン発生するため、コスト削減はすぐに積み重なります。
はじめに
統合をインストールする および ScaleDown APIキーを設定してください:
uv pip install -U langchain-scaledown
export SCALEDOWN_API_KEY="..."
新着 ScaleDown アカウントが 50Mの無料トークン。The ScaleDown 統合ドキュメント 各ミドルウェアの設定オプションを取り上げます。与えられた langchain-scaledown 試してみて、その感想を次の LangChainフォーラム, X、または GitHub.