
LFM2.5-24B-A2B は、アクティブパラメータわずか 2B の 24B パラメータ推論モデルで、高速かつプライベートなオンデバイスエージェント向けに構築されています。回答の前に思考を行い、ツールを呼び出し、一般的なエージェントハーネス内でマルチステップのタスクを遂行します。トークンごとにアクティブになるのは 2B パラメータのみのため、推論トークンあたりのコストが低く、自身のハードウェア上でエージェントを継続的に実行できます。
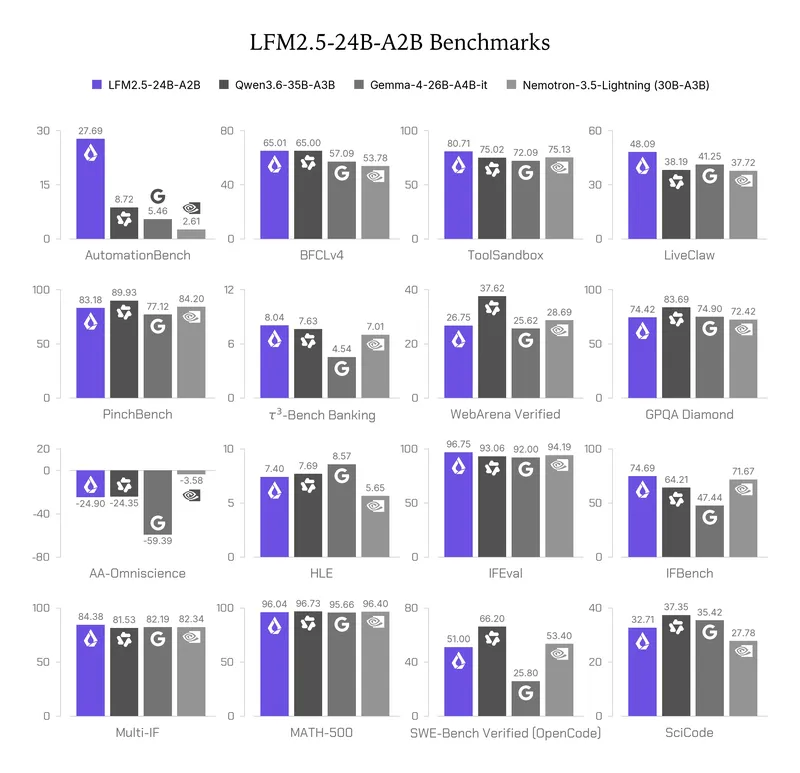
- 最高水準のエージェント性能: 総パラメータ数およびアクティブパラメータ数が約50%多い Qwen3.6-35B-A3B と、エージェントおよびツール使用タスクで拮抗しており、LiveClaw で 48.09 を獲得(相手は 38.19)。
- MoE 速度での推論: 常に回答の前に思考します。トークンあたりのアクティブパラメータは 2B のみで、推論トークンあたりのコストが低く抑えられます。
- 効率的な推論: Apple M5 Max で 184 tok/s、NVIDIA B300 GPU 1 基で最大 21K output tok/s を実現。

アクティブパラメータ 2B で推論エージェントを構築した方法
LFM2.5-24B-A2B は LFM2-24B-A2B をベースに、そのアーキテクチャを踏襲しています: 40 層、MoE ブロックごとに 64 エキスパートと top-4 ルーティング、そしてゲート付き短畳み込みと GQA の同じハイブリッド構成です。コンテキストウィンドウは 32K から 131K トークンに拡大され、さらに インプレーストークナイザー拡張 により語彙が 65K から 128K トークンへと倍増し、非ラテン文字のトークン化が改善されました。前任モデルとは異なり、最終的な回答の前に明示的な思考連鎖を生成する推論専用モデルです。
事前学習は約 17T から約 33T トークンへとスケールアップされました。ミッドトレーニングでは、推論、数学、コード、指示追従、多言語テキストに重点を置いた 2T トークンを 32K コンテキストで、長コンテキストデータに重点を置いた 300B トークンを 131K コンテキストで追加しました。ツール呼び出しとマルチターンの軌跡は両フェーズを通じて登場します。ポストトレーニングにより、ベースモデルは 5 段階のステージを経てエージェントへと変換されます:
- 教師ありファインチューニング (SFT)
- 教師モデルの専門化
- マルチドメインオンポリシー蒸留 (MOPD)、非エージェント: 非エージェントタスクについて専門教師モデルを蒸留します。
- MOPD、エージェント: エージェントタスクに焦点を当てた第 2 の蒸留ステージです。
- エージェント強化学習 (Agentic RL): 以下のようなエージェントハーネス内でモデルを学習させます: OpenClaw, Hermes Agent, Pi、および OpenCode.
ベンチマーク結果
LFM2.5-24B-A2B を、ツール使用とエージェントワークフロー、知識、指示追従、数学、コーディングをカバーする 16 のベンチマークで、Qwen3.6-35B-A3B、Gemma-4-26B-A4B-it、Nemotron-3.5-Lightning と比較評価しました。本モデルはグループの中で最も小さいモデルでありながら、総およびアクティブパラメータが約50%多い MoE モデルと競争力のある結果を示しました。
| ベンチマーク | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verified (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
*すべてのモデルは、各ベンチマークの推奨生成パラメータを使用して vLLM で評価されました。
あなたのアプリにとって、強みはツール使用と指示追従です。LFM2.5-24B-A2B は、8つのツール使用・エージェント系ベンチマークのうち5つ(AutomationBench、BFCLv4、ToolSandbox、LiveClaw、τ³-Bench Banking)で競合モデルをリードするか同等の成績を収めており、AutomationBench では次点のモデルの3倍以上のスコアを記録しています。また、3つの指示追従ベンチマークすべてで首位です。GPQA Diamond、HLE、AA-Omniscience といった知識重視のベンチマークや、SWE-Bench Verified (OpenCode) や SciCode といったコーディング系ベンチマークでは、より大規模なモデルが依然として優位性を保っているため、知識重視のワークロードでは LFM2.5-24B-A2B を検索(RAG)や Web 検索と組み合わせてください。
これらの結果により、LFM2.5-24B-A2B は、推論し、ツールを呼び出し、お客様のデバイス上で確実に動作する必要があるエージェントにとって、強力な基盤となります。
CPU および GPU での推論速度
LFM2.5-24B-A2B は、llama.cpp、MLX、vLLM、SGLang、ONNX を含む推論エコシステム全体での初日対応とともにリリースされます。
エッジ推論。 LFM2.5-24B-A2B は比較対象の MoE モデルの中で最も高速であり、M5 Max で 184 tokens/s、Ryzen AI Max+ 395 で 114 tokens/s のデコード速度を実現しています。これは、次点のモデルより最大 1.7 倍高速であり、メモリ使用量は最も少なくなっています。

GPU 推論。 LFM2.5-24B-A2B は同サイズクラスで最速のモデルであり、B300 1基において高同時実行数時に毎秒 21K を超える出力トークンを達成しています。

LFM2.5-24B-A2B の使い方
推論し、ツールを呼び出し、お客様のデバイス上で確実に動作するエージェントが必要な場合に、LFM2.5-24B-A2B をご利用ください。
最新バージョンのインストール transformers ( transformers>=5.0.0):
pip install -U transformers
と互換性あり)次にモデルを読み込んで実行します:
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
#   attn_implementation="flash_attention_2" <- uncomment on compatible GPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_new_tokens=512,
    streamer=streamer,
)
エージェントハーネスで使用する
LFM2.5-24B-A2B を OpenAI 互換の任意のバックエンドの背後でローカルにサーブし、エージェントハーネスをそこに向けます。例えば、Hermes Agent を使用する場合:
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
ポートは使用するサービングバックエンドによって異なります:llama.cpp と MLX は 8080、vLLM は 8000、SGLang は 30000、LM Studio は 1234を使用します。OpenClaw と Pi の設定については モデルカード を、セットアップ全体については 私たちのガイド をご覧ください。動画の例については、 リリースブログ をご覧ください。
LFM2.5-24B-A2B を始めよう
LFM2.5-24B-A2B と LFM2.5-24B-A2B-Base はどちらもオープンウェイトで、本日 Hugging Face から入手可能です。
- ダウンロード: LFM2.5-24B-A2B-Base および LFM2.5-24B-A2B on Hugging Face.の翻訳: 「Hugging Face上で公開されています。」
- ハーネスでの使用方法: 私たちの ガイド OpenClawやHermes Agent、Piのようなローカルエージェントの実行方法について。
- 微調整: LFM2.5-24B-A2Bをあなたのタスクに適応させるには、当社の ファインチューニングのチュートリアル.
皆さんが何を构建されるのか、楽しみにしています。
引用
この作品を利用する場合は、リリースブログを引用してください:
@article{liquidAI202624BA2B,
  author  = {Liquid AI},
  title   = {LFM2.5-24B-A2B: Built for Fast On-Device Agents},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/lfm2-5-24b-a2b},
}