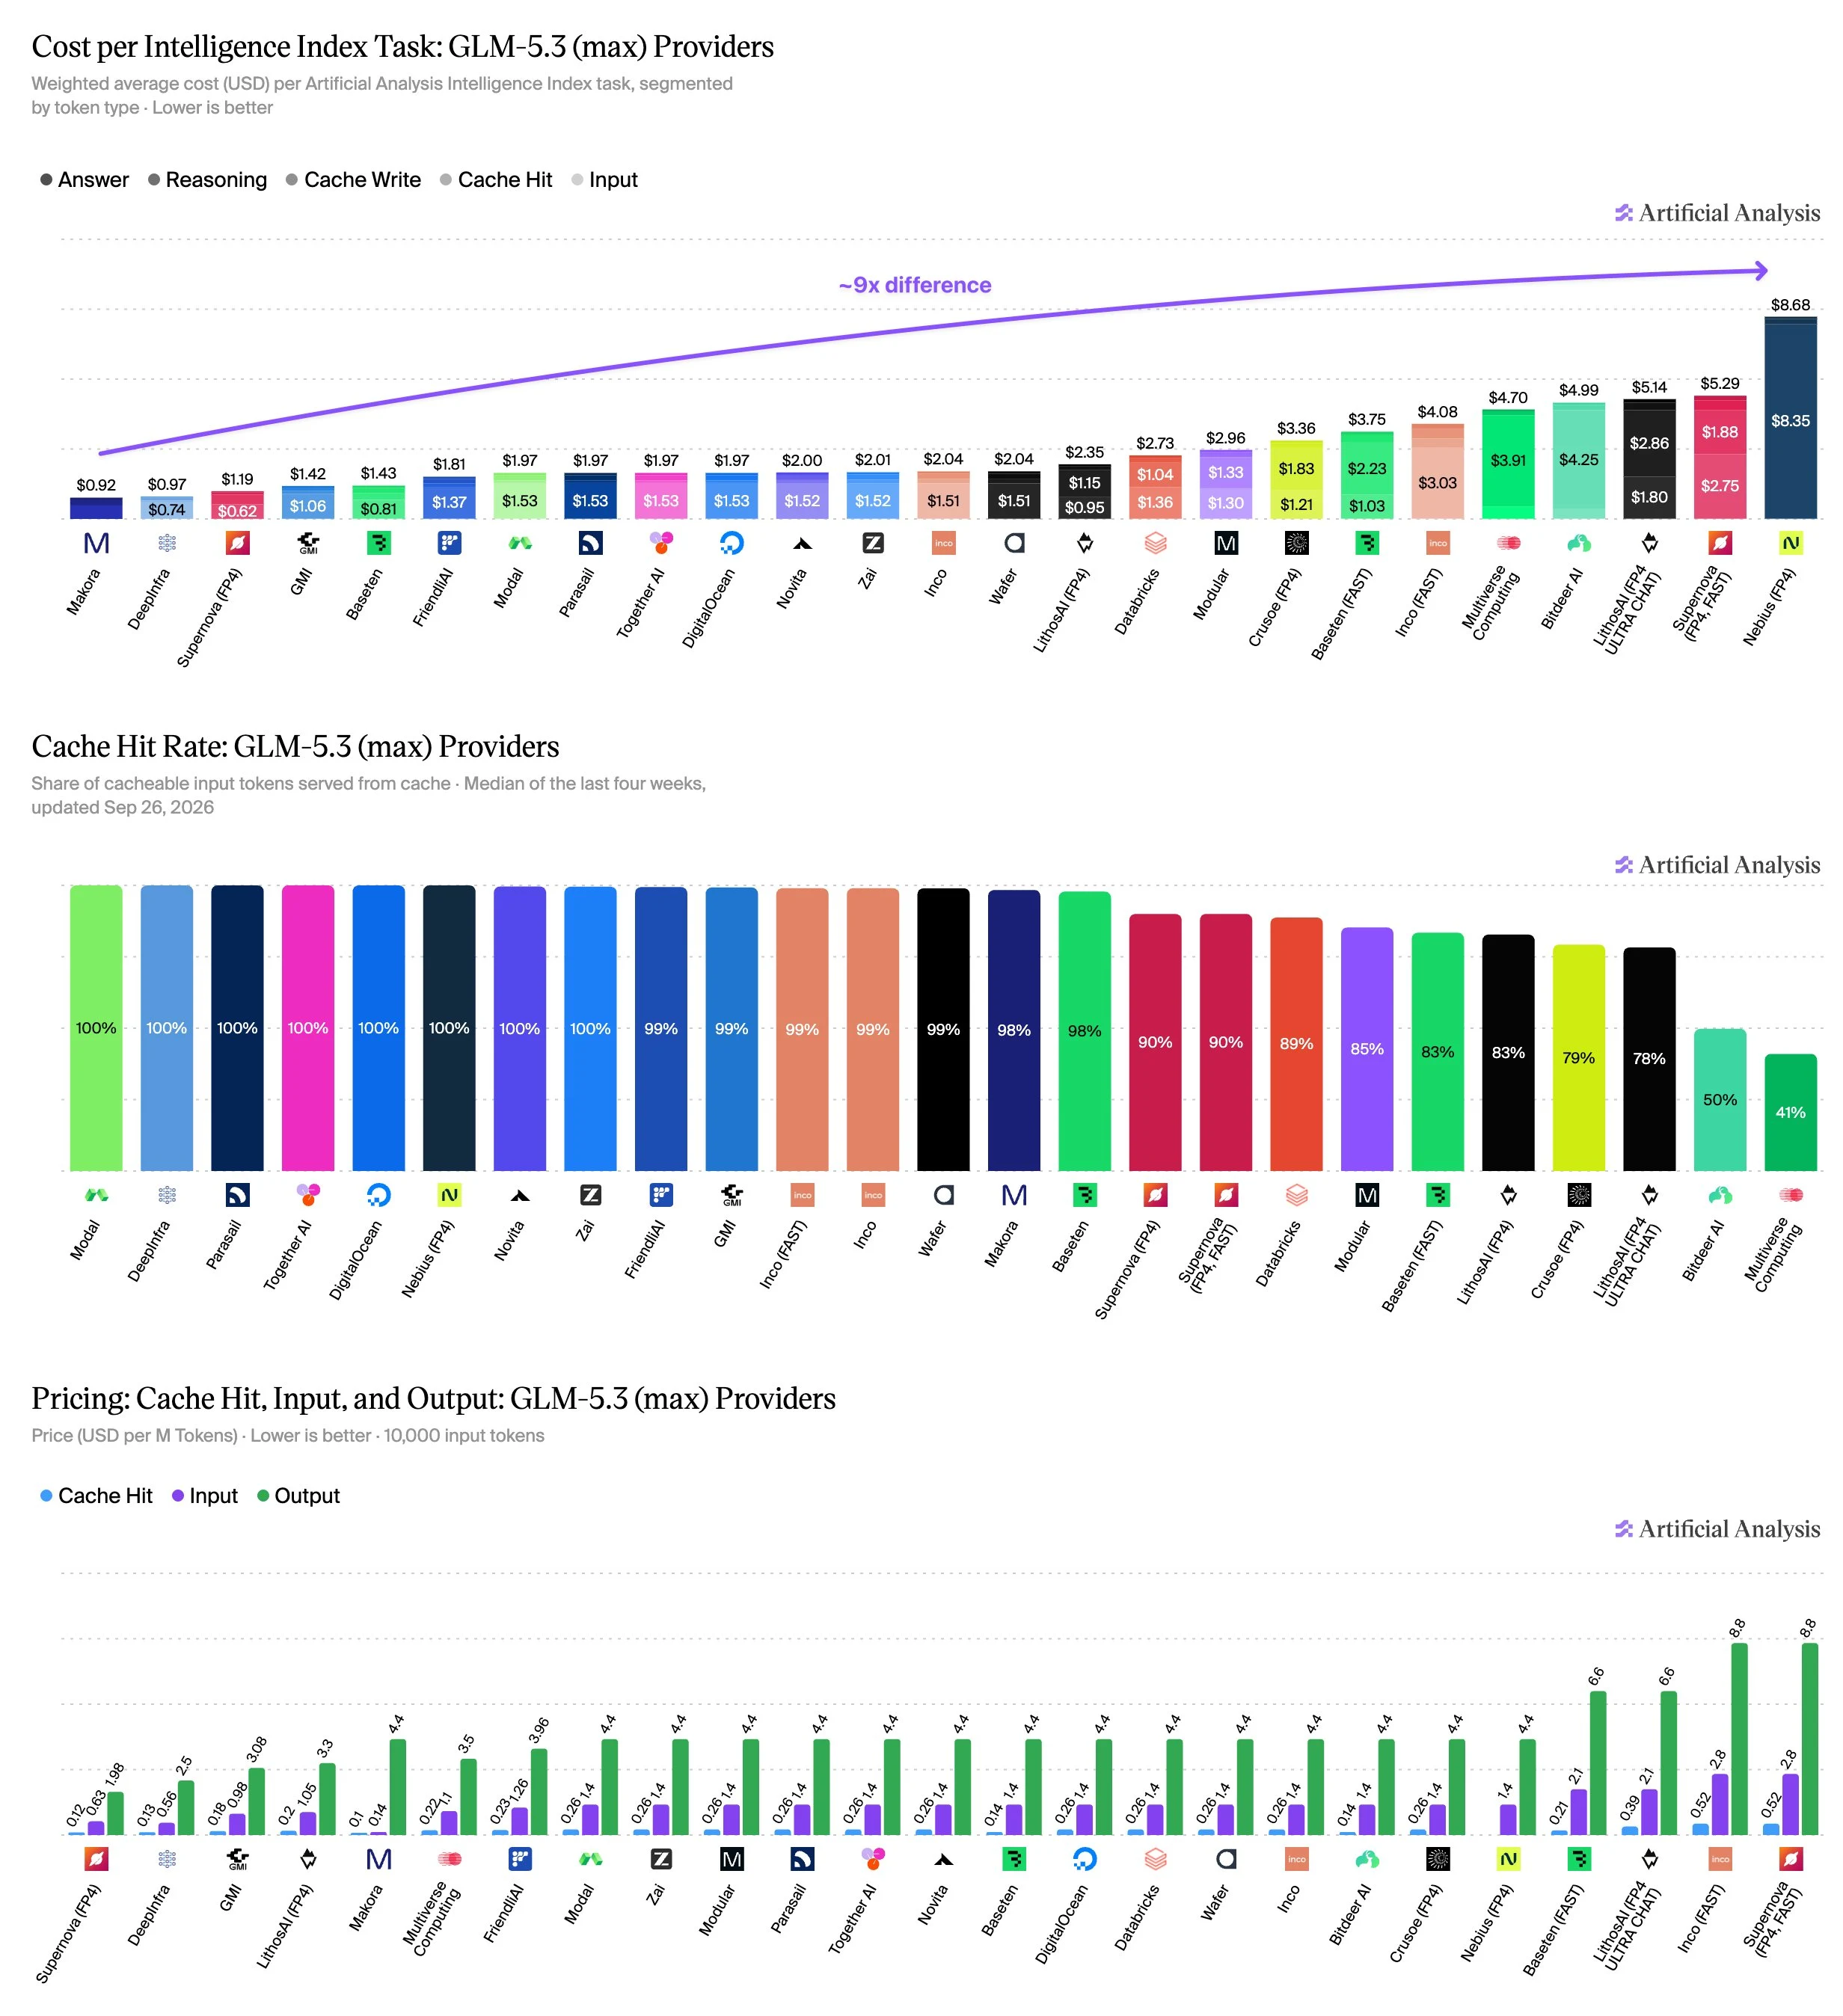
プロバイダ別のキャッシュヒット率とタスクあたりのコストは、現在Artificial Analysisに公開されています。GLM-5.3(最大)のタスクあたりのコストは、プロバイダによって約9倍の差があり、これはキャッシュヒット率とトークン価格の組み合わせによるものです。
エージェント型ワークロードは各ターンで全会話履歴を再送信するため、ほとんどの入力トークンがキャッシュ可能であり、キャッシュの価格設定とキャッシュヒット率がタスクあたりのコストの差の大部分を占める。我々は既に測定されたキャッシュヒット率を用いてタスクあたりのコストを計算しており、現在は追跡する各モデルエンドポイントについてそれらを公開している。
新しいこと:
➤ 第一方および第三方エンドポイントすべてで、マルチターンエージェント型コーディングタスクを実行し、各プロバイダーの使用応答からキャッシュトークンを読み取ることで、キャッシュヒット率が表示されるようになりました。キャッシュヒット率とは、キャッシュから提供されるキャッシュ可能な入力トークンの割合です。
➤ オープンウェイトモデルの場合、各プロバイダーの入力、出力、キャッシュヒット、キャッシュ書き込みの価格から、プロバイダーごとにコスト/タスクが算出され、測定されたキャッシュヒット率で計算されます。特定のモデルに対して各プロバイダーを統一するため、モデルのIntelligence Index実行から得られる同じ入力、出力、キャッシュ可能なトークン数を使用します。
主なポイント:
➤ GLM-5.3におけるタスクあたりのコストは、マコラで0.92ドルからNebiusで8.68ドルまで、プロバイダーによって9倍もの幅があります。両方ともキャッシュ可能な入力のほぼ全て(98%および100%)をキャッシュしており、出力価格は1Mトークンあたり4.40ドルで同じです。そのため差異は入力価格にあります。マコラはキャッシュされた入力トークン1Mあたり0.10ドルを請求し、Nebiusは共有のサーバーレスエンドポイントではキャッシュ入力に対する割引を提供せず、全ての入力を1.40ドルで請求します。
➤ 21のプロバイダー(25のエンドポイント)におけるキャッシュヒット率は41%から100%です。15のエンドポイントは98%以上、8つは100%です。Modal、DeepInfra、Parasail、Together AI、DigitalOcean、Nebius、Novita、Z AIの第一方APIが該当します。Multiverse Computingは41%で最も低く、次いでBitdeerが50%です。