
金磊 発信元 凹非寺
量子位 | 公式アカウント QbitAI
何ですか?35BのMoEは、スマホでもスムーズに動作しますか?
ええ~、本当です。
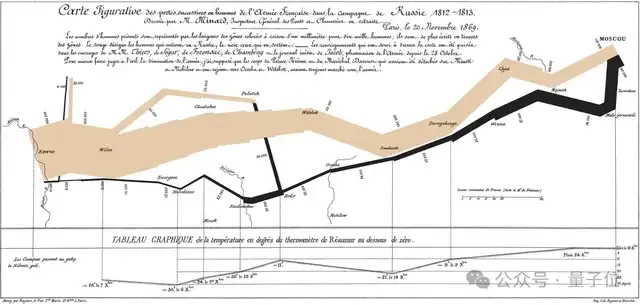
私たちはインターネットが切断された状態で、iPhone 17 Pro Max携帯電話にデータ可視化の古典的な図をアップロードします――ナポレオンのロシア遠征の失敗した行軍路線図です:
それから私たちは直接質問します:
図リで記録された最低気温は何度の摂氏度か、いつに起こったのか、換算プロセスも一緒に説明する。
見ての通り、1分足らずで、アップル携帯電話上のモデルは、その線からマイナス30度のマークを見つけ、日付は1812年12月6日であると判断しました。さらに1列度を1.25度セルシウスに換算すると、マイナス37.5度セルシウスの答えが得られます。
また、このスマホのモデルの速度は、もっと速いです。
例えば、同じ道路の駐車標識の写真や、同じ駐車時間の問題についてです。左側は最適化されていない35Bモデルで、右側は最適化されたモデルです:
見ての通り、最適化されていない時は、毎秒約2個のTokenの速度でしたが、最適化後は毎秒8〜12個のTokenの速度になりました。ネットワークが切断されている状態でも、答えが素早く表示されます。
わかっているところによると、この35BモデルはiPhone 17 Pro Max上で、3Gメモリしか使っていない状態でも、1秒間に13個以上のトークンを処理できる!
滑らかで、本当に少し滑らかです。
では、このモデルがスマホで実行できるというのは、一体どのようなAIなのでしょうか?
気を引き立てないように、これは面壁智能とOpenBMBがちょうどオープンソースにしたMiniCPM-V 4.7です。合計で2つのバージョンがあります:
- 35B-A3B:総パラメータ35Bで、各推論で3Bのみが活性化され、MiniCPM-Vシリーズの最初のMoEモデルです。約3GのメモリでiOSやAndroid端末上でスムーズに動作します。
- 1B:実際のパラメータは1.3Bで、極小サイズを重視し、OCR、数学、ビデオ理解に特化しています。同じサイズのモデルの中ではトップクラスです。
しかし、一言言うと、速く走ることだけが問題ではない。では、MiniCPM-V 4.7をエンドポイント型大模型の世界に置くと、どれほどの水準になるのか?
一般的な視覚能力において、35B-A3BのMMBenchは91.72、MMStarは80.67を記録した;理科問題に関しては、MMMUとMathVistaはそれぞれ80.22と88.00であった。ビデオ理解能力のVideo-MMEとLongVideoBenchも、76.40と68.90を得た。
特にOmniDocBench v1.6では、35B-A3Bが94.24点を獲得し、他の4つのモデルはすべて80点前後で、12点以上の差をつけました。
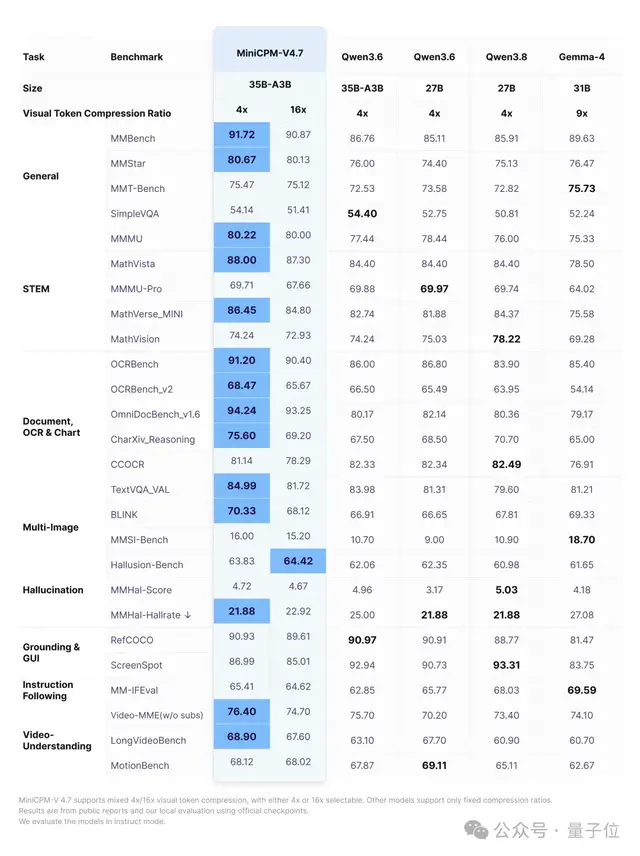
さらに注目すべきは、ビジュアル圧縮を16倍にした後の性能です。MMBenchは91.72から90.87に、OCRBenchは91.20から90.40に下がりました。節約された計算能力は、精度を犠牲にすることなく得られたものです。
それに加えて、MiniCPM-V4.7は純文書能力において、中国語知識のCMMLUが90.21、ツール呼び出しのτ2-Benchが84.65を記録し、同様に最も高い値となった。
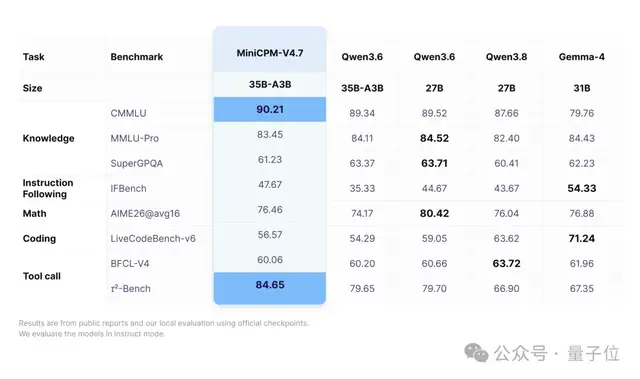
報道によると、MiniCPM-V4.7は最初の端側でスムーズに動作し、かつ性能を損なわないオープンソースのMoEモデルです。
では次に、そのより多くの効果を見てみましょう。
35Bをバッグに入れて、ネットが切れても使える
まず、私たちの生活に近い問題を一つ見てみましょう。
今回モデルに入力したのは、家庭の電気使用調査表で、エアコン、冷蔵庫、電気ケトル、テレビ、洗濯機、待機機器の出力と使用時間が記載されています。また、この月の電気料金の明細も添付されており、合計で420度の電力が使われ、126元です。
この問題には合計3つの問題があり、それぞれは以下の通りです:
各電化製品が1ヶ月にどれくらいの電力を消費するかを先に推定し、順番に並べる。次に、これらの製品を合わせて請求書の何%を説明できるかを計算し、残りの部分が他の電化製品に全て割り当てられるかどうかを調べる。最後に、省電方案3つから最も省電効果の高いものを選び出す。それは、エアコンを1日1時間短く運転し、テレビを1日2時間少なく見る、そして待機機器を1日8時間完全に電源を切るというものである。
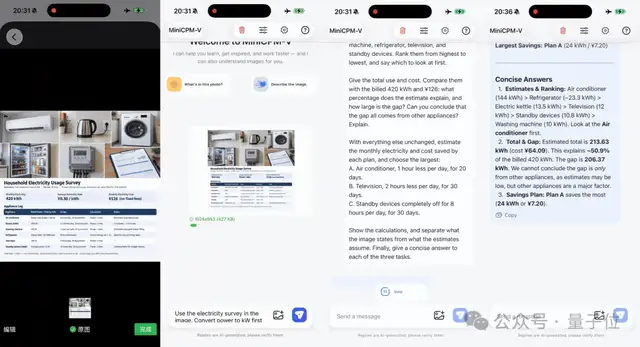
結果によると、35B-A3Bはまずワットをキロワットに換算し、その後パワーに使用時間を掛けて一つずつ計算する。エアコンは月に144度で、最初に挙げられる。冷蔵庫はラベルに記載されている年間電力消費量280度を基準に、月に約23.33度に換算される。その後は電気ケトル、テレビ、待機機器、洗濯機の順である。
六つの電化製品の合計は約213.63度で、請求書の電気価格に基づくと64.09元になります。これでは請求書の50.9%程度しか説明できず、まだ206.37度が不足しています。3つの方案の中で、エアコンを1時間短く運転するのが最も効率的で、1ヶ月で24度の電力を節約でき、7.2元になります。
見ての通り、ネットワークが切断されている状態で、これほど複雑なグラフに対しても、35B-A3Bはしっかりと対応できている。
35Bを見た後、次に1Bの効果を見てみましょう。今回の1Bのタスクは、一ページの論文をMarkdownに変換することです。
この画像をマークダイラーに変換してください。
半分秒もかからずに、タイトルの階層、段落、表が復元され、公式もLaTeXに書き換えられ、レンダリング後のレイアウトは原文とほぼ一致した。
論文のスクリーンショットやPDFページをノートに入れることがよくある人にとって、このような作業は以前はネット接続を使ってクラウドモデルに任せられていました。今では1.3Bの小さなモデルで、スマホのローカル環境で完了できます。
もちろん、スマートフォン以外にも、iPadのような端末も問題ありません。
例えば、先ほどのナポレオン遠征図の問題をiPad M4で実行してみたところ、答えは依然として1812年12月6日、マイナス37.5度セルシウスでした。
端側以外では、APIを使ってMiniCPM-V4.7を実行しました。
第一の問題は会計です。私たちはスーパーのレシートのサンプルを準備しました。その中には純乳製品、全粒粉パン、ティッシュペーパーなど6種類の商品が含まれており、会員特典とクーポンによる2つの減額があり、最終的に支払いは78.40元でした。要求は、それを中国語の会計表に整理し、レシート上の計算が正確かどうかを確認することです。
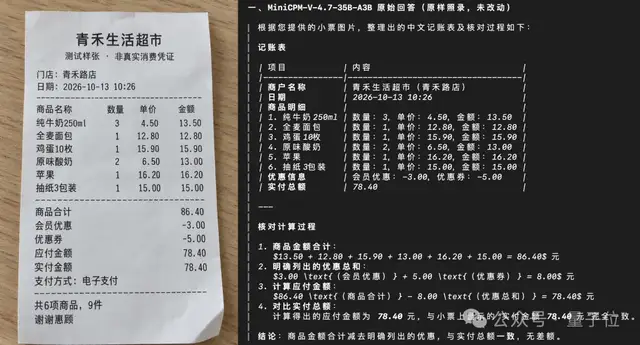
結果からわかるように、35B-A3Bはまず店舗、日付、そして6種類の商品の数量、単価、金額を一つずつ表に記入し、元の図と一つ一つ照合したところ、誤りは一つもなかった。
確認する際、レシートには商品の合計が86.40元と明記されていたが、6つの金額を最初から加えて86.40元にし、さらに2件の合計8元の割引を引くと78.40元になり、これがレシートの実際の支払額と一致する。
第二の問題も駐車に関係していますが、ルールは最初に示したものよりも複雑です。
私たちが設定した状況は、火曜日に住民証を持っていますが、その日はここに車を停めることはありませんでした。14:10に停車し、15:40まで続ける予定です。そして、この停車時間がどれくらいか、清掃の禁止区域にぶつからないか、時間制限を超えないか、駐車料金を払うべきか、そして全体の計画が規則に合致しているかどうかという5つのことを判断させます。
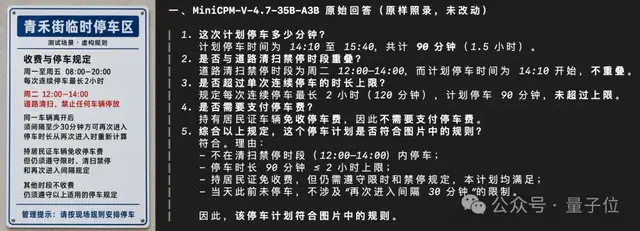
35B-A3Bの5つの質問をすべて正解しました。今回は合計90分間の停車時間となり、14:10から始まるため、12時から14時の清掃時間を避けることができ、2時間の上限も超えません。住民証を持っているため、駐車料金が無料になります。
最後の総合判断で、各規則を一通り確認し、その日は前回から停車していないことにも気づいたため、「再び入るには30分間の間隔が必要」という項目は不要であり、この停車計画は規定に適合していると結論した。
3Gメモリで35Bのデータを動かすにはどうすればいいですか?
見た目は良いのに、問題が浮かぶ:
35Bのモデルが、12GBのメモリを持つスマホで動作し、しかも遅くないのは、どうしてなのか?
35B-A3BこのMoEモデルは、合計で35Bのパラメータを持っていますが、各トークンを生成する際に実際に計算に関与するのは約3B程度です。しかし、問題がある点があります。それは、各層でどの専門家を使用するかを決める必要があり、上層の計算が終了してから初めて分かります。
そして、携帯電話のメモリには全ての専門家を収容することができず、大部分はフラッシュメモリに保存され、使用した後で読み込まれる。
過去によく使われた方法には二つあります。一つは、どの専門家を使うかによって異なる方法です。大規模モデルは動作可能ですが、解読が遅く、リアルタイムでの対話ができません。もう一つは、全体的な対話に対して事前に一定数の専門家を配置する方法です。読み込む回数が少なくなると、モデルが選ぶ専門家の数も減り、能力が低下する可能性があります。
MiniCPM-V 4.7は、両方を考慮する必要がある:速度は十分に速く、能力も簡単には低下しないようにしなければならない。実際の使用においては、さらに一歩踏み込む必要がある——開発者が自社のビジネスに合わせてカスタマイズし、モデルが新しいスキルを学びながら、元の能力もできるだけ保持するようにする。
まず、どのようにしてより速く走るかを見よう。
前瞻専門家スケジュール(LES)は、専門家の事前取得、スケジュール計算、重みアクセスの処理を一緒に最適化しています。いつ移動するか、どれを先に計算するか、そして各回にどれだけ移動するかなど、すべてが適切に調整されています。
チームは一つの特徴を利用した:モデルの隣接する二層の入力特徴がしばしば非常に似ている。そのため、現在の層が計算中である間に、そのルーティング入力特徴を次の層のルーターに送り、次の層で使用される可能性のある専門家を事前に予測することができ、そしてバックグラウンドスレッドが対応する重みをフラッシュメモリからメモリに読み込む。
次の階層が実際に作業を開始すると、必要な専門家のほとんどが準備されている。チームのテストでは、この方法により必要な専門家の80%以上を事前に揃えることができ、追加の訓練も不要である。
計算の順序も調整されました:実際に選択されたルートで、すでに読み込まれている専門家から先に計算し、残りの必要な専門家は同時に読み込まれます。計算とデータの読み込みを同時に行うようにし、データが来るのを待ってから作業することを減らします。
ここに重要な違いがあります:予測は単に事前の運搬と計算順序の手配を担当するだけで、最終的に各トークンがどの専門家を使用するかは、モデルの元のルーティングメカニズムによって決定されます。当てられなかった専門家は通常通りロードされ、通常通り計算され、スピードを上げるために省略されることはありません。
もう一つの最適化は、重み自体に起こります。精度の量化を段階的に組み合わせることで、チームは基本モデル能力を保持しつつ、専門家の重みを小さくすることで、毎回のデータ量を減らします。そして、重みを連続的な保存構成に再編成することで、分散的な読み取りを減らし、フラッシュメモリをより効率的に順序的に読み取ることができます。
運ぶべき物を減らすことで、搬送がスムーズになる。さらに、事前の読み込みと並行計算を組み合わせることで、エンド側のストレージと帯域幅の負荷を共に低減する。
16GBのメモリを備えたiPad Pro M4では、フォーカスエキスパートスケジューリング方式により、デコーディング速度がx5倍に向上しました。
さらに、チームはモデルに合わせたDSparkの草稿モデルをトレーニングし、llama.cppなどの端末側推論フレームワークに接続した。草稿モデルが複数のtokenを先に生成し、その後主モデルが一括して検証することで、生成速度がさらに向上する。16GBメモリのM5 Macでのテストでは、デコーディング速度が平均17%向上した。
視覚側も省かれている。MiniCPM-V 4.7はLLaVA-UHD v4のViT内早期圧縮技術を採用しており、視覚エンコーダ内部で視覚トークンを事前に統合しているため、後続の層で計算されるデータが少なくなる。開発者は4倍と16倍の圧縮間を切り替えることができ、前にも述べたように、16倍に設定した場合でも得点はほとんど下がらない。
これらの技術を重ね合わせると、面壁が言っていた「速く上がる」という状態になります。
速く走ること以外に、開発者がよく遭遇する問題があります。モデルを業務に合わせて微調整した後、新しいタスクはより良くなりますが、元の汎用能力は低下します。
面壁は、自己再生微調(Self-Replay Fine-Tuning)を導入しました。方法は非常にわかりやすいです。微調前に、モデルに既存の能力をカバーする一連の問題に答えさせ、高品質な回答を選び出した後、その回答を新しいタスクの訓練データに混ぜ込みます。モデルは新しいスキルを学びながら、元々できることも復習し、既存の能力の忘れを減らします。
これらの「復習資料」はモデル自体から来ており、元の回答スタイルに近いです。全体の手法は標準的な微調整プロセスを踏襲しており、モデルの構造や損失関数を変更する必要はありません。再生データは一度だけ生成すればよく、モデルが新しい能力を学習したり、複数回のトレーニングを行ったりする際に再利用できます。
オンライン強化学習やOn-Policy Distillationといった訓練方法と比べて、これらは各訓練ごとに新しいデータをサンプルする必要があるが、自己回放微調整では新たな能力を定義するコストが通常の監督微調整に無限に近くなり、同時にモデルの汎用性能も維持される。
大規模モデルはもうスマホでは使えない
技術について話した後、再びスマホ業界に戻りましょう。
2026年、端側AIは大規模な導入へと進んでいます。IDCの予測によると、今年の中国における新世代AIスマートフォンの出荷数は1.47億台に達し、前年比で31.6%増加し、浸透率は初めて53%を超えます。言い換えれば、新しいスマートフォンが2台売られた場合、1台は端側AIを搭載しているということです。面壁智能のCEO、李大海も述べています。2026年は端側AIが大規模に実用化される元年であると。
しかし、スマホメーカーにとっては、もう一つ現実的な問題があります。それはコストです。
メモリの価格は絶えず上昇しており、12GBはAIスマホにとって最低限の要件となっている。フラッグシップモデルでは一般的に16GBが標準で、一部の機種では24GBへ向かっている。モデルをより強力にするためには、より多くのメモリが必要であり、メモリの価格が高くなるほど、その道のりは費用がかさむ。
ですから、より少ないメモリでより大きなモデルを動作させることは、メーカーにとって非常に魅力的です。iPhone 17 Pro Maxのメモリは12GBですが、35B-A3Bは約3Gのメモリでスムーズに動作し、残りの空間は他のアプリケーションに使うことができます。
より長期的に見ると、エッジAIの競争の焦点も変化しています。以前はチップの製造プロセスや計算能力が比較されていましたが、今後はモデルや推論フレームワークがハードウェアとどれだけうまく連携できるかが、差を生む重要な要素になるでしょう。
生態面において、MiniCPM-V 4.7は多くのプラットフォームでサポートされています。iOS、Android、Hongmengのすべてでデプロイが可能であり、発売日にはRockchip、Huawei、Intel、AMD、Armなどのチッププラットフォームへの対応が完了しました。推論フレームワークではSGLang、vLLM、llama.cpp、Ollamaがサポートされ、微調整にはSWIFTやLLaMA-Factoryが使用でき、量化バージョンにはGGUF、AWQ、GPTQ、FP8などいくつかの形式があります。
このルートの背後には、面壁と清華が提案した密度法則がある。この法則に従えば、大規模モデルの能力の密度は約3.5ヶ月ごとに2倍になり、同じ能力を得るために必要なパラメータはますます少なくなる。2026年9月までに、MiniCPMシリーズの累計ダウンロード数は5000万回を超えている。
要するに、優れた大モデルをスムーズにポケットに入れることは、もはや難しいことではない。